



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Muse Spark es la primera familia de modelos de Meta Superintelligence Labs, presentada el 8 de abril de 2026 como sustituta de la línea Llama (Meta AI). La versión 1.3 es la tercera iteración y, según la documentación de Meta, la recomendada por defecto para nuevos proyectos.
Las especificaciones, según la página de modelos de la API de Meta y la página de precios a fecha de septiembre de 2026:
Hay tres detalles que merece la pena destacar.
No es un modelo de pesos abiertos. Esto es lo primero en lo que la mayoría de la gente se equivoca, en parte porque Meta pasó años siendo la empresa de los pesos abiertos. Muse Spark 1.3 se sirve exclusivamente a través de una API. La propia nota de lanzamiento de Meta termina con una línea en su hoja de ruta que menciona "el lanzamiento de los pesos abiertos de Muse Spark" como un objetivo futuro, lo que deja claro que aún no ha ocurrido. Si necesitas pesos de Meta que puedas descargar hoy mismo, el modelo es Muse Glimmer: 30B de parámetros, multimodal denso, contexto por defecto de 128K, licencia Apache 2.0, destilado de Muse Spark (documentación de Muse Glimmer). Una licencia genuinamente permisiva y un modelo mucho más pequeño. No confundas ambos.
El audio presenta una degradación específica en la versión 1.3. La página de modelos de Meta indica en una nota a pie de página que la comprensión de audio en la versión 1.3 "actualmente no es totalmente compatible" y que la calidad de la respuesta puede verse afectada, por lo que recomienda utilizar la versión 1.2 o el modelo específico Muse Voice Transcribe. Se trata de una regresión inusual en una actualización menor, y es importante si tu flujo de trabajo procesa audio.
La ventana de contexto tiene un precio fijo. 1.048.576 tokens sin, en palabras de Meta, recargo por contexto largo: la misma tarifa por token tanto si la ventana está casi vacía como si está casi llena. La mayoría de los proveedores aplican un incremento a partir de cierto umbral. Este no lo hace.
[CAPTURA DE PANTALLA: API de modelos de Meta: el panel de control dev.meta.ai mostrando la entrada del modelo muse-spark-1.3 y la selección de nivel]
Meta presenta la versión 1.3 como una actualización centrada en la usabilidad más que en un salto de capacidad, y las diferencias publicadas respaldan esta interpretación.
Fuente: Presentación de Muse Spark 1.3, Meta AI Research, 2 de septiembre de 2026.
Las cifras de eficiencia conllevan una consecuencia comercial directa: una reducción del 25 % de tokens en el mismo trabajo supone un recorte del 25 % en la partida presupuestaria, antes de cualquier decisión de enrutamiento. Pero ten en cuenta la procedencia: se trata de una comparación de ingeniería interna de Meta, no de una reproducción de terceros. La tendencia es casi con toda seguridad correcta; la magnitud en tu carga de trabajo es algo que debes medir tú mismo.
Los cambios en el comportamiento son, discretamente, la mitad más interesante. Un modelo que pregunta antes de realizar una acción irreversible y admite cuando está bloqueado es una propuesta operativa distinta a uno que sigue adelante con confianza. Para ejecuciones de agentes a largo plazo donde una llamada a una herramienta errónea cuesta dinero real, eso vale más que cualquier punto en un benchmark.
Meta publica una tabla de puntuación comparando Muse Spark 1.3 con Muse Spark 1.2, GPT-5.6 Sol y Claude Opus 5 en evaluaciones de agentes, programación, seguimiento de instrucciones y contexto largo. La suite, según el informe de metodología de evaluación de Meta:
Las puntuaciones individuales están [VERIFICAR]. Meta solo las publica dentro de una imagen renderizada en la publicación de lanzamiento, no como texto legible por máquina, por lo que este artículo no transcribirá números que no pueda citar con precisión. Consúltalos en la tabla de puntuación de la página de Meta antes de citar cualquier cifra.
Lo que el informe de metodología sí dice en texto es más útil que las puntuaciones de todos modos, y tres advertencias merecen acompañar a cualquier número que decidas citar.
Las comparaciones se realizaron con diferentes niveles de esfuerzo. Muse Spark 1.3, Opus 5 y GPT-5.6 Sol se evaluaron con el máximo esfuerzo de razonamiento; Muse Spark 1.2 en xhigh. Por tanto, parte de cualquier diferencia entre la versión 1.2 y la 1.3 se debe a una diferencia en la configuración, no puramente a una diferencia del modelo.
La comparación de OSWorld no tiene versiones equivalentes. Todos los modelos se evaluaron en OSWorld 2.0 versión 08.08, excepto Muse Spark 1.2, que se ejecutó en la versión 06.24. Meta lo revela claramente, lo cual es un punto a su favor, pero significa que esa fila en particular no es comparable.
Las puntuaciones son las mejores de cada fuente. Meta informa "el valor de métrica primaria comparable más alto disponible de nuestra evaluación, la tabla de clasificación oficial o los resultados autodeclarados por el proveedor del modelo". Tomar el mejor número disponible para cada modelo en cada fila es un método defendible, pero no es una ejecución controlada única.
Meta también es inusualmente sincera sobre los límites de sus propias pruebas con la competencia, señalando que sus ejecuciones "pueden no estar ajustadas para modelos propietarios y pueden no reflejar su mejor rendimiento optimizado por el proveedor". Es una advertencia honesta y una buena razón para tratar la tabla de puntuación de cualquier proveedor —incluida esta— como una hipótesis inicial en lugar de un resultado. El único benchmark que resuelve una decisión de enrutamiento es tu tráfico en tus propios prompts, que es el argumento a favor de realizar tu propia evaluación antes de comprometerte.
Meta maneja dos niveles, y la brecha entre ellos es el hecho más importante de todo este artículo.
Fuente: Precios y límites de tasa de la API de modelos de Meta, septiembre de 2026.
El nivel Contributor es un 92% más barato en entrada y un 95% más barato en salida. Meta es totalmente transparente sobre el intercambio: tokens con un gran descuento "a cambio de permiso para usar tus prompts y completaciones para entrenar futuros modelos de Meta". Los ID de los modelos son distintos —muse-spark-1.3-contributor en lugar de muse-spark-1.3—, por lo que la elección es explícita en el momento de la llamada, no oculta en la configuración de la cuenta.
Esa transparencia es una buena práctica. También crea un riesgo operativo específico, al que volveremos más adelante.
Dos notas adicionales sobre precios. La búsqueda web con grounding cuesta 2,50 $ por cada 1.000 consultas además del coste de los tokens, por lo que cualquier cosa que utilice la herramienta web_search tiene un segundo contador en marcha. Y el razonamiento máximo solo está disponible en el nivel Standard; el nivel económico no puede alcanzar el modo que produce los benchmarks destacados.
Cuatro modos de fallo son específicos de este lanzamiento y no genéricos a la adopción de modelos.
El nivel Contributor está a una línea de configuración de distancia de un incidente de datos. Un descuento del 92% es exactamente el tipo de ahorro que un ingeniero aplica durante una revisión de costes sin leer la segunda mitad de la frase, y los dos ID de modelo solo se diferencian por un sufijo. Si un desarrollador apunta un servicio de producción a muse-spark-1.3-contributor para cumplir con un objetivo presupuestario, las consultas de los clientes se convierten en datos de entrenamiento de Meta y nada parece distinto en la aplicación. Eso debe aplicarse desde un punto central, porque no se hará de forma fiable en todos los repositorios.
Los límites de tasa se aplican por equipo, no por clave. Meta es explícita: todas las claves de un mismo equipo comparten el presupuesto de 3000 RPM y 4M TPM. Emitir una clave por servicio no segmenta la capacidad, por lo que un trabajo por lotes mal gestionado puede dejar sin recursos a un producto interactivo. El consejo de Meta es leer la cabecera x-ratelimit-remaining-tokens y reducir la velocidad antes de alcanzar el límite, lo que significa que algo en tu infraestructura debe encargarse de hacerlo.
Los pesos cerrados significan que la conversación sobre la residencia de datos termina pronto. Con un modelo de pesos abiertos puedes debatir dónde ejecutarlo. Aquí solo hay una respuesta: las consultas van a la API de Meta. Tu equipo legal decide qué es aceptable; la cuestión es que la vía de escape del alojamiento propio que existe para Muse Glimmer no existe para Muse Spark.
La rotación de versiones es rápida. Tres versiones entre abril y septiembre de 2026, aproximadamente cuatro semanas entre la 1.2 y la 1.3, y una regresión de audio documentada en una versión menor. Cualquier integración que codifique de forma rígida una cadena de modelo necesitará ser revisada antes de lo que prevé el ciclo de planificación, que es para lo que sirven los nombres de modelos virtuales y las migraciones por etapas .
Un modelo cerrado cambia el propósito de una pasarela. Con un lanzamiento de pesos abiertos, el trabajo de la pasarela es la portabilidad. Aquí es el control, la atribución y la capacidad de cambiar de opinión.
Haz que el nivel sea una política, no una preferencia. La decisión sobre Contributor debe tomarse una sola vez, por las personas responsables de ella, y luego aplicarse. La pasarela aplicación de políticas te permite exponer muse-spark-1.3 a servicios de producción y restringir la variante contributor a un entorno de pruebas, o bloquearla por completo. Las aplicaciones solicitan un nombre de modelo; la pasarela decide a qué se traduce.
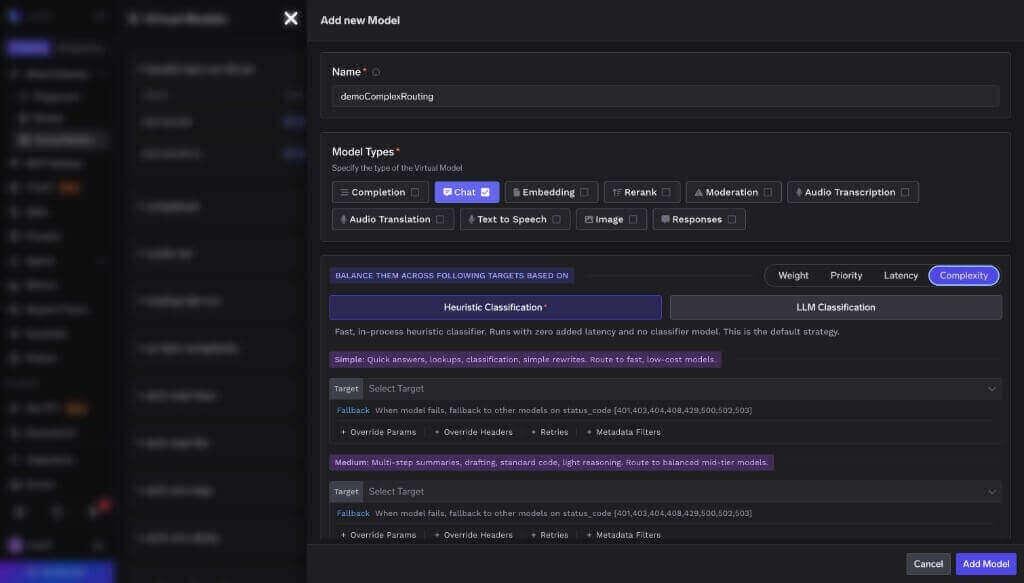
Enruta por tarea, no por lealtad al proveedor. La propia tarjeta de puntuación de Meta posiciona la 1.3 frente a Opus 5 y GPT-5.6 Sol en lugar de afirmar que los supera en todo, lo cual es un argumento a favor de una flota mixta. Las ejecuciones de agentes a largo plazo y el trabajo con contextos de un millón de tokens van a Muse Spark; el resto del trabajo va donde mejor se desempeña. En el benchmark de enrutamiento automático de TrueFoundry con 550 consultas, clasificar las peticiones de esta manera redujo los costes un 69% manteniendo el 98% de la calidad base, con una latencia media que bajó de 7,6s a 4,0s; en tráfico con perfil de producción, la reducción alcanzó el 80%.
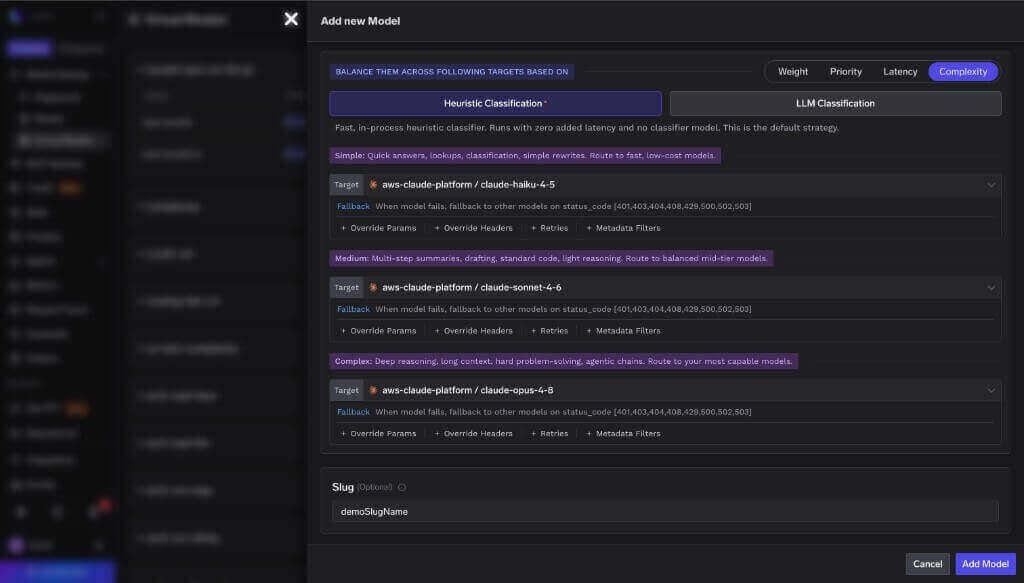
Absorbe el límite de tasa compartido. Dado que la cuota de Meta es por equipo, la pasarela es el lugar natural para gestionarla: limitación de tasa por equipo consumidor, puesta en cola y conmutación por error a otro proveedor cuando Meta devuelve un error 429. Un presupuesto compartido necesita un único lugar que lo entienda.
Mantén tus propias barreras de seguridad. Meta informa de una mayor resistencia a la inyección de prompts en la versión 1.3, lo cual es positivo, pero no es un control que tú gestiones. Las barreras de seguridad del Gateway se ejecutan en la ruta de solicitud y respuesta independientemente del proveedor que responda, por lo que tu política no cambia cuando cambias de modelo.

Mide la eficiencia prometida. Meta afirma que la versión 1.3 utiliza aproximadamente un 25 % menos de tokens que la 1.2. El coste por solicitud y la atribución de tokens por equipo es la forma de confirmar esto en tu propio tráfico en lugar de aceptarlo a ciegas.

La versión corta, a fecha de septiembre de 2026:

[CAPTURA DE PANTALLA: Muse Code — sesión de terminal que muestra una ejecución de agente en Muse Spark 1.3]
Muse Spark 1.3 es una versión competente y sin pretensiones, y precisamente esa falta de pretensiones es su punto fuerte. Meta no ha proclamado una nueva frontera. Ha apostado por menos llamadas a herramientas, menos tokens, un mejor comportamiento en hilos largos y un criterio más preciso en acciones irreversibles: los factores que determinan si la ejecución de un agente termina correctamente o si te hace perder toda la tarde. Para un equipo que ya trabaja con varios proveedores, esto la convierte en una cuarta opción creíble para tareas de agentes a largo plazo, con una ventana de un millón de tokens a precio fijo como elemento diferenciador.
Ten claro dónde pierde. Los pesos son cerrados, por lo que los argumentos sobre portabilidad y residencia que hacen interesante a un modelo de pesos abiertos no se aplican aquí; y si buscabas el modelo abierto de Meta, ese es Muse Glimmer, que es mucho más pequeño. El audio ha retrocedido en esta versión. Las puntuaciones principales se publican como una imagen, medidas en parte con configuraciones dispares y presentadas como los mejores resultados obtenidos. Además, la forma más barata de ejecutarlo te cuesta tus propios prompts.
La conclusión honesta es esta: todo se reduce a lo que quieres controlar. Si quieres el mejor modelo de Meta, lo alquilas bajo sus condiciones, y la decisión interesante no es si adoptarlo, sino dónde reside la política de niveles y quién puede modificarla. Coloca esa decisión tras una pasarela antes de que el primer equipo lo integre directamente, y añadir Muse Spark 1.3 a tu rotación solo te costará un cambio de configuración en lugar de una migración.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Muse Spark es la familia de modelos de Meta Superintelligence Labs, presentada el 8 de abril de 2026 y ahora sucesora de la línea Llama de Meta. Muse Spark 1.3, lanzado el 2 de septiembre de 2026, es la versión actual, con una ventana de contexto de 1.048.576 tokens y entrada de texto, imagen, vídeo y PDF.
No. Muse Spark 1.3 es cerrado y solo está disponible mediante API. La publicación de lanzamiento de Meta menciona una versión de pesos abiertos como un elemento futuro de la hoja de ruta. El modelo de pesos abiertos de Meta disponible hoy es Muse Glimmer: 30.000 millones de parámetros, Apache 2.0, destilado de Muse Spark y con una ventana de contexto predeterminada de 128K.
En el nivel Standard, 1,25 $ por millón de tokens de entrada, 0,15 $ por entrada en caché y 4,25 $ por millón de tokens de salida, sin recargo por contexto largo. El nivel Contributor cuesta 0,10 $ de entrada y 0,20 $ de salida, a cambio del permiso para entrenar con sus prompts y respuestas.
Meta evalúa la versión 1.3 frente a Muse Spark 1.2, Claude Opus 5 y GPT-5.6 Sol en GDPVal-AA v2, JobBench, OSWorld 2.0, DeepSearchQA, AutomationBench, DeepSWE v1.1, SWE-Atlas Codebase QnA, Terminal-Bench 2.1, MRCR v2 y un índice interno de seguimiento de instrucciones. Las puntuaciones individuales solo se publican en una imagen de la publicación de lanzamiento de Meta: consúltelas allí y no en coberturas secundarias.
El AI Gateway de TrueFoundry añade aproximadamente 3-4 ms y sostiene más de 350 RPS con 1 vCPU, algo irrelevante frente a tiempos de generación de varios segundos.
No, y la dispersión de benchmarks anterior es el argumento en contra. Enrutar por tipo de tarea entre modelos abiertos y cerrados suele ser más barato y mejor que estandarizar en uno solo.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















