



November 10, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La limitación de velocidad clásica de las API asume que las peticiones son fungibles: un GET /users/42 cuesta aproximadamente lo mismo que el siguiente, por lo que contar peticiones es una estimación aceptable de la carga. Todos los limitadores de velocidad que ha configurado están creados bajo ese principio.
El tráfico de LLM rompe este esquema. Mismo endpoint, mismo minuto, mismo usuario: "resume esto en una línea" representa quizás 50 tokens ida y vuelta; un contrato de 150 páginas enviado a un modelo de razonamiento se aproxima a los 200.000. Ambos equivalen a una petición, y un límite de 1.000 peticiones por minuto permite cualquiera de los dos.
Esa variabilidad es la forma normal del tráfico en producción cuando hay agentes involucrados, porque el turno de un agente incluye en cada paso toda la conversación más los resultados de las herramientas y el contexto recuperado en el prompt. El número de peticiones se mantiene estable mientras que el número de tokens aumenta un orden de magnitud: el mecanismo detrás de la explosión de tokens por agentes en CI/CD.
Por lo tanto, cambie la unidad. Cuente tokens, porque los tokens son lo que usted compra. El recuento de peticiones sigue siendo importante (protege el gateway y la conexión con el proveedor), así que ejecute ambos.
La mayor parte de la confusión aquí radica en el vocabulario. Cuatro problemas, cuatro mecanismos, y los equipos instalan rutinariamente uno creyendo que instalaron otro:
Los límites de velocidad son un control de disponibilidad; los presupuestos son un control financiero. Fallan de forma diferente y tienen propietarios distintos: la plataforma gestiona el primero; finanzas, el segundo.
El error habitual es instalar un límite de velocidad de tokens y llamarlo control de costes. 20.000 tokens por minuto en un modelo económico suponen unos pocos dólares al día; en un modelo de razonamiento puntero es una cifra muy distinta y cambia cada vez que un proveedor ajusta sus tarifas. El volumen de procesamiento de tokens no es dinero.
Los límites de los proveedores merecen una advertencia, porque los equipos dependen de ellos sin pretenderlo. El límite de su organización en OpenAI o Anthropic es un único fondo compartido: cuando un proceso por lotes lo satura, su producto de cara al cliente se ve ralentizado por un sistema que no puede expresar "el asistente siempre tiene prioridad". De ahí la necesidad de un gateway bajo su propio control.
El algoritmo decide cuánto pico de tráfico (burst) se permite pasar, algo vital para los agentes.
Para el tráfico de chat humano, la ventana fija funciona bien; las personas no se coordinan. Los agentes sí lo hacen, de forma involuntaria. Reintentan ante fallos, se despliegan en paralelo y se ejecutan según agendas programadas, por lo que muchos clientes coinciden en el mismo instante de reloj y la duplicación del límite deja de ser teórica. Las ventanas deslizantes resuelven esto al no tener un momento de reinicio. El algoritmo token bucket responde a otra necesidad (se adecua al tráfico en el que se desean picos breves) a cambio de tener que ajustar un parámetro adicional.
La reducción del nivel del modelo es la estrategia menos utilizada: si se alcanza un límite a nivel de modelo, una cadena de reserva puede prestar servicio desde un segundo proveedor en lugar de devolver un error 429 a una persona; este es el mecanismo de conmutación por error descrito en nuestro artículo sobre routers de LLM, donde 429 actúa como código de estado desencadenante. Un exceso de presupuesto es diferente: si el dinero se ha agotado, se ha agotado, y gastarlo de forma discreta en una opción más económica no es lo que el departamento financiero ha solicitado.
Regla genérica por encima de la específica. Bajo un esquema de aplicación donde la primera coincidencia prevalece, una regla general situada cerca de la parte superior absorbe el tráfico que debería haber coincidido con una regla más específica situada debajo. La regla específica nunca se ejecuta.
Tratar un único contador compartido como un límite por usuario. "20.000 tokens por minuto" sin acotación de ámbito representa un único contador para todo el mundo. El primer cliente lo consume íntegramente.
Asumir que las peticiones fallidas son gratuitas. Para límites basados en peticiones no lo son; y para límites de tokens la respuesta es distinta.
Dos objetos de directiva, deliberadamente independientes: la limitación de velocidad gobierna el volumen de procesamiento y los presupuestos gobiernan el dinero.
Las reglas de limitación de velocidad aceptan seis unidades, el conjunto completo:
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
No existe una unidad por segundo; una sola petición a un LLM puede tardar decenas de segundos, por lo que los límites por segundo medirían ruido. La configuración se encuentra en la pestaña Config:
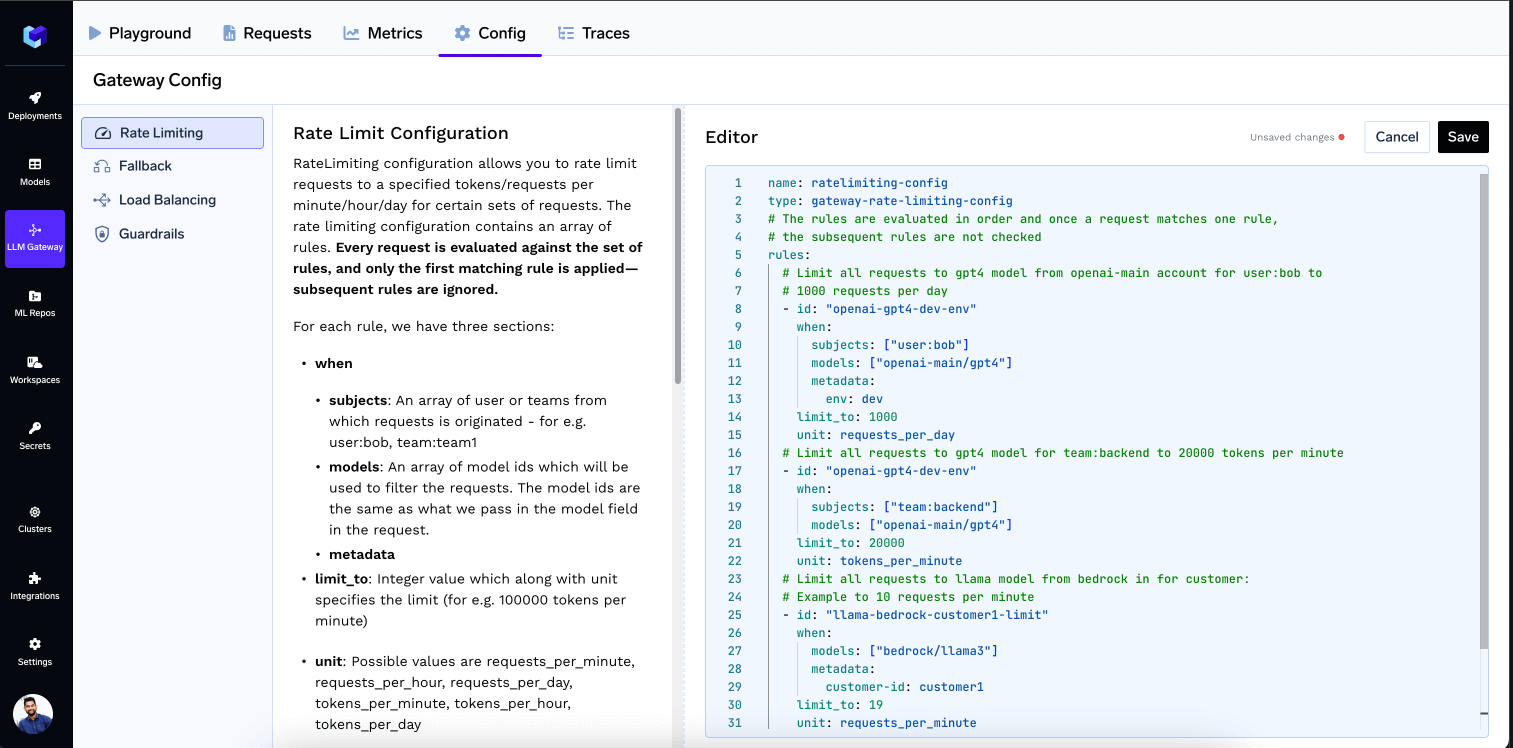
Un conjunto de reglas es de tipo type: gateway-rate-limiting-config con una lista de reglas. Cada regla tiene un id estático, un bloque when cuyas condiciones de subjects, models y metadata se combinan mediante AND, un entero limit_to, una unidad unit y, opcionalmente, rate_limit_applies_per. Los sujetos llevan prefijo (user:, team:, virtualaccount:) y metadata lee la cabecera X-TFY-METADATA.
Puesto que la unidad mínima es por minuto, el gateway mantiene una ventana de 60 segundos, conserva intervalos temporales cada 10 segundos para cada usuario, modelo, equipo o segmento personalizado, y suma los últimos 6 intervalos para evaluar el contador. Los intervalos más antiguos se descartan. La resolución de diez segundos es la cifra clave que debe asimilarse: un pico de tráfico se suaviza a lo largo de seis subintervalos en lugar de permitirse dos veces en un único límite de reinicio.
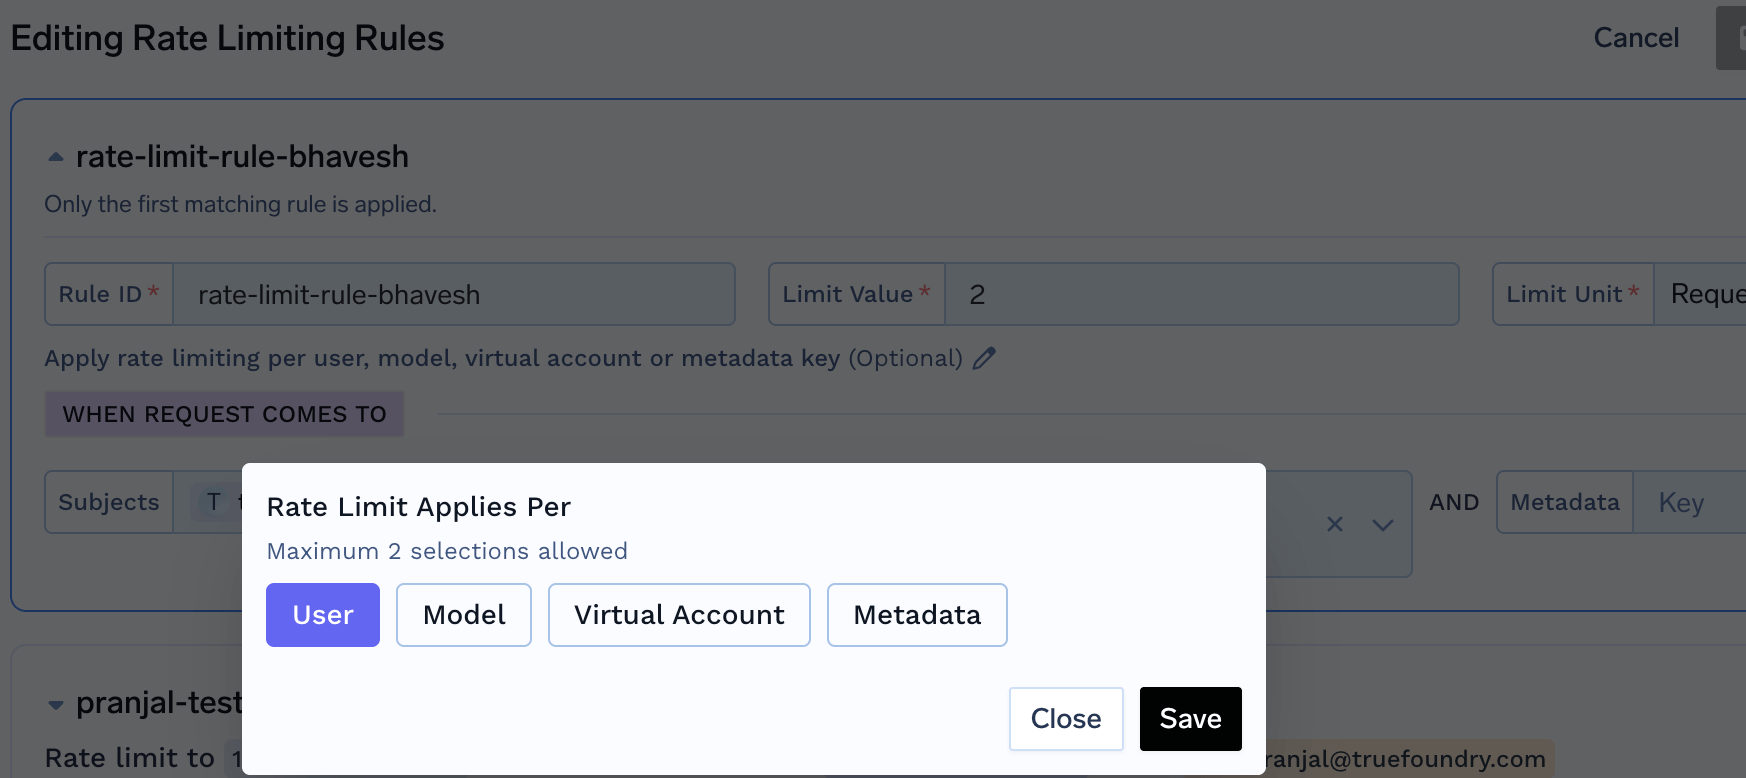
Sin este parámetro, una regla actúa como un único contador compartido para todo lo que coincida con ella. Con él, el contador se divide por entidad. Los valores permitidos son user, virtualaccount, model y metadata.* con su propia clave. Máximo dos valores por regla.
['user'] otorga a cada usuario su propia asignación y ['model'] a cada modelo la suya. La última regla refleja el patrón que la mayoría de los equipos terminan necesitando: un límite máximo por proyecto asociado a los metadatos que la aplicación ya envía, sin requerir la edición de reglas al incorporar un nuevo proyecto.
Esto sustituye a un formato dinámico de ID de regla. La migración es directa: {user}-daily-limit se convierte en id: 'user-daily-limit' más ['user'], y project-{metadata.project_id}-limit pasa a ser id: 'project-limit' más ['metadata.project_id']:
Cada petición se evalúa contra todas las reglas, pero solo se aplica la primera regla que coincida. Las coincidencias posteriores nunca la bloquean. El uso, sin embargo, se contabiliza en todas las reglas con las que la petición coincida.
Por ello, mantenga las reglas especializadas en la parte superior. El fallo documentado: colocar app-a-limit (10.000 rpm, virtualaccount:app-a) por encima de tenant-wide-limit (5.000 rpm, when: {}), provoca que el tráfico de la app A (contabilizado en ambas) sature por sí solo el contador del tenant. En consecuencia, cualquier usuario cuya primera coincidencia sea la regla del tenant recibirá un error 429 muy por debajo de las 5.000 rpm. La solución no es reordenar, sino delimitar el ámbito: rate_limit_applies_per: ['user', 'virtualaccount'].
Cualquier petición que el gateway rechace, o en la que el proveedor falle con un código 4XX/5XX, se contabiliza como una petición en todas las reglas requests_per_* con las que haya coincidido. Existe una excepción: las peticiones rechazadas previamente con un 429 por la propia limitación de velocidad, para evitar que una sobrecarga de reintentos incremente el problema.
Los límites de tokens funcionan de otra forma. Las peticiones fallidas no consumen cuota de tokens porque una petición fallida no reporta tokens. No hay nada que contar. Por esta razón, un bucle de reintentos puede agotar su presupuesto de peticiones mientras el panel de tokens muestra un estado correcto.
Un exceso del límite devuelve HTTP 429 con error.type: "RateLimitError" y error_origin_level: "rate_limit_budget", además de una cabecera x-tfy-applied-rules que especifica la regla activada.
Los presupuestos constituyen el control financiero y son exclusivamente de coste, cost_per_* en USD. No existe un presupuesto denominado en tokens; si necesita un límite máximo de tokens, utilice un límite de velocidad.
Budget V2 se incorporó en la versión v0.158.0 e invierte la lógica de aplicación: se comprueba cada regla coincidente y todas deben permitir la petición, aplicando una condición AND entre presupuestos. La limitación de velocidad se rige por la primera coincidencia; los presupuestos requieren que todas las reglas autoricen el acceso. La V1 utilizaba la primera coincidencia, por lo que la migración implica un cambio semántico, no sintáctico.
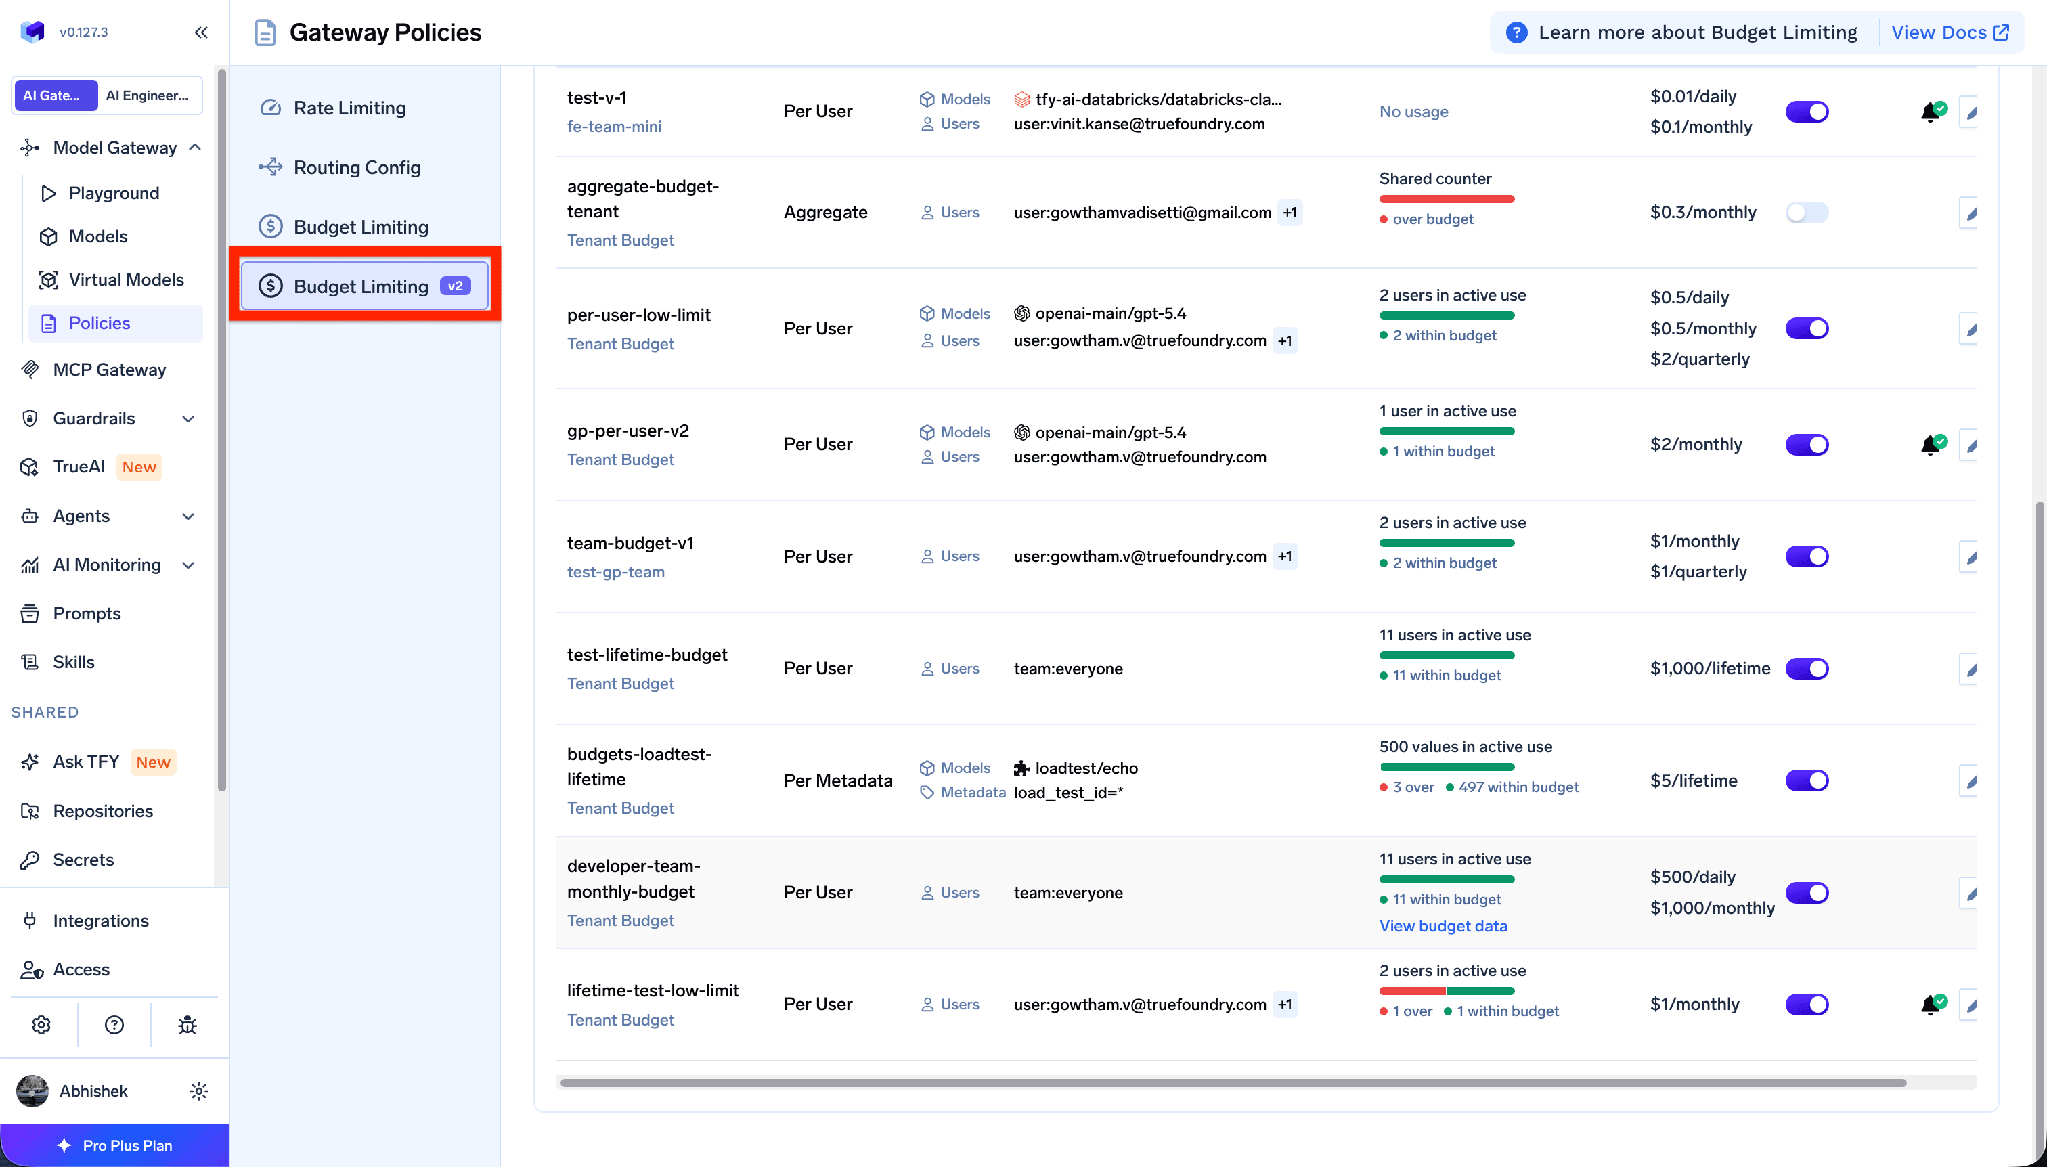
Las reglas se gestionan en AI Gateway → Policies → Budget Limiting → Add Rule, en dos ámbitos: tenant (tenant-budget-config) o equipo (team-budget-config, con un team_name controlado por RBAC).
Cinco períodos de reinicio, todos en UTC: Diario (00:00), Semanal (Lunes 00:00), Mensual (día 1), Trimestral (1 ene, 1 abr, 1 jul, 1 oct) y Lifetime, que nunca se reinicia: el límite absoluto de gasto de la tabla anterior:
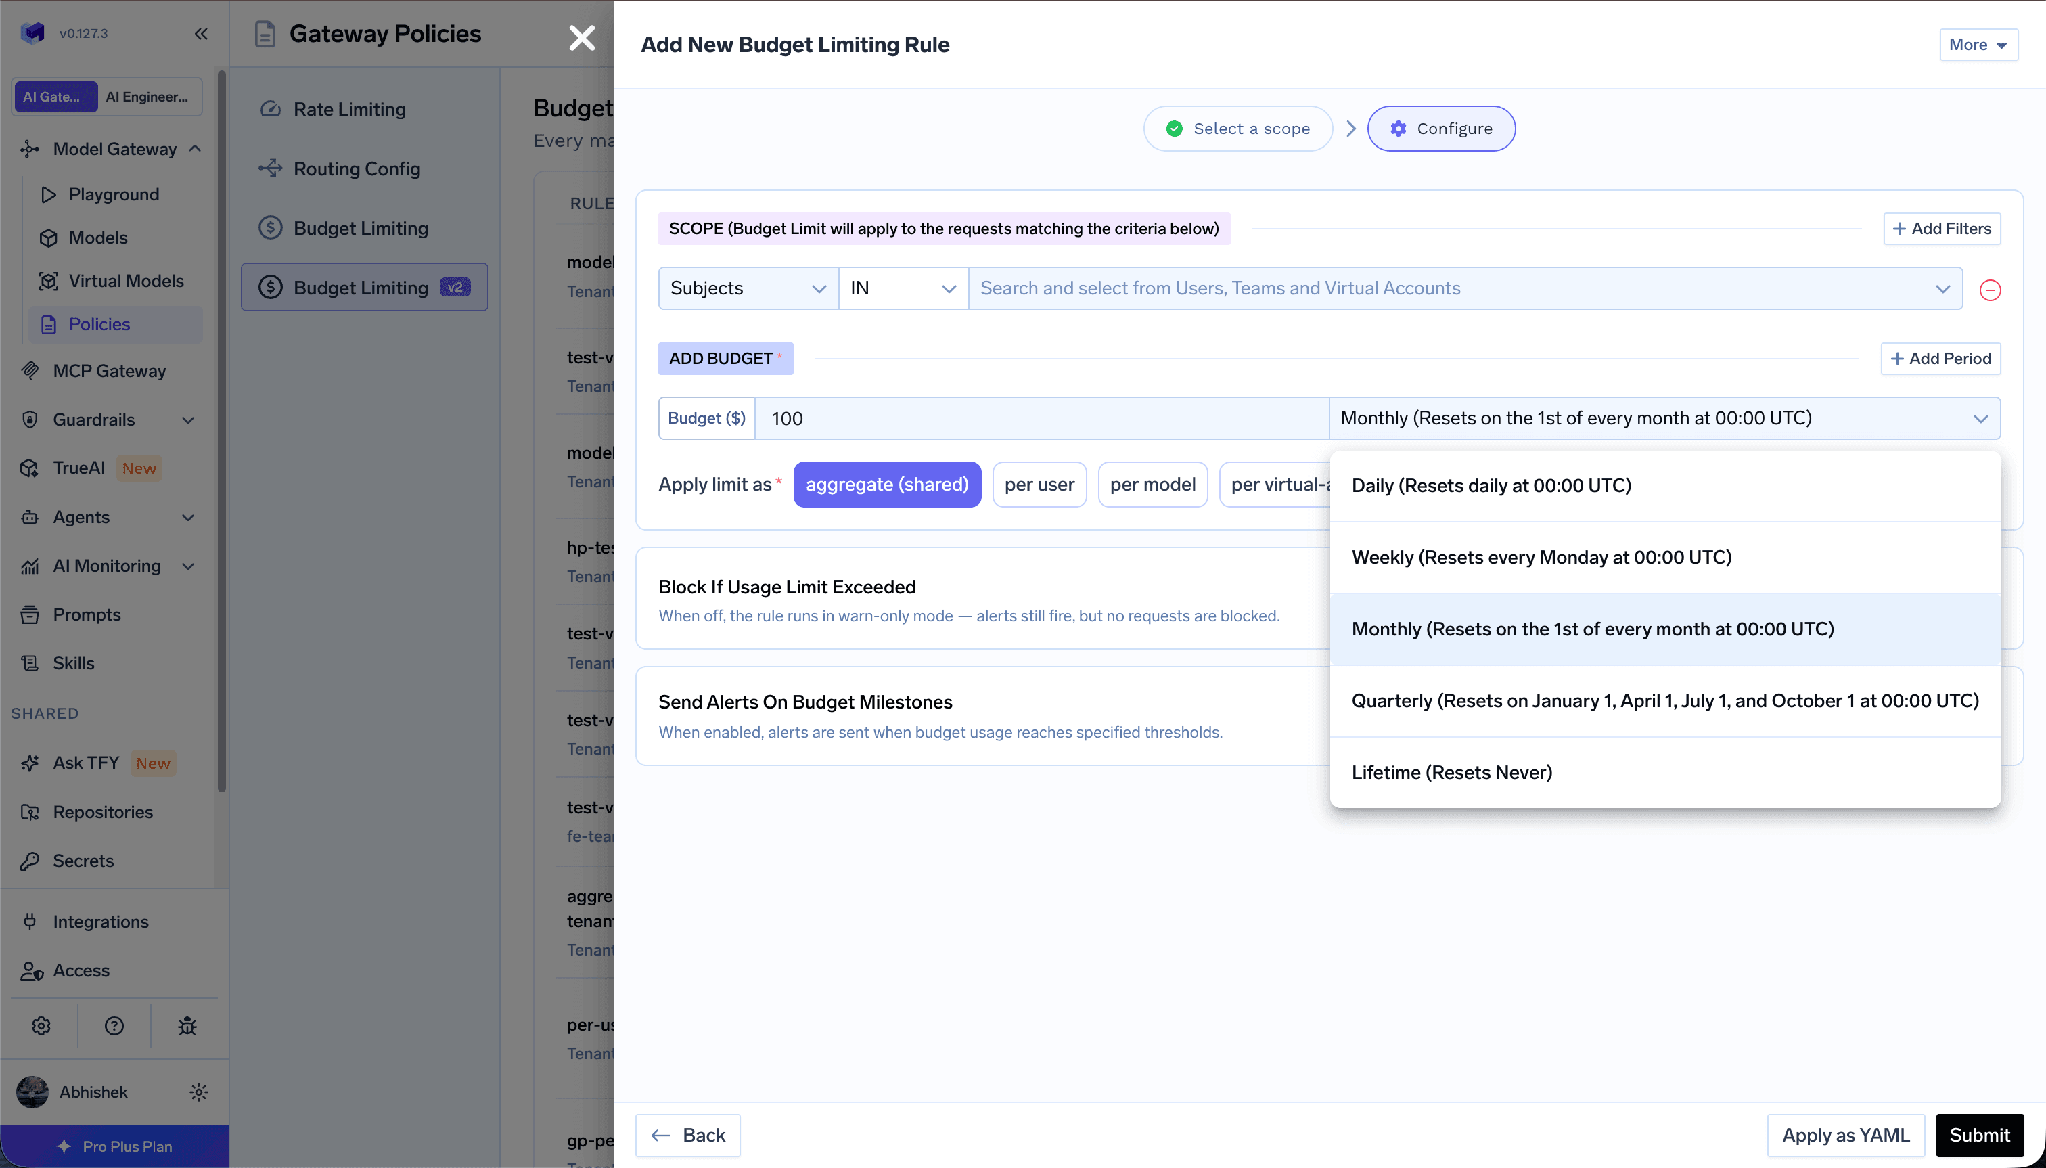
Una única regla puede aplicar varios períodos de forma simultánea, bloqueando la petición si se supera cualquiera de ellos: el ejemplo multi-period-cap de la documentación define cost_per_day: 0.5, cost_per_month: 0.5 y cost_per_quarter: 2 conjuntamente. Los filtros de ámbito (Subjects, Models, Provider accounts, Metadata) admiten IN/NOT IN y se combinan mediante AND:
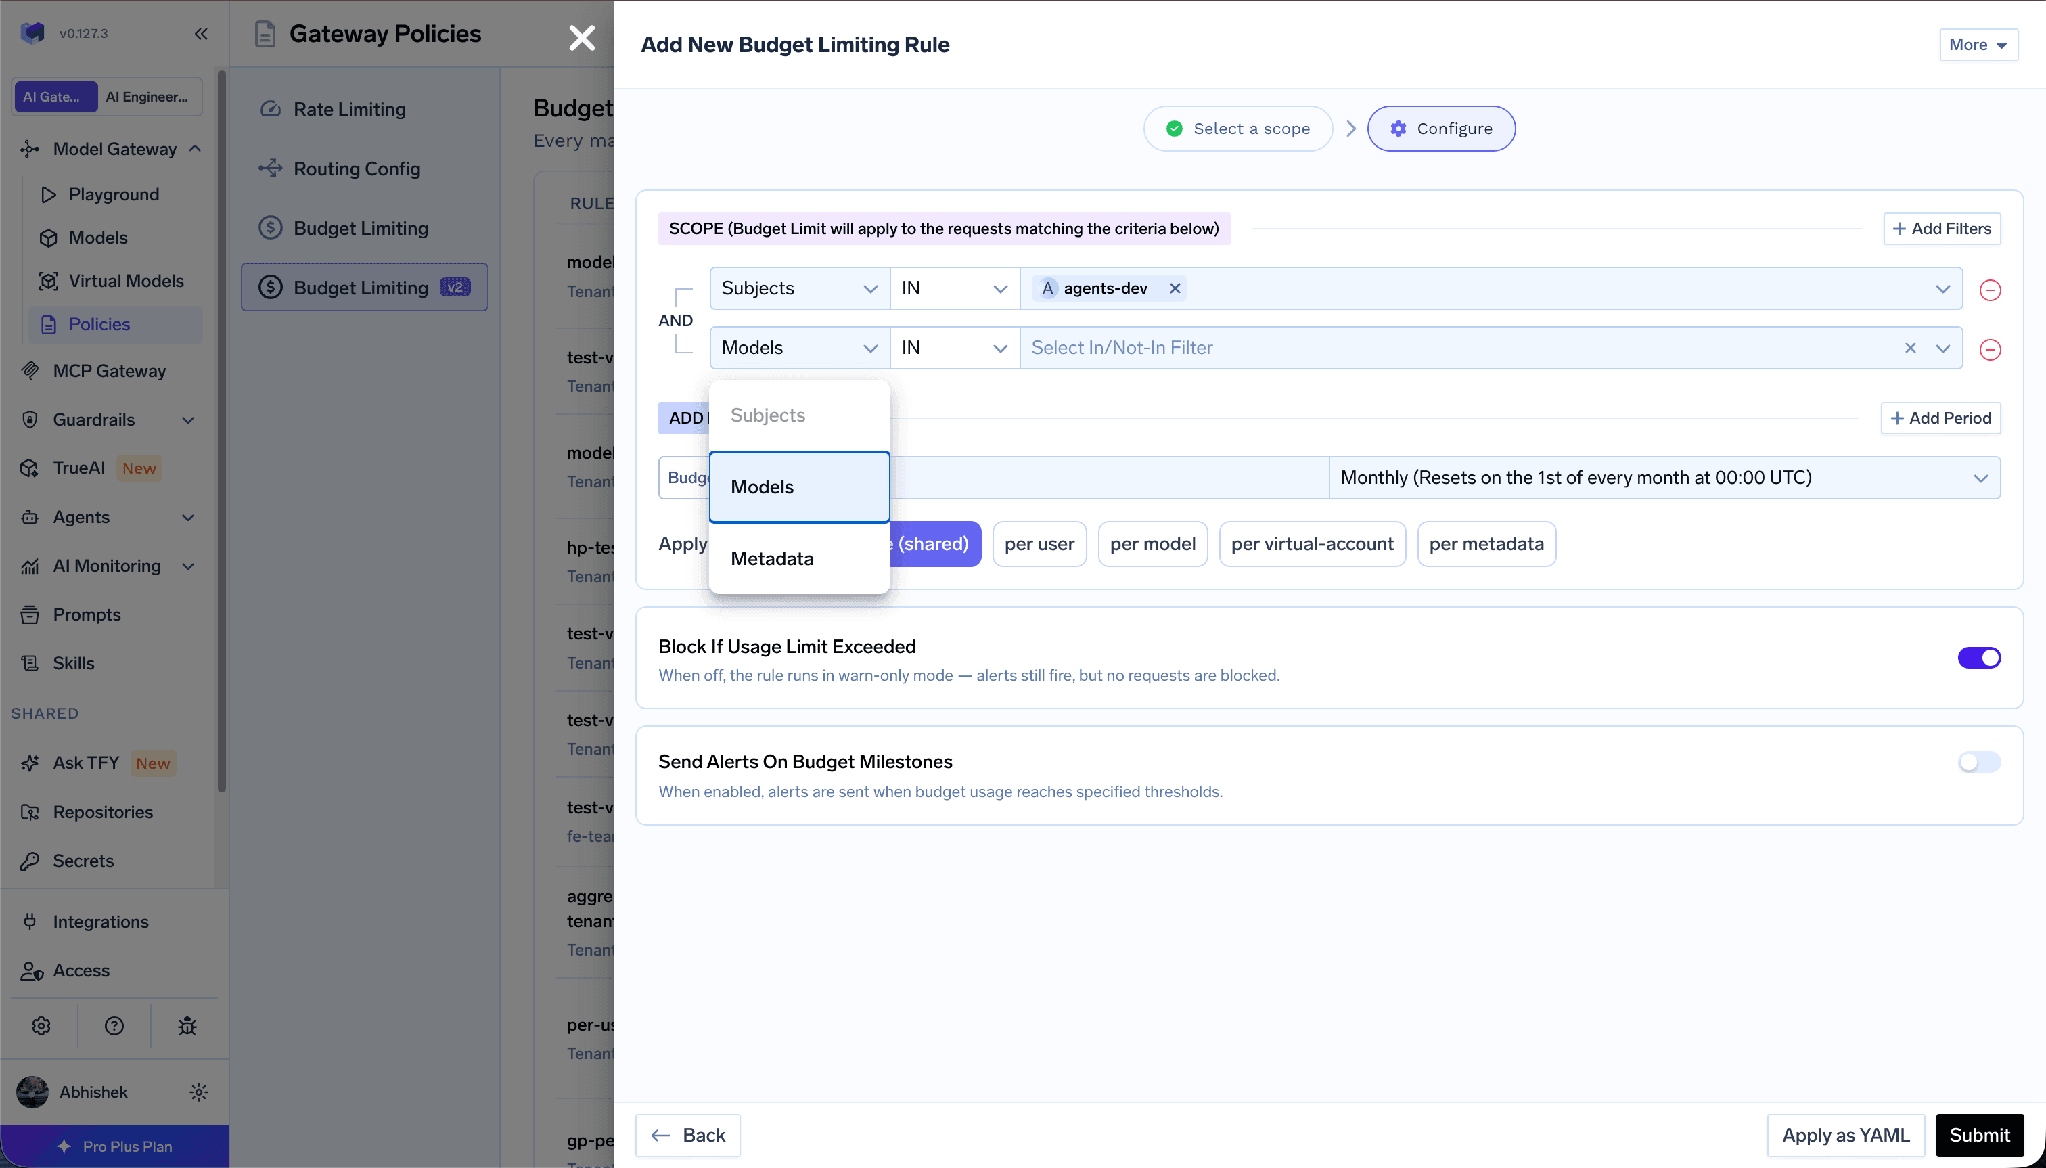
Apply limit as (applies_to.type) admite aggregate, per-user, per-model, per-virtual-account o metadata con una clave, y no se puede modificar tras su creación. Las reglas por entidad admiten excepciones (overrides) para usuarios, modelos, cuentas virtuales o valores de metadatos específicos:
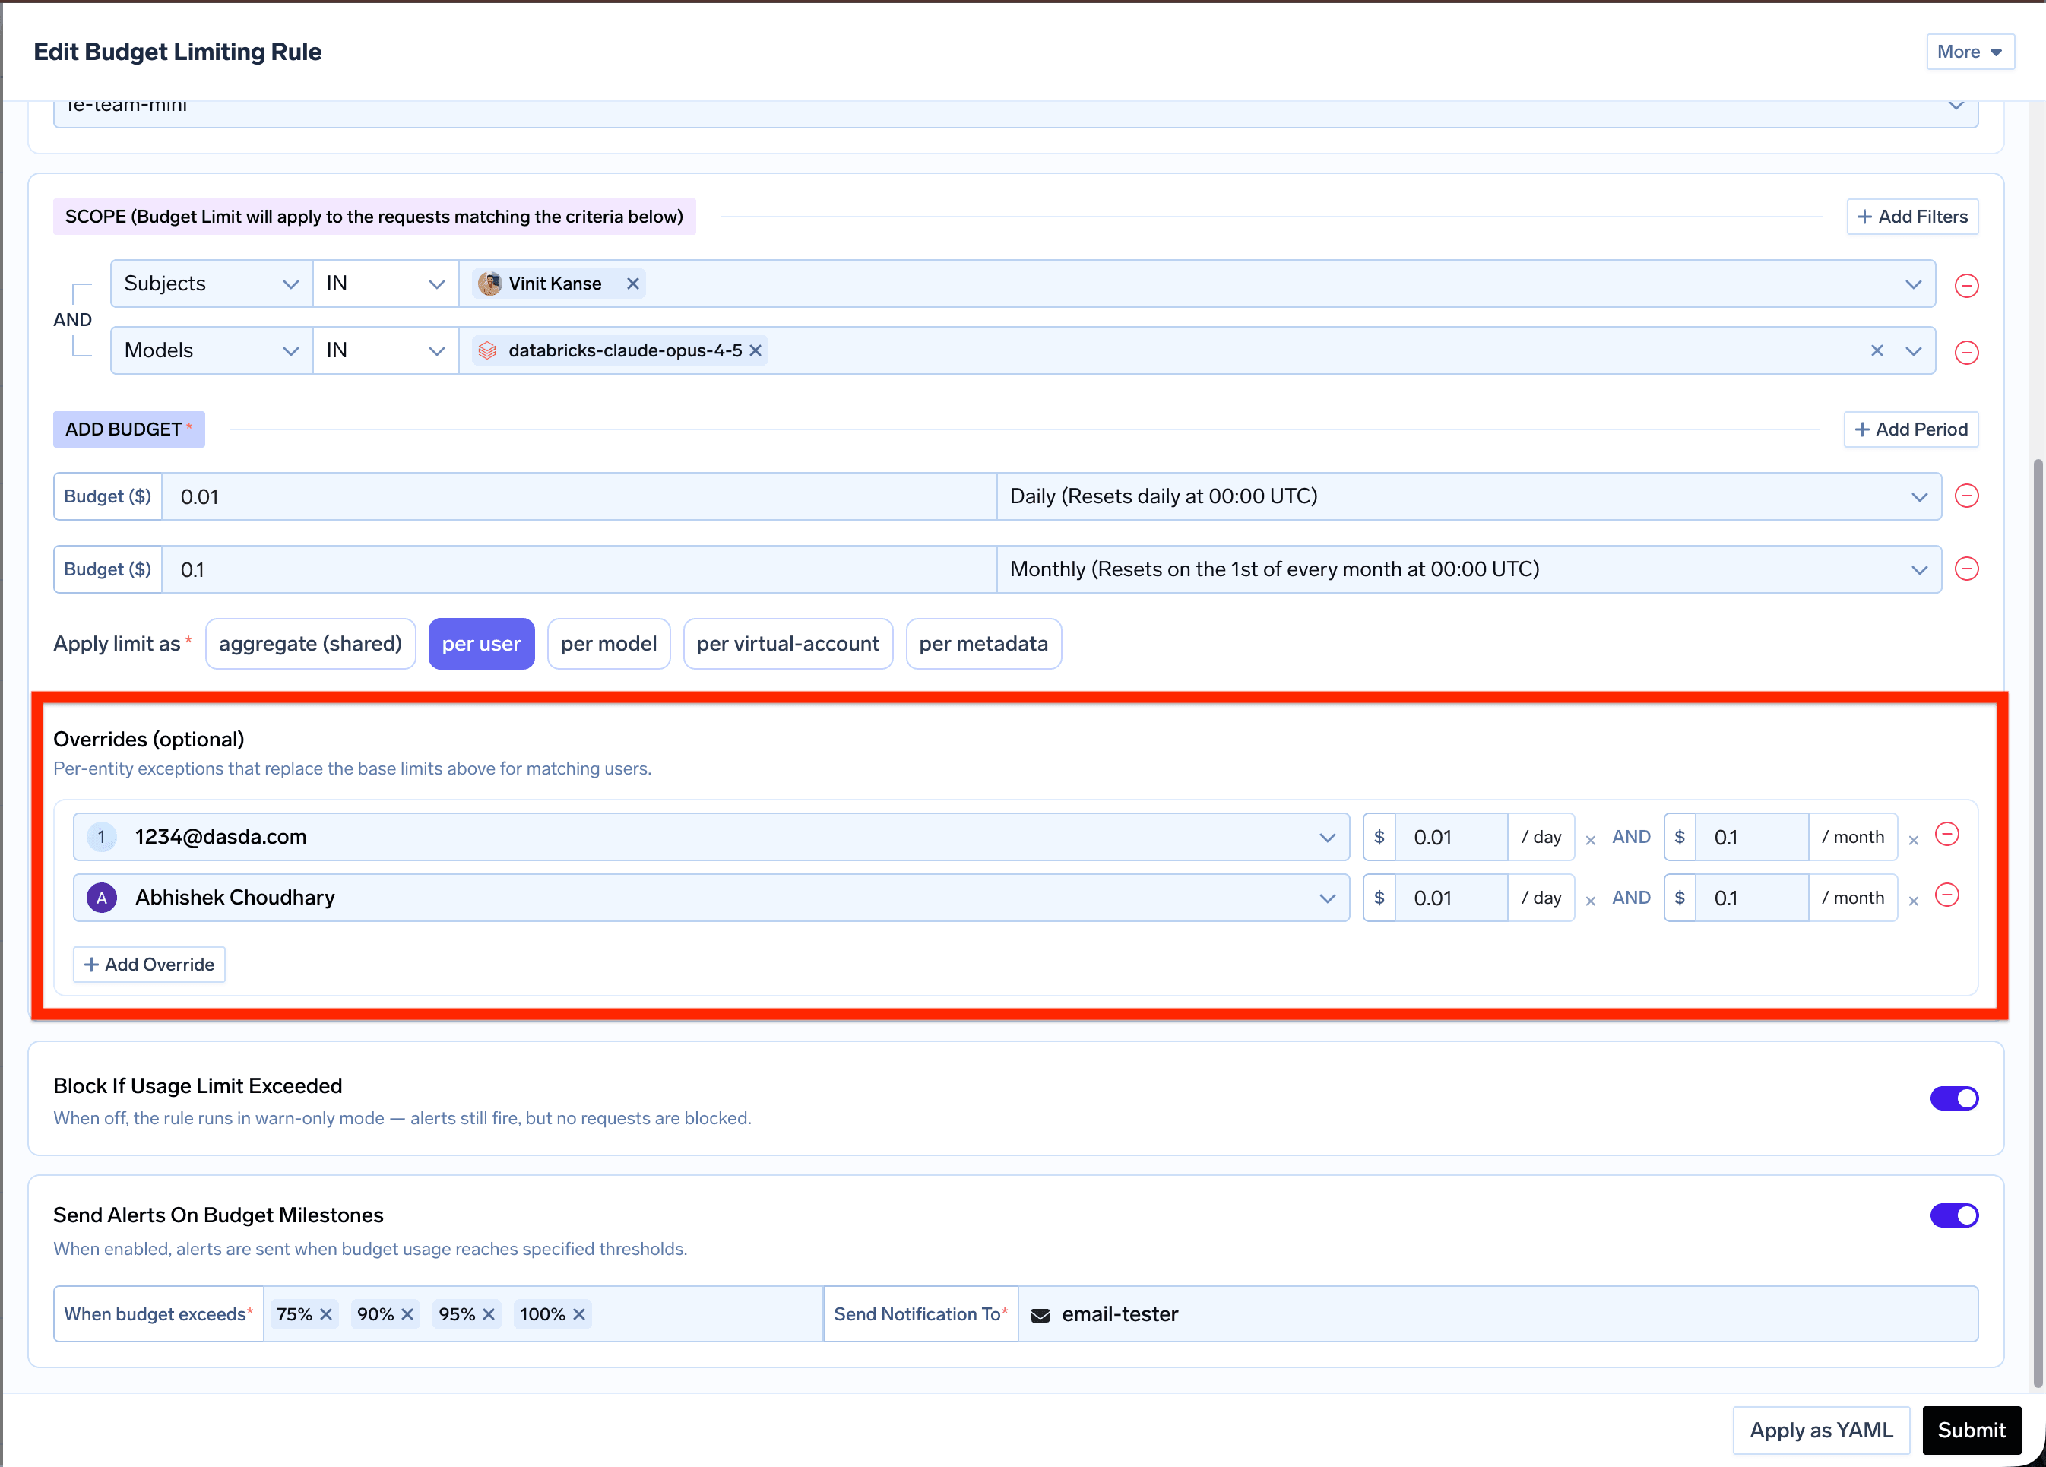
Una excepción reemplaza todos los períodos para esa entidad. Si la regla base establece límites diarios y trimestrales y la excepción solo define uno diario, dicha entidad no tendrá ningún límite trimestral. Incluya todos los períodos que desee aplicar.
Tres modos: enforce (predeterminado, rechaza), audit (permite el paso, registra y alerta) y soft_enforce (bloquea únicamente cuando ningún otro presupuesto coincidente pueda autorizarlo; si otro dispone de margen, la petición se aprueba y el exceso se registra como una infracción de auditoría). Un bloqueo en modo enforce estricto en cualquier punto prevalece.
Las alertas se activan al 75, 90, 95 y 100 por ciento, cada una una vez por período de presupuesto, de forma independiente para cada entidad en un presupuesto por entidad; los presupuestos Lifetime alertan una sola vez por umbral en su totalidad. Destinos admitidos: email, slack-webhook, slack-bot, pagerduty, ms-teams-webhook, utilizando {{user.email}} para entregas por usuario.
Una advertencia importante: los contadores de presupuesto comienzan en el momento de creación de la regla, no al inicio del período. El gasto previo no se contabiliza de forma retroactiva, por lo que una regla creada a mitad de mes no se reconciliará con su factura de ese período.
Los presupuestos son tan precisos como las tarifas en las que se basan, por lo que dichas tarifas son públicas. El catálogo en github.com/truefoundry/models es la base de datos de precios utilizada para el seguimiento público de costes, consultable en truefoundry.com/models. Consulte la tarifa que se le aplica y abra una PR si encuentra algún error.
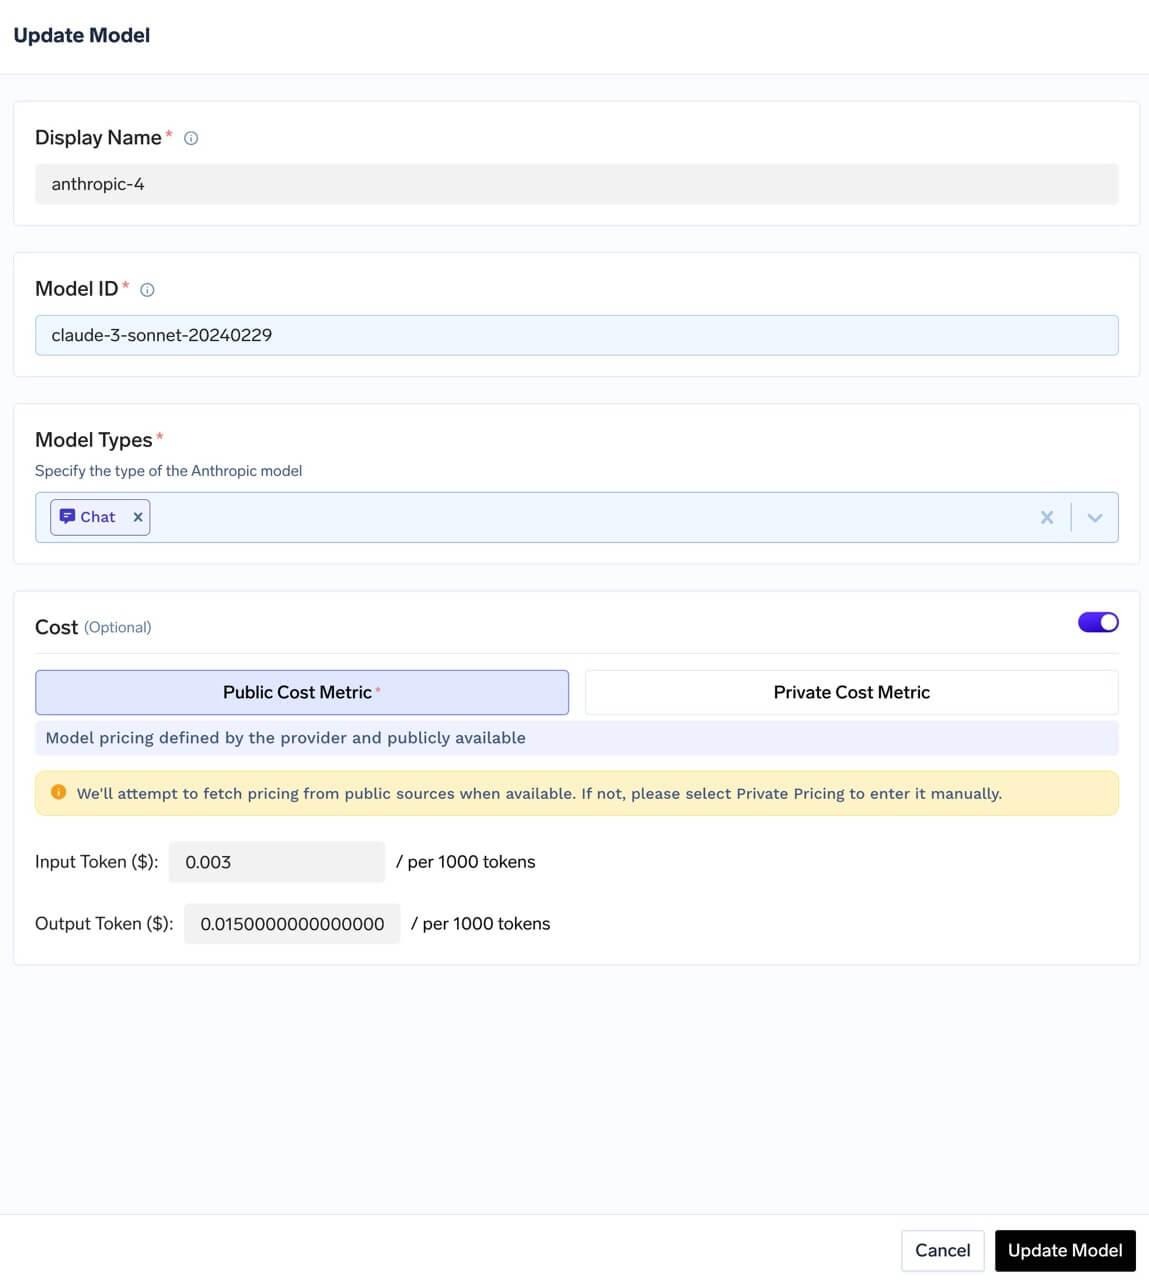
Dos detalles relevantes. Precios por región: providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml incluye diferentes tarifas de entrada y salida para us-west-2, us-west-1, eu-central-1 y eu-west-1, de modo que el tráfico multirregión no se calcula erróneamente con una tarifa plana. Precios por tramos: providers/google-gemini/gemini-2.5-pro.yaml dispone de tarifas base más tarifas superiores a partir de 200K tokens, y gemini-1.5-flash.yaml establece tramos desde 128K tokens. El contexto extenso no se tara de forma lineal. Los modelos sin precios públicos utilizan una entrada de Private Cost.
Un presupuesto por usuario solo es efectivo si las peticiones se atribuyen de forma fiable. Tres mecanismos automatizan este proceso sin depender de la disciplina de los desarrolladores:
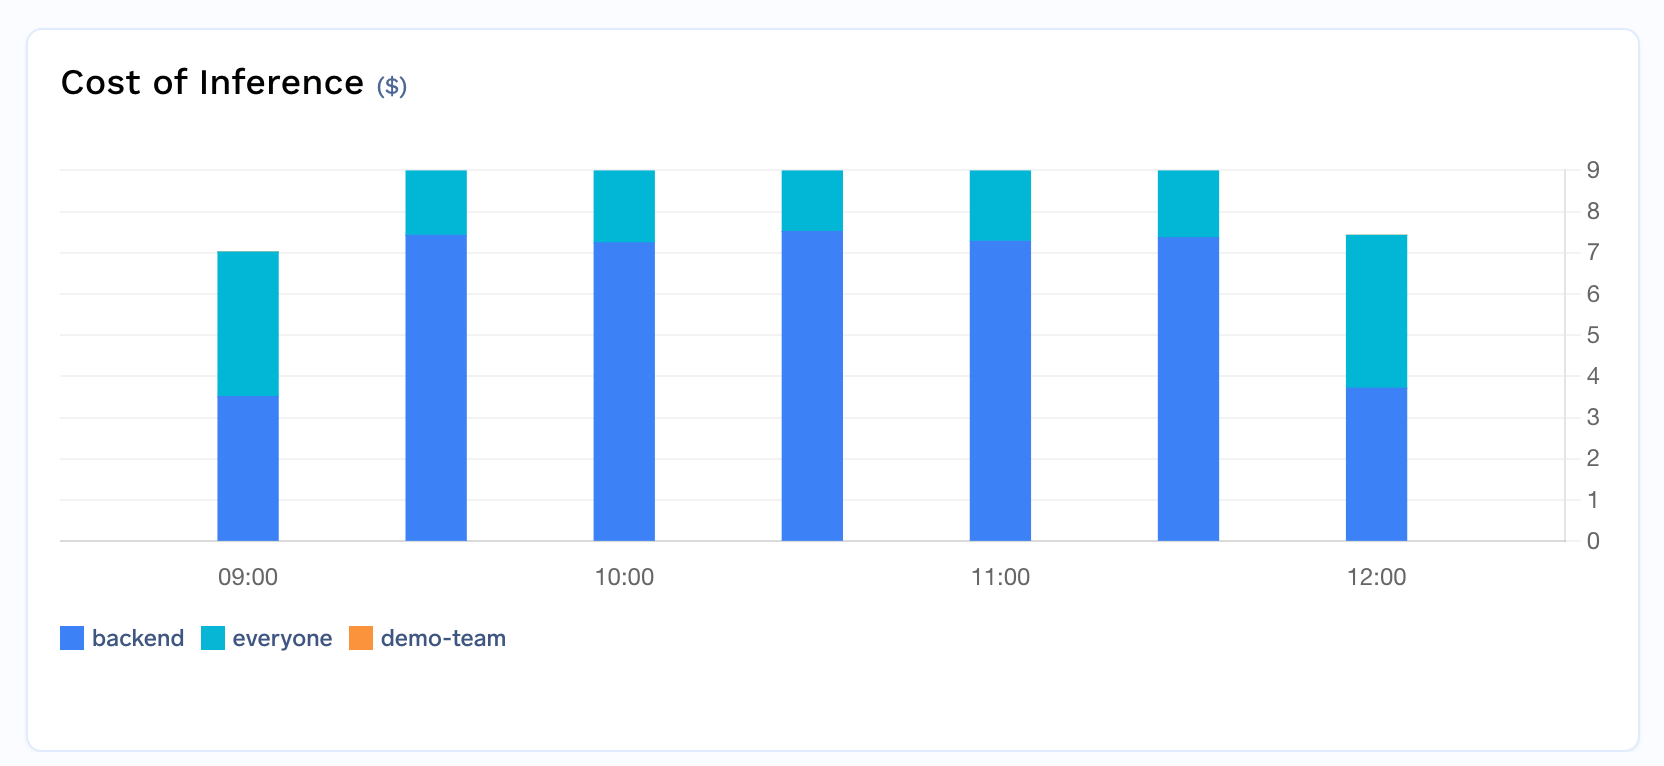
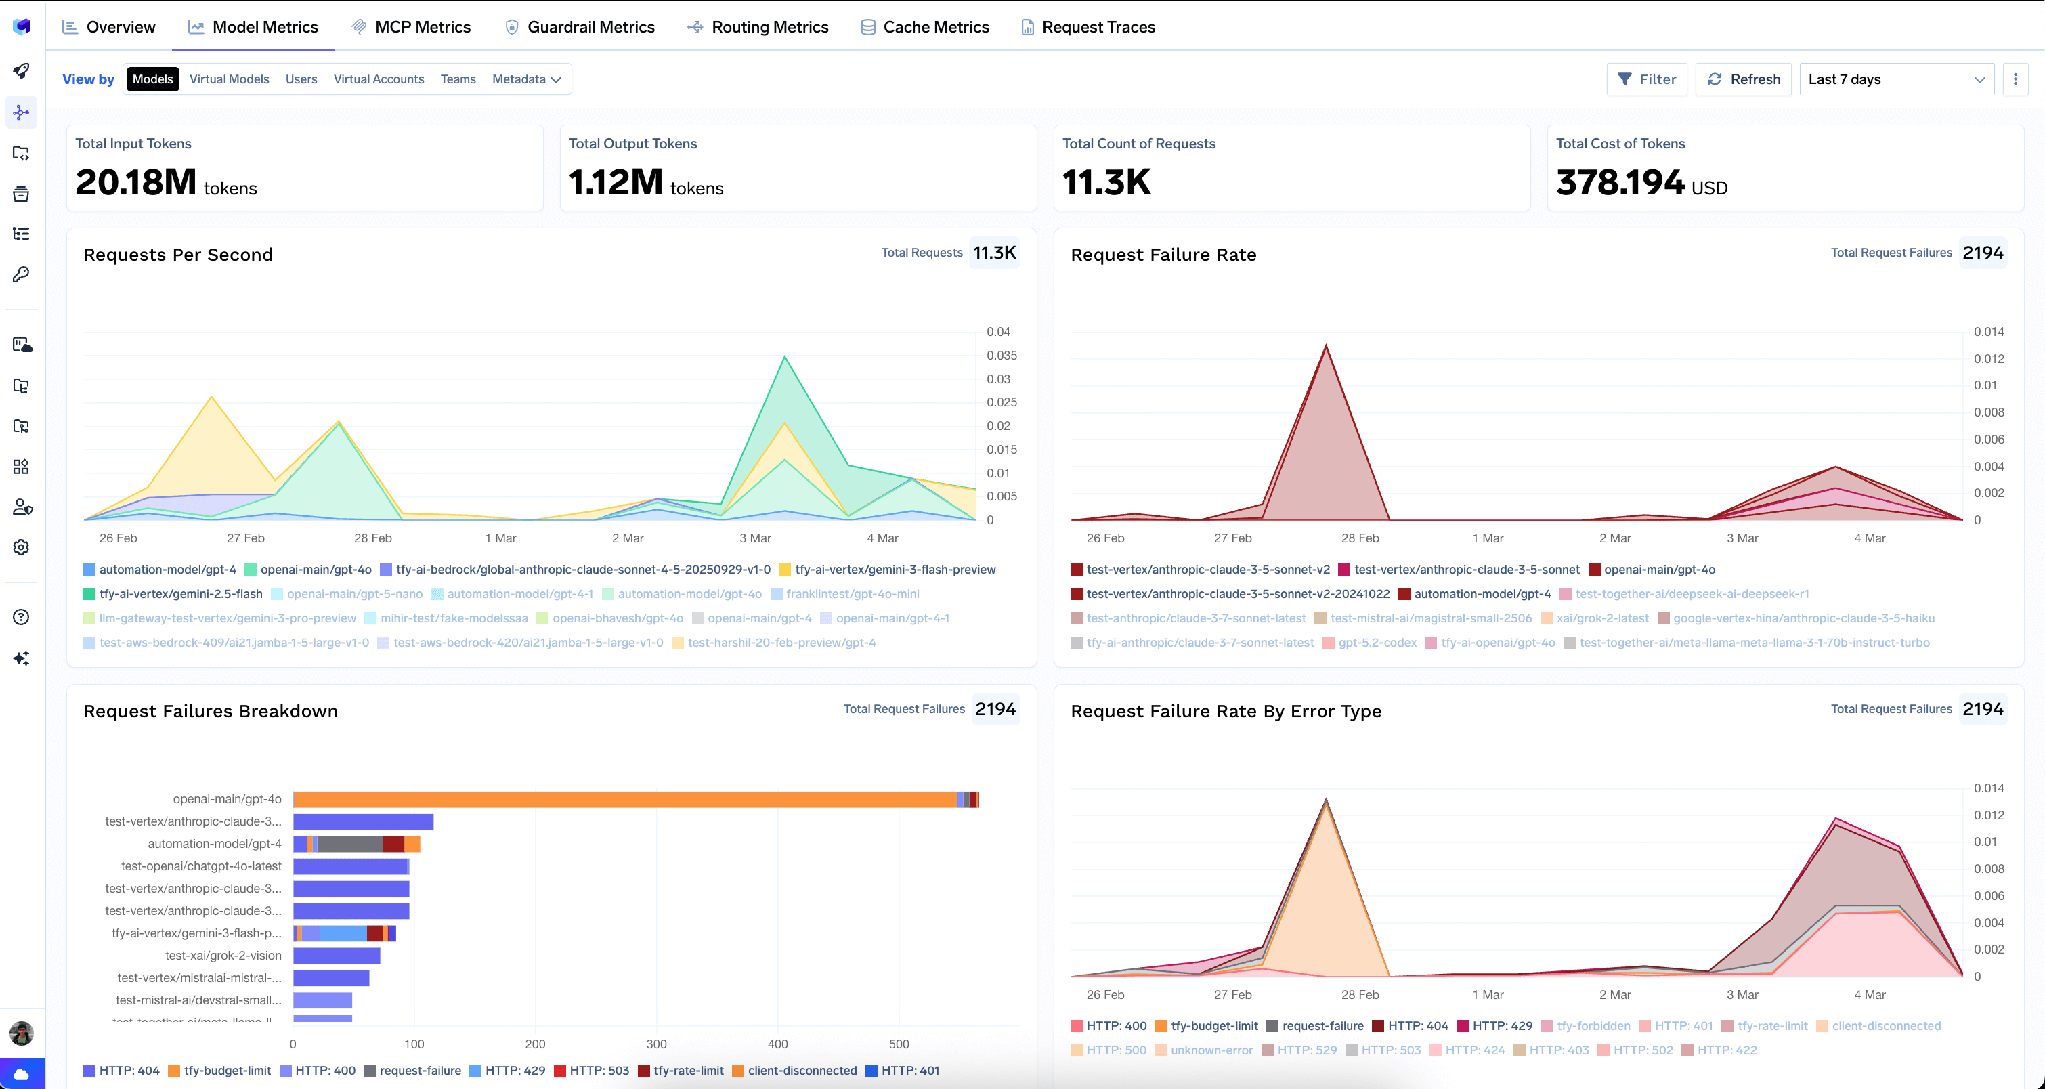
Model Metrics realiza el seguimiento de Total Input Tokens, Total Output Tokens y Total Cost of Tokens en USD, exportables desde Metrics → 3 puntos → Download Raw Data agrupados por username, model_name o teams:
Un gateway y tres grupos: un asistente enfocado a clientes, un agente de código interno y un equipo de datos que realiza extracción masiva, todos compartiendo una misma cuenta de proveedor. El agente de código sufrió una incidencia el mes pasado y el resto de usuarios recibió errores 429.
Evite el desabastecimiento. El problema se debía a un contador compartido, no a la falta de un límite. Sitúe una regla coding-agent-tpm (200.000 tokens_per_minute, subjects: ["virtualaccount:coding-agent"]) por encima de una regla genérica para todo el tenant (500.000 tokens_per_minute, when: {}), y configure en la regla genérica rate_limit_applies_per: ['virtualaccount'] para que el agente no agote la asignación de los demás al coincidir con ambas. Añada también una regla requests_per_minute sobre los mismos sujetos: las peticiones fallidas se contabilizarán en esa regla, pero no en la de tokens.
Establezca el límite financiero. Un presupuesto mensual por usuario en el agente de código con una excepción para un ingeniero, junto con un límite Lifetime en el proyecto de extracción:
Ambas reglas se comprueban en cada petición coincidente y ambas deben autorizarla. La excepción amplía el límite de un ingeniero sin flexibilizar el de los demás y, dado que reemplaza todos los períodos, vuelve a incluir los de la regla base.
Inicie en modo audit y atribuya los costes. Ejecute mode: audit durante una semana: se realiza el seguimiento del uso y se envían alertas sin bloquear ninguna petición. Analice las alertas al 75%, ajuste los valores al tráfico real y pase a aplicar restricciones (enforce). Etiquete cada cuenta virtual y exija la selección de equipo en los PATs; el informe de imputación de costes se generará de forma automática: la finalidad de la atribución de costes por equipo.
Los dos sistemas aplican las reglas en sentidos opuestos. La limitación de velocidad opera bajo el principio de primera coincidencia (first-match-wins); exactamente una regla bloquea la petición. Budget V2 exige que todas las reglas autoricen el acceso (all-must-pass); cualquier regla coincidente puede bloquear. Si aplica el modelo mental de uno sobre el otro, las directivas producirán resultados inesperados.
Los presupuestos no se pueden definir en tokens y los límites de velocidad no se pueden definir en dólares. Necesita ambos. Asimismo, la URL de la documentación es /ai-gateway/ratelimiting, en una sola palabra; con guion devolverá un error 404.
El seguimiento de costes de audio es más limitado que el de tokens. Cubre text-to-speech y speech-to-text de ElevenLabs y Google Vertex; otros proveedores de audio registran el uso pero no el coste por carácter o por segundo, y la tarificación privada de audio está disponible únicamente para Google Vertex. Las operaciones de speech-to-text sin duración reportada por el proveedor se calculan a coste cero: un presupuesto permitirá tráfico ilimitado si interpreta que es gratuito.
Pasar de peticiones a tokens requiere una configuración sencilla y ofrece un gran impacto. Un contador de peticiones indica el nivel de actividad; un contador de tokens indica lo que está comprando; un presupuesto indica cuándo debe detenerse.
Estructure adecuadamente las capas y el resto se ejecutará de forma fluida: los límites de tokens suavizan la carga por minuto, los límites de peticiones protegen la vía de acceso, los presupuestos regulan el gasto mensual y un límite Lifetime previene costes descontrolados. El comportamiento descrito en este artículo corresponde a la documentación de TrueFoundry a fecha de septiembre de 2026.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




La misma idea —limitar lo que un llamante puede consumir en una ventana—, pero cambia la unidad. La limitación de tasa de API clásica cuenta solicitudes, lo que funciona cuando las solicitudes cuestan más o menos lo mismo. Las solicitudes a LLM varían en órdenes de magnitud en tokens, así que un límite de tokens refleja mucho mejor el consumo real. Use ambos: los tokens gobiernan el ritmo de gasto y las solicitudes protegen la conexión frente a las tormentas de reintentos.
Ambos. Un límite de tokens es un control de rendimiento sobre una ventana móvil: impide que un llamante acapare la capacidad ahora mismo. Un presupuesto es un control financiero sobre un periodo de calendario: impide que un equipo gaste de más este mes. Un límite de tokens no puede expresar dólares, ya que la misma cantidad de tokens cuesta importes distintos en modelos distintos, y un presupuesto no dice nada sobre el minuto actual.
Una solicitud fallida —rechazada por el gateway, o fallida por el proveedor con un 4XX o un 5XX— cuenta como una solicitud para cada regla requests_per_* con la que coincidió. La única excepción es una solicitud ya rechazada con un 429 por el propio límite de tasa. Los límites de tokens no se ven afectados: una solicitud fallida no reporta tokens.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Aproximadamente 3-4 ms de sobrecarga, gestionando más de 350 RPS con una sola vCPU, en más de 1.000 LLM compatibles. La excepción es el clasificador LLM opcional, que añade una llamada real a un modelo antes de reenviar la solicitud.
Sí. El gateway es compatible con OpenTelemetry y se conecta a Grafana, Datadog o Prometheus. Cada llamada al clasificador LLM genera su propio span, por lo que la latencia del clasificador se ve por separado de la del modelo servido.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















