November 5, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La autorización de granularidad fina trata del tamaño del elemento sobre el que estás decidiendo, no del mecanismo con el que decides. La autorización de granularidad gruesa pregunta: «¿puede esta identidad usar la pasarela de AI?». La autorización de granularidad fina pregunta: «¿puede esta identidad llamar a la herramienta delete_issue en el servidor MCP de Linear, justo ahora, para esta persona?».
El cambio se despliega a lo largo de cuatro dimensiones independientes, que conviene separar porque implican costes distintos:
La mayoría de las publicaciones sobre control de acceso de granularidad fina reducen todo esto a un único control deslizante etiquetado como «más seguro» y lo suben al máximo. Ese es el error. La granularidad de sujeto y de acción son casi gratuitas: elegir un usuario en lugar de un grupo, o un permiso individual en lugar de un paquete, no cuesta nada en el momento de auditar. La granularidad de recurso y de ocasión es donde realmente llega la factura.
La granularidad también es ortogonal a la elección entre RBAC y ABAC. Los roles sencillos pueden expresar permisos muy finos si limitas estrictamente las asignaciones (bindings), y las políticas basadas en atributos pueden ser desesperadamente gruesas. El modelo es el cómo decides; la granularidad es sobre qué decides.
Hagamos cuentas. Cuarenta ingenieros y un permiso para toda la pasarela otorgan a una revisión de acceso 40 estados que confirmar. Aplica el alcance por recurso a lo largo de 12 servidores MCP y tendrás 480. Pasa al nivel de herramienta a razón de 25 herramientas por servidor y tendrás 12.000 celdas. Añade la aprobación por invocación y el objeto de revisión deja de ser una cuadrícula: se convierte en un registro de eventos.
Nadie audita 12.000 celdas. En su lugar, aparece el verdadero riesgo del exceso de granularidad:
Por lo tanto, la limitación es la capacidad de respuesta. En cualquier peldaño deberías poder responder a tres preguntas sin necesidad de ejecutar un proceso: quién puede acceder a este recurso, qué puede hacerle y cuándo fue la última vez que lo hizo. Si rompes eso, habrás comprado precisión a costa de perder visibilidad.
Esta es también la razón por la que los permisos de menor privilegio y la máxima granularidad no son el mismo objetivo. El menor privilegio otorga solo la autoridad que requiere el trabajo; no dice que debas dividirla en porciones tan finas como el sistema permita. Un rol que contiene exactamente los siete permisos que necesita un trabajo es de menor privilegio. Setecientas concesiones separadas que suman esa misma autoridad solo resultan caras.
Cuatro peldaños, de grueso a fino, cada uno con una función específica. La regla es mantenerse en el peldaño más bajo que contenga el riesgo.
Dos propiedades hacen que sea una escala y no un menú a la carta.
Los peldaños se componen hacia abajo, no lateralmente. El peldaño 3 solo importa para las identidades que superaron el peldaño 2, y una herramienta deshabilitada es inalcanzable sin importar el rol que tenga alguien. Puedes ser generoso en un peldaño grueso y estricto en uno fino, y la estrictez se mantendrá.
Cada peldaño tiene un formato de registro diferente. Los peldaños 1 y 2 son tablas que lees. El peldaño 3 es una lista que comparas contra el trimestre anterior. El peldaño 4 es un registro del que extraes muestras. Tratar el peldaño 4 como una tabla es la razón por la que los equipos terminan con doscientas políticas que nadie puede resumir.
Usar el peldaño 1 para hacer el trabajo del peldaño 2. El error más común con diferencia. Alguien necesita un servidor MCP, así que se le asigna un rol a nivel de tenant que contiene mcp-server:ReadMcpServer, el cual da acceso a todos los servidores MCP del tenant. La concesión parece limitada porque la lista de permisos es corta. Pero no lo es.
Subir al peldaño 4 para evitar una conversación sobre el peldaño 2. Las políticas de aprobación son atractivas porque posponen la decisión. Pero una puerta de control en una herramienta a la que las personas equivocadas pueden acceder directamente es una puerta delante de un campo abierto. Corrige primero la asignación (binding).
Tratar los interruptores a nivel de herramienta como un límite contra solicitantes no confiables. Deshabilitar una herramienta la elimina del descubrimiento y bloquea su invocación: algo idóneo contra un agente que de otro modo elegiría algo peligroso de una lista larga. No reemplaza los permisos del sistema ascendente sobre la credencial.
No revisar nunca los peldaños finos. Las concesiones gruesas se revisan porque son llamativas. Una herramienta habilitada para una migración puntual hace ocho meses resulta invisible. Audita las listas de herramientas habilitadas con la misma frecuencia con la que auditas los roles.
TrueFoundry implementa los cuatro peldaños. Un sujeto (usuario, equipo, cuenta virtual o agente) más un recurso más un rol forman una asignación de rol (role binding), gestionada de manera independiente a la configuración del recurso, de modo que puedes cambiar quién puede acceder a algo sin volver a desplegarlo.
Hay tres roles de tenant integrados: Admin (control total, no editable), Member (la base predeterminada y editable) y Read-Only Member (solo lectura, también fijo).
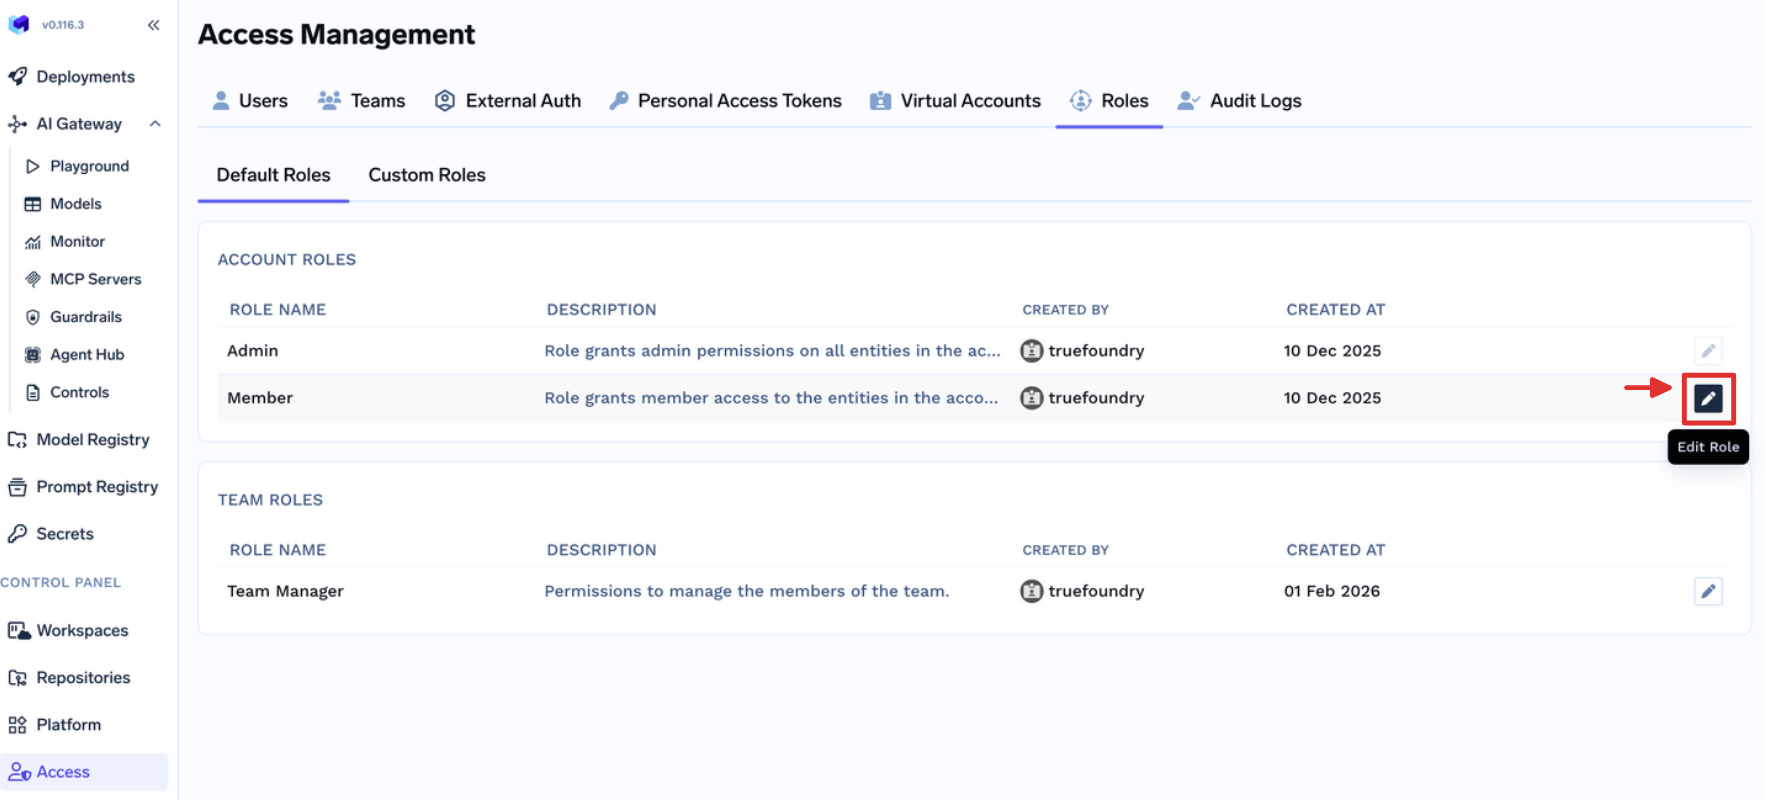
Cuando estos resulten demasiado amplios o demasiado reducidos, crea un rol personalizado desde Access > Custom Roles. El catálogo es la clave de los permisos de granularidad fina aquí: cada entrada es una clave recurso:Acción agrupada por tipo de recurso, y la nomenclatura te muestra qué granularidad existe antes de que diseñes nada.
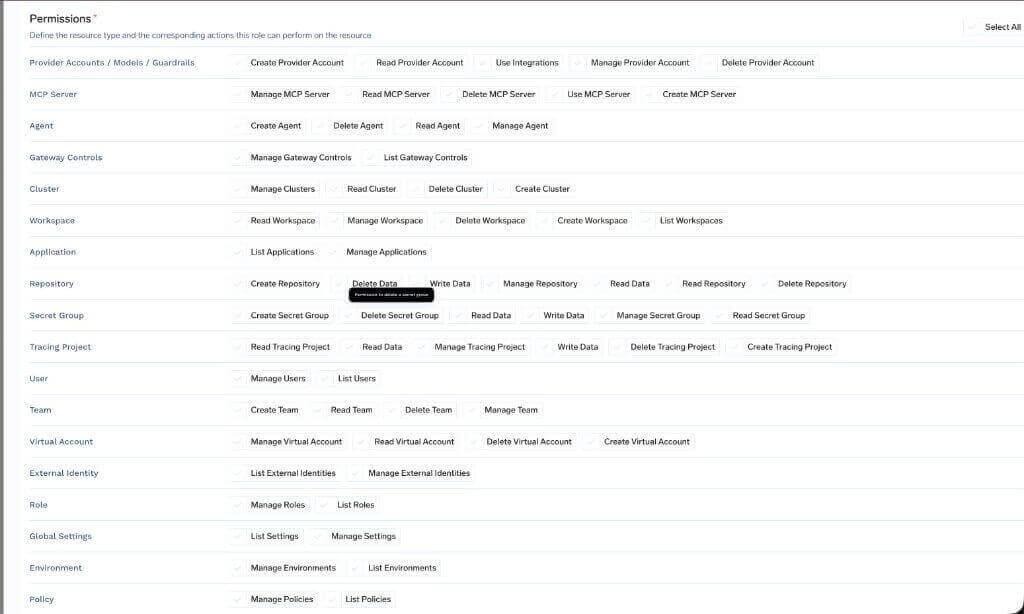
Crear un servidor MCP y gestionarlo son claves independientes. Esas divisiones otorgan a la estructura de un modelo de autorización su resolución útil.
Una regla rige este peldaño: los permisos de roles personalizados se aplican a todos los recursos del tipo seleccionado. Para un solo recurso, utiliza la página de Access Control de ese recurso. Hacer lo contrario es caer en el error mencionado de «usar el peldaño 1 para hacer el trabajo del peldaño 2».
Abre el menú de tres puntos del recurso y selecciona Access Control.
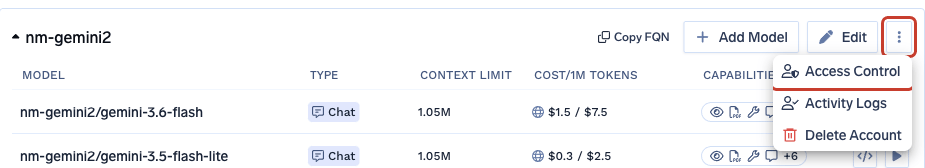
Elige sujetos y un rol. El panel lateral enumera las acciones que incluye cada rol, de forma que ves la concesión antes de aplicarla.

Los roles dependen del recurso: Manager y User en una cuenta de proveedor; MCP Server Manager, MCP Server User y MCP Server Approver en un servidor MCP; Agent Manager y Agent Access en un agente; y niveles de admin, member y viewer en clusters y workspaces. Conceder permisos a un equipo es mejor que concederlos a una persona individual: las futuras incorporaciones los heredan automáticamente y la tabla de concesiones se mantiene lo suficientemente corta como para poder leerla. El modelo de control de acceso de MCP está construido sobre este peldaño.
Este es el peldaño que los equipos consideran en último lugar y el que los agentes más necesitan. En un servidor MCP Remote o gestionado por TrueFoundry, la pestaña Tools controla qué herramientas se pueden llamar.

Las herramientas deshabilitadas se omiten en las respuestas de tools/list y no se pueden invocar. Ambas partes cuentan: el modelo no puede elegir lo que nunca ve, y la pasarela rechaza la llamada si algo intenta solicitarlo de todos modos.
El interruptor Enable new tools by default establece el comportamiento base, y es una decisión de diseño real. Activado, la lista funciona como una denylist y las nuevas herramientas del proveedor aparecen automáticamente. Desactivado, funciona como una allowlist y las nuevas herramientas ascendentes permanecen ocultas hasta que alguien las habilite. La allowlist es lo adecuado para cualquier elemento que toque producción.
Edit Tool realiza algo más sutil. Junto con la modificación de la descripción, puedes configurar MCP Tool Annotations en None, Read-only o Destructive, lo que define readOnlyHint o destructiveHint.
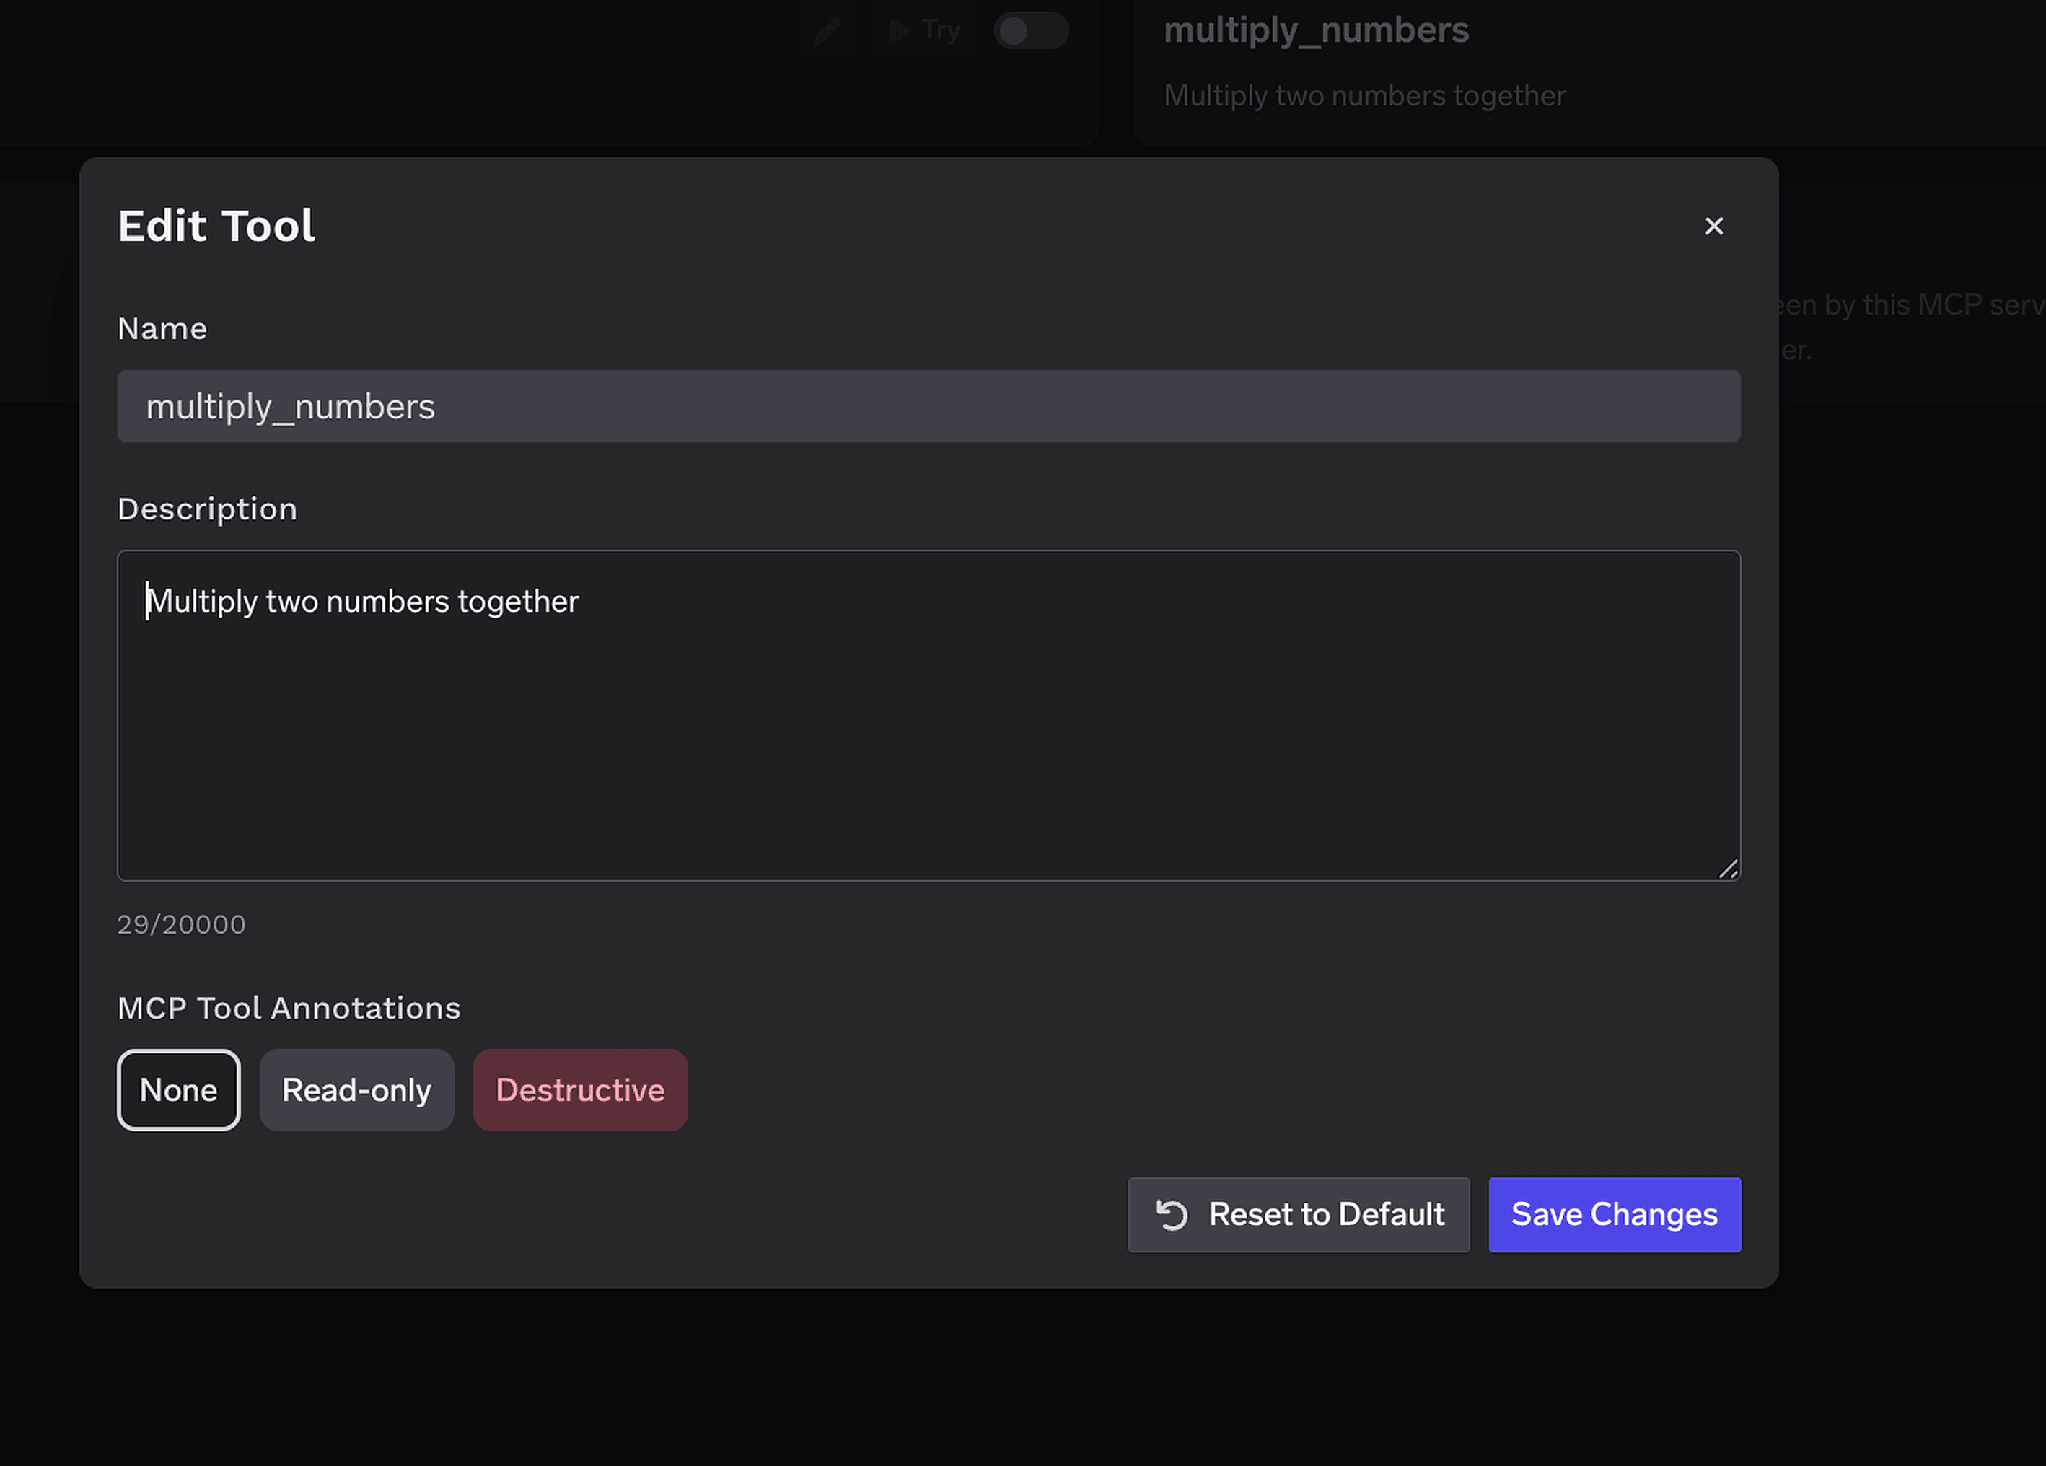
Esa anotación es la etiqueta que lee el peldaño 4, por lo que una clasificación puntual se convierte en una política continua sin necesidad de nombrar las herramientas dos veces.
Las políticas de aprobación de herramientas retienen una llamada a tools/call en la pasarela, crean una solicitud pendiente y notifican a los aprobadores. La herramienta no se ejecuta. Una vez aprobada, las llamadas se realizan con éxito durante una ventana de validez; transcurrida esta, se requiere una nueva aprobación.
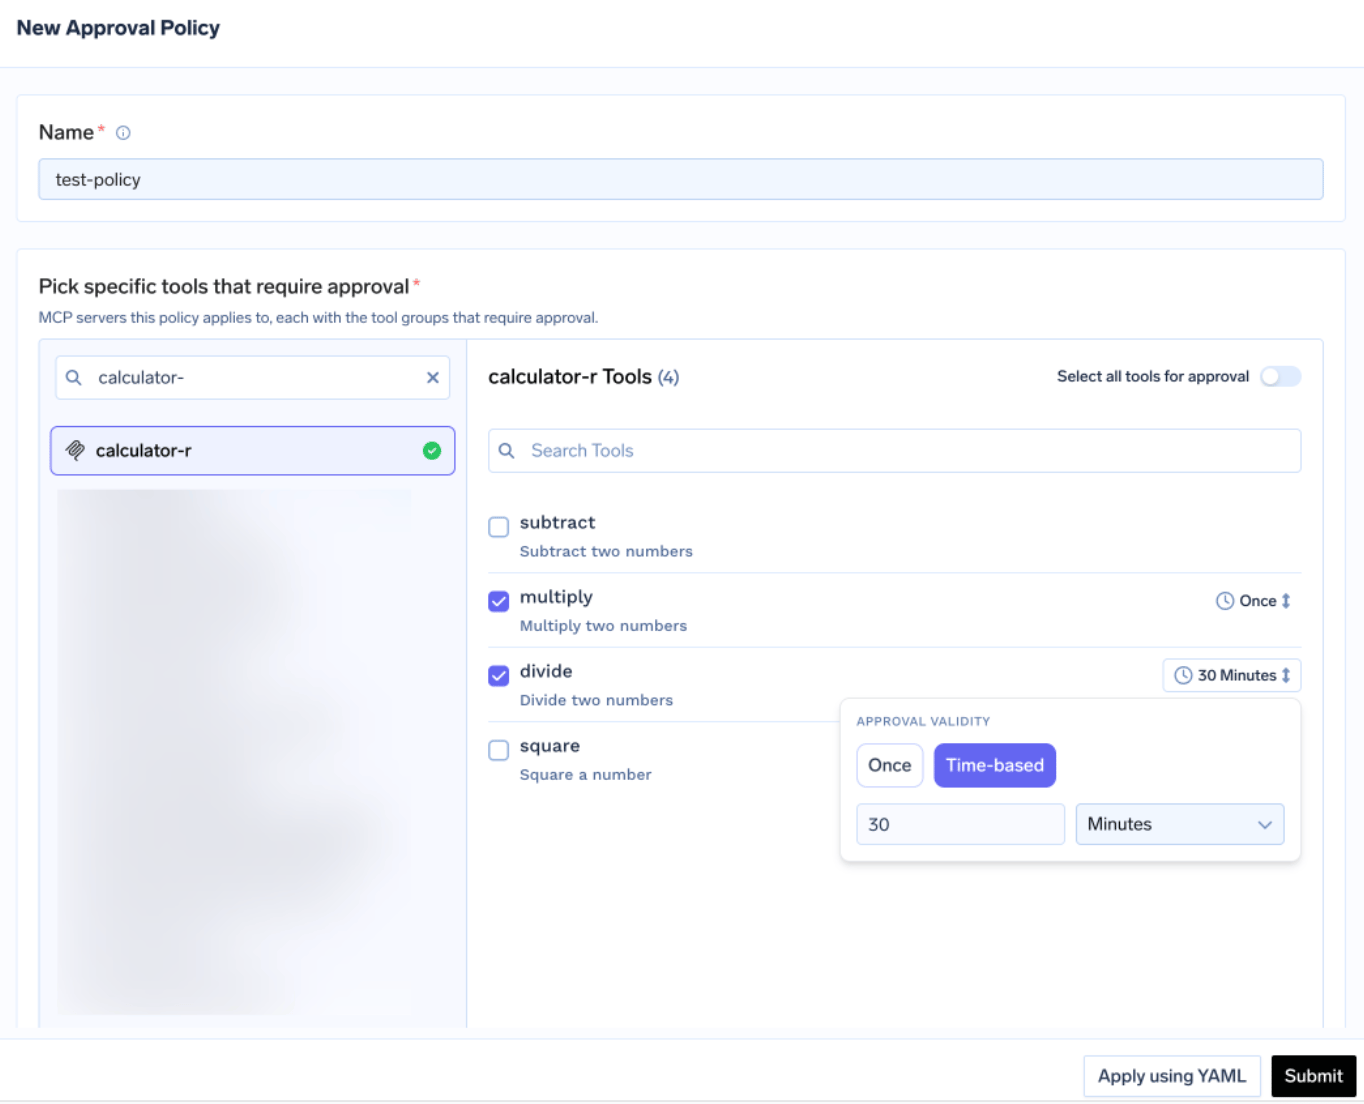
Dos controles ajustan la granularidad y ambos tienen reglas de precedencia documentadas:
Las concesiones se limitan al solicitante más el servidor y la herramienta específicos, y no se comparten entre usuarios. Los aprobadores trabajan desde Pending Requests, donde se muestra la herramienta, la política, el solicitante, la ventana de validez y los argumentos de la herramienta.
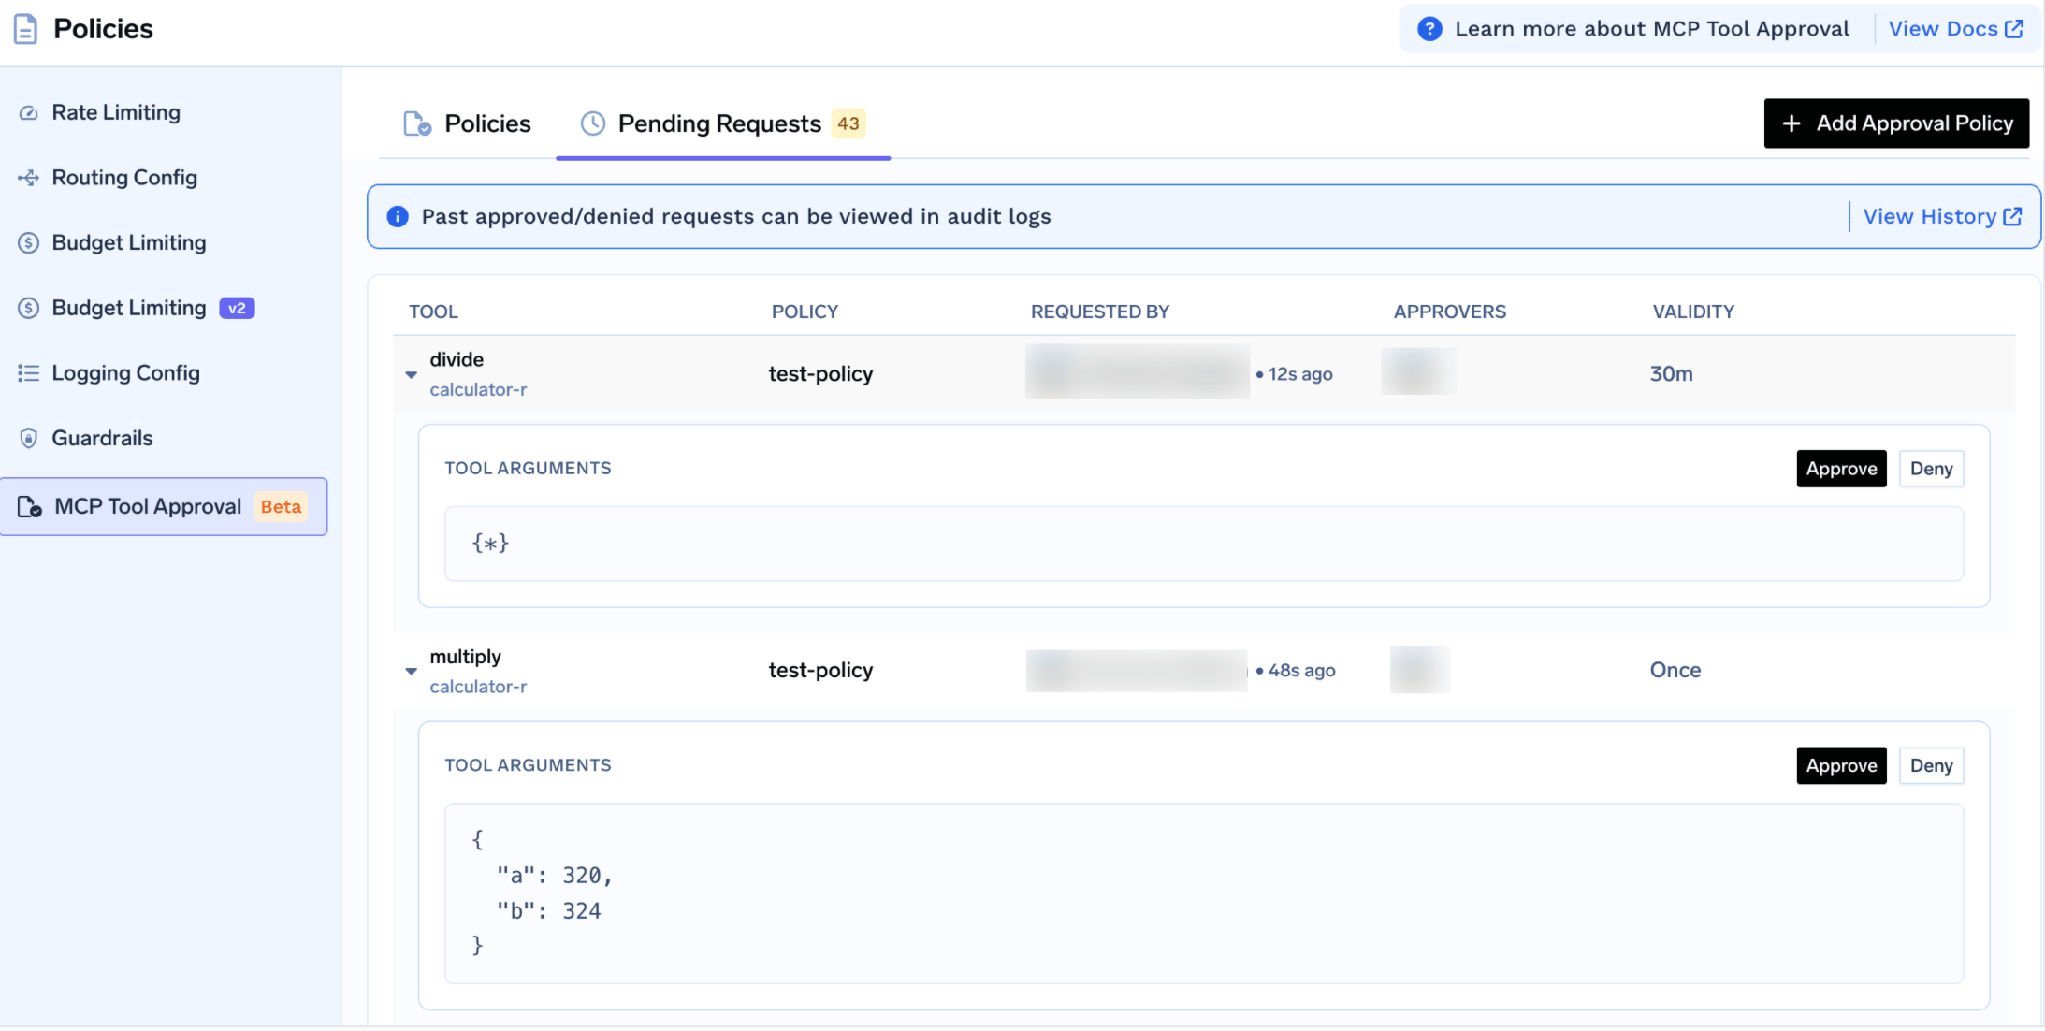
Quién puede hacer qué aquí también está dividido entre peldaños. Solo los administradores del tenant pueden crear, actualizar o eliminar políticas. Aprobar o denegar requiere ser admin del tenant o tener el rol MCP Server Approver en ese servidor, añadido desde su lista de Collaborators.
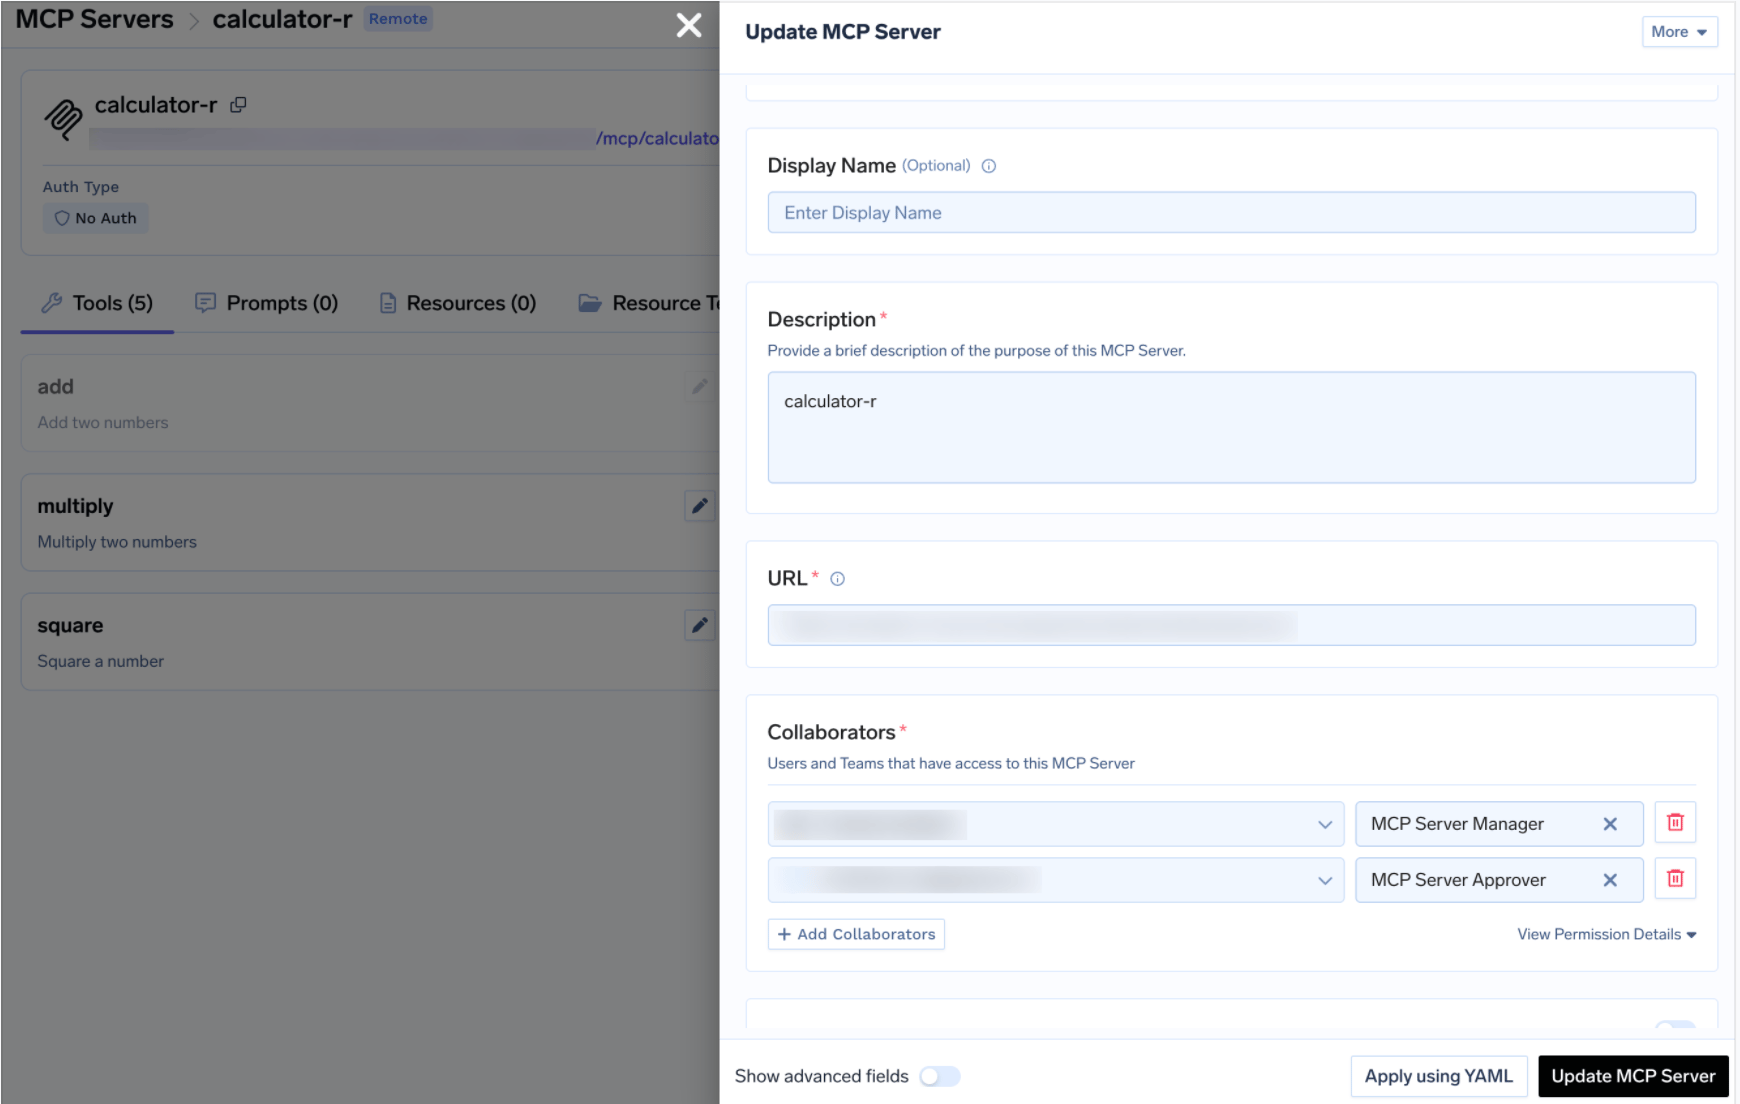
Si un servidor designado por una política no tiene colaboradores con rol de Approver, solo los administradores del tenant podrán decidir: una forma silenciosa de canalizar cada aprobación hacia tres personas sobrecargadas.
Un límite honesto: una denegación no es un bloqueo definitivo. Se registra, y la siguiente llamada genera una nueva solicitud. Para detener el acceso de forma duradera, vuelve a bajar por la escala: elimina el acceso del sujeto al servidor o deshabilita la herramienta. El peldaño 4 rige las ocasiones, no la autoridad.
Los grupos de secretos muestran con máxima claridad por qué la granularidad de acción justifica su esfuerzo, ya que lo que se debe separar es ver un valor de depender de él.
Un grupo de secretos organiza secretos relacionados para que gestiones el acceso una sola vez y no por cada secreto. Cuando guardas un secreto, el valor va a tu propio gestor de secretos (AWS SSM, GCP Secret Manager, HashiCorp Vault, Azure Vault) y TrueFoundry almacena un nombre totalmente cualificado (FQN) al que haces referencia desde despliegues, montajes de volúmenes, integraciones y claves de API de modelos de la pasarela.
Esa indirección es el mecanismo: un despliegue que consume un secreto por FQN no requiere que ningún humano haya leído el valor. Esto hace que esta separación sea real y no cosmética:
La fila de Viewer es el beneficio clave. Alguien puede ver que stripe-live-key existe aquí (suficiente para revisar de qué depende un proyecto) sin que el valor aparezca en su pantalla. El catálogo de permisos hace explícita esa misma separación: secret-group:ReadSecretGroup permite ver el grupo, secret-group:ReadData permite leer los valores. Son claves distintas, por lo que un rol personalizado puede contener una sin la otra.
Dos advertencias, ya que aquí la documentación es más estrecha que el concepto. Un admin de tenant tiene acceso a todos los grupos de secretos de forma predeterminada; para miembros y equipos, debes asignar un rol individualmente en cada grupo. Además, la lista de roles por recurso nombra un cuarto rol, Secret Group Access, junto a Admin, Editor y Viewer (aunque la página de gestión de secretos solo documenta los tres anteriores, por lo que no detallaremos lo que otorga el cuarto). Comprueba tu propia consola antes de construir un proceso sobre él. [VERIFY]
El patrón es generalizable. Siempre que un recurso tenga tanto una descripción como un contenido (payload), busca claves separadas para cada uno (los repositorios tienen la misma separación entre ReadRepository y ReadData) y concede la descripción sin el contenido siempre que sea suficiente.
Las concesiones se combinan, y eliminar una no elimina la otra. Un sujeto puede tener acceso de forma directa y heredarlo a través de un equipo. TrueFoundry combina ambos, por lo que revocar la concesión directa deja intacta la heredada. Comprueba ambas, en ese orden. La granularidad fina empeora esto: más concesiones pequeñas significan más lugares donde buscar.
Editar un rol predeterminado de equipo lo cambia para todos los equipos. Team Member y Team Manager se editan en Access > Default Roles, y el cambio es global. Añadir virtual-account:ManageVirtualAccount para que un equipo pueda recuperar tokens concede esa capacidad en todos los equipos. Las personas siguen limitadas a sus propios equipos, pero la capacidad se propaga. Es un cambio del peldaño 1 disfrazado de peldaño 2.
Una aprobación pendiente es una respuesta correcta, no un error. Mientras una solicitud está pendiente, la pasarela devuelve un resultado JSON-RPC con isError: false y _meta.approval_status: "pending", cuyo texto pide al emisor que espere. Un agente que solo comprueba errores lo tratará como el resultado real de una herramienta y continuará. Lee _meta.approval_status y vuelve a intentarlo.
La autorización de granularidad fina se vende como un selector que simplemente se incrementa. En realidad es una escala por la que se asciende deliberadamente, deteniéndose cuando el riesgo deja de aumentar en lugar de cuando la plataforma se queda sin opciones.
Cada peldaño responde a una pregunta diferente. La capacidad del tenant pregunta qué puede hacer alguien en general. Los roles por recurso preguntan dónde. Los permisos a nivel de herramienta preguntan qué operaciones existen para ser elegidas. La aprobación por invocación pregunta si esta llamada concreta debería ocurrir ahora. En ese orden, cada uno restringe al anterior y todos se mantienen legibles.
Fuera de orden (un control por llamada que protege una asignación demasiado amplia, o un rol a nivel de tenant que sustituye a una concesión de recurso) obtienes un modelo que parece riguroso en un diagrama pero que no se puede explicar durante una auditoría. El modelo de autorización con más granularidad no es el mejor. El mejor modelo es el de mayor granularidad que puedas explicar claramente en voz alta.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




La autorización de grano fino es un control de acceso que decide sobre unidades pequeñas en lugar de sobre sistemas completos: un recurso con nombre en lugar de un tipo de recurso, una acción en lugar de acceso total, una herramienta en lugar de un servidor, una llamada en lugar de una concesión permanente. El mecanismo pueden ser roles, atributos o código de políticas; la granularidad se refiere al tamaño de lo que se decide, no a cómo se decide.
Tan fino como exija el riesgo, pero no más de lo que usted pueda auditar. Por cada nivel que añada, pregúntese si aún puede responder a «quién puede hacer qué con este recurso» a partir de una tabla y no de una investigación. La granularidad de sujeto y de acción es barata. La granularidad por recurso y por llamada conlleva un coste real de revisión, así que resérvela para las operaciones irreversibles o visibles desde el exterior.
Los permisos a nivel de herramienta deciden qué herramientas concretas de un servidor puede invocar un agente. Los agentes los necesitan porque un agente elige sus propias herramientas entre las que descubre, y sus entradas pueden ser adversarias: un documento envenenado puede dirigirlo hacia una herramienta destructiva. Desactivar una herramienta en TrueFoundry la omite de tools/list y bloquea su invocación, de modo que el modelo no puede elegir lo que no ve. Qué es la autorización en MCP explica el modelo en el que se enmarca.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Sí. Incluye un MCP Gateway, un Agent Gateway y un MCP & Agents Registry con control de acceso a nivel de herramienta. Los agentes creados con LangGraph, CrewAI, AutoGen o un framework propio pueden gobernarse de forma centralizada.
Sí. La pasarela es compatible con OpenTelemetry y se integra con Grafana, Datadog, Prometheus o tu pila preferida. Rastrea cada solicitud desde la instrucción (prompt) hasta la ejecución de la herramienta y el modelo, así obtienes un registro unificado sin tener que reemplazar lo que ya tienes en funcionamiento.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada