November 1, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
ElEl servidor MCP de dbt es un servidor MCP remoto operado por dbt Labs como parte de dbt Cloud. Model Context Protocol es el estándar abierto que permite a un agente descubrir y llamar a herramientas en un sistema externo, y la implementación de dbt expone tu proyecto de dbt Cloud como herramientas invocables. Según la documentación de TrueFoundry, puede consultar métricas a través de la capa semántica (Semantic Layer), inspeccionar metadatos de modelos y ejecutar SQL.
La mayoría de los servidores MCP de datos proporcionan a un agente datos : Snowflake proporciona filas, Postgres proporciona filas. El servidor MCP de dbt proporciona el mapa: qué modelos existen, a partir de qué se han creado, qué significa cada columna, qué pruebas los protegen y cómo define tu organización una métrica.
Una nota de honestidad: la documentación describe áreas de capacidad, no una lista de funciones, y menciona una herramienta: execute_sql. Lee cualquier cosa más allá de las familias anteriores en la pestaña Herramientas . [VERIFICAR] La página de documentación no describe herramientas de activación de trabajos ni de orquestación de ejecuciones, por lo que no hemos afirmado que existan.
Este es el tipo de fallo que todo equipo de analítica conoce. Alguien le pregunta a un agente: "¿Cuál fue la retención neta de ingresos el trimestre pasado?". El agente tiene credenciales del almacén de datos. Ve fct_subscriptions, dim_customers y cuarenta columnas con nombres como mrr_amt y mrr_amount_usd. Así que escribe una consulta. Obtiene un número. Es incorrecto, y no hay nada que lo indique.
El agente no falló en el SQL. Falló en la definición. Adivinó qué significaba cada columna, cómo debía tratarse la pérdida de clientes (churn), si incluir las reducciones de categoría, y produjo una respuesta segura basada en cuatro suposiciones. El servidor MCP de dbt elimina las conjeturas de dos maneras.
Linaje y contexto de las columnas. Un agente puede preguntar a partir de qué se ha creado fct_subscriptions, qué significa cada columna y qué pruebas se han superado en ella: el contexto que tiene un analista humano y que una conexión directa al almacén de datos no posee.
Métricas con nombre. Si la retención neta de ingresos está definida en la capa semántica, el agente no la redacta en absoluto. Llama a la métrica por su nombre con una granularidad y una dimensión, y dbt compila el SQL. La definición reside en el control de versiones, revisada por sus propietarios. Es por eso que MCP de capa semántica es su propio término de búsqueda: separa a un agente que escribe consultas de uno que lee las respuestas acordadas.
Ese es el argumento a favor de conectar dbt antes que un almacén de datos. Un agente de texto a SQL sin capa semántica es una máquina de alucinaciones con permisos de consulta. Con dbt por delante, tiene un diccionario.
Los flujos de trabajo útiles encadenan herramientas en lugar de llamar a una sola:
Tres de esos cuatro solo necesitan metadatos, por lo que esta integración es fácil de hacer segura.
Seremos más específicos aquí que con un servidor de almacén de datos; inflar el riesgo sería deshonesto.
La lectura de metadatos es de bajo riesgo. Los nombres de los modelos, las descripciones de las columnas, los bordes del linaje y los resultados de las pruebas no son datos de clientes. Nada se filtra y nada cuesta dinero.
execute_sql es donde comienzan las consecuencias. La documentación es explícita: desactívalo a menos que los agentes necesiten ejecutar SQL directamente. Para funcionar, requiere un ID de entorno de desarrollo y un ID de usuario, lo cual ya es un aviso en sí mismo. Un agente que ejecute bucles sobre una tabla grande supone una factura del almacén de datos y, dependiendo del alcance de los tokens, una posible vía de fuga de datos.
Las consultas a la capa semántica son el segundo punto. Son más seguras que el SQL sin procesar porque la definición es fija, pero no son gratuitas. Una consulta de métricas se traduce en trabajo para el almacén de datos, y si un agente la despliega en todas las dimensiones durante tres años de datos diarios, generará un escaneo costoso.
El alcance del token multiplica ambos factores. Un token de acceso personal (PAT) hereda los permisos del usuario; un token de servicio utiliza conjuntos de permisos asignados. Un PAT perteneciente a un administrador de cuenta, pegado en la configuración de un agente, le otorga a ese agente acceso de administrador. La documentación recomienda usar un token de servicio para el acceso de lectura compartido, que es la opción predeterminada correcta para cualquier proceso desatendido. Además, tres cabeceras más un token, copiados en el portátil de cada analista, son imposibles de auditar cuando el equipo supera las quince personas.
Nada de esto es un argumento en contra de conectar dbt. Es un argumento a favor de contar con un plano de control delante, que es lo que un pasarela MCP.
dbt es no es una opción seleccionable con un solo clic en el catálogo de MCP gestionados. Se accede a través de Conectar cualquier servidor MCP remoto, porque requiere un token que tú creas y unas cabeceras que solo tú conoces.
Requisitos previos: una cuenta de dbt Cloud en los planes Starter, Team o Enterprise; acceso de administrador de cuenta; un entorno de producción, además de un entorno de desarrollo para execute_sql; y las funciones de IA de dbt habilitadas.
Paso 1: Crear un token de dbt. Utiliza un token de acceso personal para el acceso individual o cuando necesites execute_sql; utiliza un token de servicio para el acceso de lectura compartido. Cópialo inmediatamente.
Paso 2: Recopilar los ID numéricos, desde las URL de dbt Cloud:
Paso 3: Abrir el selector.EnMCP Gateway, haga clic enAñadir servidory eligeConectar cualquier servidor MCP remoto.
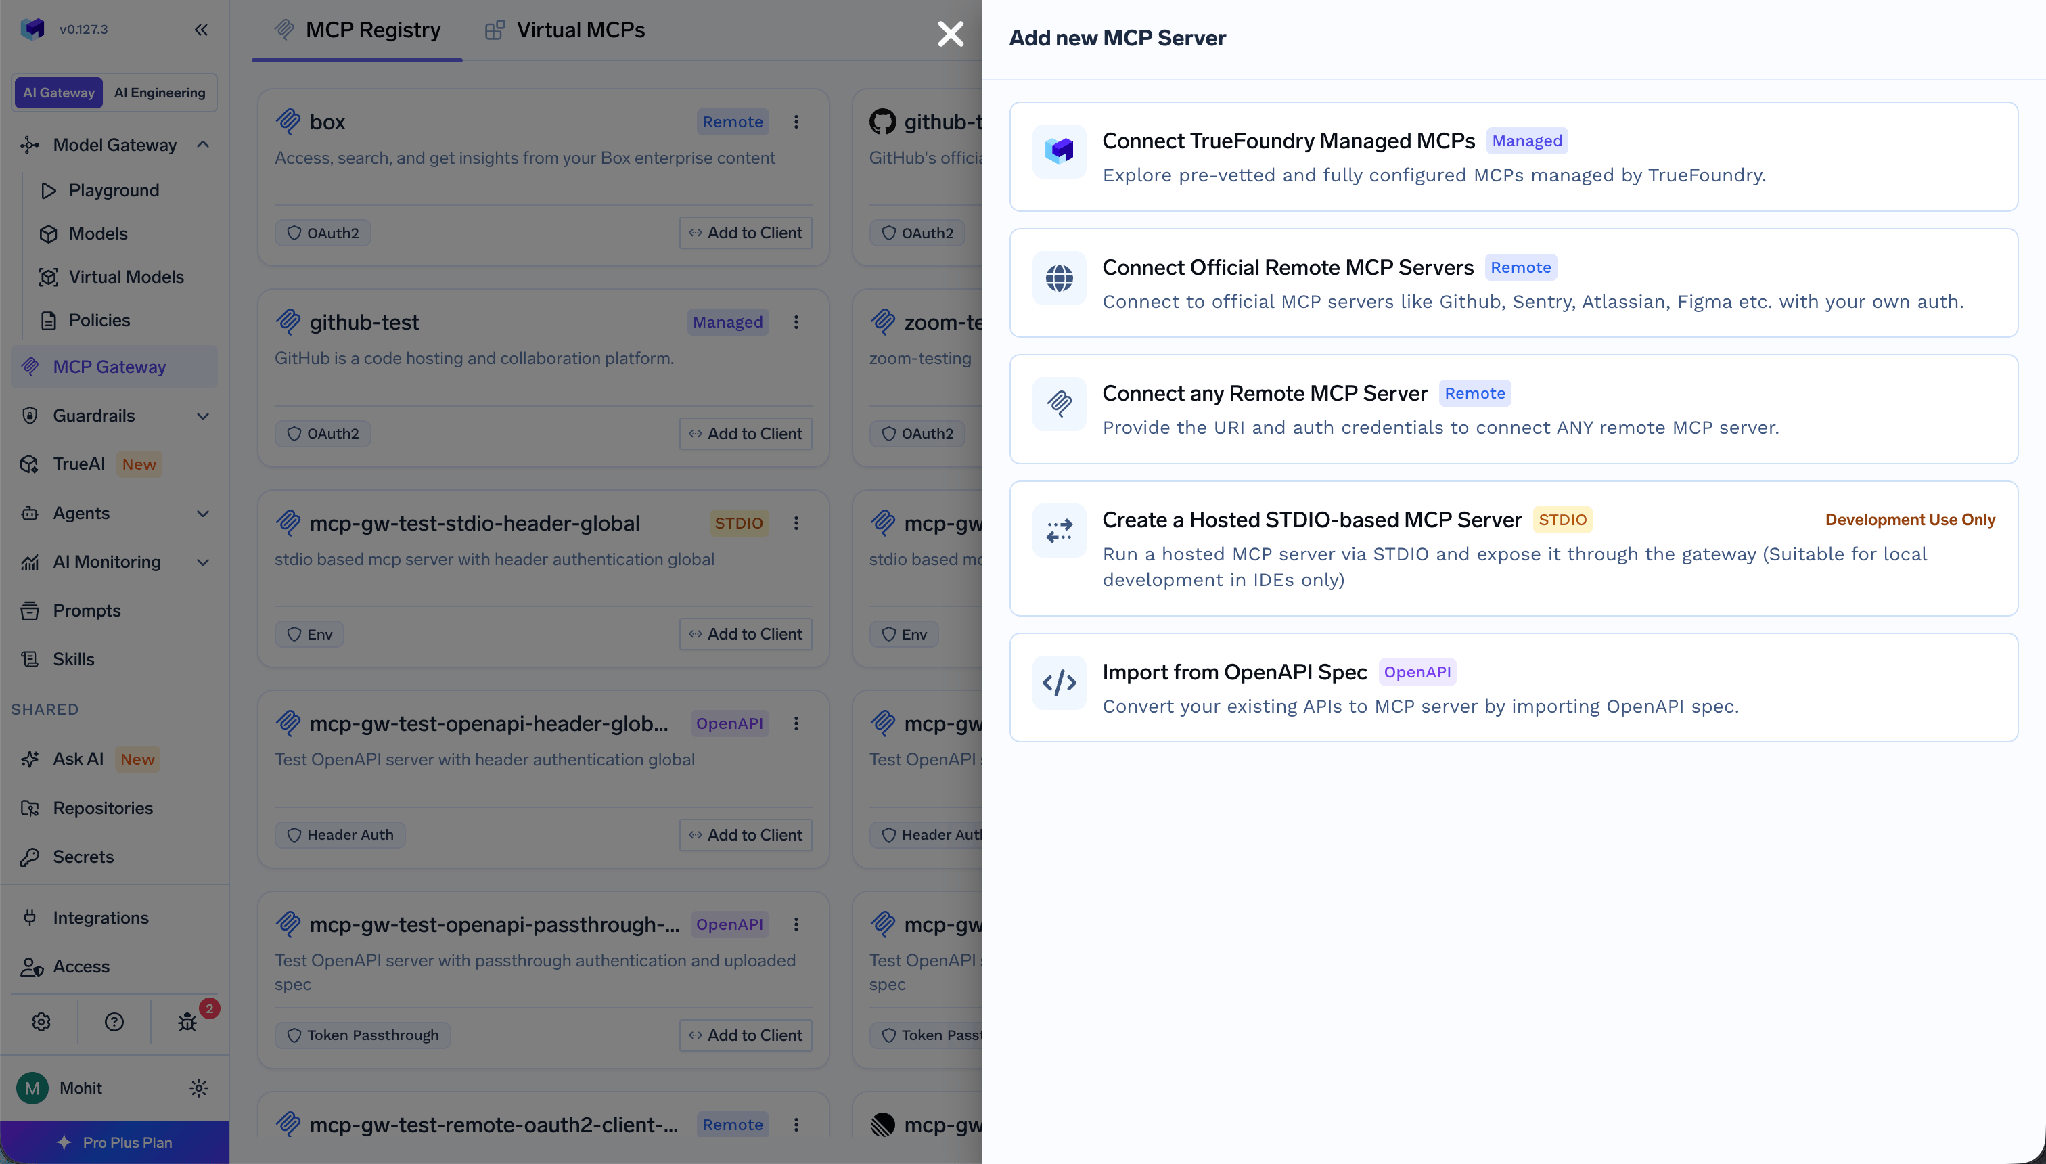
Paso 4: Configurar el servidor. Proporciona un Nombre,Descripción,URL,ColaboradoresyDatos de autenticación. La URL es el punto de conexión estándar de MCP de dbt:
https://cloud.getdbt.com/api/ai/v1/mcp/
Para cuentas multicelda, utiliza el nombre de host de tu celda; por ejemplo, https://abc123.us1.dbt.com/api/ai/v1/mcp/.
Paso 5: Configura la autenticación y las cabeceras. Añade la autenticación mediante token de portador (bearer token), configura el token de dbt y establece las cabeceras x-dbt-*. Para ocultar herramientas de riesgo en la propia conexión, añade x-dbt-disable-toolsets o x-dbt-disable-tools; son dos vías independientes para eliminar una herramienta, lo que constituye una defensa en profundidad.
TrueFoundry separa laautenticación de entrada autenticación, cómo un cliente se identifica ante la pasarela, desde autenticación de salida, cómo la pasarela se identifica ante dbt.
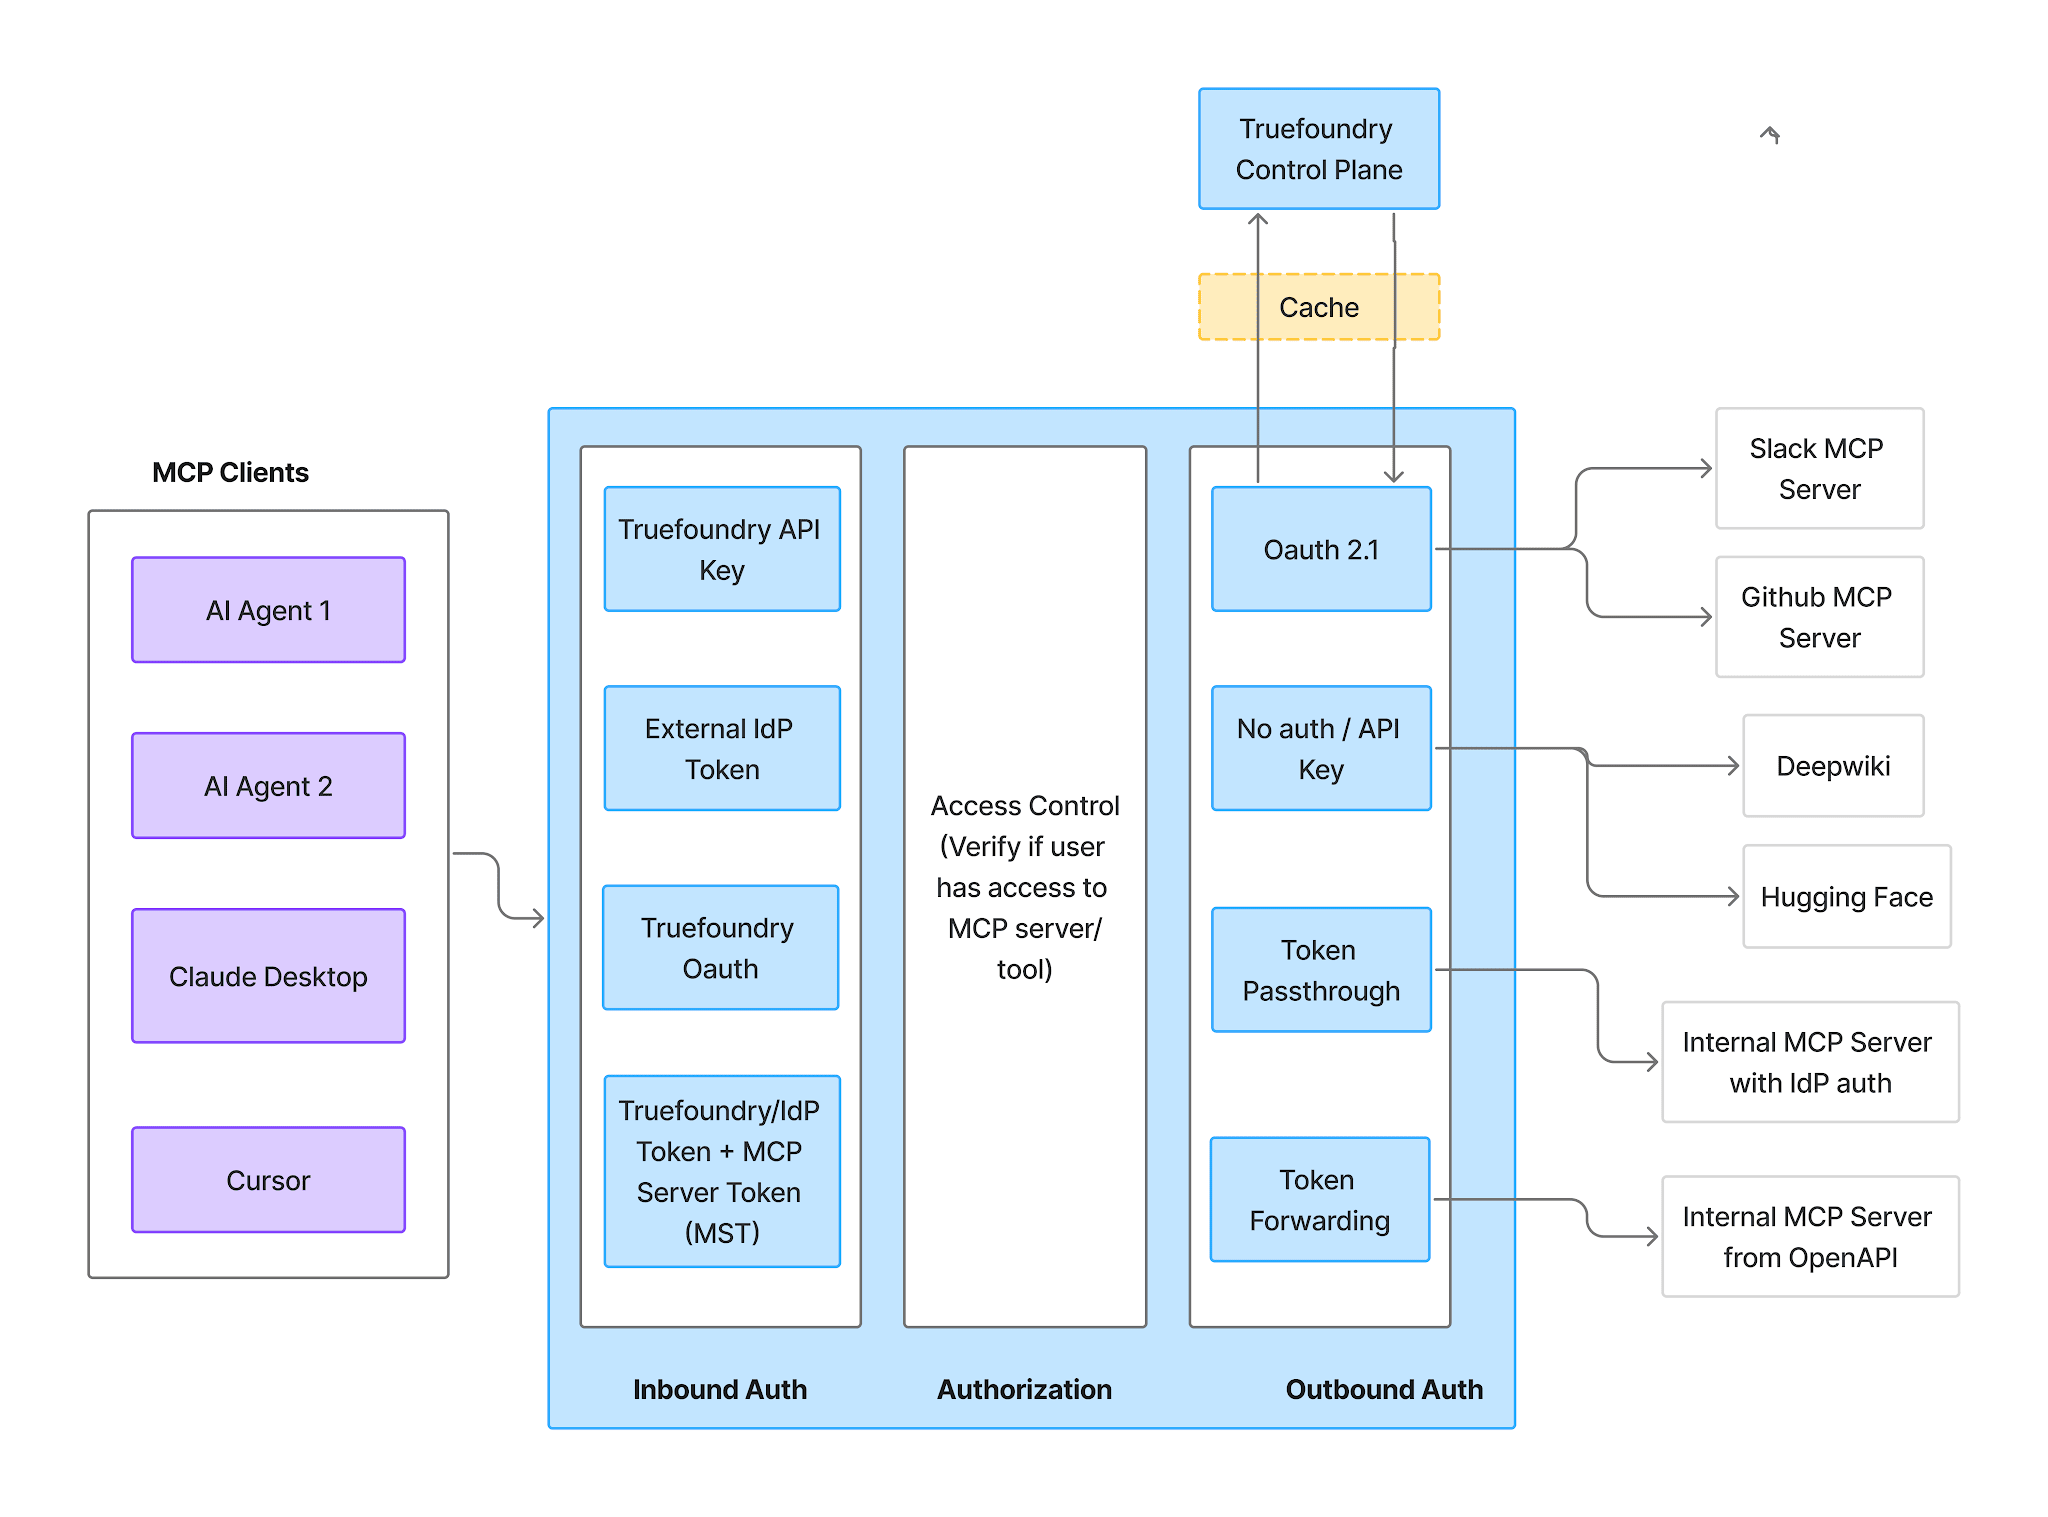
Entrada admite claves de API de TrueFoundry, tokens de cuenta virtual para llamadas de servicio a servicio, tokens de proveedor de identidad para JWT de tu propio IdP (Okta, Entra, Auth0, Cognito) y OAuth de TrueFoundry para herramientas de IDE. Una advertencia: los tokens de cuenta virtual otorgan el mismo acceso a todas las solicitudes, por lo que no pueden reflejar el alcance por usuario.
Salida para dbt es el Clave de API tipo, con dos modos de credenciales.
Credenciales compartidas significa una clave para todos: configure el nombre y el valor de la cabecera una sola vez. Este es el modo para un token de servicio con alcance a metadatos de solo lectura.
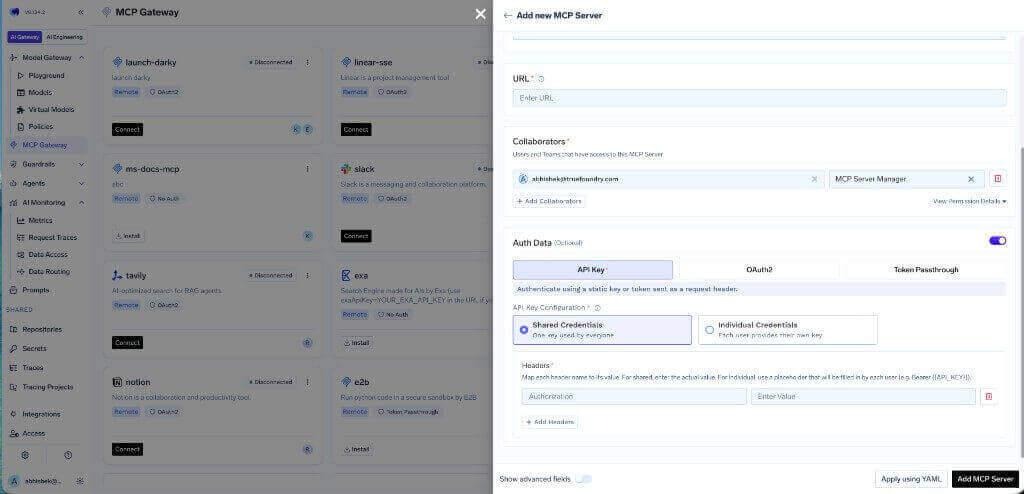
Credenciales individuales significa que cada usuario proporciona su propia clave: configure la cabecera con un marcador de posición como Bearer {{API_KEY}}, y cada persona añade su token a través de la Anulaciones de autenticación pestaña.
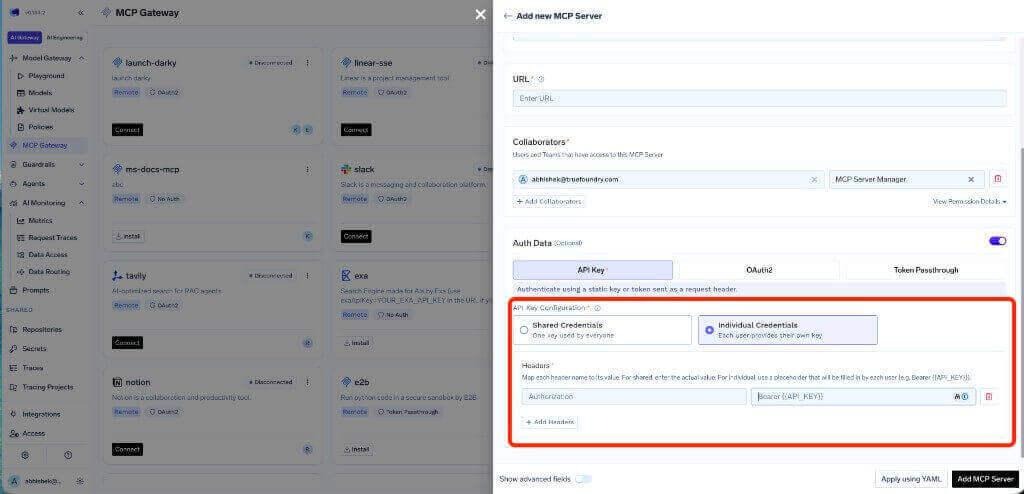
La correspondencia es directa: las credenciales compartidas se vinculan a un token de servicio; las credenciales individuales se vinculan a PATs, y es lo que necesita si execute_sql está habilitado, ya que mantiene la ejecución de SQL limitada a la persona que la realizó.
Dado que dbt utiliza autenticación mediante token de portador (bearer token), no hay pantalla de consentimiento OAuth ni URI de redirección aquí. Si configura OAuth2 en un servidor remoto autorregistrado, la URI de redirección es la devolución de llamada de su plano de control, https://<tfy-control-plane-base-url>/api/svc/v1/llm-gateway/mcp-servers/oauth2/callback, no la devolución de llamada auth.truefoundry.com utilizada por los MCP gestionados.
ElHerramientas pestaña es donde decide qué pueden hacer los agentes; para dbt, los cinco minutos más valiosos de la configuración.

Interruptores por herramienta. Desactive una herramienta y se omitirá por completo de tools/list; los clientes nunca la verán y no podrá ser invocada. Esto no es filtrado a nivel de prompt. La configuración recomendada para dbt es sencilla: deje activadas las herramientas de metadatos y descubrimiento, y desactive execute_sql a menos que un agente específico la necesite. Un agente que no puede llamar a execute_sql no puede ser inducido a realizar una consulta descontrolada.
Habilitar nuevas herramientas por defecto. Si se deja activado, las nuevas herramientas ascendentes aparecen automáticamente. Si se desactiva, solo estarán disponibles las herramientas que haya habilitado, por lo que una futura versión de dbt no podrá ampliar silenciosamente lo que pueden hacer los agentes.
Acción masiva. Cambia cada fila a una casilla de verificación para que pueda activar o desactivar muchas herramientas a la vez.
Haga clic en el lápiz de una herramienta para anular cómo se presenta al modelo:
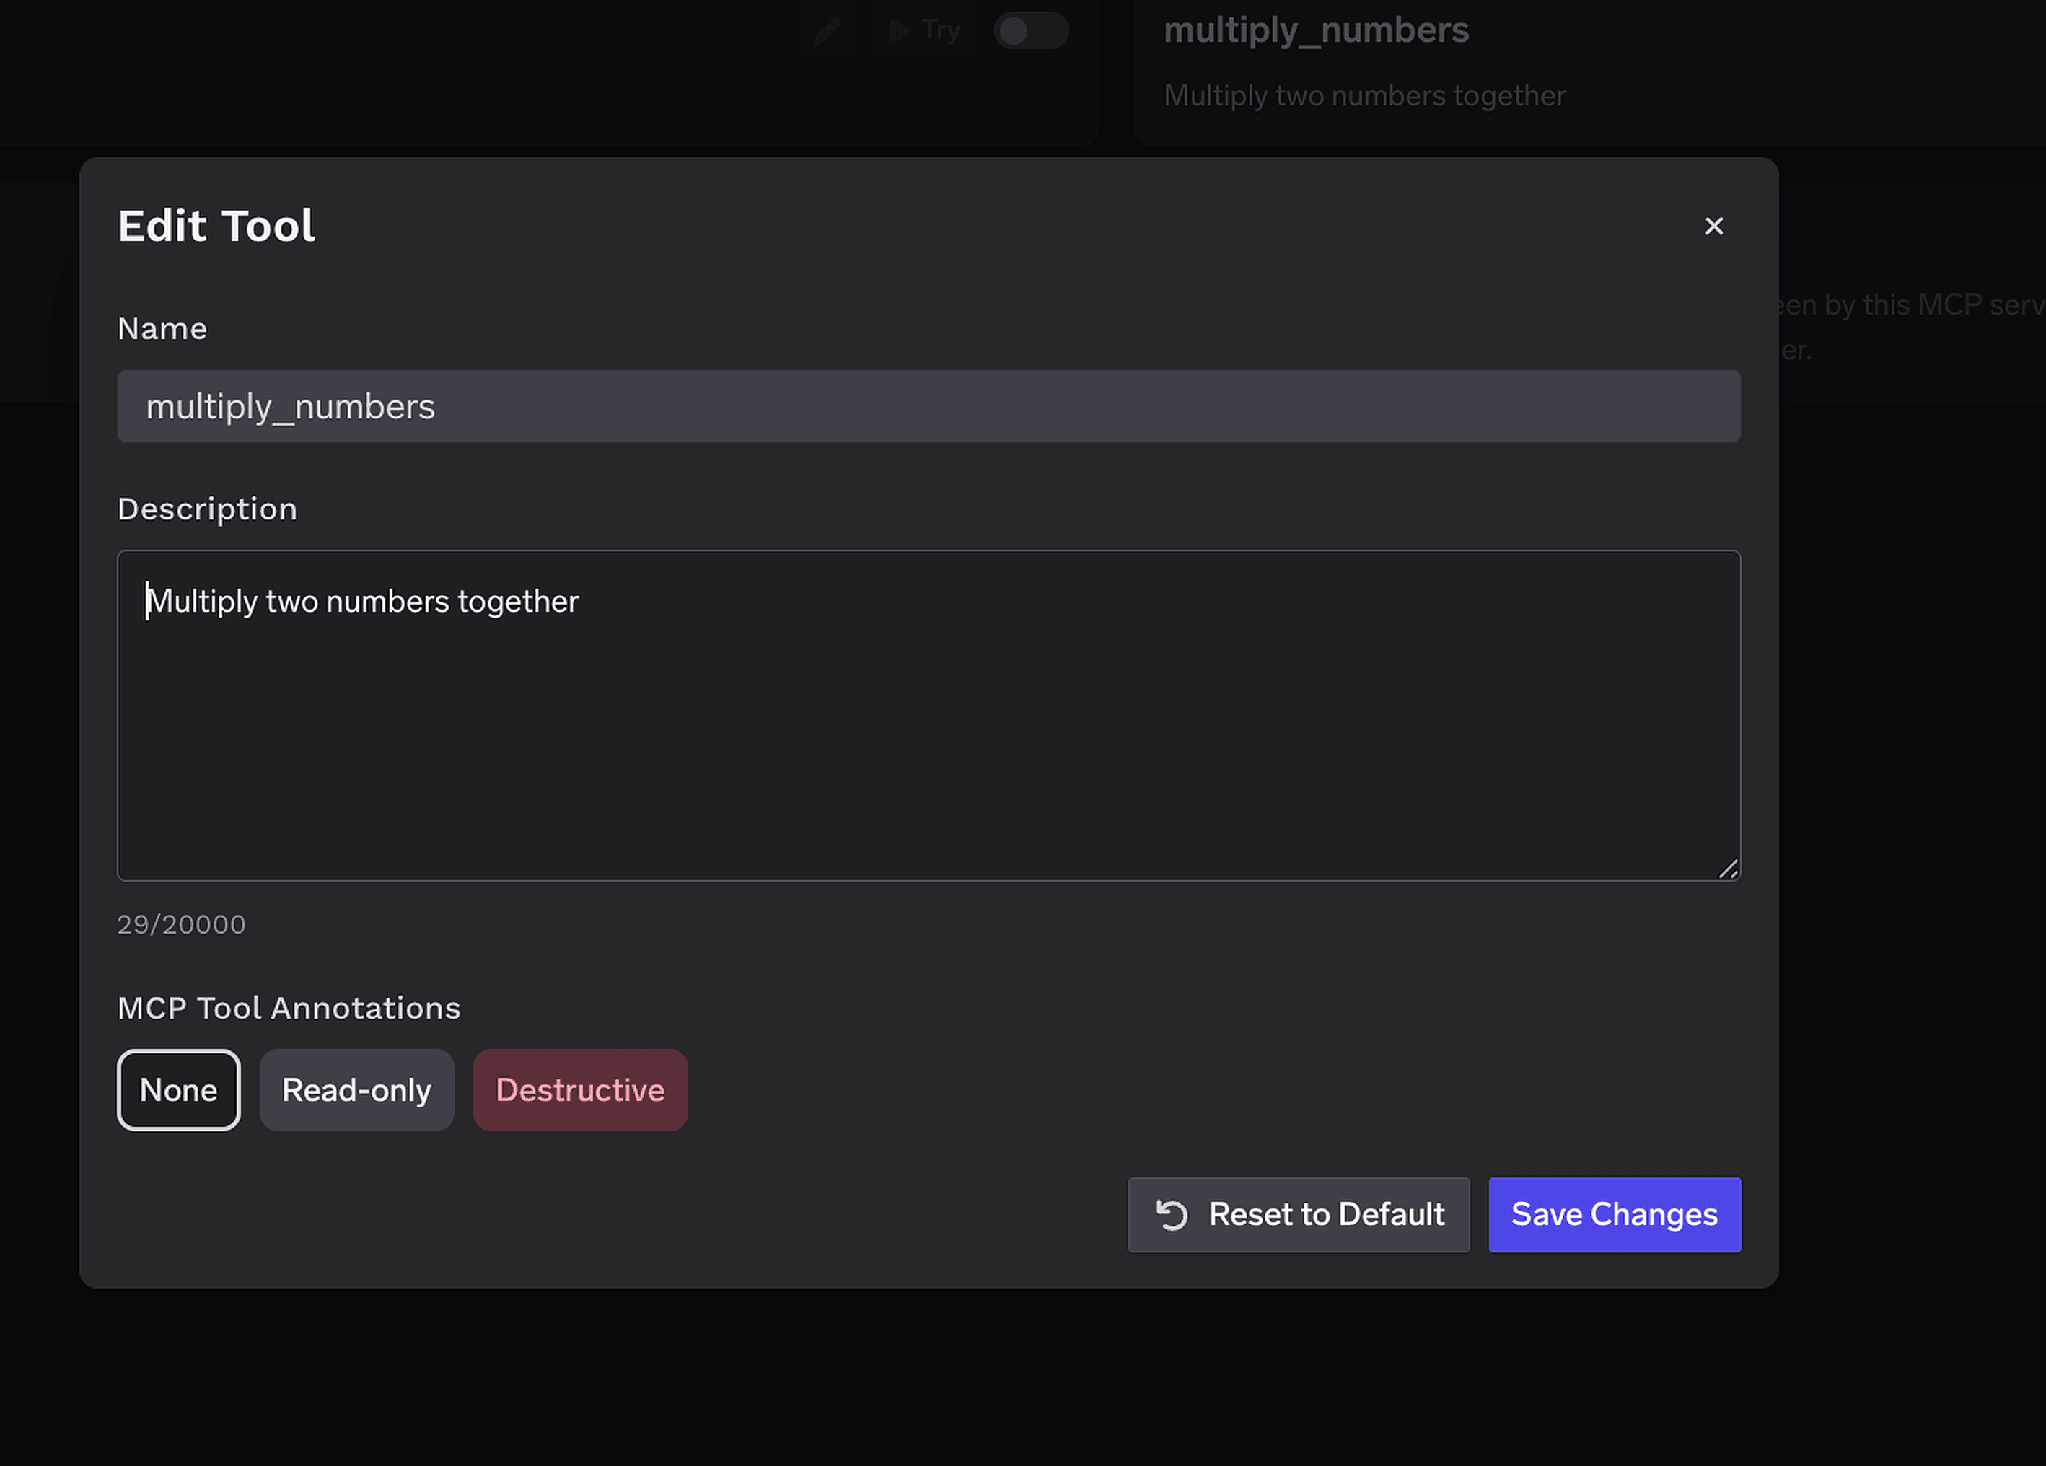
ElDescripción anulación, de hasta 20.000 caracteres, guía la selección de herramientas. Reescriba una herramienta de consulta de métricas para que diga “llame siempre a esto en lugar de redactar SQL para una métrica conocida” y dirigirá al modelo hacia la definición que usted posee. Anotaciones de herramientas MCPmarca una herramientaSolo lecturaoDestructiva, estableciendo readOnlyHint o destructiveHint.
El control de acceso se aplica a usuarios, equipos o cuentas virtuales en dos dimensiones: a qué servidores llega una identidad y qué herramientas dentro de un servidor invoca.
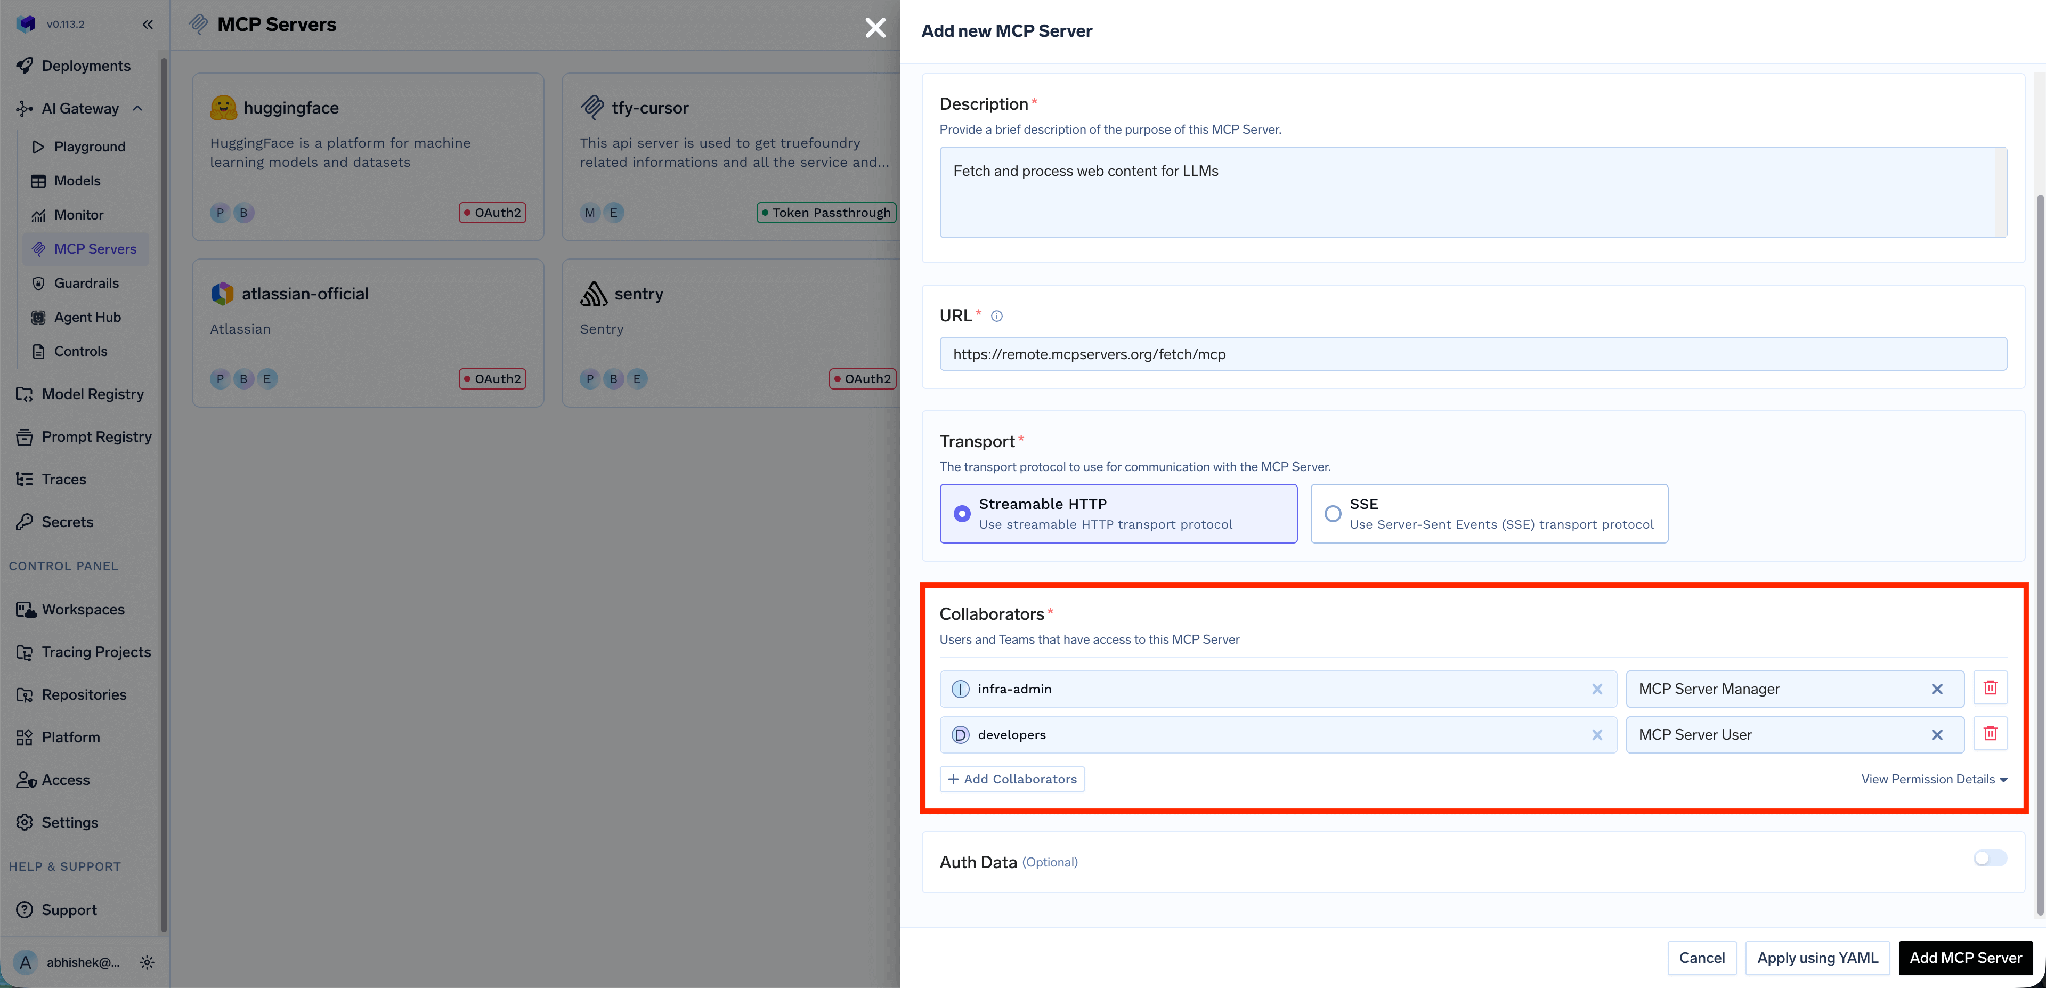
Así que el equipo de plataforma es dueño de qué herramientas de dbt existen y otros equipos las consumen; lo mismo Control de acceso MCP modelo aplicado en todo su registro.
Deshabilitar execute_sql es una medida drástica. A veces, es necesario que un agente ejecute SQL o realice una consulta de métricas costosa, pero no sin supervisión. Para eso sirven las políticas de aprobación de herramientas, que encajan perfectamente con dbt, ya que el conjunto restringido es pequeño.
Cuando se invoca una herramienta restringida, la llamada se pone en espera, se crea una solicitud y se notifica a los aprobadores. Tras la aprobación, las llamadas se realizan correctamente durante un periodo de tiempo configurable, después del cual se requiere una nueva aprobación.
Cree una política en AI Gateway → Policies → MCP Tool Approval, actualmente marcada como Beta:
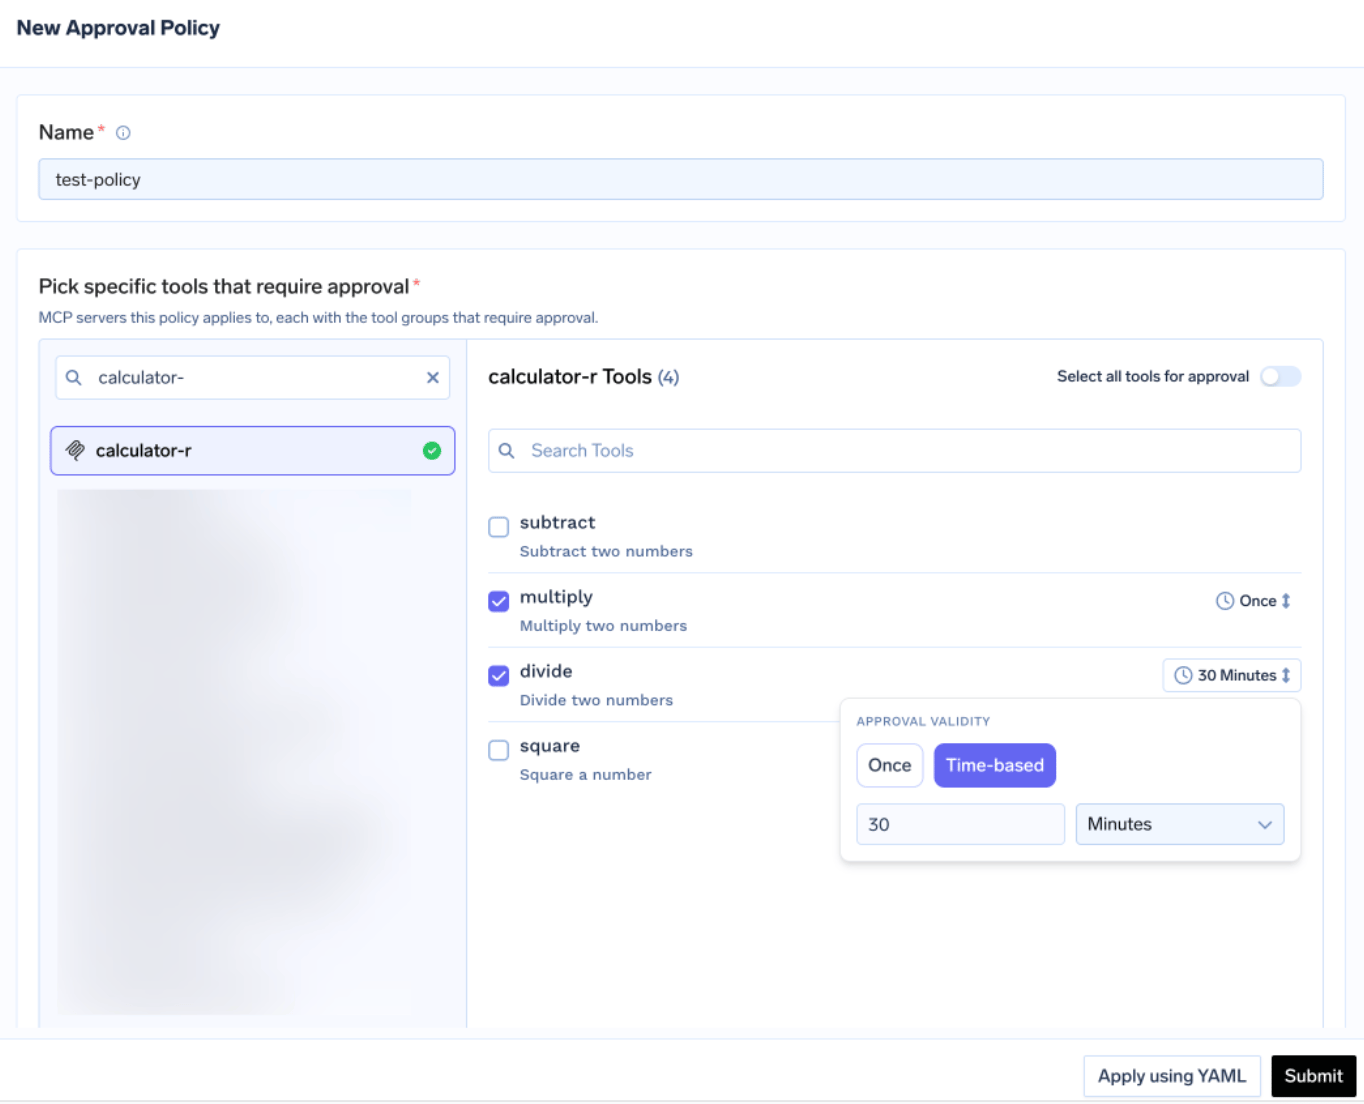
Cada política nombra los servidores que restringe y elige un ámbito de aprobación: "named" solo restringe las herramientas que usted enumera, "destructive" restringe todas las herramientas marcadas con destructiveHint: true, y "all" lo restringe todo. Cuando los ámbitos se solapan, prevalece el más específico: named > destructive > all. Para dbt, "named" suele ser la opción más sensata: dos o tres nombres de herramientas cubren la exposición real, y restringir todo obligaría a los aprobadores a validar constantemente las lecturas de linaje.
Validez puede ser Una vez, para una sola ejecución, o basada en tiempo, una duración en minutos. Cuando las políticas entran en conflicto, prevalece la más restrictiva: "Una vez" prevalece sobre una ventana de 10 minutos, y esta sobre una de 30 minutos. Se notifica a los aprobadores por correo electrónico, Slack, PagerDuty o MS Teams:
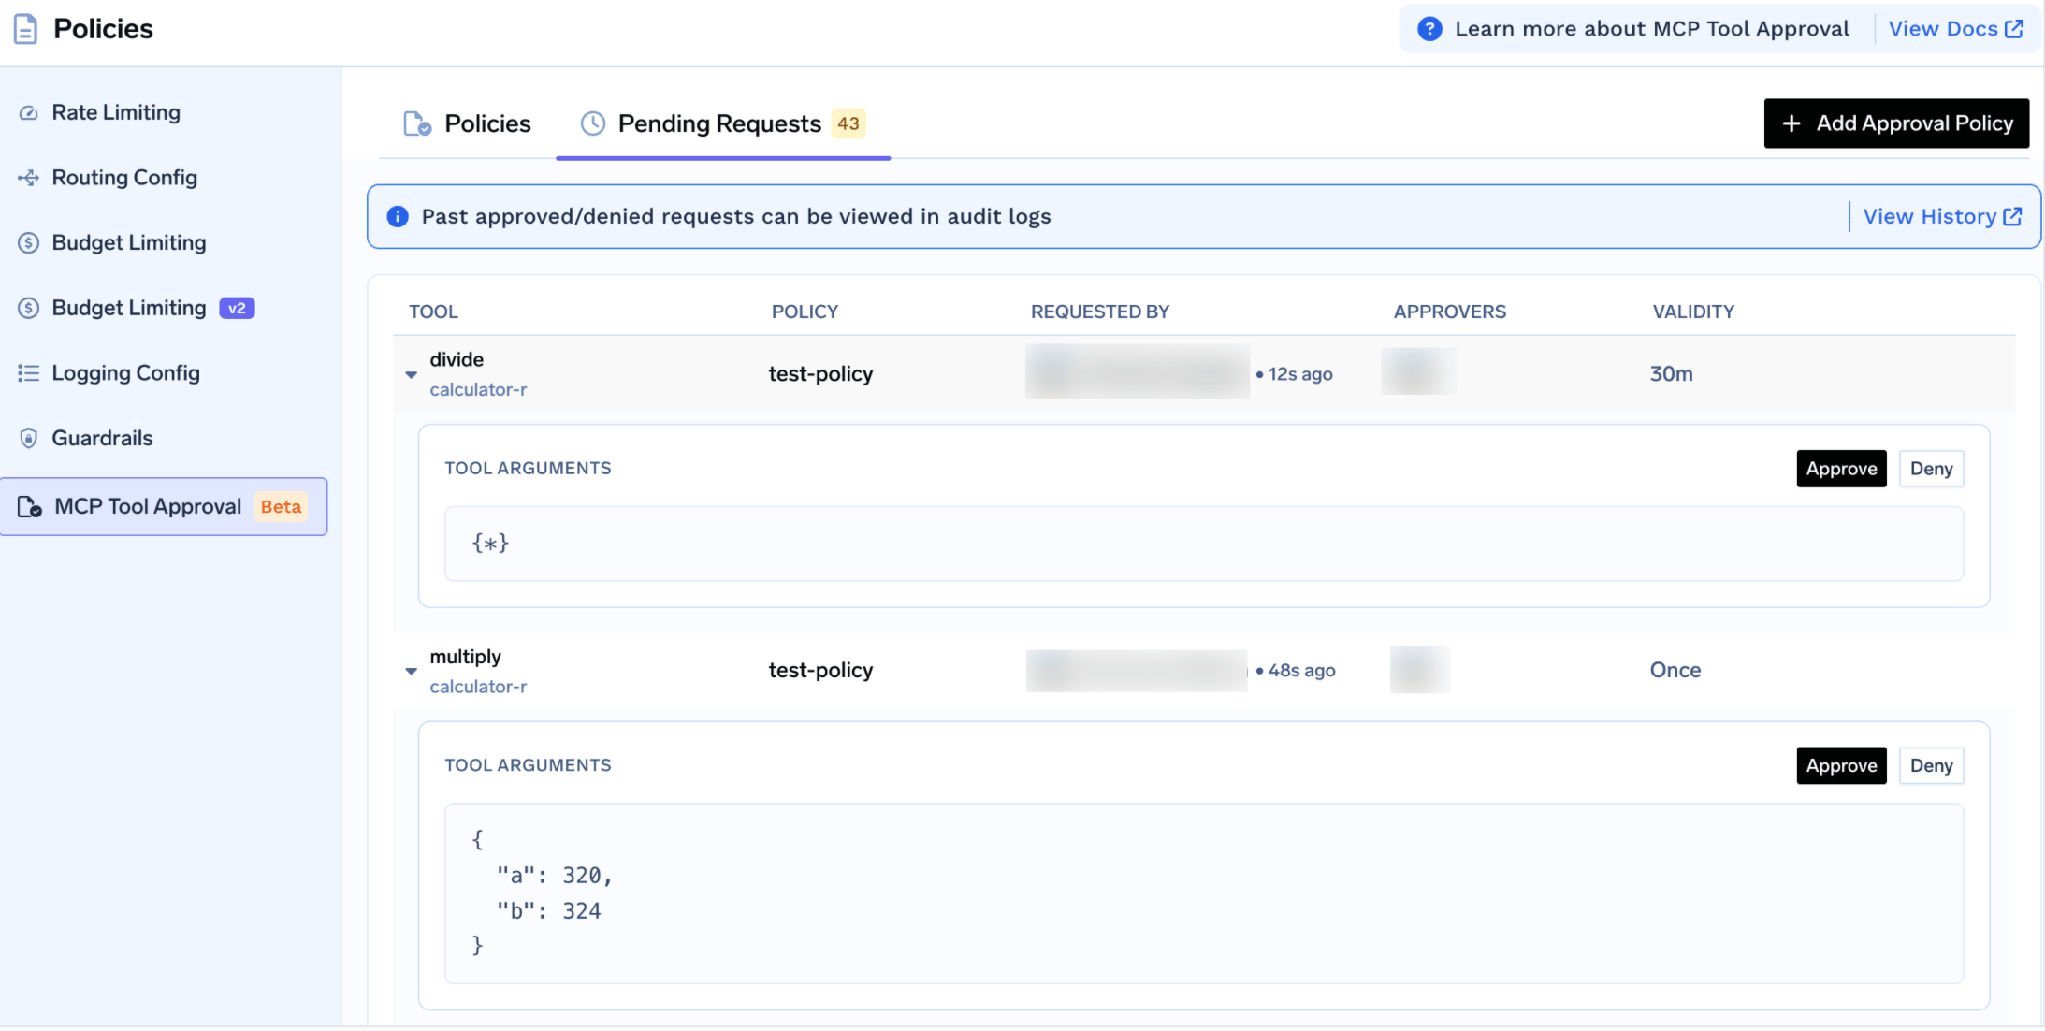
Cada solicitud muestra la herramienta, la política, el solicitante y los argumentos reales, de modo que el aprobador puede leer el SQL antes de autorizarlo. Mientras está pendiente, el emisor recibe un resultado JSON-RPC con _meta.approval_status: "pending" en lugar de un error, por lo que un agente bien configurado esperará y volverá a intentarlo. Las autorizaciones se asignan por solicitante y una denegación no bloquea a nadie de forma permanente; para ello, deshabilite la herramienta o elimine al usuario.
Prueba primero manualmente. En la página de detalles del servidor, haz clic en Probar junto a una herramienta, rellena los parámetros y lee el JSON; Probar está desactivado para las herramientas que hayas apagado. Esto permite detectar a tiempo los fallos habituales de dbt: un ID de entorno incorrecto, funciones de IA de dbt no habilitadas o un token caducado.
Abre la pestaña Cómo usar para obtener tu URL de Gateway específica del inquilino y los fragmentos de código.
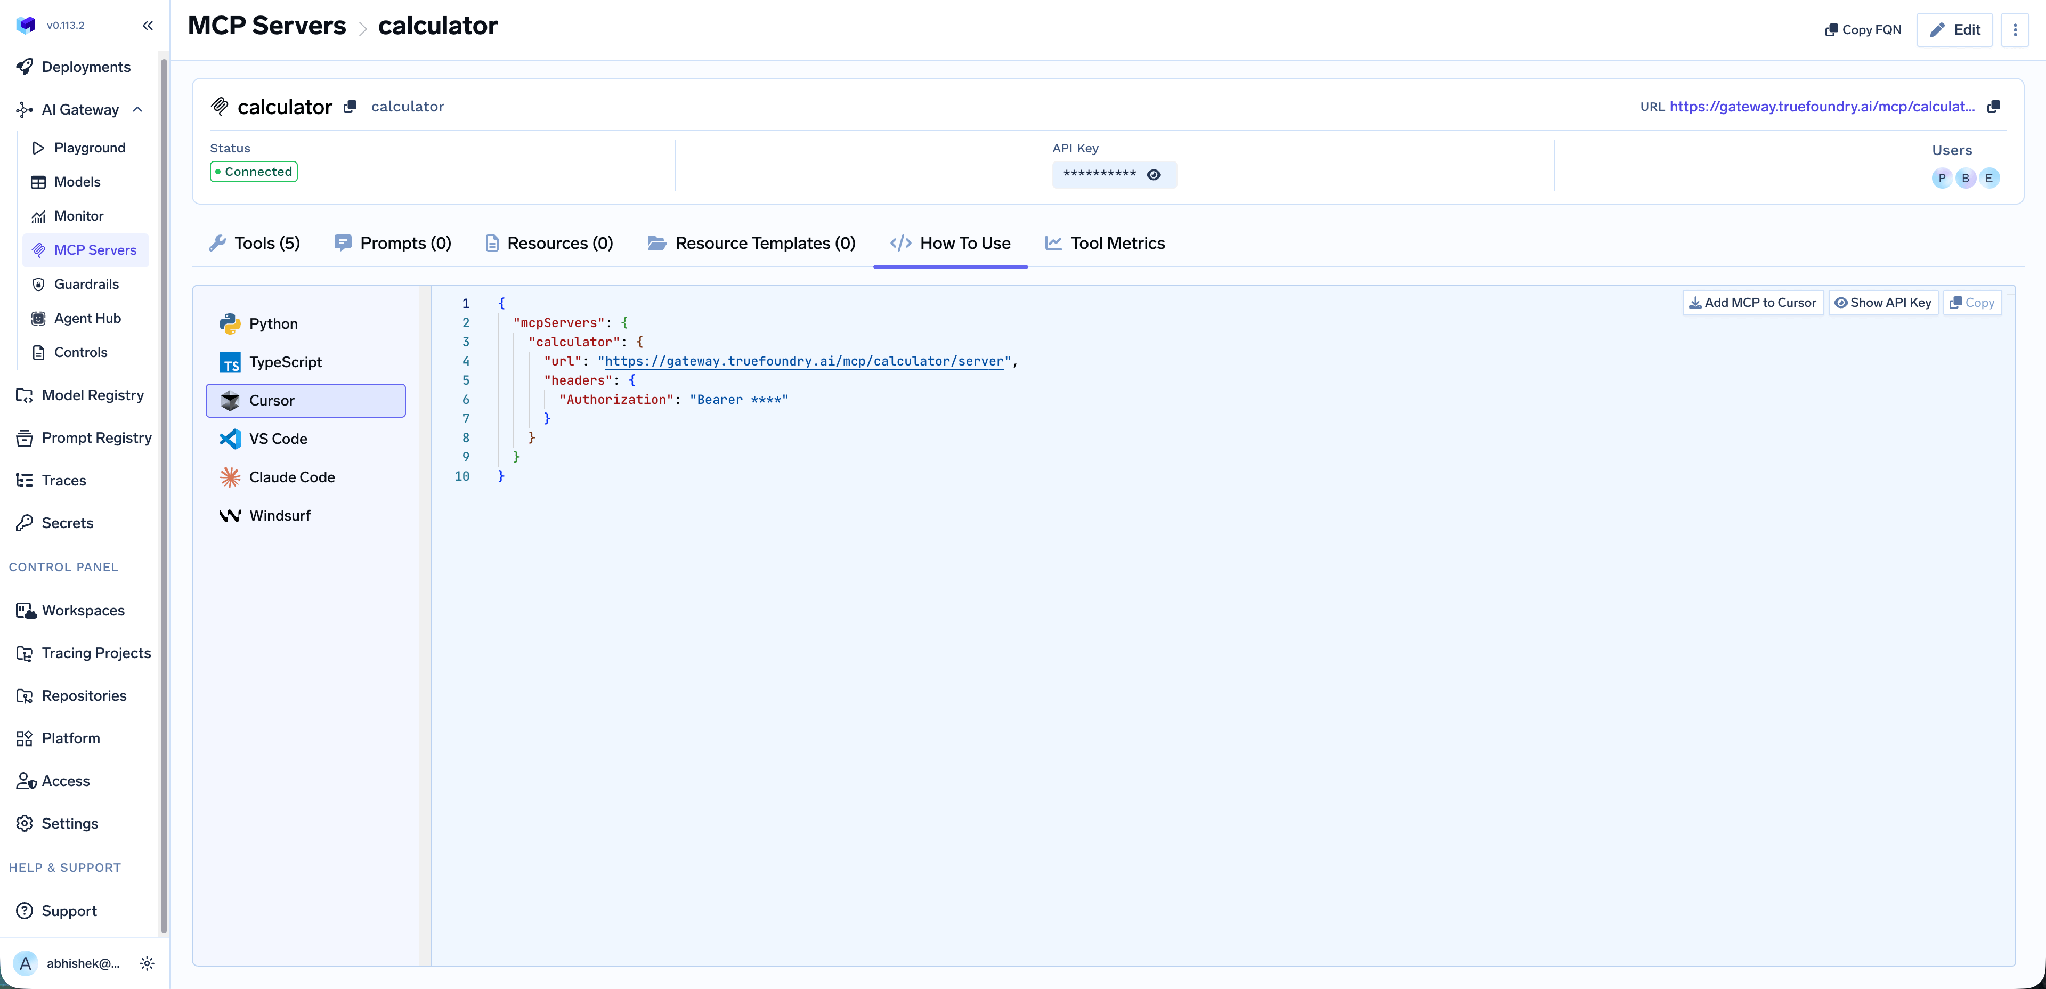
Cubre Claude Code, VS Code, Claude Desktop, Cursor, Windsurf, Codex y los SDK de MCP para Python y TypeScript. Añadir MCP a Cursor escribe la configuración; Mostrar clave API revela el token.
Utiliza la URL de esta pestaña en lugar de crearla tú mismo; es específica del inquilino y un endpoint construido manualmente es la causa más común de que un cliente se conecte pero no muestre ninguna herramienta. El efecto secundario es importante: los analistas configuran un endpoint de TrueFoundry, por lo que las credenciales de dbt nunca llegan al portátil.
Métricas a nivel de herramienta. El panel desglosa las solicitudes por segundo, la latencia desde P50 hasta P99, la tasa de fallos por tipo de error y el recuento de solicitudes por herramienta.
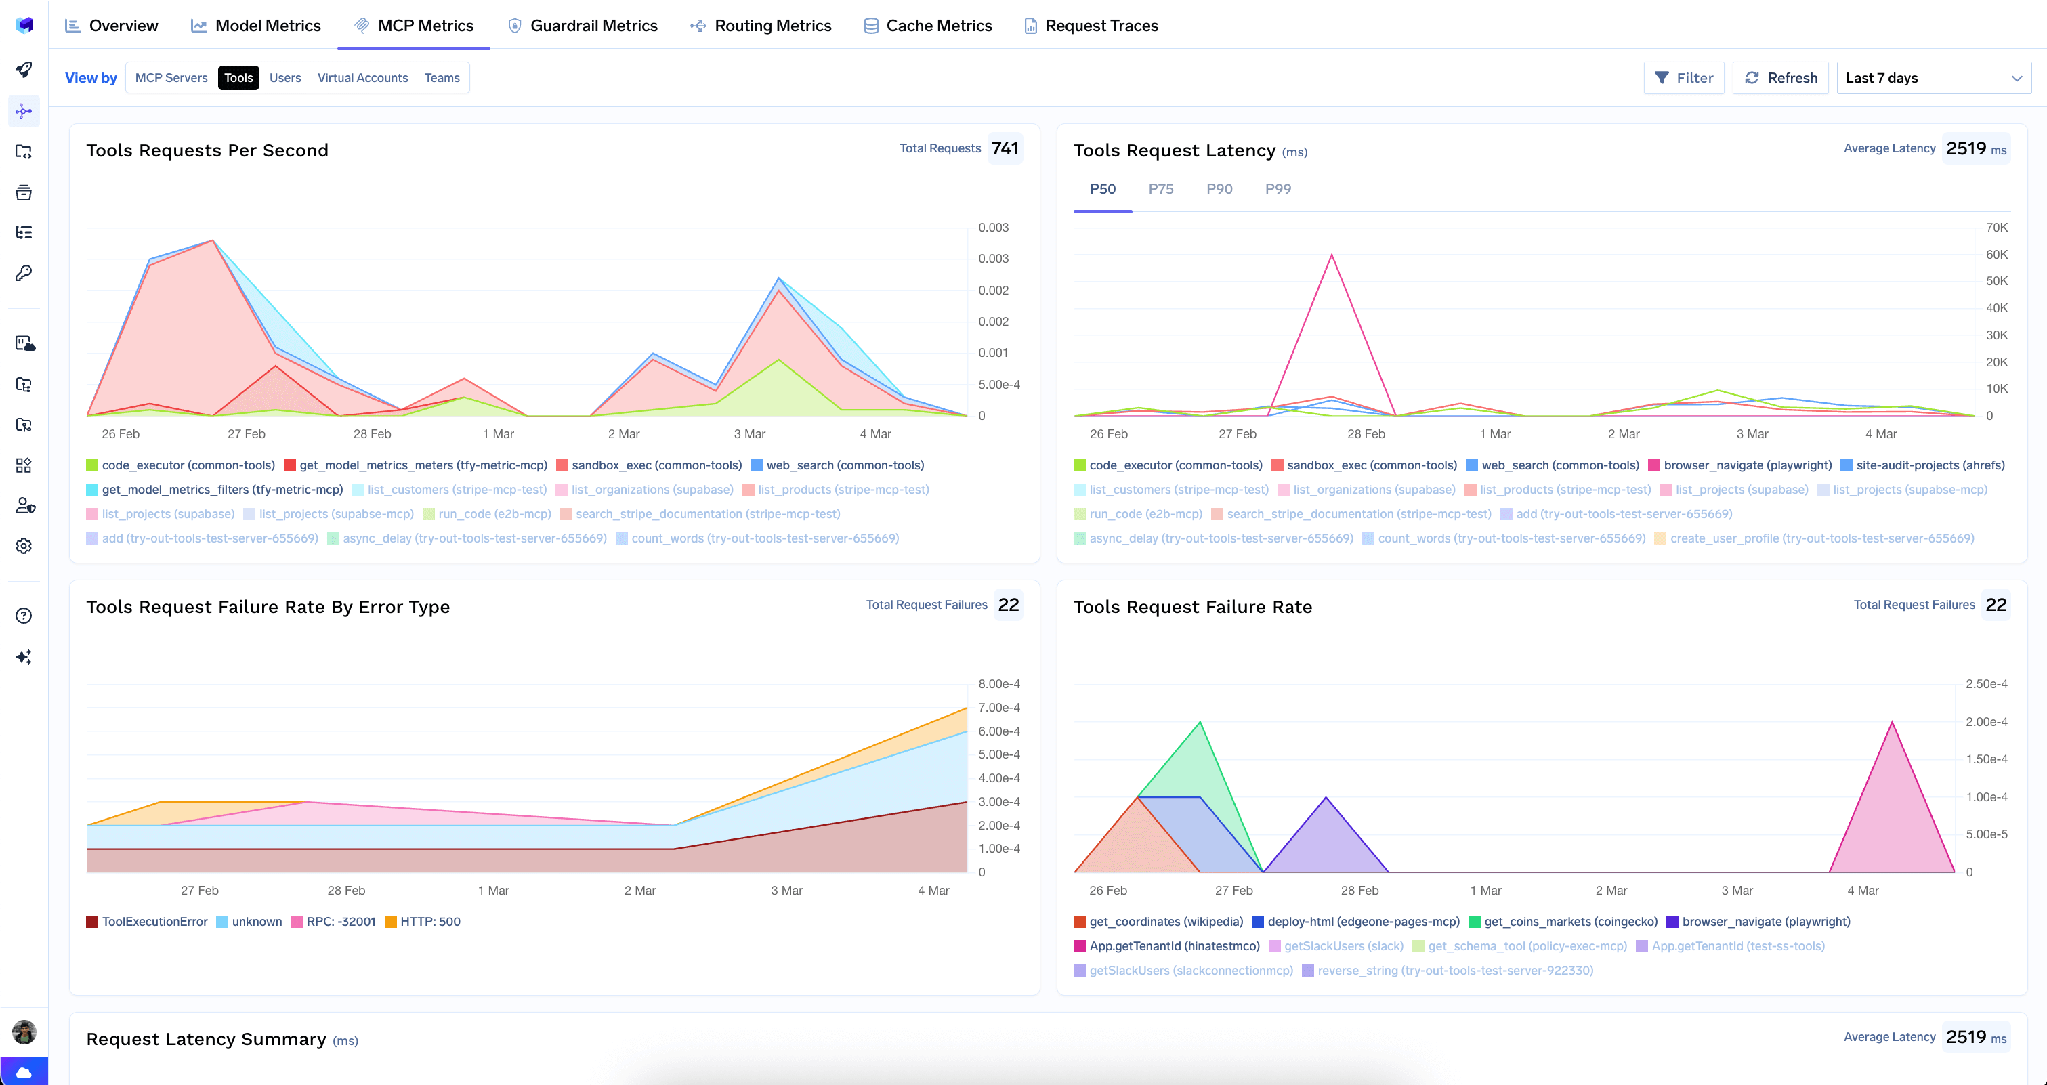
Para un servidor de datos, esto es control de costes, no solo un panel: es la forma de descubrir que un agente realiza una consulta de métricas doscientas veces por ejecución.
Observabilidad completa de las solicitudes. Cada llamada a herramienta se rastrea con la identidad del emisor, el nombre de la herramienta, los datos de entrada y la latencia, exportándose mediante OpenTelemetry. «Qué agente ejecutó esa consulta, para quién y con qué argumentos» se convierte en una simple consulta, no en una investigación.
Barreras de seguridad. Los mecanismos de control previos y posteriores a la herramienta aplican políticas sobre las llamadas a herramientas MCP.
Baja sobrecarga. La pasarela añade aproximadamente 3-4 ms de latencia y gestiona más de 350 RPS en una sola vCPU, junto con 1.000 LLM.
Un registro único. Una vez registrados varios servidores, puede agrupar un subconjunto seleccionado de herramientas tras un único punto de acceso con un Servidor MCP virtual — las herramientas de metadatos de dbt junto con una herramienta de lectura de almacén de datos, nada más. Esa es la configuración de un agente de análisis fiable: dbt proporciona las definiciones y el almacén de datos proporciona las filas.
Los administradores de inquilinos pueden eliminar todas las credenciales almacenadas desde el menú de tres puntos junto a Editar:
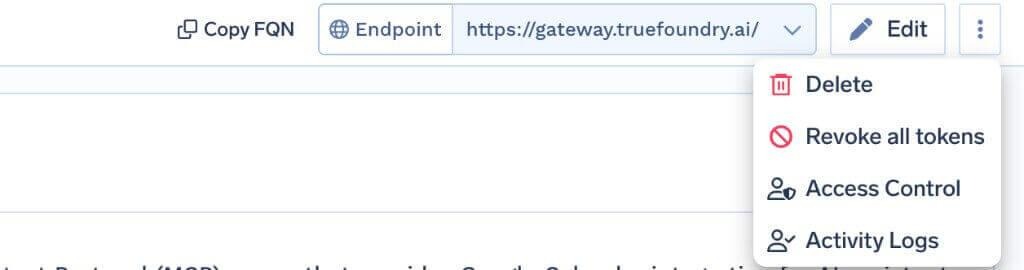
Revocar todos los tokens elimina todas las anulaciones de autenticación y los tokens almacenados para todos los usuarios y cuentas virtuales en ese servidor, entra en vigor en la siguiente solicitud y queda registrado en los registros de actividad. Es irreversible, todos deben volver a proporcionar sus credenciales después y solo los administradores del inquilino pueden verlo. Hay un límite importante: borra los tokens solo en la puerta de enlace, no en dbt Cloud, por lo que durante un incidente, rote también el token de dbt allí.
Las cabeceras son la configuración. La mayoría de los primeros intentos fallidos se deben a un ID x-dbt-* ausente o incorrecto, no a un problema de autenticación. El ID del entorno de desarrollo y el ID de usuario solo son necesarios para las herramientas SQL y Fusion, por lo que una conexión parece correcta hasta que se realiza la primera llamada SQL.
Se requiere el rol de Administrador de cuenta para configurarlo, no para usarlo. Necesita el rol de Administrador de cuenta en dbt Cloud para crear el token y leer los ID. Eso no significa que el agente deba tener acceso de administrador: créelo como administrador y luego proporcione al agente un token de servicio con permisos limitados.
Los metadatos son tan buenos como su proyecto. Un agente que lee el linaje en un proyecto sin documentar obtiene un mapa sin etiquetas.
El servidor MCP de dbt es la integración más infravalorada del stack de datos, precisamente porque no parece impresionante. No devuelve datos. Devuelve definiciones, linaje y documentación: el contexto que diferencia a un agente que responde correctamente a una pregunta de negocio de uno que escribe SQL plausible basándose en columnas que ha adivinado.
Además, es inusualmente fácil de asegurar. El riesgo se concentra en execute_sql y en las costosas consultas de la capa semántica, y ambos problemas se pueden resolver en minutos: un token de servicio con alcance limitado en lugar de un PAT de administrador, interruptores por herramienta que mantienen los metadatos abiertos y el SQL cerrado, puertas de aprobación y un registro de llamadas trazado.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Es el servidor remoto de Model Context Protocol de dbt Cloud. Permite a un agente consultar métricas a través del Semantic Layer, inspeccionar los metadatos y el linaje de los modelos y ejecutar SQL sobre un proyecto de dbt Cloud. Su valor está en los metadatos: su grafo de modelos y sus definiciones de métricas, más que las filas en bruto.
Tres áreas de capacidad según la documentación: consultas de métricas del Semantic Layer, inspección de metadatos de modelos y ejecución de SQL mediante execute_sql. dbt también agrupa las herramientas en toolsets que puede ocultar con las cabeceras x-dbt-disable-toolsets y x-dbt-disable-tools. Su lista exacta aparece en la pestaña Tools.
Regístrelo como un servidor MCP remoto con https://cloud.getdbt.com/api/ai/v1/mcp/, autenticación con token Bearer y las cabeceras x-dbt-*. Use un token de servicio con alcance limitado en lugar de un PAT de administrador, desactive execute_sql salvo que un agente lo necesite y aplique una política de aprobación a las herramientas que mantenga.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Sí. Incluye un MCP Gateway, un Agent Gateway y un MCP & Agents Registry con control de acceso a nivel de herramienta. Los agentes creados con LangGraph, CrewAI, AutoGen o un framework propio pueden gobernarse de forma centralizada.
Sí. La pasarela es compatible con OpenTelemetry y se integra con Grafana, Datadog, Prometheus o tu pila preferida. Rastrea cada solicitud desde la instrucción (prompt) hasta la ejecución de la herramienta y el modelo, así obtienes un registro unificado sin tener que reemplazar lo que ya tienes en funcionamiento.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada