



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
DeepSeek-V4-Pro entró en fase de vista previa el 24 de abril de 2026 y estuvo disponible de forma general el 13 de agosto de 2026, en menos de cuatro meses. El nombre del modelo en la API nunca cambió: se sigue llamando deepseek-v4-pro, y la versión de disponibilidad general simplemente sustituyó a la versión de vista previa.
Las especificaciones, desde la página de Modelos y precios de DeepSeek y la ficha del modelo GA, a fecha de septiembre de 2026:
Hay dos detalles que importan más que el número de parámetros.
En primer lugar, los pesos son genuinamente abiertos. El punto de control de la versión GA se ha publicado en deepseek-ai/DeepSeek-V4-Pro-0813 bajo licencia MIT, no bajo una licencia comunitaria a medida con límite de ingresos o restricciones de uso. La licencia MIT es de lo más permisivo que existe. Ese es el único hecho que hace que merezca la pena escribir el resto de este artículo.
En segundo lugar, el trabajo de eficiencia es la clave de su arquitectura. La ficha del modelo de vista previa describe un diseño de atención híbrido que combina atención dispersa comprimida y atención altamente comprimida, e informa de que, con un contexto de 1M de tokens, V4-Pro necesita aproximadamente el 27% de los FLOPs de inferencia por token y el 10% de la caché KV de DeepSeek-V3.2. Ofrecer un contexto largo es barato aquí, de una forma que no lo era en la generación V3, que es precisamente lo que hace que los cálculos para el alojamiento propio sean interesantes.
[CAPTURA DE PANTALLA: Chat de DeepSeek: el selector de Modo Experto que dirige a V4-Pro en la aplicación y la web]
DeepSeek es inusualmente directo al respecto. La ficha técnica del modelo GA indica que V4-Pro-0813 «está construido sobre la estructura del modelo DeepSeek-V4-Pro (Preview), con un módulo de decodificación especulativa DSpark añadido»; el modelo base es el mismo, pero el post-entrenamiento y la ruta de decodificación no lo son.
Las diferencias que publica, de la versión preview a la GA:
Fuente: Ficha técnica del modelo DeepSeek-V4-Pro-0813, septiembre de 2026.
Una advertencia al leer esto. DeepSeek señala que las puntuaciones de los agentes de código se obtuvieron utilizando su propio DeepSeek Harness en modo mínimo con el máximo esfuerzo de razonamiento, temperatura = 1.0 y top_p = 0.95. Un salto de casi cinco veces en DeepSWE es un resultado de post-entrenamiento medido bajo el propio sistema del proveedor, no una reproducción independiente. La tendencia es claramente real; la magnitud merece tu propia evaluación.
Junto con el modelo, la versión GA trajo soporte nativo para la API de respuestas de OpenAI con una configuración de Codex de un solo clic, y el control de reasoning_effort de tres niveles que sustituye al interruptor binario de pensamiento.
La ficha técnica del modelo GA publica una tabla comparativa frente a competidores abiertos y cerrados. Aquí está la parte que todo el mundo reproduce, y luego la parte que la mayoría de las publicaciones omiten.
Fuente: Ficha técnica del modelo DeepSeek-V4-Pro-0813, septiembre de 2026.
Donde V4-Pro lidera. Trabajo de agentes tipo terminal y programación con enfoque en seguridad. Supera a Opus-4.8 en Terminal Bench 2.1, DeepSWE, Cybergym y AutomationBench. Para ser un modelo que puedes descargar, es un resultado genuino.
Donde los modelos cerrados siguen ganando. Conocimiento general y el trabajo más complejo en repositorios. Opus-4.8 está por delante en NL2Repo por más de ocho puntos, en DSBench-Hard, en Toolathlon-Verified y en HLE sin herramientas. Fable-5 con fallback lidera en la mayoría de los mismos. Si tu carga de trabajo está dominada por cambios complejos en repositorios de múltiples archivos o por preguntas de amplitud de conocimientos, los modelos cerrados de vanguardia siguen siendo la mejor respuesta, y ningún entusiasmo por las licencias cambia eso.
Donde se sitúan los otros modelos abiertos. Kimi K3 supera ligeramente a V4-Pro en Terminal Bench 2.1 y DeepSWE. El título de «mejor modelo de pesos abiertos» está en disputa, no resuelto. La afirmación interesante es más limitada y duradera: un modelo descargable está ahora lo suficientemente cerca de la vanguardia como para que la cuestión de su implementación sea relevante.
DeepSeek introdujo la facturación en horas punta y valle junto con la versión GA, efectiva desde las 16:00 UTC del 16 de agosto de 2026. Las tarifas en horas valle son exactamente la mitad que en horas punta. Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, excluyendo los días festivos chinos; todo lo demás, incluidos los fines de semana, es hora valle.
Fuente: Modelos y precios de DeepSeek, septiembre de 2026.
Tres cosas a tener en cuenta. El precio por acierto en caché es 30 veces inferior al de fallo en caché, por lo que la estructura del prompt es enormemente importante para cualquier cosa con un prompt de sistema estable. La división entre horas punta y valle es una palanca de programación, no un descuento: el trabajo por lotes trasladado a horas valle reduce su factura a la mitad. Y DeepSeek subió los precios en la versión GA en relación con la preview, aunque las tarifas publicadas de la preview están [VERIFICAR]: ya no están en la página de precios y no las obtendremos de fuentes secundarias.
Una nota operativa: el límite de concurrencia de la API para deepseek-v4-pro es 500. DeepSeek también confirmó el 10 de septiembre de 2026 que seguirá ofreciendo la API V4 Pro más allá del 14 de septiembre de 2026 con la facturación sin cambios (cambio registro).
[CAPTURA DE PANTALLA: Plataforma DeepSeek: panel de control de uso que muestra el gasto en tokens en horas punta frente a horas valle]
Existen cuatro modos de fallo que aparecen repetidamente con los modelos de vanguardia de pesos abiertos, y V4-Pro presenta los cuatro.
La factura del alojamiento propio se calcula por nodo, no por GPU. El comando de servicio de referencia de DeepSeek en la ficha del modelo apunta a una configuración única de 4 nodos GB300 a través de vLLM, con caché KV FP8, paralelismo de expertos y decodificación especulativa DSpark habilitados. Un MoE de 1,7 billones de parámetros no es algo que se pueda poner en marcha en una A100 de repuesto. Los pesos abiertos te dan la opción de realizar el alojamiento propio; si los números compensan frente a los 1,98 dólares por millón de tokens de salida depende totalmente de tu nivel de utilización. Por debajo de una carga constante bastante alta, la API sale ganando.
No hay plantilla de chat. La versión GA no incluye ninguna plantilla de chat Jinja. En su lugar, DeepSeek proporciona una carpeta de codificación con scripts de Python para convertir mensajes en formato OpenAI a la entrada del modelo y volver a analizar la salida. Cualquier elemento de tu pila tecnológica que asuma el uso de tokenizer.apply_chat_template necesitará ajustes.
V4-Pro no tiene visión. La visión reside en la línea Flash, no en la Pro. Una estrategia de modelo único que asumiera la multimodalidad falla aquí, lo que significa que estás enrutando a través de al menos dos modelos, lo hayas planeado o no.
La residencia y la API son ahora decisiones independientes. Enviar prompts a api.deepseek.com es una cuestión de flujo de datos distinta a ejecutar los mismos pesos dentro de tu propia VPC. Los equipos suelen confundir "podemos usar DeepSeek V4" con "podemos llamar a la API de DeepSeek", y ambas obtienen respuestas diferentes en la misma revisión de seguridad. Tu asesoría legal decidirá qué es aceptable; el punto es simplemente que los pesos abiertos hacen que ambos caminos sean técnicamente viables.
Un modelo de vanguardia de pesos abiertos solo cambia tu economía si realmente puedes alojarlo en algún lugar. Eso es lo que hace TrueFoundry.
Alójalo en tu propia VPC.Elpuerta de enlace de IA (AI Gateway) registra modelos de pesos abiertos de alojamiento propio junto a proveedores alojados: despliegas V4-Pro en tu propio Kubernetes con vLLM o SGLang, apuntas la puerta de enlace al endpoint y aparece en el catálogo de modelos con el mismo enrutamiento, limitación de tasa, seguimiento de costes y observabilidad que cualquier modelo de API (documentación sobre modelos de alojamiento propio). Dado que tanto vLLM como SGLang ofrecen una API compatible con OpenAI de forma predeterminada, la pasarela no necesita un adaptador específico para DeepSeek.
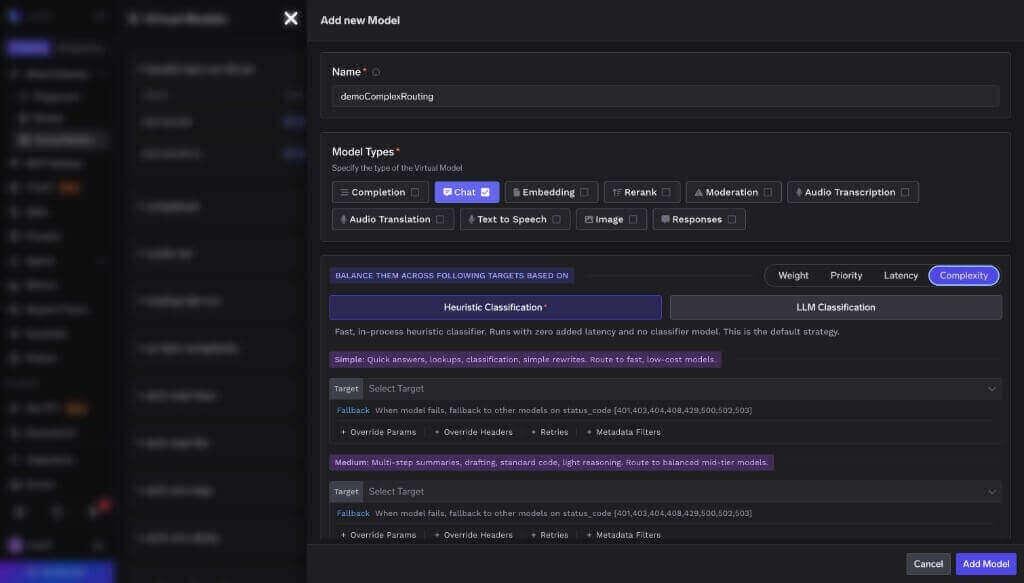
O llame a la API y mantenga la opción abierta. Si aún no está listo para el autohospedaje, dirija el tráfico a la API de DeepSeek a través de la pasarela y mantenga la misma ruta de llamada que utilizaría más adelante para un despliegue autohospedado. Cambiar del endpoint alojado a su propio clúster se convierte en un simple cambio de configuración en lugar de una reescritura de la aplicación.
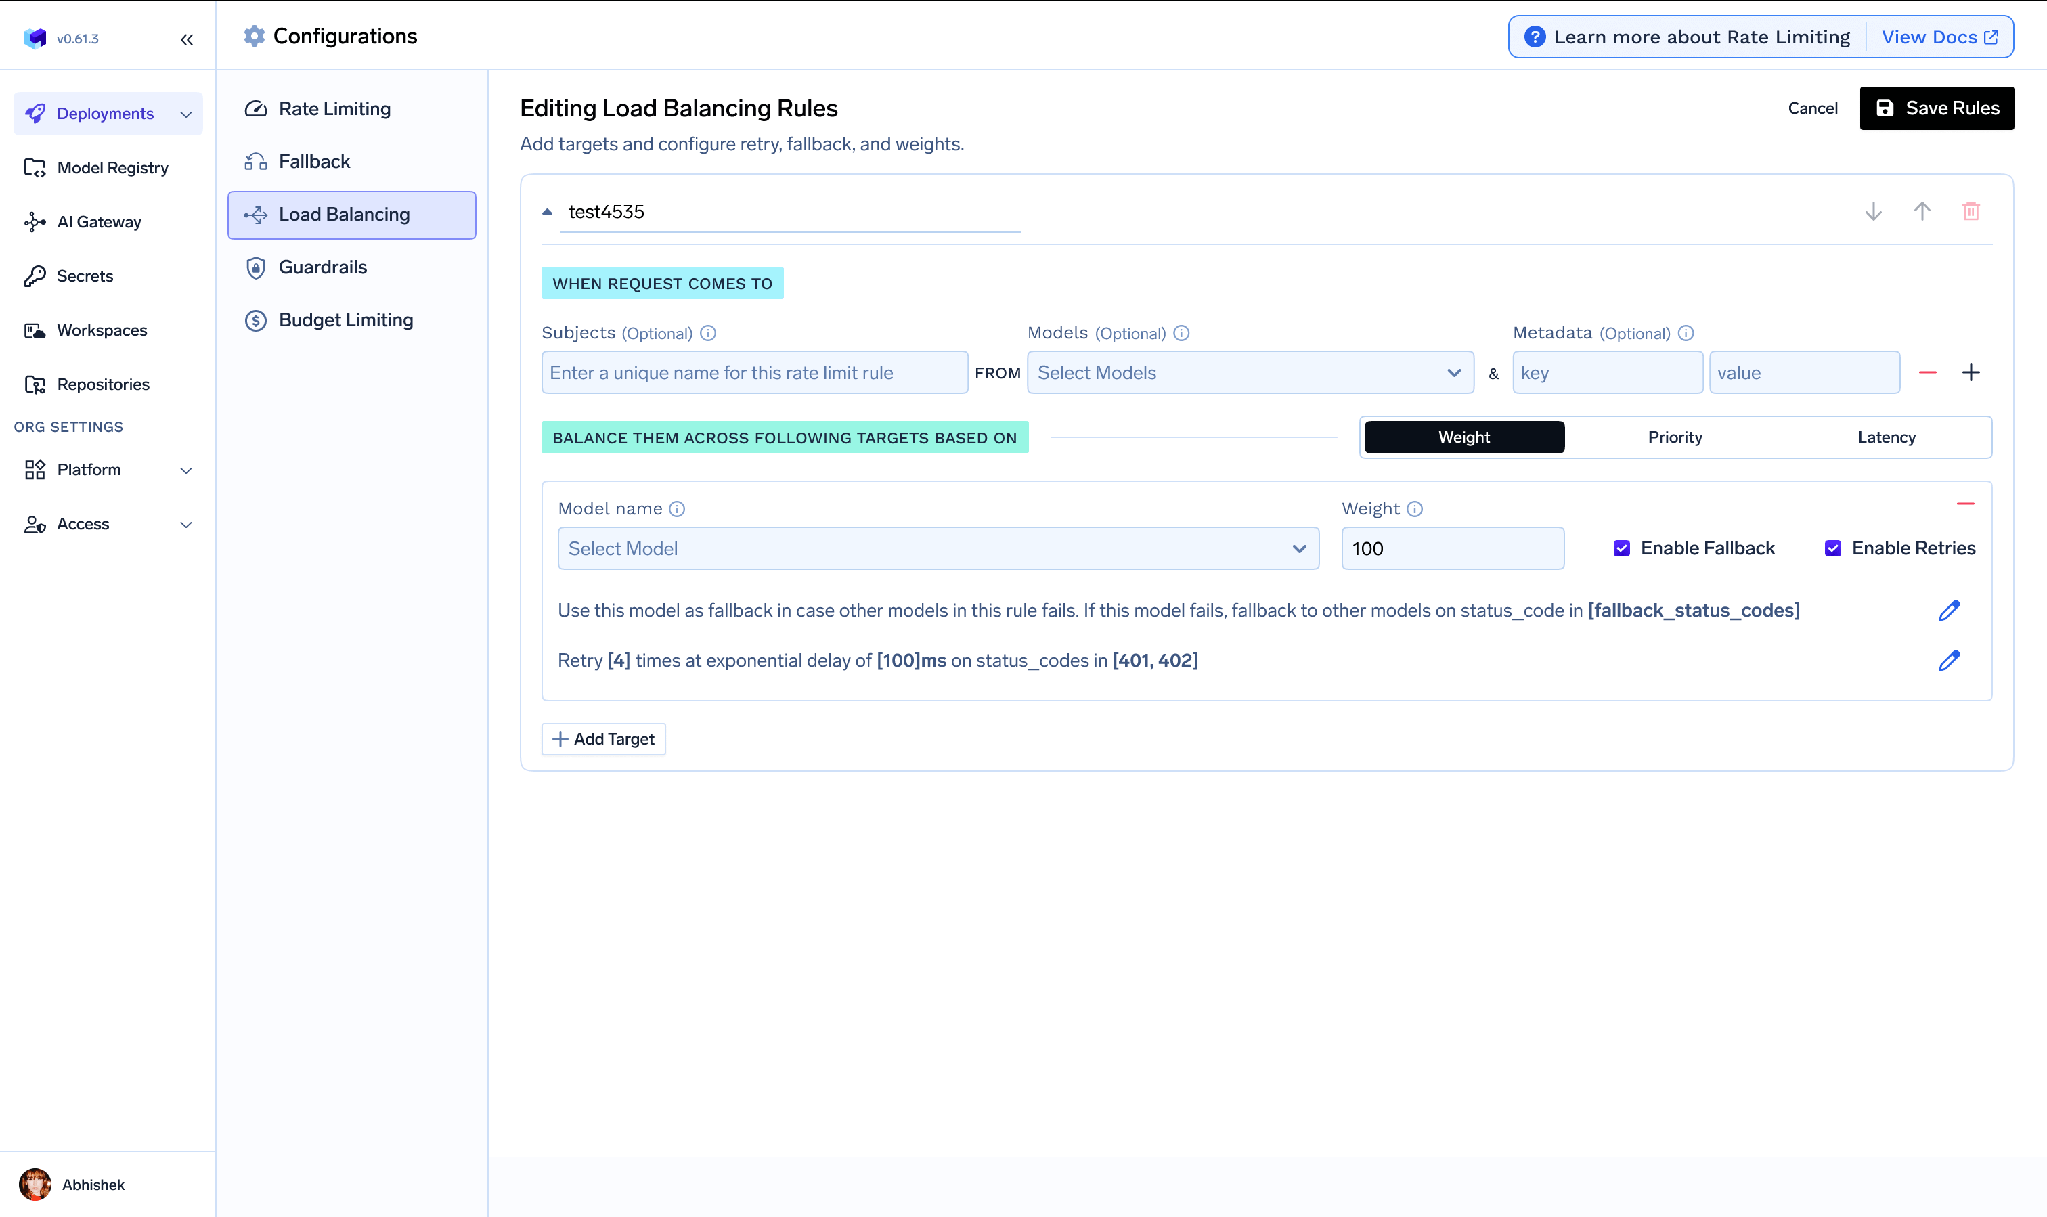
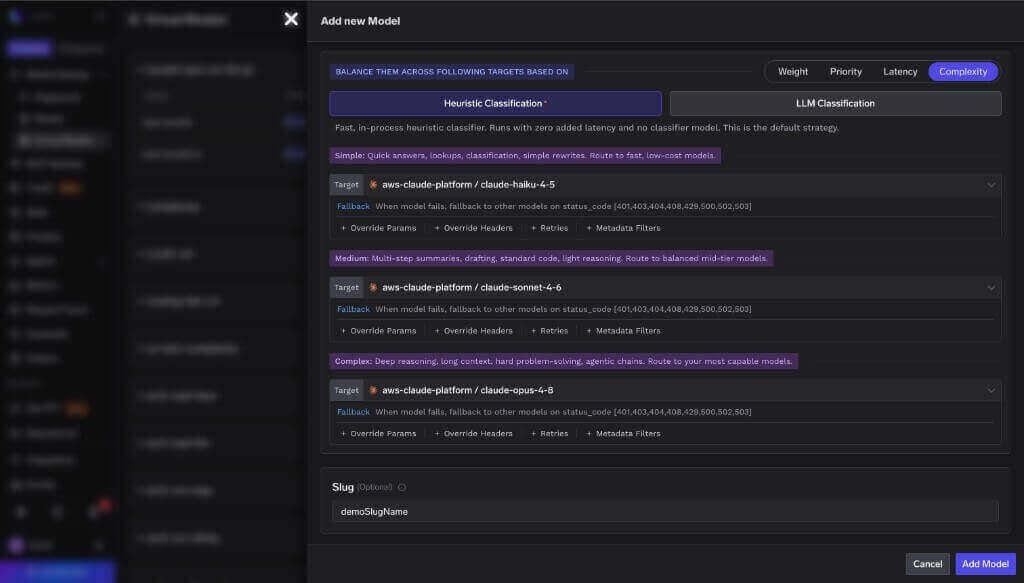
Enrute según la complejidad, no por costumbre. La tabla de evaluación anterior es un argumento a favor de una flota mixta, no de una migración, y enrutamiento consciente de los costes y la calidad es la forma de gestionar una. Trabajo de repositorio complejo para Opus-4.8, ejecuciones de agentes tipo terminal para V4-Pro, y clasificación y extracción para algo más económico. En la propia evaluación de enrutamiento automático de TrueFoundry con 550 prompts, la estratificación de solicitudes redujo los costes un 69% manteniendo el 98% de la calidad base, con una latencia media que pasó de 7,6s a 4,0s; en tráfico de producción, la reducción alcanzó el 80%.
Aplique las mismas medidas de seguridad en ambos casos. Un modelo autohospedado no hereda la pila de seguridad de un proveedor. Las medidas de seguridad a nivel de pasarela se ejecutan en la ruta de solicitud y respuesta, independientemente de si el modelo es el endpoint de DeepSeek o su propio pod.

Mida antes de comprometerse. El coste y la latencia por solicitud y por equipo es la única forma de averiguar si los precios fuera de hora punta de V4-Pro o un nodo autohospedado superan realmente a lo que utiliza hoy en día.

La versión corta, a fecha de septiembre de 2026:

El lanzamiento general de DeepSeek V4-Pro no es una historia de benchmarks. Según las cifras que publica la propia DeepSeek, supera a Opus-4.8 en algunas tareas de agentes, pero queda por detrás en trabajos de repositorio más complejos y en conocimiento, mientras que Kimi K3 disputa su liderazgo entre los modelos abiertos. Como entrada en una tabla de clasificación, es un buen modelo con resultados desiguales.
Como licencia, es otra historia. Un modelo con un contexto de 1 millón de tokens lo suficientemente cerca de la frontera como para ser una opción real, publicado bajo licencia MIT, significa que la cuestión del despliegue deja de ser retórica. Puedes ejecutarlo en tu propia VPC, mantener los prompts en una infraestructura que controlas y pagar por computación en lugar de por tokens, siempre que tu nivel de uso justifique un nodo potente y estés dispuesto a gestionar la pila de servicio. Para la mayoría de los equipos hoy en día no será así, y lo más acertado es dirigir el tráfico a la API mientras se mantiene abierta la opción de alojamiento propio.
Esta es la conclusión honesta: todo se reduce a lo que quieres controlar. Si prefieres que otro ejecute el modelo, la frontera cerrada sigue siendo el camino más corto y la mejor opción para las tareas más exigentes. Si quieres la posibilidad de trasladar el modelo a tu propio perímetro sin tener que reescribir la aplicación, un modelo de pesos abiertos tras una pasarela es la forma más económica de adquirir esa opción, y deberías hacerlo antes de que te haga falta.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




DeepSeek V4 es la familia de modelos mixture-of-experts de DeepSeek. La versión preliminar de V4, que abarca V4-Pro y V4-Flash, se lanzó el 24 de abril de 2026. DeepSeek-V4-Pro alcanzó la disponibilidad general como DeepSeek-V4-Pro-0813 el 13 de agosto de 2026.
Los pesos y el repositorio se publican bajo licencia MIT en Hugging Face, en deepseek-ai/DeepSeek-V4-Pro-0813. Eso cubre los pesos y el código, no los datos de entrenamiento, así que «pesos abiertos» es un término más preciso que «código abierto».
A septiembre de 2026: 0,66 $ por millón de tokens de entrada en horas valle y 1,32 $ en horas punta cuando no hay acierto de caché, 0,022 $ y 0,044 $ cuando hay acierto de caché, y 1,98 $ y 3,96 $ por millón de tokens de salida. Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables.
Sí, y DeepSeek publica recetas de despliegue para vLLM y SGLang. Sea realista con la escala: es un modelo de 1,7 billones de parámetros y la configuración de referencia de la model card es un nodo GB300 con varias GPU.
El AI Gateway de TrueFoundry añade aproximadamente 3-4 ms y sostiene más de 350 RPS con 1 vCPU, algo irrelevante frente a tiempos de generación de varios segundos.
No, y la dispersión de benchmarks anterior es el argumento en contra. Enrutar por tipo de tarea entre modelos abiertos y cerrados suele ser más barato y mejor que estandarizar en uno solo.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















