



October 9, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: October 7, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Los guardrails para agentes de IA son controles de inspección de contenido que examinan la carga útil real de cada interacción del agente (el prompt del usuario, la respuesta del modelo y los argumentos y resultados de cada llamada a herramientas) y toman medidas (permitir, bloquear o reescribir) según la política establecida.
Resulta útil separar dos preguntas que toda llamada de agente gobernada debe responder:
El control de acceso es el portero en la entrada; los guardrails son el detector de metales. Necesita ambos. Un agente puede estar totalmente autorizado para llamar a su servidor MCP de Postgres y aun así ser engañado para enviar una consulta destructiva: el acceso dijo que sí, y solo un guardrail en los argumentos de la herramienta detecta cuál es realmente la consulta.
Los guardrails no son nuevos en las aplicaciones de LLM, pero los agentes cambian el problema de tres formas concretas:
En TrueFoundry, las barreras de seguridad se aplican en la pasarela durante la ruta de llamada del agente : la cadena de usuario → aplicación → agente → subagente → llamadas a herramientas MCP. Cada salto supervisado pasa por un punto de interceptación con un antesydespués de que de cada punto de enganche.
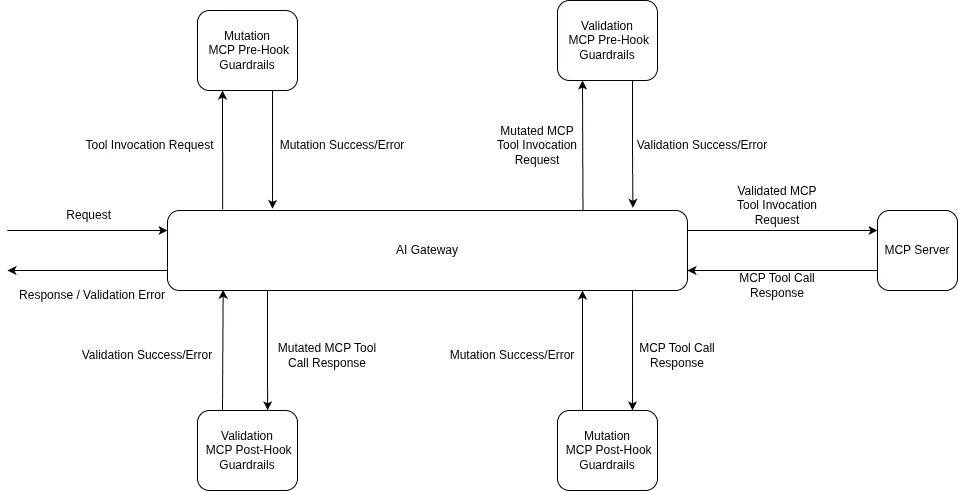
El orden es importante para el coste y el radio de impacto. Un fallo previo a la herramienta significa que la herramienta nunca llega a ejecutarse, lo que supone el fallo más económico posible. Un fallo en la entrada del LLM cancela la solicitud al modelo en curso antes de que tengas que pagar por ella. Dado que cada salto se comprueba de forma independiente, un resultado comprometido en el tercer salto se detecta en ese mismo momento, y no después de que se haya propagado a tres llamadas más.
La ventaja de ejecutar barreras de seguridad en la MCP Gateway es que cada riesgo real del agente se asigna a un control específico e integrado. Las barreras de seguridad integradas de TrueFoundry se ejecutan en la infraestructura gestionada por TrueFoundry, sin necesidad de configurar claves API de terceros.
Más allá de las funciones integradas, la pasarela se conecta con proveedores externos (Palo Alto Prisma AIRS, CrowdStrike AIDR, Cisco AI Defense, AWS Bedrock Guardrails, Google Model Armor, NVIDIA NeMo Guardrails, Guardrails AI, entre otros) y admite barreras de seguridad totalmente personalizadas cuando necesitas una lógica específica para tu dominio.
La barrera de seguridad contra inyección de prompts es la que se ha diseñado específicamente para el problema de los agentes: analiza el prompt del usuario y y cualquier documento o contenido contextual por separado, de modo que una inyección oculta dentro de una página web o un ticket devuelto se detecta incluso cuando el mensaje original del usuario es seguro.
La aplicación de barreras de seguridad al tráfico de los agentes sigue un flujo de tres pasos y, fundamentalmente, nada de esto reside en el código de su agente.
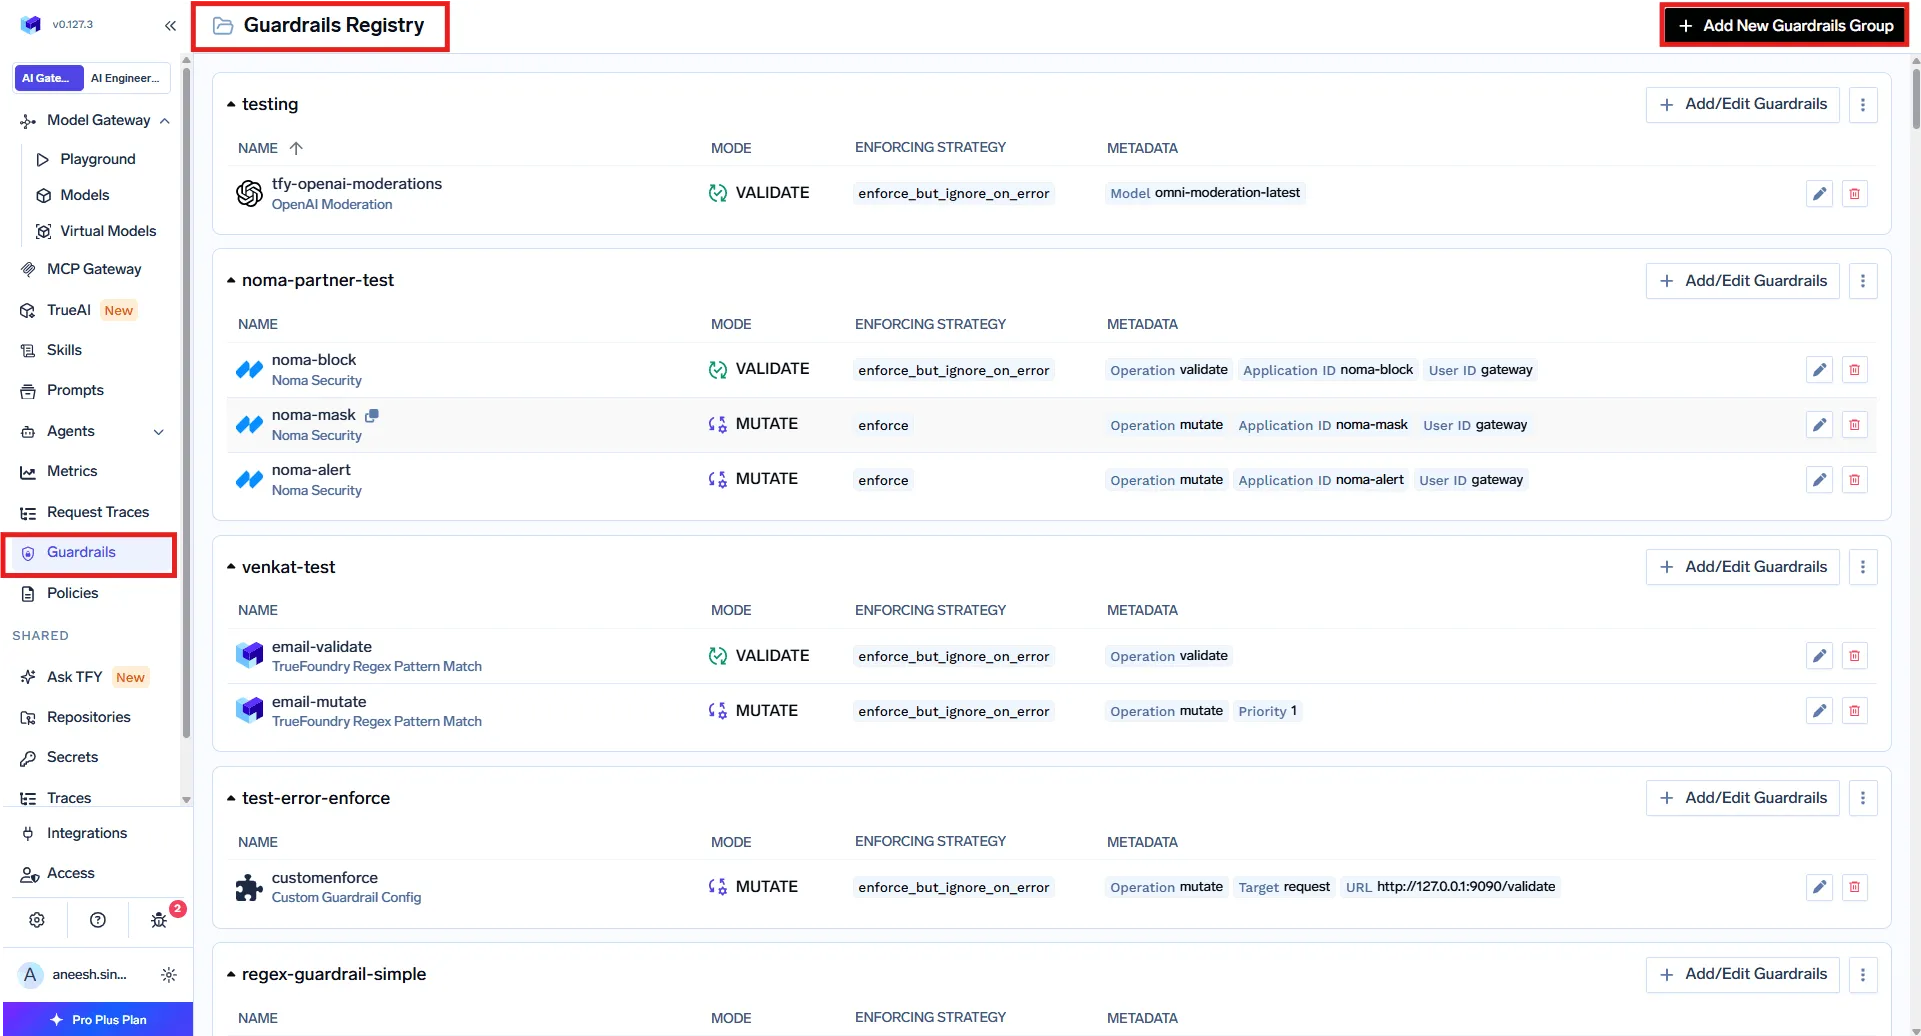
EnAI Gateway → Guardrails, cree un grupo de barreras de seguridad y añada las integraciones que necesite: integradas, de proveedores externos o personalizadas. Un grupo es también la unidad de control de acceso: un gestor puede añadir, editar y eliminar barreras de seguridad; un usuario solo puede aplicarlas. Un patrón común es tener un grupo para toda la organización gestionado por el equipo de plataforma, además de grupos por equipo para comprobaciones específicas de producto.
EnAI Gateway → Policies → Guardrails, cree reglas que decidan cuándo se ejecuta cada barrera de seguridad. Esto es lo que permite que el modelo escale a flotas de agentes: las reglas se basan en el objetivo (los modelos, servidores MCP e incluso herramientas específicas que se están llamando) y el sujeto (usuarios, equipos o cuentas virtuales). Dado que una regla cubre a cada llamante de un servidor MCP o modelo determinado, protege a todos los agentes que acceden a ese objetivo, sin necesidad de configuración por agente.
Cada regla combina:
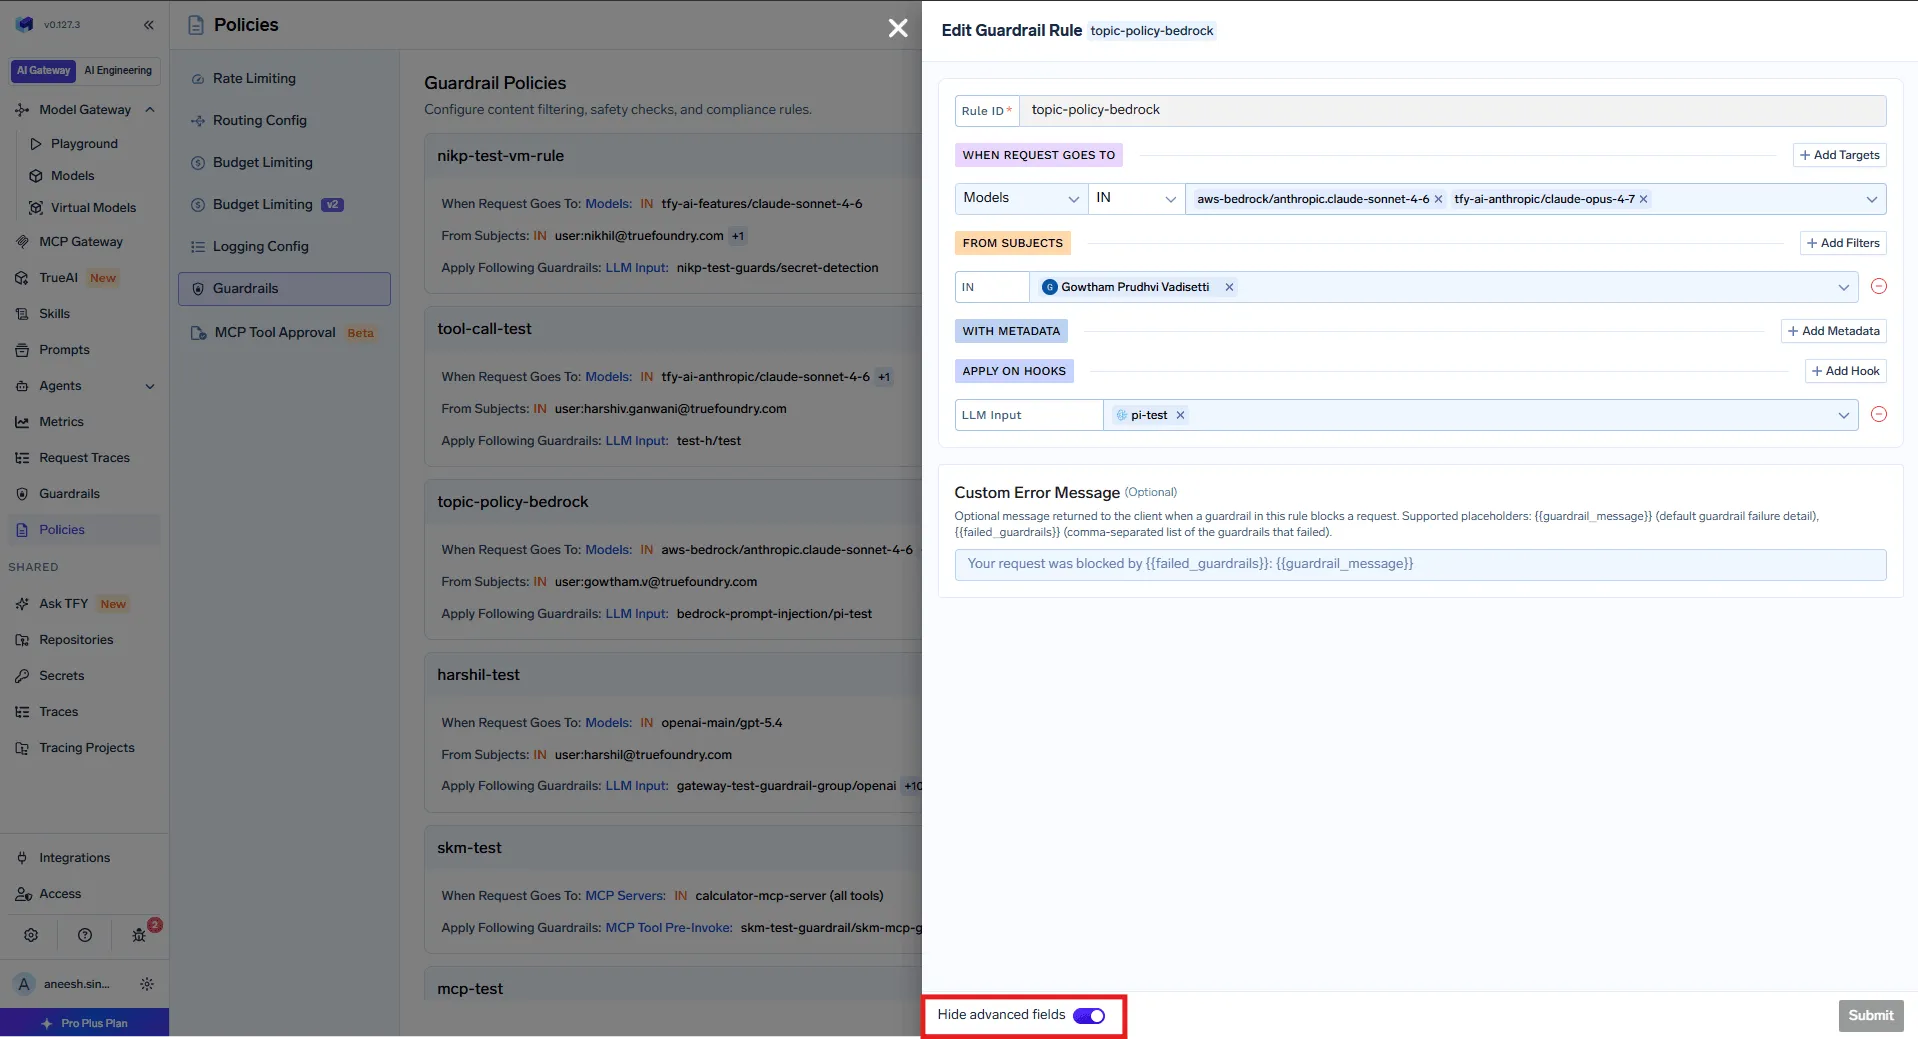
Captura de pantalla del producto — Documentación de TrueFoundry: editor de reglas de políticas de barreras de seguridad.
Todas las reglas que coinciden se evalúan y sus barreras de seguridad se combinan por hook. Si la Regla A aplica detección de PII en la entrada del LLM y la Regla B aplica detección de inyección de prompts en la entrada del LLM, ambas se ejecutan. Una regla sin condiciones de destino o sujeto se convierte en una línea base que se aplica a todo el tráfico; es útil para realizar una comprobación de inyección de prompts a nivel de toda la empresa por encima de todo lo demás.
Para pruebas rápidas o llamadas puntuales, también puede pasar barreras de seguridad por solicitud con la cabecera X-TFY-GUARDRAILS, lo que omite las políticas por completo:
curl https://<your-gateway>/api/llm/chat/completions \
-H "Authorization: Bearer $TFY_API_KEY" \
-H 'X-TFY-METADATA: {"environment":"production","agent":"research-agent"}' \
-H 'X-TFY-GUARDRAILS: {"llm_input":["global/prompt-injection","global/pii-detection"]}' \
-H "Content-Type: application/json" \
-d '{
"model": "openai-main/gpt-4o",
"messages": [{"role":"user","content":"Summarize ticket #4521 and email the customer"}]
}'
Cada solicitud se rastrea junto con las barreras de seguridad que se ejecutaron y sus veredictos, para que pueda confirmar la cobertura antes de confiar en ella. Aquí es también donde se ajustan los falsos positivos, que son más importantes para los agentes que para los chatbots: un salto bloqueado puede hacer fallar toda una cadena.
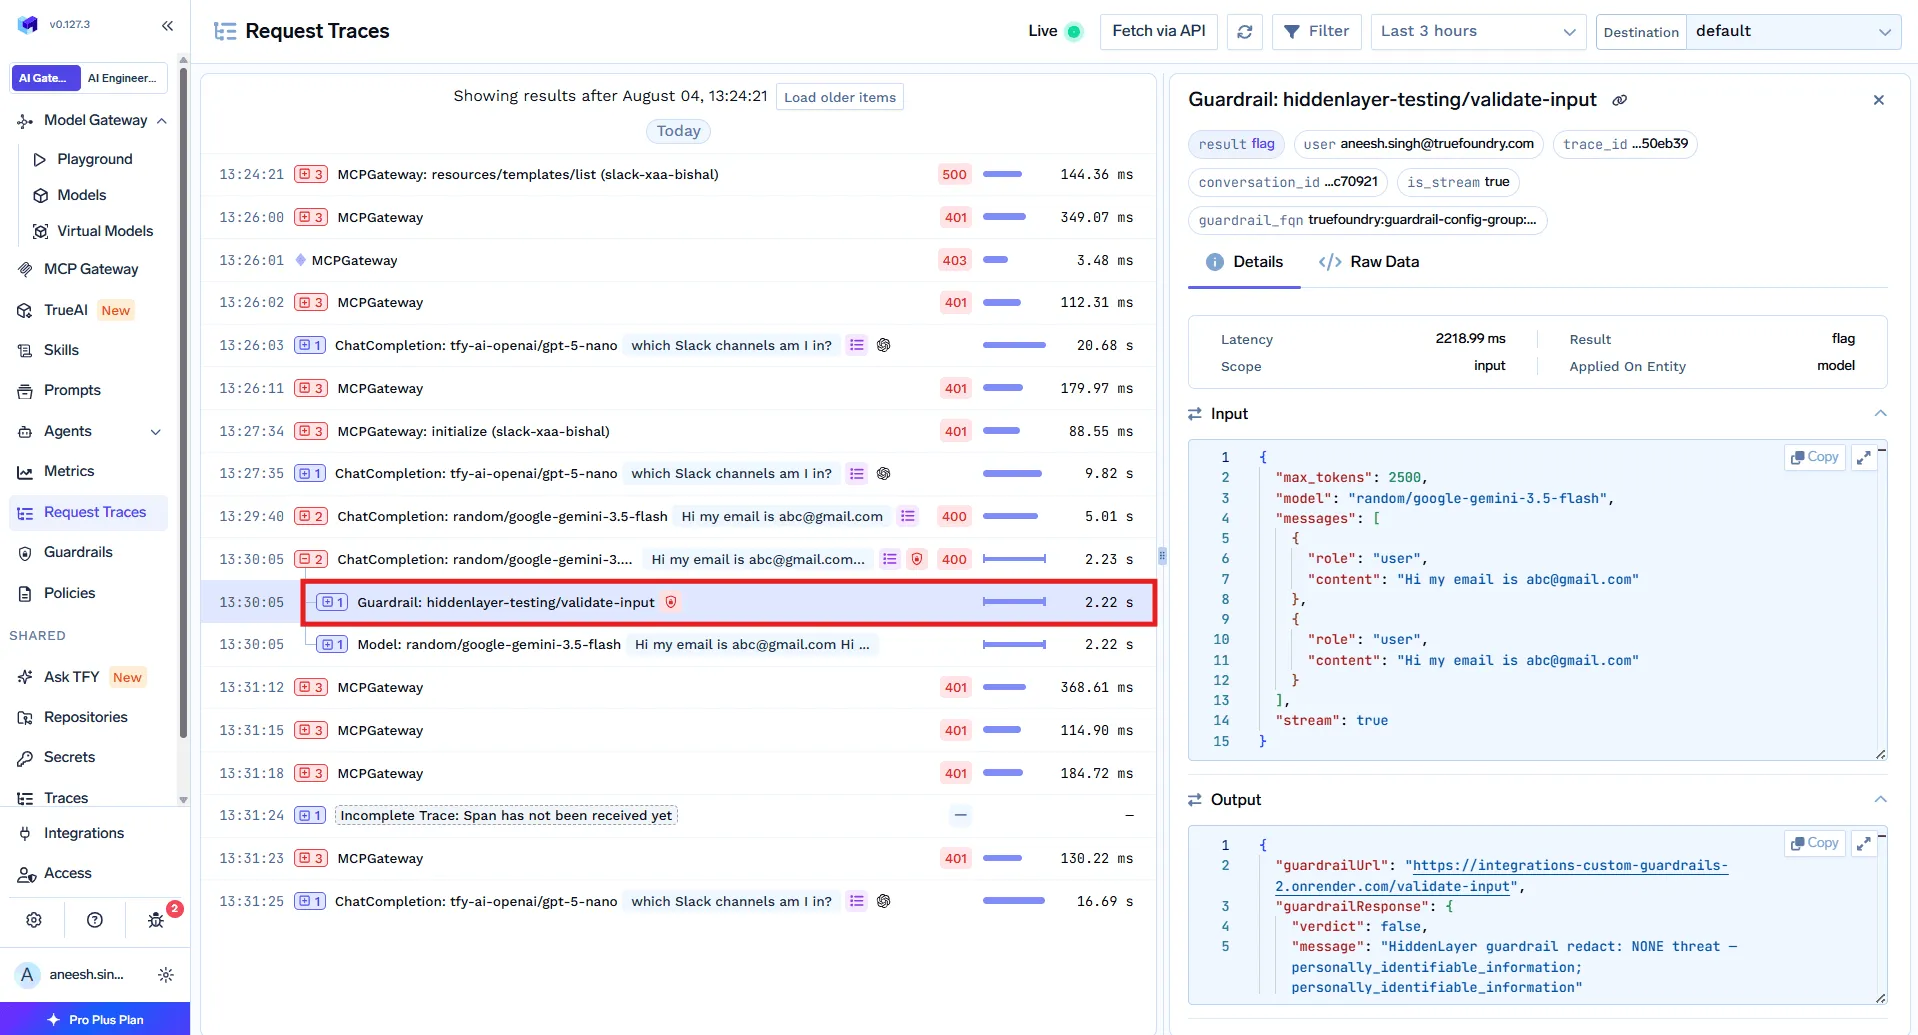
Captura de pantalla del producto — Documentación de TrueFoundry: resultados de las barreras de seguridad en un seguimiento de solicitud.
Antes de publicar, utiliza el Playground para realizar pruebas de prompts y llamadas a herramientas en los cuatro hooks y observar qué es lo que se detecta.
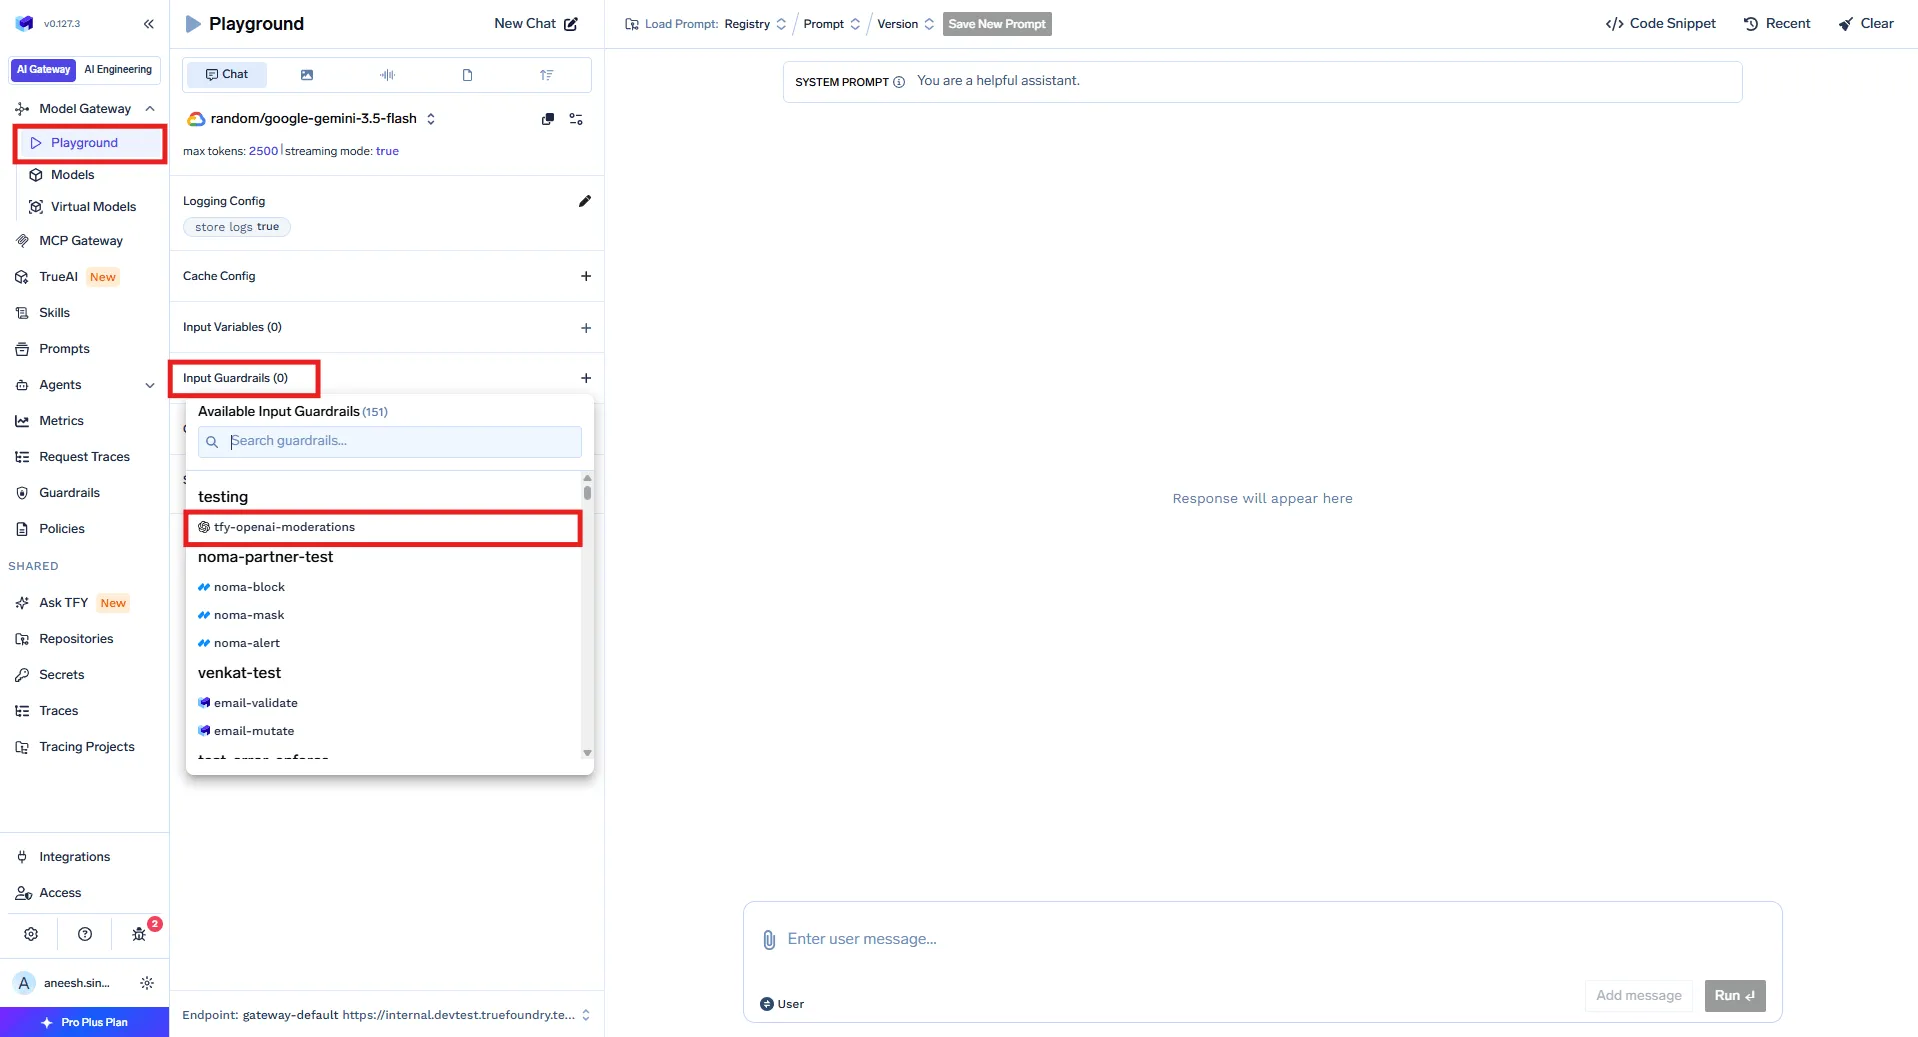
Captura de pantalla del producto: documentación de TrueFoundry: AI Gateway Playground.
Dos ajustes controlan el comportamiento de cada guardrail.
Modo de operación:
Estrategia de aplicación:
Para lógica personalizada, despliegas un guardrail como servicio HTTP y la pasarela lee su contrato de respuesta: un HTTP 2xx significa que el guardrail se ejecutó, y el cuerpo JSON contiene el resultado — verdict: false para denegar, o un cuerpo de resultado mutado para reescribir:
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada
















