



October 15, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 8, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Ein stiller architektonischer Wandel ist bereits in vollem Gange.
Unternehmen begannen damit, Anwendungen mit OpenAI, Anthropic, Gemini, Open-Source- und internen Modellen zu verbinden. Sie ergänzten Gateways für API-Schlüssel, Ratenbegrenzungen, Provider-Routing und Nutzungsverfolgung. Dann kamen die Agenten.
Plötzlich benötigte der Stack auch MCP-Server, A2A-Kommunikation, Tool-Autorisierung, Speicher, Kontextverwaltung, menschliche Freigaben, Inferenz-Routing, Wiederholungsversuche, Evaluierung und Richtliniendurchsetzung. Jede Anforderung schuf ein weiteres Produkt, einen Proxy, eine Bibliothek oder ein Team.
Das Ergebnis kommt einem bekannt vor: mehrere gute Tools, mehrere Kontrollpunkte, aber kein zentraler Ort, der den gesamten Prozess überblickt.
Ein Agent kann drei Modelle aufrufen, fünf Tools einsetzen, Aufgaben an einen Sub-Agenten delegieren, für eine Freigabe pausieren, aus dem Speicher fortfahren und ein Produktionssystem aktualisieren. Kosten, Risiko, Latenz und geschäftlicher Mehrwert ändern sich bei jedem Schritt.
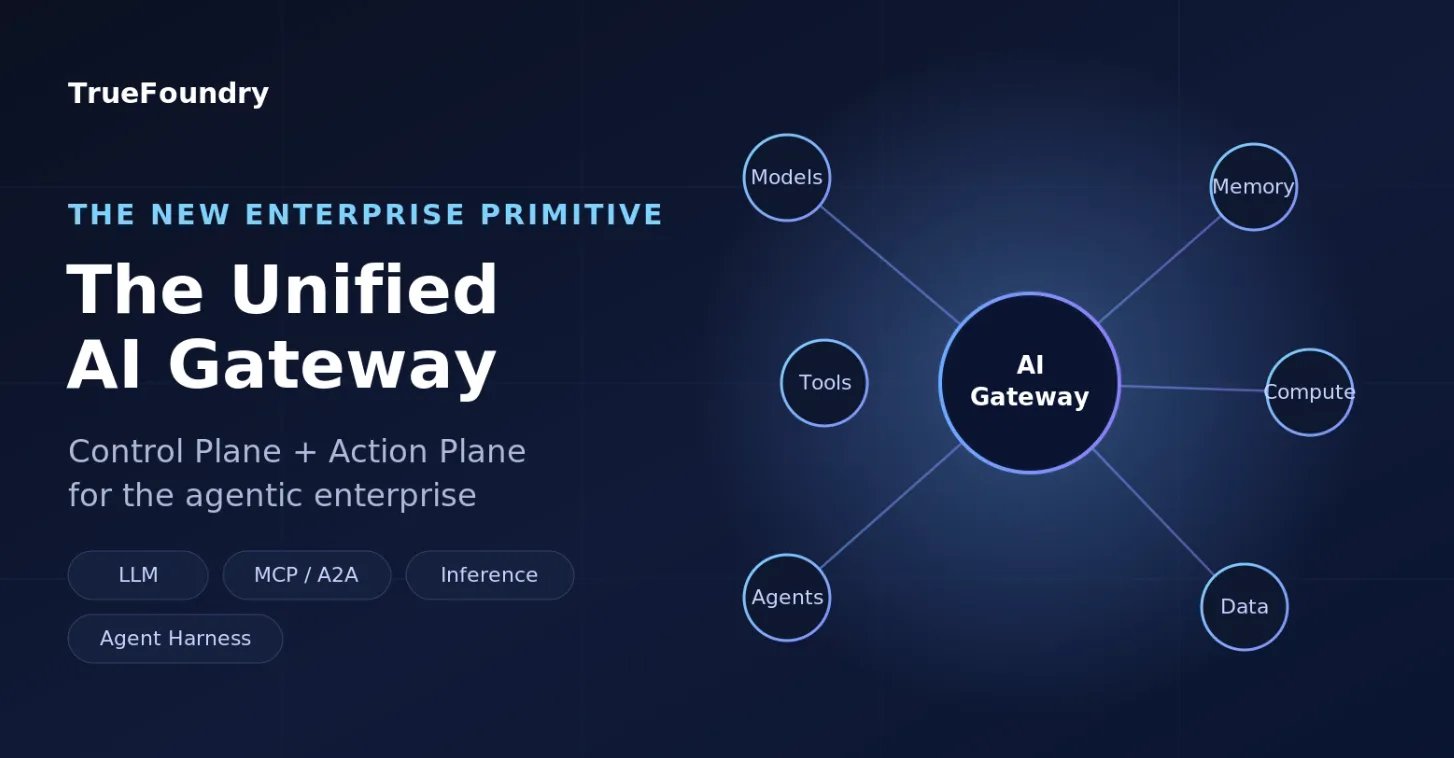
Deshalb entwickelt sich das Gateway zu einer Steuerungs- und einer Aktionsebene über Modelle, Tools, Agenten, Daten und Rechenleistung hinweg.
Ich sehe das AI Gateway als grundlegendes Element für Unternehmen – sowohl unter dem Aspekt der Token-Optimierung als auch der maximalen Wertschöpfung.
Token-Optimierung bedeutet, aus jedem Token, jedem Modellaufruf, jedem GPU-Zyklus und jeder investierten Einheit mehr nutzbare Arbeit herauszuholen.
Wertschöpfung bedeutet, jede Aufgabe mit dem Modell, dem Tool, dem Workflow und den Kontrollmechanismen zu verknüpfen, die das beste Geschäftsergebnis liefern.
Eine Dokumentenklassifizierung lässt sich perfekt mit einem kleinen internen Modell durchführen. Eine komplexe Kreditanalyse erfordert möglicherweise ein Spitzenmodell. Ein Kundenservice-Agent nutzt vielleicht ein schnelles Modell für den Abruf, ein leistungsfähigeres Modell für das Reasoning und ein deterministisches Tool für die finale Transaktion. Ein regulierter Workflow erfordert unter Umständen ein souveränes Modell, einen privaten Endpunkt und eine menschliche Kontrollinstanz.
Das Gateway wird zum Ort, an dem diese Entscheidungen getroffen werden.
Meine These ist simpel: AI Gateways werden sich über einfaches Routing hinaus zur Orchestrierungsebene für agentische Systeme entwickeln. Sie werden Modelle dynamisch auswählen und austauschen – basierend auf Kosten, Latenz, Sicherheitsvorgaben, Governance, Datensensibilität und den Anforderungen der jeweiligen Aufgabe.
Jede Aufgabe hat ein anderes Wirtschafts- und Risikoprofil. Das Gateway sollte sie genau so behandeln.
Wenn Agenten skaliert werden, ist die intelligente Zuweisung von Arbeitslasten an das passende Modell entscheidend für die Optimierung von Kosten und Geschäftswert. Dies eröffnet Unternehmen große Chancen, während sie Leistung, Governance und Wirtschaftlichkeit über Tausende von Workflows hinweg in Einklang bringen.
Herkömmliche Gateways basierten auf Endpunkten, Anfragen, Antworten und Dienstidentitäten.
Agenten führen Sitzungen, Pläne, delegierte Befugnisse, Speicher, Tool-Aufrufe und langlebige Zustände ein. Das Gateway muss nun wissen, wer die Aufgabe initiiert hat, welcher Agent agiert, welche Befugnisse delegiert wurden, auf welche Daten zugegriffen werden darf, welche Tools aufgerufen werden können, wie hoch das Budget ist, welches Modell für den jeweiligen Schritt geeignet ist und welche Genehmigungen erforderlich sind.
Diese Fragen machen das Gateway zu einer Entscheidungsmaschine.
Eine Zahlungsabfrage und eine Zahlungsfreigabe können dieselbe Anwendung und dasselbe Protokoll nutzen. Ihre Risikoprofile unterscheiden sich jedoch drastisch. Das Gateway benötigt Richtlinien auf der Ebene von Absicht und Aktion.
Hier kommt die Action Plane ins Spiel. Sie steuert, was der Agent tun kann, wie er es tun kann und was geschehen muss, bevor die Aktion ein System of Record erreicht.
Das LLM-Gateway verwaltet bereits den Anbieterzugriff, Fallbacks, Ratenbegrenzungen, Token-Budgets und Observability.
Seine nächste Aufgabe ist tiefgreifender: die Auswahl des besten Modells für jeden Schritt basierend auf Leistungsfähigkeit, Preis, Latenz, Kontextlänge, Datenrichtlinien und geschäftlicher Kritikalität. Das Routing entwickelt sich von statischen Regeln hin zu einer arbeitslastbewussten Orchestrierung.
MCP verbindet Agenten mit Tools, Daten und Unternehmenssystemen. A2A ermöglicht es Agenten, zu kommunizieren und Aufgaben zu delegieren.
Das Gateway muss die Delegationskette abbilden, Berechtigungen auf Tool-Ebene durchsetzen, OAuth-Token vermitteln, Scopes validieren, Mandanten isolieren und jede Aktion protokollieren. Die Identität von Agenten wird zu einem grundlegenden Sicherheitsmerkmal.
Unternehmen werden Modelle über öffentliche APIs, private Clouds, On-Premise-Cluster, souveräne Umgebungen und Edge-Infrastrukturen hinweg betreiben.
Das Inference-Gateway entscheidet basierend auf Kapazität, Lokalität, Datenresidenz, GPU-Verfügbarkeit, Kosten und Leistung, wo eine Arbeitslast ausgeführt wird. Dies schafft eine direkte Brücke zwischen Anwendungsabsicht und Infrastrukturökonomie.
Das Agent-Harness verwaltet Tool-Nutzung, Wiederholungsversuche, Fehlerbehebung, Kontextkomprimierung, Speicherpersistenz, State-Offloading, Sub-Agent-Zustände, Lifecycle-Hooks, Berechtigungen, menschliche Genehmigungen, Verifizierung und Telemetrie.
Sobald diese Funktionen neben Routing und Richtlinien angesiedelt sind, beginnt die Grenze zwischen Gateway und Harness zu verschwimmen.
Die Steuerungsebene definiert Identität, Richtlinien, Routing, Budgets, Modellberechtigung, Datenresidenz, Tool-Berechtigungen, Risikoschwellenwerte und Genehmigungsanforderungen.
Sie beantwortet die Fragen: Was soll unter welchen Bedingungen und mit welchen Ressourcen geschehen?
Die Ausführungsebene ruft Modelle auf, aktiviert Tools, verwaltet Sitzungen, koordiniert Agenten, steuert Wiederholungsversuche, speichert Zustände, fordert Genehmigungen an, validiert Ergebnisse und protokolliert Nachweise.
Sie beantwortet die Frage: Wie gelangt die Arbeit sicher von der Absicht zum Ergebnis?
Die Verknüpfung dieser Verantwortlichkeiten schafft einen entscheidenden Vorteil. Ein Modellausfall kann einen sicheren Fallback auslösen. Ein Budgetschwellenwert kann Aufgaben an ein kleineres Modell weiterleiten. Sensible Daten können die Ausführung auf einen privaten Endpunkt umleiten. Eine risikoreiche Aktion kann eine menschliche Überprüfung erfordern.
Der Workflow bleibt dynamisch, während die Unternehmensrichtlinien konsistent bleiben.
Das Gateway sollte den gesamten Verlauf erfassen: Benutzerabsicht, Agentenplan, Modellauswahl, Kontextquellen, Tool-Aufrufe, Richtlinienentscheidungen, Genehmigungen, Kosten, Latenz und das Endergebnis.
Diese Rückverfolgbarkeit unterstützt Audits, Vorfallanalysen, Modellvergleiche, Richtlinienanpassungen und die Messung der Kosten pro abgeschlossener Aufgabe.
Das Gateway kann Konversationen komprimieren, Zustände auslagern, den Speicher von Sub-Agenten isolieren und steuern, welcher Kontext an ein Modell zurückgegeben wird. Die Verifizierung schließt den Kreis durch Schema-Prüfungen, Geschäftsregeln, Groundedness-Tests, deterministische Validierung, Überprüfung durch Sekundärmodelle und menschliche Freigabe.
Das Gateway wird zum Ort, an dem aus Ergebnissen vertrauenswürdige Aktionen werden.
Agenten-Flotten erzeugen eine massive Auffächerung über Modelle, Tools und Sub-Agenten hinweg. Eine einzige Benutzeranfrage kann Dutzende nachgelagerte Aufrufe auslösen, wodurch Gateway-Latenz, Speichernutzung und Durchsatz schnell zu Kosten- und Zuverlässigkeitsfaktoren werden.
Das Agent-Gateway verfolgt einen First-Principles-Ansatz mit Rust, einer leichtgewichtigen Laufzeitumgebung, hohem Durchsatz und nativer Unterstützung für Agenten-Protokolle. Die veröffentlichte Benchmark-Umgebung meldet etwa 30 MB Speicherbedarf, 165.000 Anfragen pro Sekunde und eine Latenz von 0,09 Millisekunden.
Die genauen Zahlen variieren je nach Arbeitslast und Infrastruktur, aber das Prinzip ist klar: Jede zusätzliche Millisekunde, jeder Wiederholungsversuch und jede Speicherzuweisung summieren sich über Tausende von Agenten hinweg. Im Unternehmensmaßstab beeinflusst die Gateway-Leistung direkt die Inferenzkosten, die Benutzererfahrung und die Skalierbarkeit der Plattform, bevor die Infrastruktur zum Flaschenhals wird.
Ein einheitliches Gateway bietet Unternehmen einen zentralen Ort zur Steuerung von Modellen, Tools, Agenten, Inferenz, Identität, Kosten und Nachweisen.
Teams profitieren von Modellportabilität. Sicherheitsteams erhalten Durchsetzungsmöglichkeiten auf Aktionsebene. Finanzteams erhalten Budgetkontrollen, die direkt mit Workflows verknüpft sind. Plattformteams profitieren von Routing über verschiedene Anbieter und private Infrastrukturen hinweg. Risikoteams erhalten eine lückenlose Nachvollziehbarkeit von der Benutzerabsicht bis zur finalen Aktion.
Produktteams arbeiten schneller, da die Plattform die komplexen Herausforderungen zentral löst.
Neue Modelle lassen sich schnell integrieren. Neue Tools übernehmen bestehende Richtlinien. Neue Agenten nutzen dieselben Muster für Identität, Speicher, Beobachtbarkeit und Genehmigungen. Jeder Anwendungsfall baut auf demselben Fundament auf.
Die nächste Phase der Unternehmens-KI wird durch die Qualität der Orchestrierung definiert.
Modelle werden sich ständig weiterentwickeln. Protokolle werden ausgereifter. Die Inferenz wird sich über Clouds und private Infrastrukturen verteilen. Agenten werden autonomer und tiefer mit Kernsystemen vernetzt sein.
Unternehmen benötigen eine Ebene, die den gesamten Ausführungspfad überblickt und in Echtzeit steuern kann.
Diese Ebene ist das AI Gateway.
Es fungiert als Steuerungsebene für Richtlinien, Identität, Routing, Governance und Wirtschaftlichkeit.
Es fungiert als Ausführungsebene für Orchestrierung, Tools, Speicher, Verifizierung und Umsetzung.
Das führende Gateway unterstützt jeden Agenten dabei, bei jedem Schritt die beste Wahl zu treffen: das richtige Modell, das passende Tool, die optimale Rechenleistung, die notwendige Kontrolle und das angemessene Maß an menschlicher Einbindung.
So verwandeln Unternehmen bloße KI-Aktivitäten in echten geschäftlichen Mehrwert.
Besonders beeindruckend ist, wie TrueFoundry Modell-Routing, MCP-Zugriff, Agenten-Ausführung und Inferenz-Management in einer einzigen, kontrollierten Plattform vereint. Das Gateway übernimmt Authentifizierung, Ratenbegrenzungen, Budgets, Sicherheitsvorgaben, Beobachtbarkeit und Failover für gehostete sowie selbstverwaltete Modelle. Die MCP-Schicht ergänzt dies um kontrollierte Tool-Erkennung, OAuth, Token-Austausch und Richtlinien auf Tool-Ebene, während der Agent Hub dieselben Kontrollen auf die Orchestrierung und Ausführung von Sub-Agenten überträgt. In der Praxis erhalten Unternehmen einen konsistenten Pfad von der Modellauswahl über die Tool-Nutzung bis hin zur finalen Aktion. Genau so sollte eine praxistaugliche Steuerungs- und Ausführungsebene aussehen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet

















