



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Team von TrueFoundry hat im letzten Monat intensiv daran gearbeitet, unsere ML-Deployment-Plattform um neue Funktionen zu erweitern. Unser Ziel ist es, eine Plattform zu schaffen, die das Deployment von ML-Modellen und -Diensten absolut einfach macht und gleichzeitig höchste Engineering- und Sicherheitsstandards durchsetzt. Um eine exzellente ML-Plattform aufzubauen, benötigen wir ein solides technisches Fundament. Deshalb lag unser anfänglicher Fokus vor allem darauf, eine robuste Plattform für das Deployment von Code bereitzustellen.
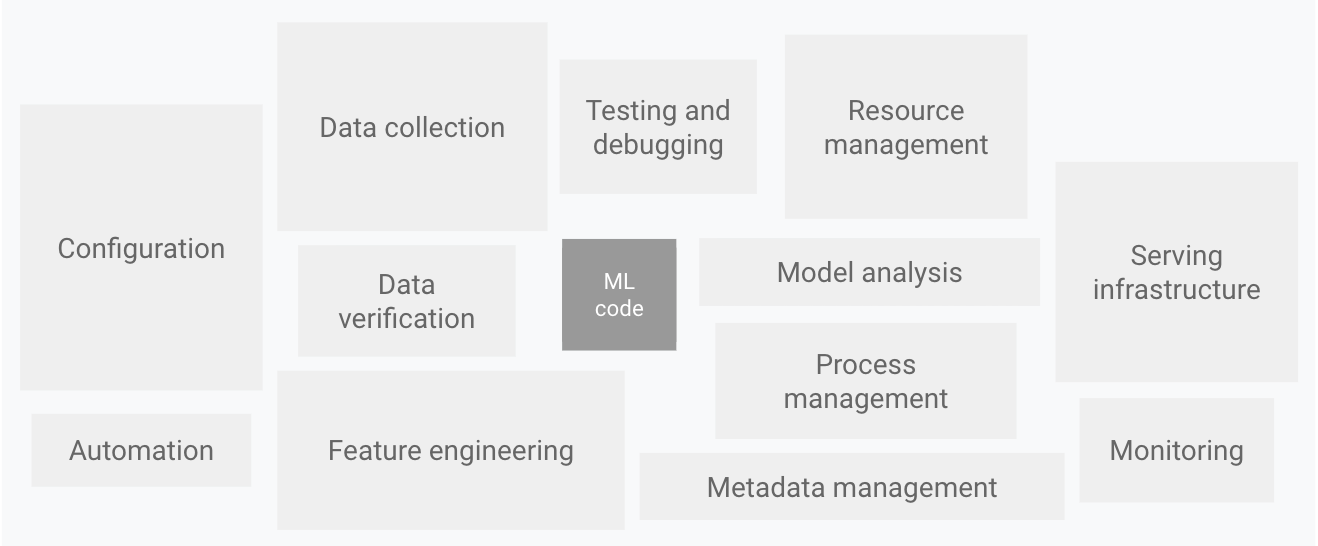
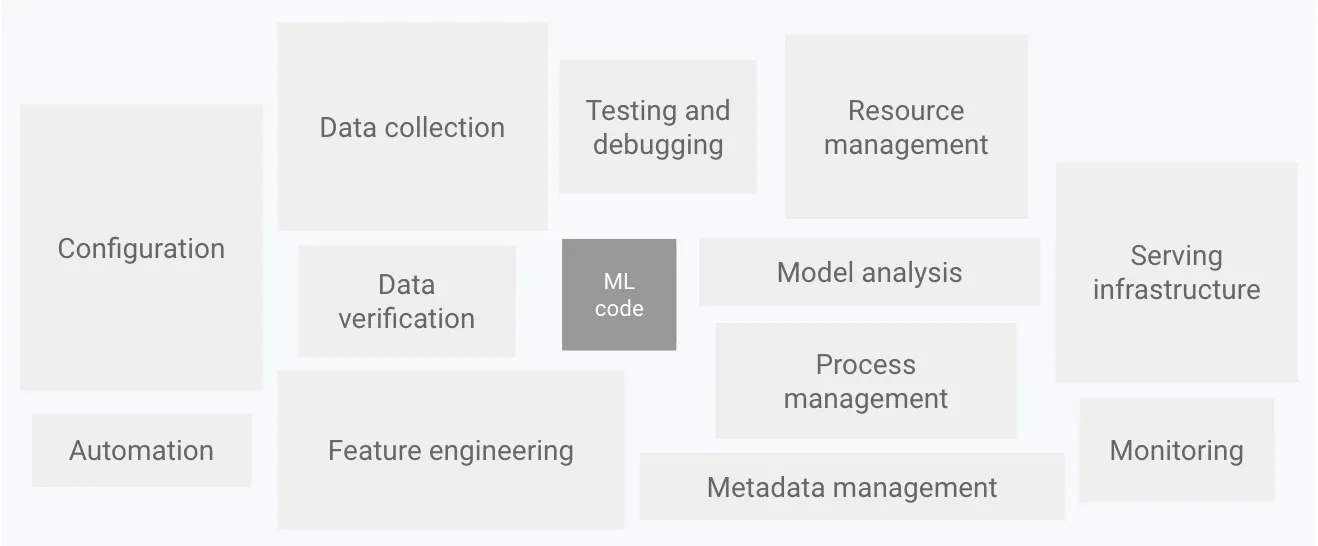
Von allen oben beschriebenen Komponenten der ML-Plattform konzentrieren wir uns auf die Serving-Infrastruktur, das Monitoring und die damit verbundene Automatisierung.
Ein Großteil unserer Arbeit floss in den Aufbau unserer Deployment-Plattform auf Basis von Kubernetes. Das Ziel war es, Deployments in unter 5 Minuten zu ermöglichen, wobei die Plattform den gesamten Prozess übernimmt: vom Erstellen des Images aus dem Quellcode über das Speichern in einer Docker-Registry bis hin zum finalen Deployment der Anwendung auf Kubernetes. Hier sind einige der Updates aus dem letzten Monat:
Machine-Learning-Modelle können je nach Instanztyp sehr unterschiedliche Inferenz-Latenzen oder Leistungsmerkmale aufweisen. Beim Testen der Inferenz-Latenz eines Hugging-Face-Modells auf Intel- im Vergleich zu AMD-Prozessoren haben wir beispielsweise festgestellt, dass Intel-Prozessoren etwa 30 % schneller sind. Deshalb bieten wir Nutzern nun die Möglichkeit, den Instanztyp bei der Bereitstellung ihrer Workloads selbst zu wählen. Wird kein Instanztyp ausgewählt, kann der Workload auf jedem verfügbaren Instanztyp bereitgestellt werden.

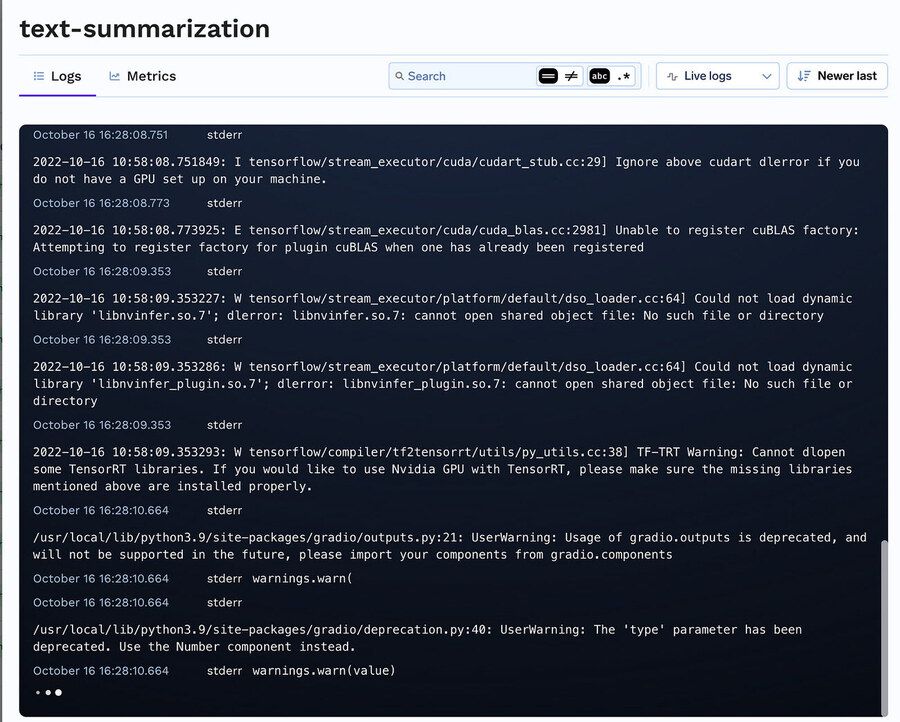
Zuvor haben wir Grafana-Links zur Anzeige von Logs und Metriken verwendet. Obwohl Grafana sehr flexibel anpassbar ist, waren Berechtigungs- und Zugriffssteuerungen dort kaum möglich. Zudem erwies es sich als etwas langsam und für Nutzer, die nicht mit Grafana vertraut waren, als schwer verständlich. Deshalb haben wir eine eigene Benutzeroberfläche für Logs und Metriken implementiert, die in den meisten Fällen ausreichen sollte. Für fortgeschrittene Nutzer bieten wir in der Public Cloud weiterhin die Grafana-Integration an.

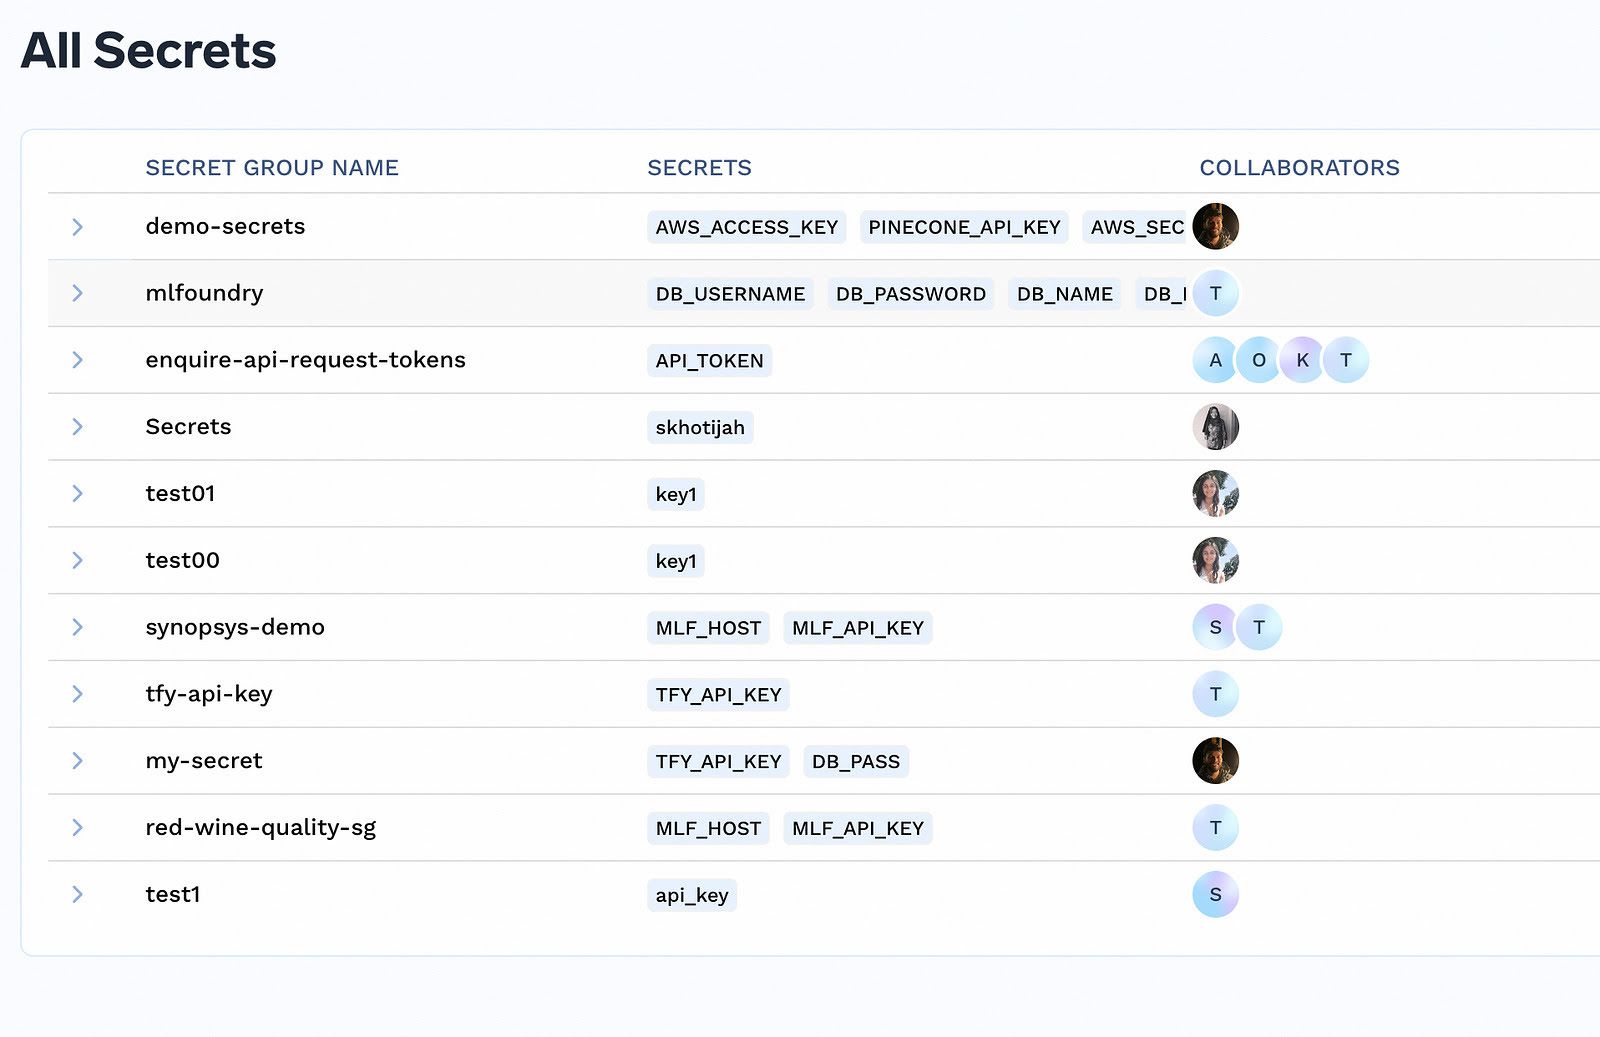
Nutzer können nun für Secret-Gruppen als Editor, Viewer oder Admin hinzugefügt werden.
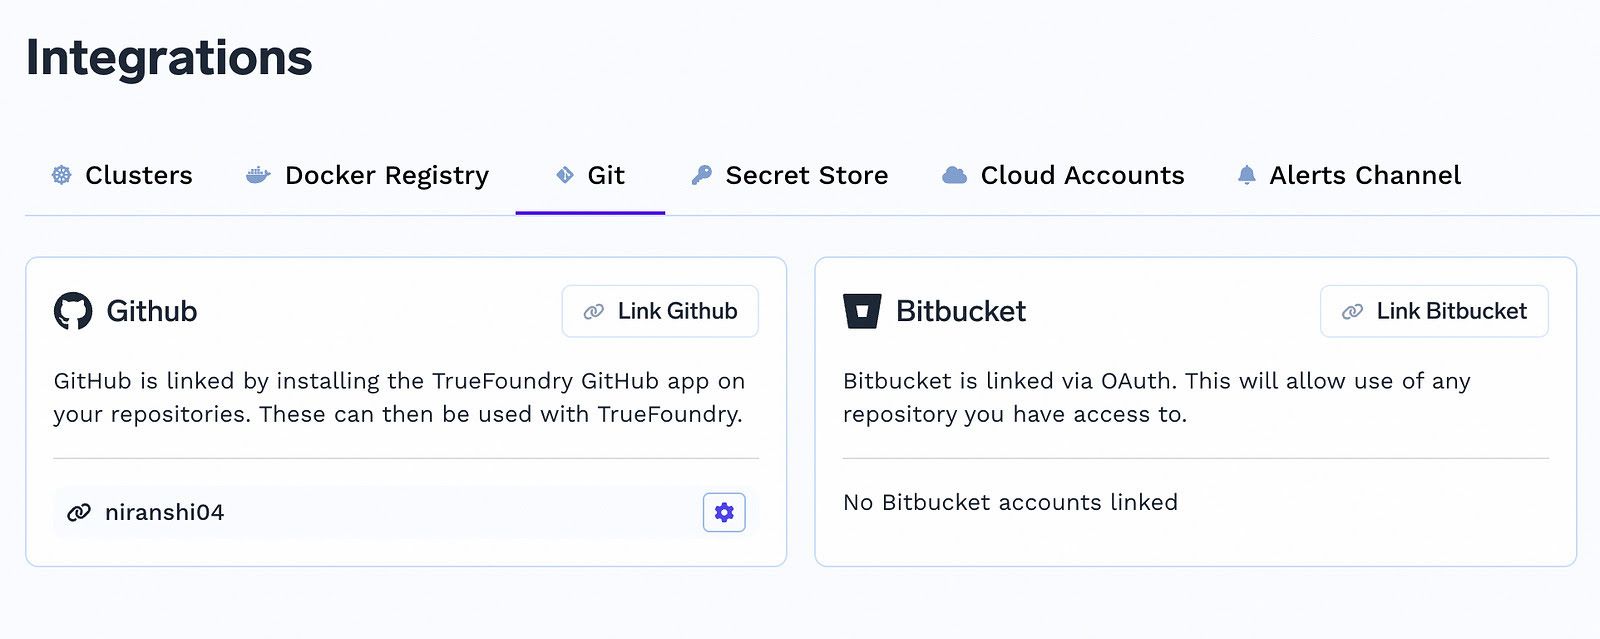
Sie können nun direkt aus beliebigen GitHub- oder Bitbucket-Repositories auf TrueFoundry deployen. Nutzer können ihre privaten Repositories über den OAuth-Flow integrieren und die entsprechenden Parameter für das Deployment der Anwendung auswählen.
Im nächsten Monat arbeiten wir an einigen spannenden Funktionen, wie zum Beispiel:
Bleiben Sie gespannt und lassen Sie uns wissen, was Sie denken!
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















