October 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Requesty bietet ein einheitliches LLM-Gateway für den Zugriff auf Hunderte von Modellen über eine einzige API. Die öffentliche Preisgestaltung ist transparent. Kunden mit nutzungsbasierter Abrechnung zahlen einen Aufschlag von 5 % auf die Kosten der zugrunde liegenden Modelle. Es gibt keine Standardgebühren pro Nutzer oder Mindestabnahmeverpflichtungen. Enterprise-Pläne basieren auf individuellen Preisen.
Dieses Modell eignet sich für Teams, die ein verwaltetes AI Gateway mit breitem Modellzugriff und minimalem Infrastrukturaufwand suchen. Requesty umfasst Routing, Caching, Failover, Ausgabenkontrolle und Observability für über 600 Modelle. Teams können auch eigene Anbieter-Keys verwenden, wobei Requesty derzeit einen Aufschlag von 0 % angibt.
Unternehmenskunden sollten daher über den reinen Prozentsatz hinausblicken. Die tatsächlichen Kosten für Requesty AI hängen von der Modellauswahl, dem Datenverkehr, den Anbieterverträgen, dem Output-Volumen und den Agent-Wiederholungsversuchen ab. Auch Sicherheitsanforderungen und der Bedarf an privaten Bereitstellungen können die endgültige Entscheidung für eine Plattform beeinflussen.
Requesty bietet drei öffentliche Preismodelle an. Der kostenlose Tarif ermöglicht den Zugriff auf Modelle mit 200 Anfragen pro Tag und erfordert keine Kreditkarte. Bei der nutzungsbasierten Abrechnung werden 5 % auf die Preise der zugrunde liegenden Modelle aufgeschlagen. Die Enterprise-Preise hängen von organisatorischen Kontrollen, Support-Anforderungen und ausgehandelten Konditionen ab.
Ein API-Key ermöglicht Anwendungen den Zugriff über den einheitlichen Endpunkt. BYOK ist wichtig für Unternehmen, die ausgehandelte Anbieterkonditionen mit OpenAI, Anthropic oder anderen Anbietern haben. So können Teams diese Verträge beibehalten und gleichzeitig die Routing- und Monitoring-Ebene von Requesty nutzen.
Die folgenden Beispiele gehen von einem Modell aus, das 10 $ pro Million Token kostet. Zudem wird angenommen, dass Requesty den Modellzugriff im Rahmen der nutzungsbasierten 5%-Struktur bereitstellt. BYOK-Workloads würden einer anderen Gateway-Wirtschaftlichkeit folgen, da Requesty hierfür derzeit einen Aufschlag von 0 % ausweist.
Szenario
Monatliche Token
Anbieter-Ausgaben
5 % Requesty-Gebühr
Gesamt
Solo-Prototyp
5 Mio.
50 $
2,50 $
52,50 $
Kleines Produktteam
50 Mio.
500 $
25 $
525 $
Wachsende Produktionsauslastung
500 Mio.
5.000 $
250 $
5.250 $
Multi-Service-Agentenplattform
2,5 Mrd.
25.000 $
1.250 $
26.250 $
Große Unternehmens-Workloads
10 Mrd.
100.000 $
5.000 $
105.000 $
Diese Zahlen veranschaulichen die Preisstruktur und nicht die erwarteten Kundenausgaben. Die tatsächlichen Modellkosten variieren stark je nach Anbieter und Modell. GPT, Gemini, Claude und Mistral können zudem unterschiedliche Preise für Input-, Output- und zwischengespeicherte Token haben.
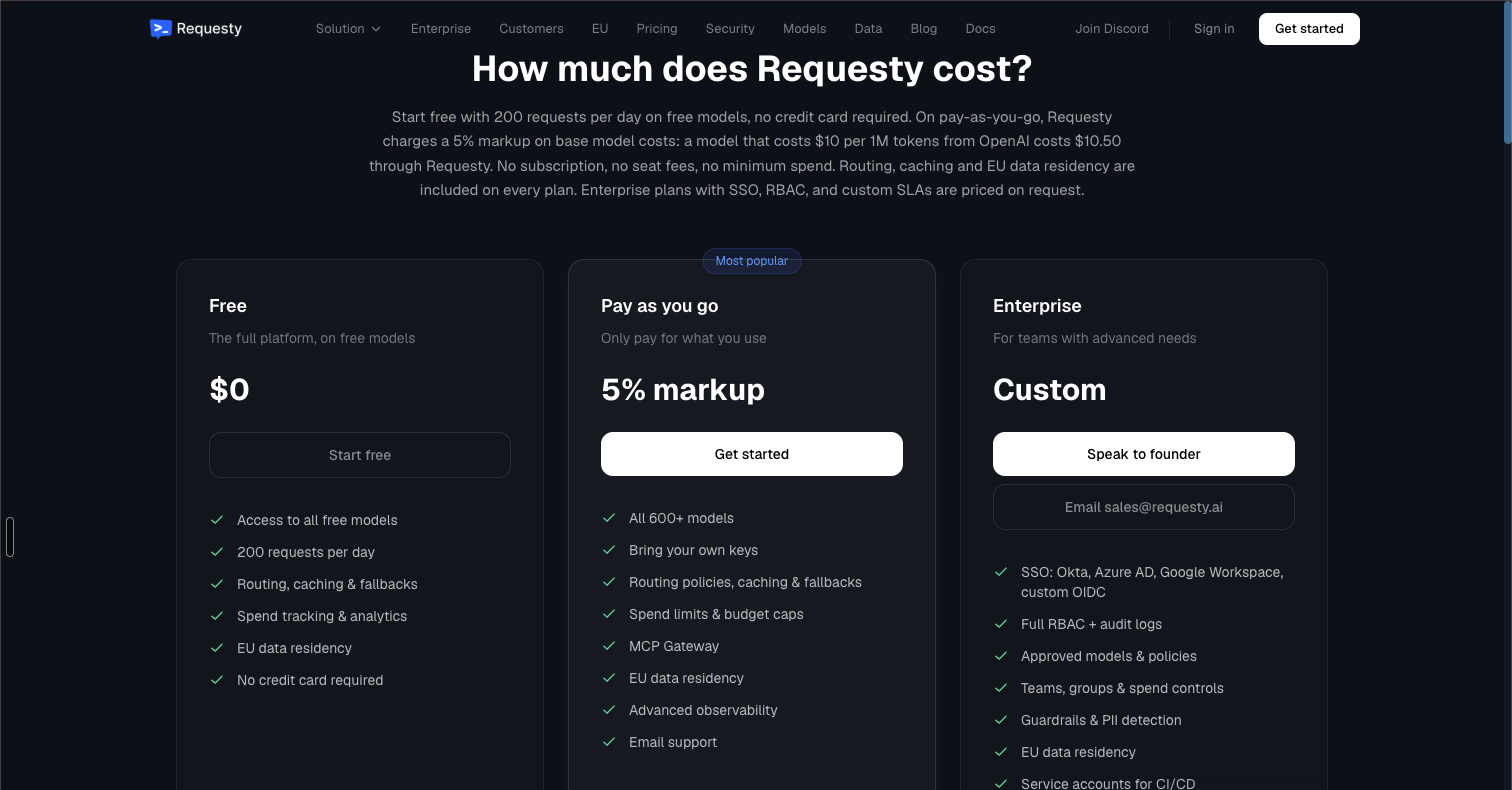
Alternativtext: Die Preisseite von Requesty vergleicht die kostenlose Nutzung mit den kostenpflichtigen Gateway-Tarifen
Dadurch ist Requesty für junge Teams, die einen planbaren Pay-as-you-go-Zugang wünschen, leicht verständlich. Einfacher Start. Einfach der Finanzabteilung zu erklären. Die gesamte Preisseite passt auf einen einzigen Bildschirm.
Preisbereich
Was Requesty bietet
Worauf Teams achten sollten
Standardpreise
5 % Aufschlag auf die Basismodellkosten
Tatsächliche Anbieter- und Modellkombination
Abonnementgebühren
Kein Abonnement aufgeführt
Enterprise-Tarif kann abweichen
Nutzergebühren
Keine Nutzergebühren aufgeführt
Anforderungen für Admins und Teams
Mindestumsatz
Kein Mindestumsatz aufgeführt
Volumenverpflichtungen bei Vereinbarung
Enterprise-Preise
Individuelle Preise
SSO, RBAC, SLAs, Support
Requesty positioniert sich als verwaltetes Gateway für große Sprachmodelle. Die Plattform deckt Modellzugriff, Zuverlässigkeit, Kostenkontrolle, Caching und Monitoring ab. Sie unterstützt OpenAI, Anthropic, Google, AWS Bedrock, Gemini, Mistral und weitere Anbieter über eine kompatible Schnittstelle.
Die Gateway-Ebene umfasst neben dem Modellzugriff verschiedene Funktionen:
Requesty veröffentlicht zudem betriebliche Daten auf Anbieterebene, die Erfolgsraten, die Nutzung von Streaming und das Cache-Trefferverhalten abdecken. Diese Unterschiede verdeutlichen, dass die Modellwahl allein nicht über die Performance in der Produktion entscheidet. Die Zuverlässigkeit des Anbieters kann Routing-Entscheidungen maßgeblich beeinflussen.
Requesty leitet Datenverkehr über eine OpenAI-kompatible Schnittstelle. Bestehende OpenAI-SDK-Integrationen können durch Ändern der Basis-URL und der Requesty-Zugangsdaten umgestellt werden. Dasselbe Muster funktioniert bei verschiedenen gängigen Entwicklungstools und Frameworks.
Wenn Sie bereits das OpenAI-SDK verwenden, verweisen Sie es einfach auf den Router-Endpunkt unter router.requesty.ai und passen den Modell-String an:
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["REQUESTY_API_KEY"],
base_url="https://router.requesty.ai/v1",
)
response = client.chat.completions.create(
model="openai/gpt-4o",
messages=[{"role": "user", "content": "Fasse diesen Vorfallbericht zusammen."}],
)
Modelle folgen einer Syntax nach dem Schema Anbieter/Modellname. Sie können zudem Routing-Richtlinien über Richtlinie/Richtlinienname referenzieren, sodass das Gateway das passende Modell für Sie auswählt.
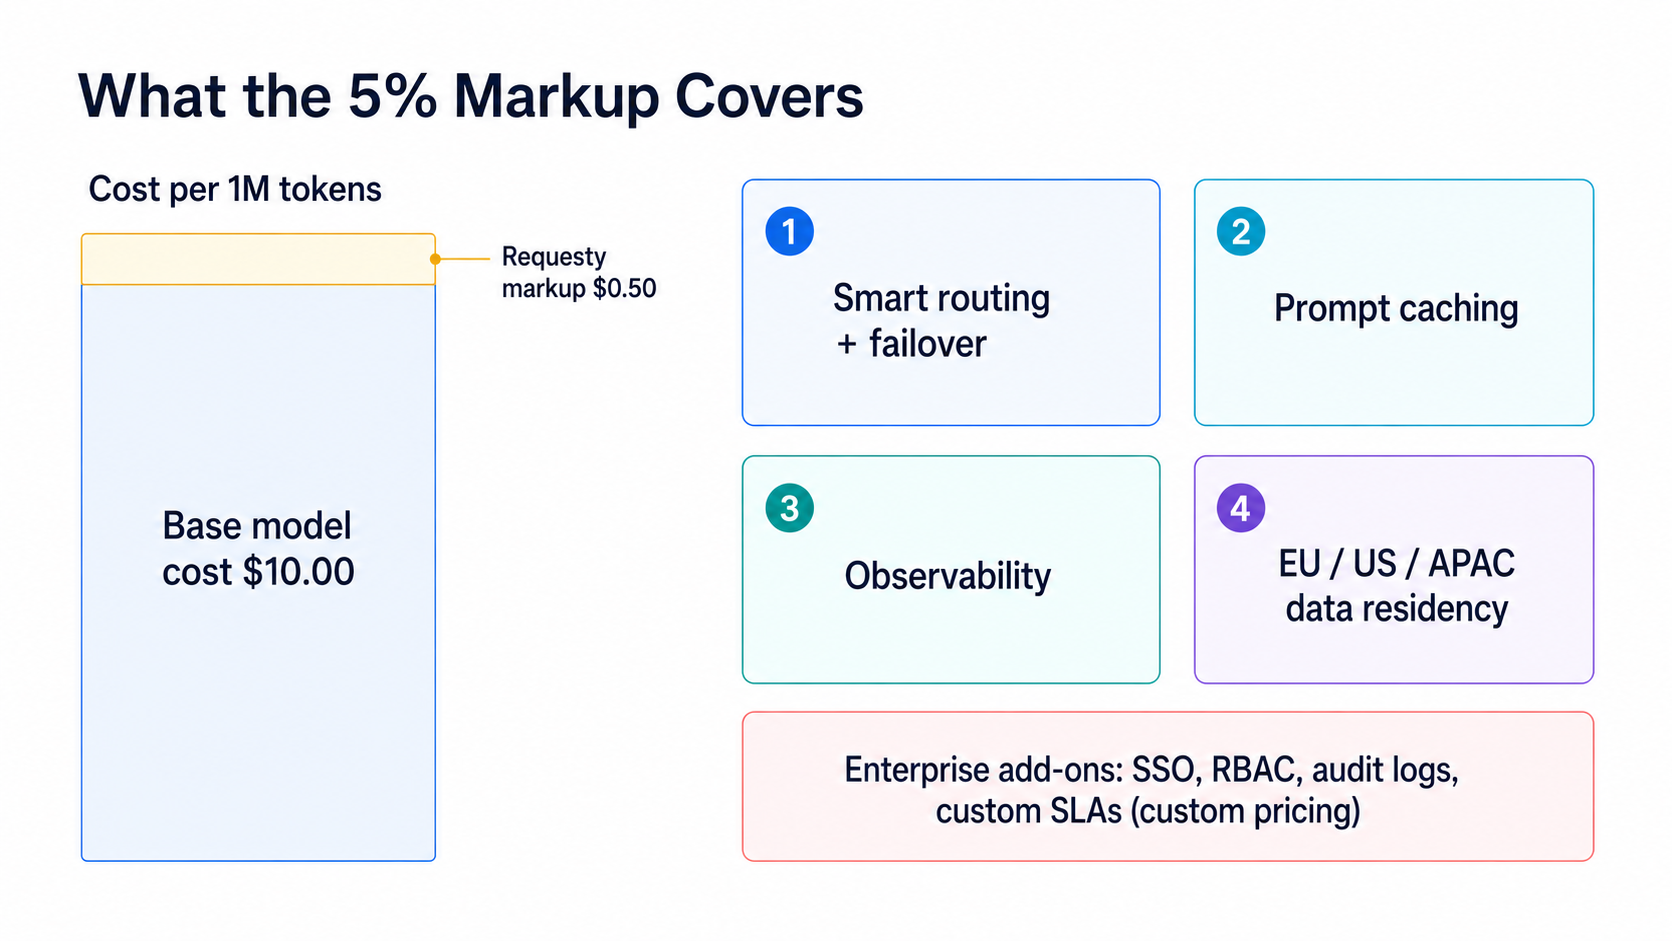
Abbildung 1: Der 5%-Aufschlag deckt die gehostete Gateway-Ebene ab, nicht nur den Modellzugriff
Alternativtext: Die Gebühr für das Requesty-Gateway umfasst Routing, Caching, Monitoring und Failover
Der Prozentsatz selbst ist einfach, während dies für Produktions-Traffic selten gilt. Finanzteams müssen das Anfragevolumen, die Kontextgröße, die Ausgaben, Wiederholungsversuche, das Routing und die Anbieterauswahl schätzen. Auch Caching verändert die effektiven Ausgaben, sobald wiederkehrende Inhalte für einen Cache-Rabatt infrage kommen.
Agenten-Workloads erschweren die Prognose, da eine einzelne Benutzeraktion mehrere Modellaufrufe auslösen kann. Ein Router kann zudem bei Fehlern oder Kapazitätsproblemen zwischen Modellen wechseln. Unterschiedliche Fallback-Richtlinien können daher sowohl die Zuverlässigkeit als auch die Gesamtkosten beeinflussen.
Zur Veranschaulichung: Betrachten Sie 2,5 Milliarden Token pro Monat bei einem Modellpreis von 10 $ pro Million. Die Ausgaben beim Anbieter belaufen sich auf 25.000 $. Eine 5%-Gebühr für das Pay-as-you-go-Modell von Requesty schlägt mit 1.250 $ zu Buche. Diese Berechnung ändert sich bei BYOK (Bring Your Own Key), da Requesty derzeit angibt, dass für Ihre eigenen Anbieterschlüssel kein Aufschlag erhoben wird.
Die wichtigere Erkenntnis ist, dass eine prozentuale Preisgestaltung an die Ausgaben beim Anbieter gekoppelt ist. Teams sollten Nutzungsmuster für ihre Rechnungen modellieren, anstatt sich auf durchschnittliche Token-Preise zu verlassen. Der Leitfaden zur LLM-Kostenoptimierung von TrueFoundry erläutert, wie sich Routing, Caching, Budgets und Zuordnung auf die KI-Ausgaben in der Produktion auswirken.
Kostentreiber
Warum das wichtig ist
Modellauswahl
Frontier-Modelle können die Kosten pro Anfrage erhöhen
Ausgabelänge
Längere Antworten erhöhen den Token-Verbrauch
Agenten-Wiederholungsversuche
Mehrstufige Workflows können die Inferenz vervielfachen
Cache-Trefferquote
Niedrigere Trefferquoten verringern die Einsparungen durch Caching
Routenauswahl
Anbieter können unterschiedliche Preise haben
Unternehmenskontrollen
Erweiterte Anforderungen können die Vertragspreise ändern
Bei der Budgetierung sollten auch Warnmeldungen, Ausgabenlimits und Durchsetzungsmechanismen berücksichtigt werden. Requesty unterstützt Budgetobergrenzen und automatische Abschaltungen. Diese Unterscheidung ist wichtig, da die Überwachung von Ausgaben und das Stoppen von Ausgaben unterschiedliche betriebliche Anforderungen erfüllen.
Requesty und TrueFoundry nutzen unterschiedliche Preismodelle. Requesty berechnet einen Aufschlag von 5 % auf die Kosten der Upstream-Modelle für standardmäßigen Pay-as-you-go-Traffic. TrueFoundry verwendet ein planbasiertes Preismodell, das mit einem kostenlosen Developer-Tarif beginnt. Dessen Preispläne skalieren dann basierend auf dem Anfragevolumen und den Plattformanforderungen.
Der Unterschied gewinnt mit zunehmender Nutzung an Bedeutung. Die Kosten bei Requesty steigen mit den Ausgaben für die Anbieter, sodass teure Modelle oder längere Ausgaben die Gateway-Gebühren erhöhen. Die Preisgestaltung von TrueFoundry orientiert sich hingegen an Anfragekontingenten. Dies kann die Prognose der Governance-Kosten erleichtern, wenn die Ausgaben für Modelle schneller steigen als die Anzahl der Anfragen.
Preisbereich
Requesty AI
TrueFoundry
Einstiegspreise
Kostenlose Version verfügbar
Developer ab 0 $/Monat
Standardpreise
5 % Aufschlag auf Anbieterkosten
Pro ab 499 $/Monat
Erweiterte Kontrollfunktionen
Individuelle Enterprise-Preise
Pro Plus für 2.999 $/Monat
Enterprise-Preise
Individuell
Individuell
Abrechnungsbasis
Prozentsatz der Modellausgaben
Anfragebasierte Kontingente
Bereitstellung
Managed Cloud
SaaS, VPC, On-Premises, Air-Gapped
Die Bereitstellung stellt einen zweiten Unterschied dar. Requesty bleibt ein verwalteter Cloud-Dienst, während TrueFoundrys AI Gateway auch innerhalb der Unternehmensinfrastruktur betrieben werden kann. Dies ist entscheidend, wenn Prompts, Protokolle oder Governance-Kontrollen innerhalb genehmigter Sicherheitsgrenzen verbleiben müssen.
Keines der Preismodelle ist automatisch günstiger. Eine prozentuale Preisgestaltung kann sich für kleinere oder variable Workloads gut eignen. Anfragebasierte Pläne können mit zunehmender Produktionsnutzung besser planbar werden.
Teams, die andere gehostete Gateways vergleichen, können sich auch TrueFoundrys OpenRouter-Preisanalyse für ein weiteres nutzungsbasiertes Modell ansehen. Der LiteLLM-Preisguide bietet einen nützlichen Vergleich für Teams, die eine Open-Source-Gateway-Infrastruktur in Betracht ziehen.
Die endgültige Entscheidung sollte die Preisgestaltung von Requesty AI, die Modellnutzung, die Bereitstellungsanforderungen und das erforderliche Maß an Governance in der Produktion berücksichtigen.
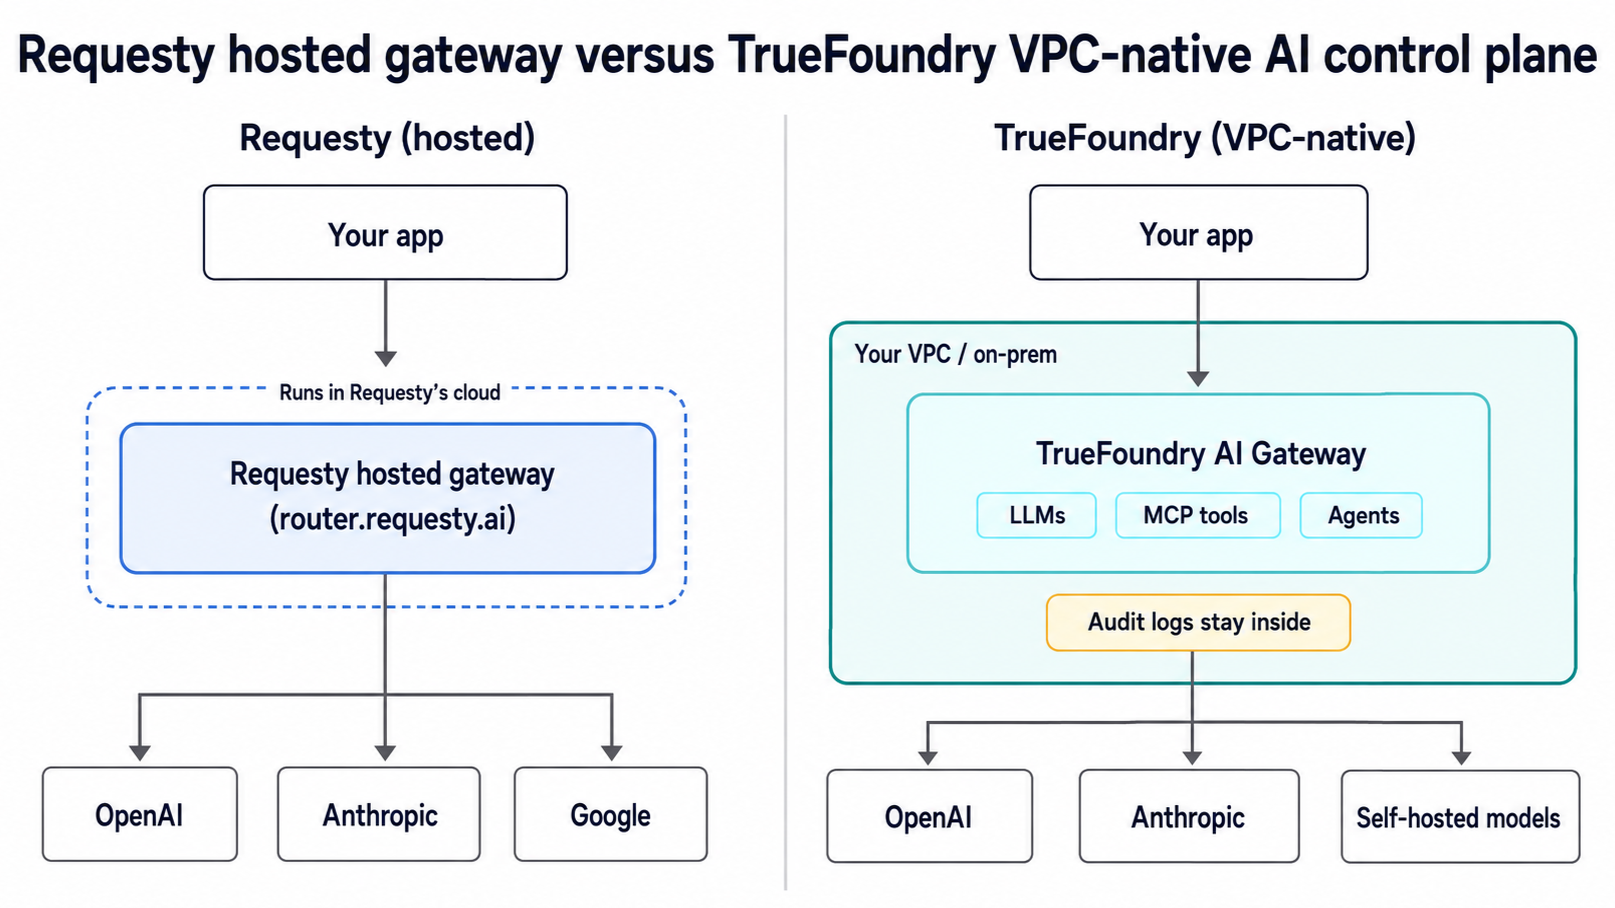
Abbildung 2: Der Preisunterschied ist eigentlich ein Bereitstellungsunterschied: gehostetes Pass-Through gegenüber einem Gateway, das innerhalb Ihrer Sicherheitsgrenzen läuft.
Alt-Text: Requesty und TrueFoundry unterscheiden sich hauptsächlich durch die Bereitstellungsgrenzen im Unternehmen
Requesty eignet sich gut, wenn Teams eine Modellauswahl benötigen, ohne selbst eine Gateway-Infrastruktur betreiben zu müssen. Der verwaltete Dienst reduziert den Einrichtungsaufwand und bietet gleichzeitig intelligentes Routing, Failover, Monitoring und Budgetkontrollen. Für einige Workloads in der Anfangsphase kann dies die beste Alternative zur direkten Integration von Anbietern sein.
Requesty ist eine gute Wahl, wenn:
Stellen Sie sich ein Produktteam vor, das monatlich 500 $ für Anbieter über den einheitlichen Schlüssel von Requesty ausgibt. Bei der aktuellen 5%-Struktur käme eine Gateway-Gebühr von etwa 25 $ hinzu. Eine vergleichbare Routing- und Monitoring-Lösung intern aufzubauen, würde sich in diesem Umfang selten lohnen.
Das Bild ändert sich, sobald der Datenverkehr auf mehrere Teams und Agenten-Workflows verteilt wird. Größere Umgebungen erfordern möglicherweise strengere Konfigurationskontrollen, detaillierte Metadaten, private Netzwerke und konsolidierte Identitätsrichtlinien. Diese Anforderungen sind oft wichtiger als die prozentuale Gebühr selbst.
CRO-BANNER:
Titel: KI-Governance geht über das Routing gehosteter Modelle hinaus
Subtext: Steuern Sie Modelle, Tools, Agenten, Budgets und Richtlinien über ein einziges Gateway
CTA: Jetzt starten
Alt-Text: TrueFoundry zentralisiert die KI-Governance im Unternehmen über das Routing gehosteter Modelle hinaus
Link: https://www.truefoundry.com/book-demo?ref=requesty_ai_pricing
Die Preisgestaltung von Requesty AI bleibt auch dann attraktiv, wenn die architektonischen Anforderungen über das Bereitstellungsmodell hinausgehen. Requesty ist vollständig verwaltet und bietet derzeit kein Self-Hosting an. Unternehmen können jedoch den EU-Standort Frankfurt nutzen und bei Verfügbarkeit regionale Modell-Endpunkte auswählen.
Auch die Richtlinien zur Datenspeicherung erfordern eine genaue Prüfung. Die Self-Service-Protokollierung ist standardmäßig aktiviert und kann Prompt-Inhalte bis zu 30 Tage lang speichern. Teams können die Inhalts-Protokollierung pro Schlüssel deaktivieren. Eine organisationsweite Null-Speicherungs-Richtlinie ist auf Anfrage erhältlich.
Requesty gibt derzeit an, dass sich das SOC 2 Typ II-Programm noch in der Umsetzung befindet. Auf der Sicherheitsseite wird der Abschluss für das dritte Quartal 2026 erwartet. Einkaufsteams in Unternehmen sollten den aktuellen Zertifizierungsstatus direkt verifizieren, bevor sie sich für Compliance-Zwecke darauf verlassen.
Unternehmen sollten sich folgende Fragen stellen:
Dieselben Fragen stellen sich, wenn aus einer Chat-Anwendung ein autonomer Workflow wird. Agenten können Modelle wiederholt aufrufen und interne Systeme ansteuern. Die Anforderungen an die Kontrolle verlagern sich dann von der Modellauswahl hin zu Identität, Tools, Kosten und Ausführungsrichtlinien.
Für Unternehmen, die über ein verwaltetes Modell-Routing hinausgehen möchten, deckt TrueFoundry ein breiteres Spektrum an Infrastrukturanforderungen ab. Das AI Gateway zentralisiert Modellzugriff, Routing, Sicherheitsvorkehrungen, Kostenkontrolle und Observability. Die Plattform kann sowohl als SaaS als auch in privaten Unternehmensumgebungen betrieben werden.
TrueFoundry unterstützt zudem Anbieter wie OpenAI, Anthropic, Google sowie selbst gehostete Modelle über eine einheitliche Schnittstelle. Teams können Latenz, Kosten, Fehler und anfragebasierte Analysen über den gesamten produktiven Datenverkehr hinweg nachverfolgen. Richtlinien können benutzerdefinierte Metadaten für die Zuordnung zu Teams, Kunden, Projekten oder Umgebungen nutzen.
Mit zunehmender Arbeitslast werden drei Kontrollmechanismen wichtig:
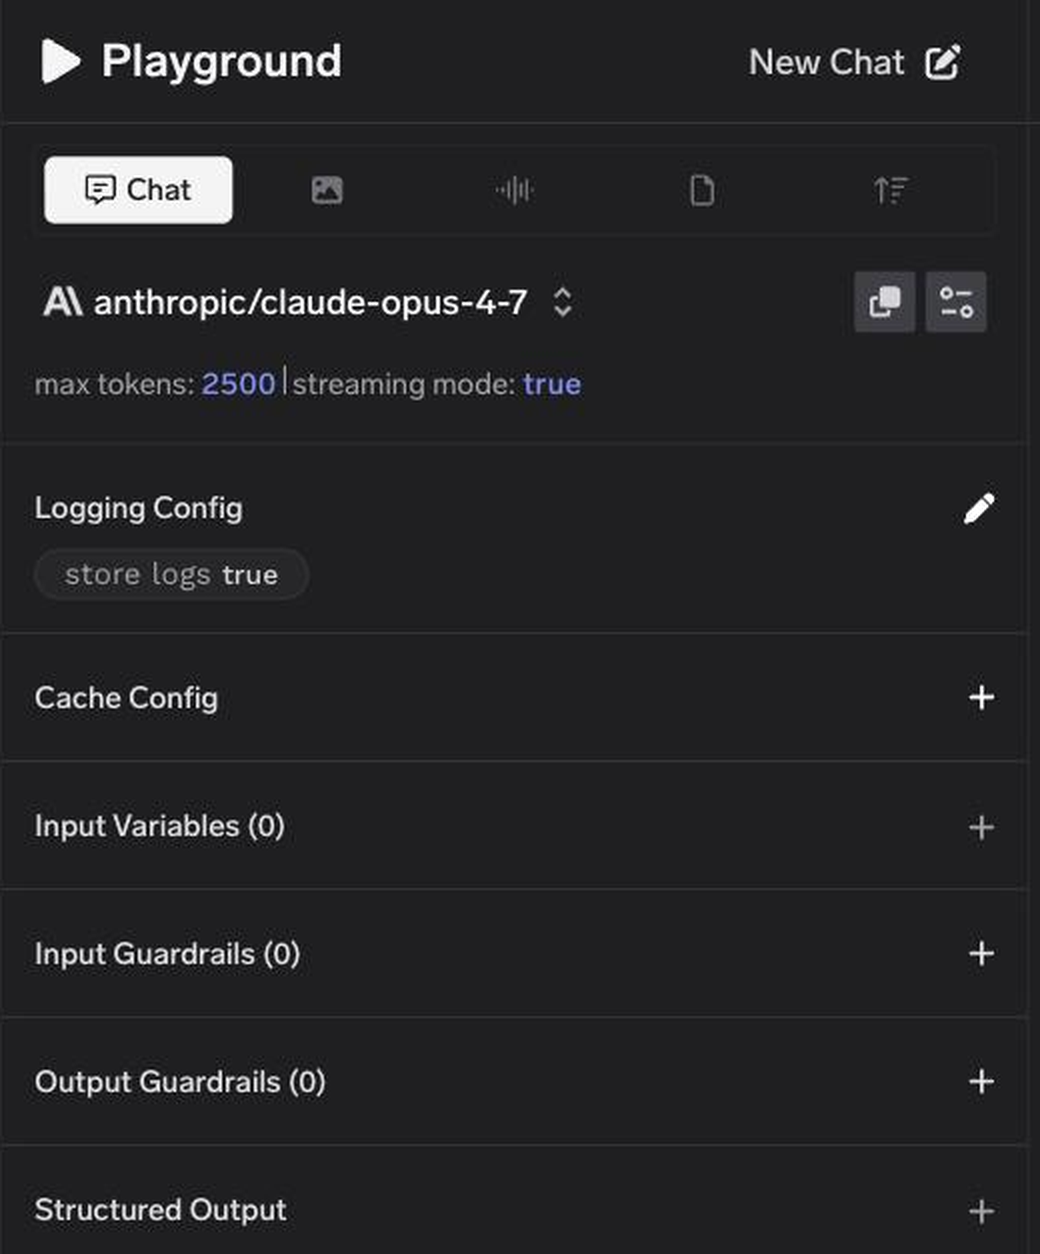
Die TrueFoundry-Gateway-Konsole zeigt die Steuerelemente für einen einzelnen Modellaufruf: Logging aktiviert, mit Cache, Eingabe- und Ausgabeschutz sowie Slots für strukturierte Ausgaben in derselben Anfrage.
Alternativtext: TrueFoundry AI Gateway Steuerelemente pro Aufruf für Logging, Caching und Guardrails
TrueFoundry verwendet zudem eine OpenAI-kompatible Schnittstelle, sodass für die Einführung kein neues SDK erforderlich ist. Bestehende Anwendungen können ihre URLs auf das Gateway umleiten und dabei die gewohnten Anfrageformate beibehalten. Der gewählte Endpunkt kann TrueFoundry SaaS oder eine private Unternehmensumgebung repräsentieren.
from openai import OpenAI
client = OpenAI(
api_key="your_truefoundry_api_key",
base_url="https://gateway.truefoundry.ai", # oder Ihr eigener VPC-Endpunkt
)
Kostenkontrollen greifen direkt im Anfragepfad. Teams können kosten- oder tokenbasierte Kontingente pro Benutzer, Dienst, Modell oder Workflow festlegen. Das Gateway kann Aktivitäten dann gemäß den Richtlinien drosseln, herabstufen oder blockieren.
Diese Struktur ist besonders nützlich, wenn der Anwendungscode unabhängig von der Anbieterlogik bleiben soll. Zudem sorgt sie für konsistentes automatisches Failover, Routing und Budgetmanagement über alle Workloads hinweg, anstatt jede Regel einzeln implementieren zu müssen.

Abbildung 3: Die Bereitstellungsumgebung und der Governance-Umfang sind hier ausschlaggebend, nicht der Aufschlag.
Requesty ist eine gute Lösung für den verwalteten Zugriff auf mehrere Anbieter. TrueFoundry richtet sich an Unternehmen, die ein Gateway, Modell-Traffic-Management, MCP-Tools und Agenten unter einer einheitlichen, kontrollierten Infrastrukturschicht benötigen.
Für Unternehmen, die die Gesamtkosten von Requesty AI mit ihren Governance-Anforderungen vergleichen, sind die Bereitstellungsumgebungen oft entscheidender als die reinen Modellgebühren.
Demo buchen bei TrueFoundry, um Ihre Anforderungen an Modell-Routing, Agenten-Governance, Bereitstellung und Kostenkontrolle zu evaluieren.
Requesty erhebt einen Aufschlag von 5 % auf die Kosten der zugrunde liegenden Modelle bei standardmäßiger nutzungsbasierter Abrechnung. Es gibt keine ausgewiesenen Gebühren pro Nutzer oder Mindestumsatzanforderungen. Der kostenlose Plan beinhaltet 200 Anfragen pro Tag. Requesty gibt derzeit an, dass für BYOK-Traffic (Bring Your Own Key) kein Aufschlag erhoben wird, während für Enterprise-Pläne individuelle Preise für erweiterte Kontrollfunktionen und Support gelten.
Der direkte Zugriff auf Anbieter vermeidet den 5-prozentigen Aufschlag von Requesty bei nutzungsbasierter Abrechnung. Die Gebühr deckt verwaltetes Routing, Fallbacks, Caching, Monitoring, Budgets und einen einheitlichen Modellzugriff ab. BYOK verändert den Vergleich, da Requesty laut aktueller Dokumentation keinen Aufschlag erhebt, wenn Kunden ihre eigenen Anbieterschlüssel verwenden. Der technische Aufwand und die betrieblichen Anforderungen sollten daher neben den reinen Token-Preisen ebenfalls berücksichtigt werden.
Die Wahl des Modells führt meist zu den größten Unterschieden, da die Preise für Ein- und Ausgaben erheblich variieren. Auch die Ausgabelänge, Wiederholungsversuche, die Routenwahl und die Cache-Performance beeinflussen die Gesamtkosten. Enterprise-Anforderungen können zu individuellen Preisen für SSO, RBAC, Audit-Logs, Guardrails und Support führen. BYOK kann die Wirtschaftlichkeit für Unternehmen, die bereits ausgehandelte Verträge mit Anbietern haben, weiter verändern.
Requesty bietet Enterprise-SSO, RBAC, Audit-Logs, Modellrichtlinien, Ausgabenkontrollen, Guardrails und Datenspeicherung in der EU. Die Plattform ist vollständig verwaltet und unterstützt derzeit kein Self-Hosting. Der SOC 2 Type II-Prozess ist laut Angaben in Arbeit. Unternehmen sollten daher die Kontrollfunktionen mit ihren internen Anforderungen an Bereitstellung, Datenresidenz und Compliance abgleichen.
TrueFoundry ist eine starke Alternative, wenn Unternehmen neben SaaS auch Optionen für VPC-, On-Premise- oder Air-Gapped-Bereitstellungen benötigen. Das AI Gateway steuert den Modellzugriff, das Routing, Budgets und Guardrails. MCP- und Agent-Gateways erweitern diese Kontrollen auf Unternehmens-Tools und autonome Workflows. Dieser umfassendere Ansatz eignet sich für Teams, deren Infrastrukturanforderungen über das reine gehostete Modell-Routing hinausgehen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet