November 2, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Dasselbe MCP-Release vom 28.07.2026 , das das Protokoll zustandslos machte, erhob auch zwei Erweiterungen in den Status erstklassiger Funktionen: MCP-Apps, mit denen ein Tool eine interaktive, in einem isolierten Iframe gerenderte Benutzeroberfläche zurückgeben kann, und Tasks, die lang laufende Arbeiten als dauerhafte Zustandsmaschine modellieren, die der Client über tasks/get, tasks/update und tasks/cancel steuert. Sie sind äußerst nützlich – stellen aber auch völlig neue Angriffsflächen für Governance und Sicherheit dar. Dieser Beitrag erläutert ihre Funktionsweise, wo die neuen Risiken liegen und warum das Gateway der ideale Ort für ihre Verwaltung ist.
Hana, eine Produktentwicklerin, veröffentlichte ein MCP-Tool zur „Erstellung von Quartalsberichten“ und nutzte beide neuen Erweiterungen, um es benutzerfreundlicher zu gestalten. Sie gab eine MCP-App zurück – eine interaktive Vorschau, die der Benutzer in einem isolierten Bereich anpassen konnte – und da die Erstellung einige Minuten dauerte, modellierte sie den Prozess als Task, damit der Aufruf nicht blockierte. Die Demo war ein Erfolg. Die Probleme traten erst in der Woche darauf auf. Die gerenderte Vorschau der App enthielt einen Anbieternamen, der direkt aus einem nicht vertrauenswürdigen Datensatz stammte. Ein Teamkollege wies darauf hin, dass niemand prüfte, was in dieser Oberfläche gerendert wurde – also genau der Inhalt, den das Modell später wieder auslesen würde. Zudem lief ein Berichts-Task achtzehn Minuten lang, verbrauchte im Hintergrund Tokens, ohne dass Fortschritt oder Kosten sichtbar waren, bis er schließlich ein Ergebnis lieferte.
Beides waren keine Fehler in Hanas Code. Es waren die neuen Oberflächen, die genau das taten, was die Spezifikation erlaubt, in einem System, das zwar Governance für Tool-Aufrufe bot, aber nicht für gerenderte UIs oder lang laufende Tasks. Das Release vom 28.07.2026 vereinfachte nicht nur den Transport; es fügte zwei Bereiche hinzu, in denen nun Wert – und Risiko – entstehen. Dieser Beitrag zeigt, wie man diese Funktionen nutzt, ohne Hanas Erfahrungen teilen zu müssen.
Das Release hat die Erweiterungen zu einem echten Framework umstrukturiert: Jede Erweiterung erhält eine Reverse-DNS-Kennung, ein eigenes Repository mit Betreuern sowie eine Versionsnummer, die sich unabhängig von der Kernspezifikation entwickelt. Clients und Server verhandeln die Unterstützung über eine Erweiterungs-Map in ihren Capabilities – ein Server gibt an, dass er MCP-Apps oder eine bestimmte Task-Version unterstützt, der Client tut dasselbe, und bei Übereinstimmung wird die Funktion genutzt; andernfalls funktioniert die Verbindung auch ohne sie. MCP-Apps und -Tasks sind die ersten beiden Beispiele für diese erstklassigen Funktionen.
Wichtig ist, dass keines von beiden das Tool-Prinzip ersetzt. Ein Tool nimmt weiterhin JSON-Argumente entgegen und liefert JSON-Ergebnisse zurück. Eine App fügt einem Tool eine optionale gerenderte Oberfläche hinzu; ein Task ändert die Art und Weise, wie das Ergebnis eines Tool-Aufrufs bei lang laufenden Prozessen übermittelt wird. Deshalb sind sie am besten als Erweiterungen zu verstehen – und deshalb muss die Governance, die Sie bereits für Tools anwenden, auf diese Funktionen ausgeweitet werden, anstatt sie zu ersetzen.
Eine MCP-App ermöglicht es einem Tool, eine interaktive UI-Ressource zurückzugeben, die der Host in einem isolierten Iframe rendert. Die Analogie aus der Diskussion zur Spezifikation ist treffend: Sie erweitert ein Tool so, wie ein gehostetes Dashboard eine API erweitert. Der JSON-Vertrag des Tools bleibt unverändert; die App ist die interaktive Hülle, die der Host dem Benutzer anzeigen kann. Für Hanas Bericht-Tool ist die App das Vorschaufenster.
Die Funktion wird ausgehandelt, nicht vorausgesetzt. Ein Server deklariert die App-Erweiterung in seinen Capabilities, und ein Host, der keine Apps unterstützt, erhält einfach das JSON-Ergebnis und rendert nichts zusätzlich. Dieses „Graceful Degradation“-Prinzip ist gutes Design – bedeutet aber auch, dass die App-Oberfläche optional ist und leicht implementiert werden kann, ohne die Konsequenzen zu durchdenken, was das Thema des nächsten Abschnitts ist.
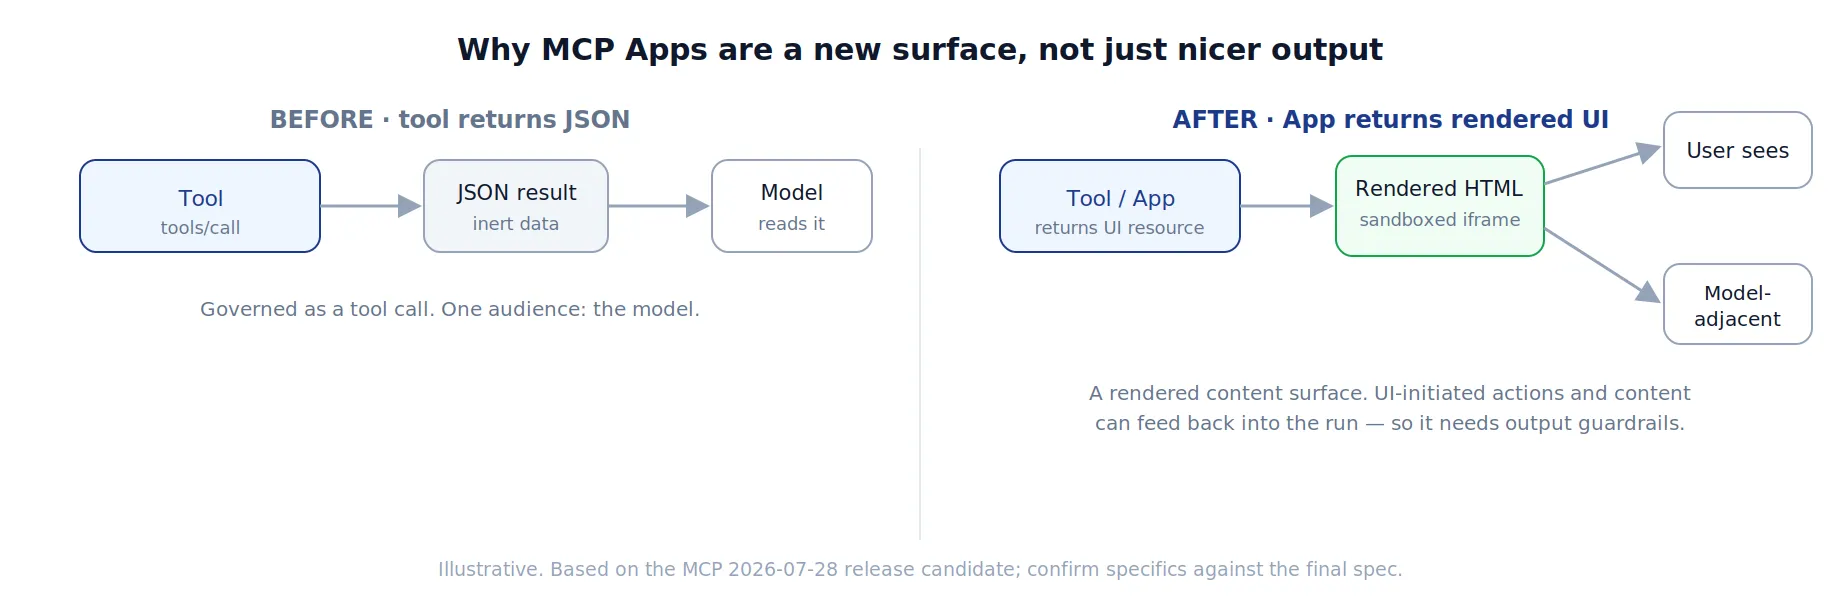
Das neue Risiko bei einer App besteht darin, dass ihr gerenderter Inhalt zwei Zielgruppen hat. Der Benutzer sieht ihn, daher ist jeder nicht vertrauenswürdige Inhalt, der im Panel gerendert wird, ein Sicherheitsanliegen für den Client – der isolierte Iframe begrenzt den Schadensradius, was genau der Grund ist, warum der Host ihn isoliert rendert. Aber „isoliert“ begrenzt nur, was das Markup dem Host antun kann, nicht was das Inhalt können. Abhängig vom Verhalten des Hosts können der Inhalt der App, die zugrunde liegenden Daten oder durch die Benutzeroberfläche ausgelöste Aktionen in den Modellkontext zurückfließen. Daher ist nicht vertrauenswürdiger Text, der in einer App gerendert wird, ein weiterer Pfad für die indirekte Prompt-Injection, die wir in unserem Beitrag zu Prompt-Injection: Anweisungen, die in ein Feld eingeschleust werden und schließlich vor dem Modell landen.
Die praktische Vorgehensweise besteht darin, App-Inhalte als nicht vertrauenswürdige Ausgabe zu behandeln, die dieselbe Überprüfung erfordert wie jeder andere modellnahe Inhalt: Scannen und bereinigen Sie, was gerendert wird, interpolieren Sie niemals rohe, nicht vertrauenswürdige Daten ohne Maskierung in die Oberfläche und halten Sie die Sandbox der App strikt. Das Feld „vendor-name“ von Hana ist der klassische Fehler – nicht vertrauenswürdige Daten, die in eine gerenderte Oberfläche interpoliert werden, die sowohl vom Benutzer als auch vom Modell konsumiert wird, ohne dass dazwischen eine Schutzmaßnahme besteht.
Aufgaben waren im Core vom 25.11.2025 experimentell; die Version vom 28.07.2026 überführt sie in eine offizielle Erweiterung mit einem Lebenszyklus, der für die zustandslose Welt konzipiert ist. Das Modell ist anforderungsgesteuert: Ein Server kann einen tools/call mit einem Aufgaben-Handle anstelle eines sofortigen Ergebnisses beantworten, und der Client steuert dann die Arbeit mit tasks/get, tasks/update und tasks/cancel. (Die frühere experimentelle Oberfläche vom 25.11.2025 enthielt auch tasks/list und tasks/result; der Release Candidate gestaltet den Lebenszyklus um get/update/cancel herum neu und entfernt tasks/list, das nicht sicher begrenzt werden kann, sobald das Protokoll zustandslos ist. Betrachten Sie den genauen Methodensatz als RC-spezifisch und bestätigen Sie die Ergebnislieferung anhand der endgültigen Spezifikation.) Eine Aufgabe ist im Grunde eine kleine, dauerhafte Zustandsmaschine plus ein Zeiger auf ihr Ergebnis.
Die Unterstützung wird granular ausgehandelt – ein Peer sagt nicht einfach „Ich unterstütze Aufgaben“, sondern gibt an, welche Anfragen mit Aufgaben erweitert werden können. Die Capabilities-Map ist diesbezüglich explizit:
Aushandlung von Aufgaben im RC vom 28.07.2026 – illustrativ; bestätigen Sie die genaue Erweiterungs-ID und das Schema anhand der endgültigen Spezifikation
{
  "capabilities": {
    "extensions": {
      "io.modelcontextprotocol.tasks": {   // reverse-DNS extension identifier
        "requests": {
          "tools": { "call": {} }          // only tools/call may be task-augmented here
        }
      }
    }
  }
}
Die obige Form veranschaulicht das Erweiterungs-Framework des RC, nicht ein wortgetreues Schema. Die frühere Form capabilities.tasks mit tasks/list gehörte zum experimentellen Tasks-API; der RC verschiebt die Aushandlung in eine über Reverse-DNS identifizierte Erweiterungs-Map. Bestätigen Sie den endgültigen Bezeichner und die Felder anhand der Spezifikation vom 28. Juli, bevor Sie mit der Implementierung beginnen.
Alles, was nicht unter Anfragen aufgeführt ist, bleibt synchron; ein Client darf nicht versuchen, eine Anfrage mit Aufgaben zu erweitern, die der Server nicht angekündigt hat. Dies ist der saubere, MCP-native Weg, um Nebenläufigkeit zu erreichen, ohne Seitenkanäle zu erfinden – und er lässt sich mit dem zustandslosen Core kombinieren, da das Aufgaben-Handle ein expliziter, vom Server erstellter Bezeichner ist, den der Client zurückgibt. Dies entspricht genau dem Muster des expliziten Zustands, das das zustandslose Modell fördert.
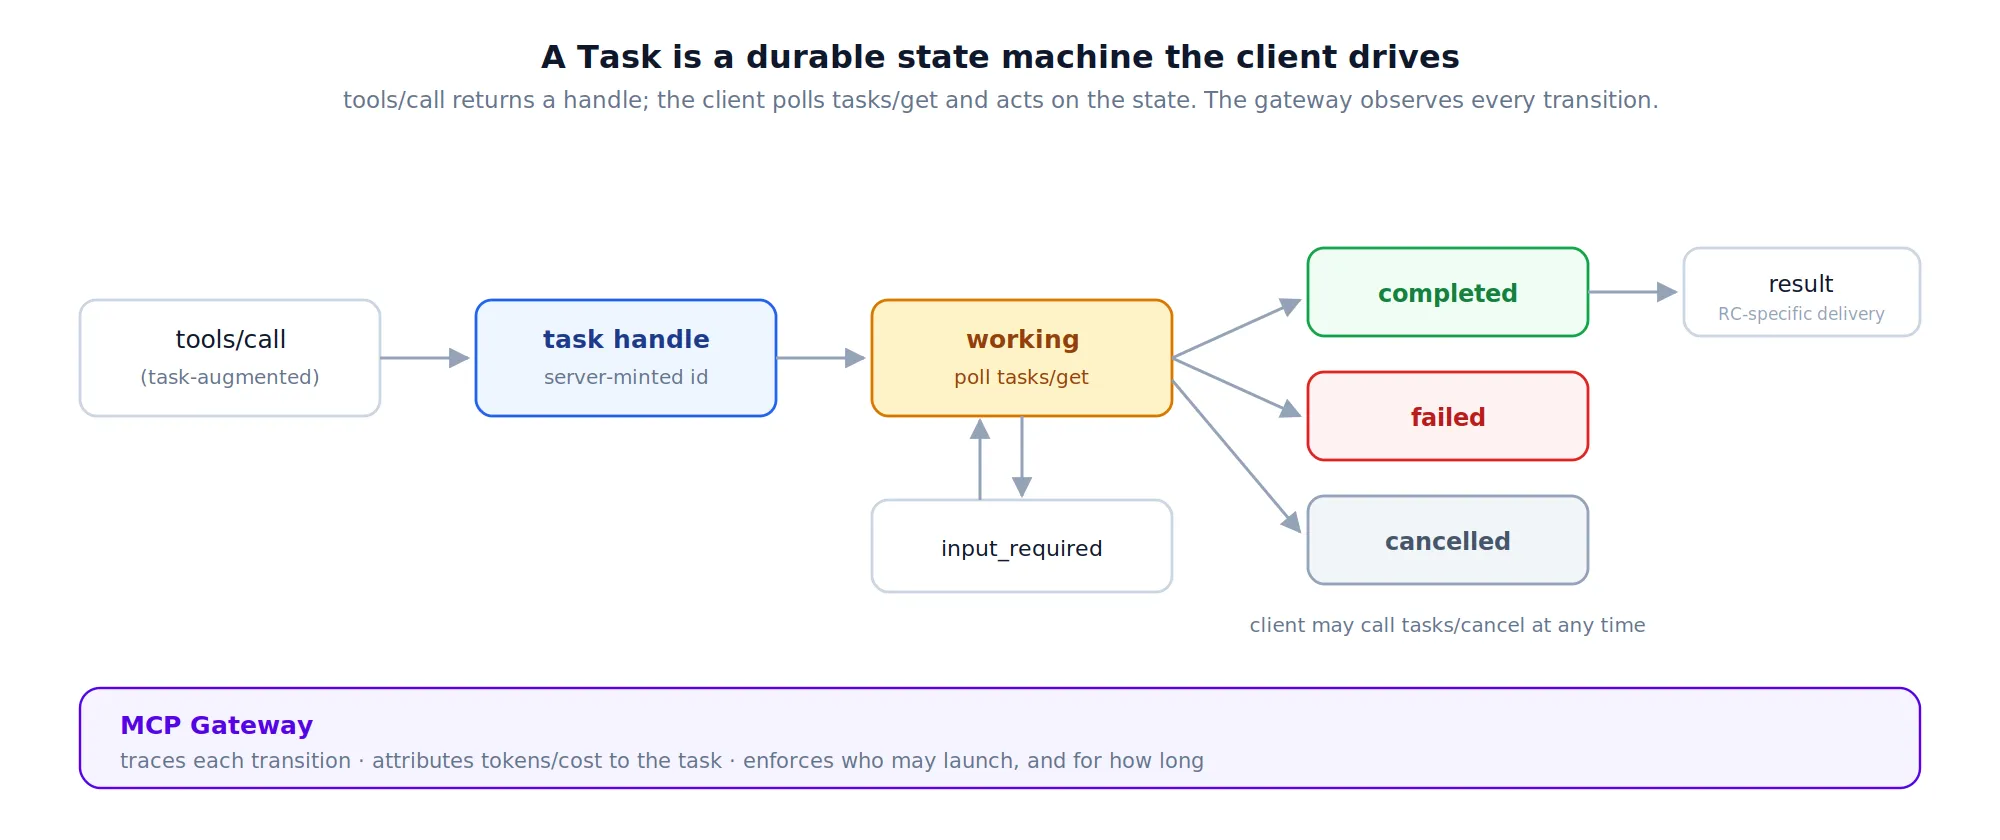
Hanas achtzehnminütiger toter Winkel ist das operative Herzstück von Aufgaben. Eine lang laufende Aufgabe, die erst nach Abschluss ein Ergebnis liefert, ist eine Blackbox: Man kann keinen Fortschritt anzeigen, keine anfallenden Kosten sehen und nicht zwischen einer hängenden und einer langsamen Aufgabe unterscheiden. Der Lebenszyklus bietet Ihnen die notwendigen Hooks – der Client pollt den Status und kann Fortschritte sowie Zwischenaktualisierungen anzeigen –, aber jemand muss diese Übergänge aufzeichnen, die während der Laufzeit verbrauchten Token summieren und dies offenlegen.
Steuerung einer Aufgabe bis zum Abschluss mit Sichtbarkeit bei jedem Schritt (illustrative Client-Schleife)
resp = call_tool("generate_report", args, task_augmented=True)
task_id = resp.task_id                       # server-minted handle

while True:
    state = tasks_get(task_id)                # poll; gateway records each transition
    emit_progress(task_id, state.status, state.progress, state.tokens_so_far)
    if state.status == "input_required":
        tasks_update(task_id, provide_input())
    elif state.status in ("completed", "failed", "cancelled"):
        break
    sleep(backoff())                          # respect the server's polling guidance

result = state.result if state.status == "completed" else None  # final result shape is RC-specific
Dies ist dieselbe Geschichte der Beobachtbarkeit wie im Rest der Serie, angewendet auf ein neues Objekt. Das Tracing , das eine normale Anfrage erfasst, sollte eine Aufgabe als einen Span behandeln, der über den gesamten Lebenszyklus hinweg offen bleibt, wobei die Token- und Kostenabrechnung diesem zugeordnet wird. TrueFoundrys MCP-Gateway erfasst bereits jeden MCP-Serveraufruf und ordnet die Nutzung nach Benutzer, Tool und Team zu; eine Task ist genau diese Telemetrie, die über die Zeit hinweg erweitert statt nur in einem einzigen Moment erfasst wird – und genau das ist das fehlende Puzzleteil in Hanas Berichtstool.
Das Protokoll legt fest, wie Apps und Tasks funktionieren; wer sie unter welchen Einschränkungen nutzen darf, überlässt es bewusst Ihnen. Das ist eine Governance-Lücke mit konkreten Fragen. Welche Agenten oder Benutzer dürfen überhaupt eine lang laufende Task starten? Wie hoch sind das Timeout und das Token-Budget, bevor eine Task zwangsweise abgebrochen wird – damit eine achtzehnminütige Laufzeit eine bewusste Richtlinienentscheidung und kein Versehen ist? Welche Tools dürfen eine App zurückgeben und welche Inhalte dürfen darin gerendert werden?
Beispielhafte Gateway-Richtlinie für die neuen Oberflächen (das Schema ist Gateway-spezifisch)
tasks:
  allow_launch:
    roles: ["agent:report-writer", "team:finance"]   # default-deny otherwise
  limits:
    max_runtime_seconds: 300                           # force-cancel past this
    max_tokens: 200000                                 # budget ceiling per task
  observability: trace_lifecycle                       # record every state transition

apps:
  output_guardrails: [pii, injection, toxicity]        # scan rendered content
  sandbox: strict                                      # host renders in a locked-down iframe
Nichts davon ist exotisch; es ist dieselbe rollenbasierte Zugriffs-, Budget- und Guardrail-Maschinerie, die bereits auf Modell- und Tool-Aufrufe angewendet wird, nur erweitert auf zwei neue Objekte. Der Grund für die Zentralisierung ist, dass Apps und Tasks von vielen Agenten über viele Server hinweg genutzt werden. Eine Implementierung pro Server oder pro App führt dazu, dass die achtzehnminütige Task oder das ungeprüfte Panel durch das Raster fallen. Ein zentraler Richtlinienpunkt macht aus der Frage „Wer darf eine Task starten, wie lange und was darf in einer App gerendert werden?“ eine einzige Antwort statt vieler.
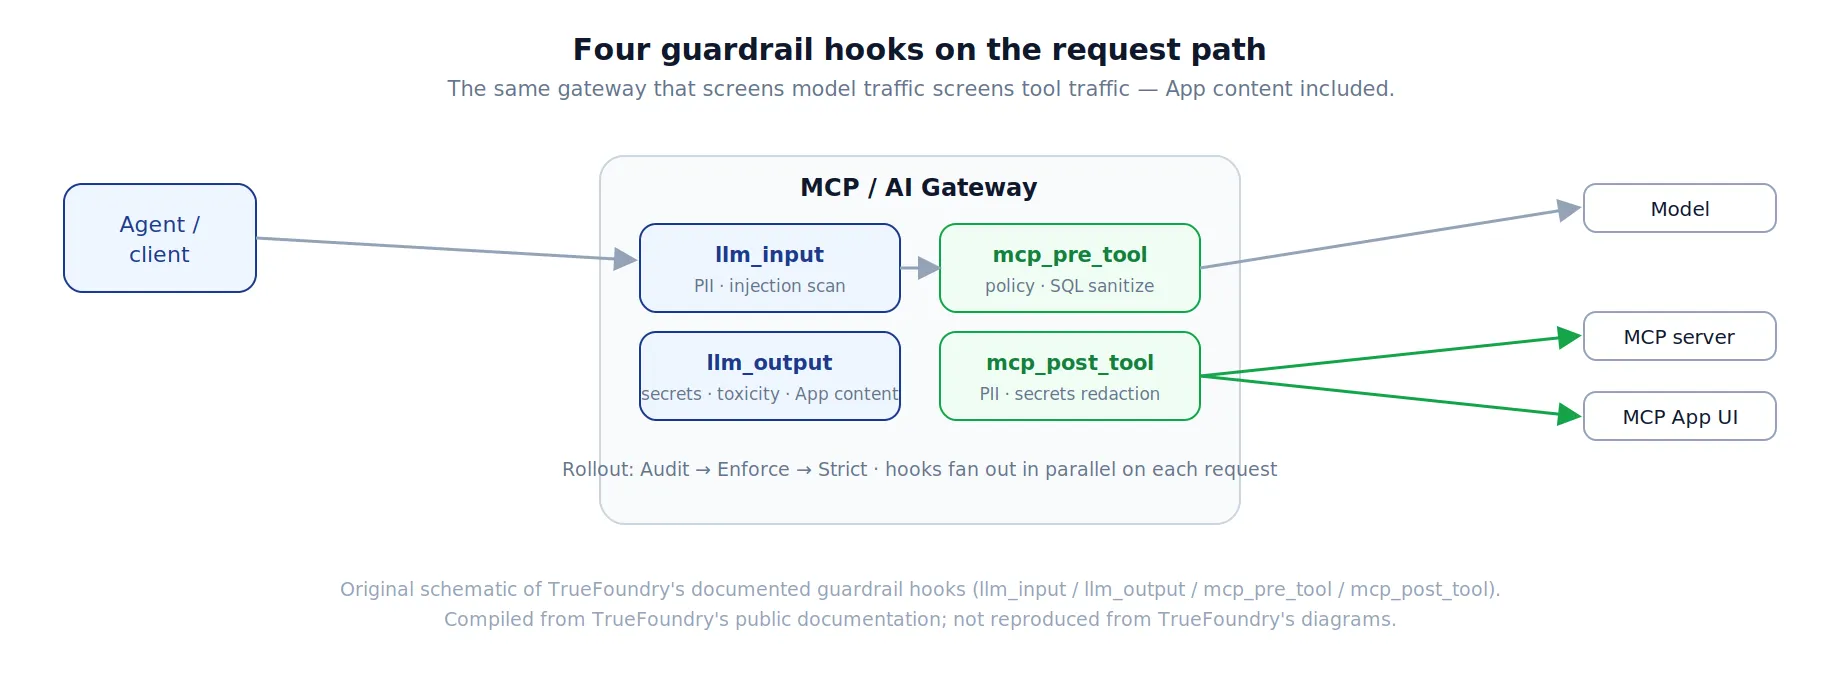
Bei Guardrails wird es konkret, da das Gateway Inhalte bereits über eine dokumentierte Reihe von Hooks prüft. Das Gateway von TrueFoundry bietet vier davon – llm_input und llm_output für den Modellverkehr sowie mcp_pre_tool und mcp_post_tool für den Tool-Verkehr – an die eine beliebige Anzahl von Validatoren (PII-Erkennung, Secrets-Scanning, Prompt-Injection- und Toxizitätsklassifikatoren, SQL-Sanitizer, Richtlinienprüfungen via Cedar oder OPA) angebunden werden kann. Sie laufen parallel bei derselben Anfrage ab, sodass ein Input-Guardrail gleichzeitig mit dem Modellaufruf ausgeführt wird und diesen stoppen kann, bevor Tokens berechnet werden, falls er blockiert. Die operative Disziplin, die dies in der Produktion sicher hält, ist ein gestaffelter Rollout – Audit (Verstöße protokollieren, Verkehr durchlassen), dann Enforce (bei Fehlern blockieren, bei Anbieterfehlern offen lassen), dann Strict –, damit ein Ausfall des Guardrail-Anbieters nicht am ersten Tag den gesamten Pfad lahmlegt.
Wenn Sie die experimentelle Tasks-API aus dem Core vom 25.11.2025 übernommen haben, ist der Wechsel zur Erweiterung eine echte Migration, keine bloße Umbenennung. Der Lebenszyklus und die Methoden sind nun um tasks/get, tasks/update und tasks/cancel herum organisiert, und die Aushandlung der Fähigkeiten ist jetzt explizit und granular. Die gute Nachricht: Die mit diesem Release eingeführte Deprecation-Richtlinie garantiert eine Überschneidungszeit von mindestens zwölf Monaten zwischen der Ankündigung und der tatsächlichen Entfernung von Funktionen. So funktioniert die alte Oberfläche weiter, während Sie migrieren, anstatt zu einem bestimmten Datum einfach auszufallen.
Der risikoarme Weg ist der, den die zustandslose Migration ohnehin fördert: Schreiben Sie Tools, die explizite Handles erstellen und erfordern, handeln Sie die Tasks-Erweiterung aktiv aus, anstatt sie vorauszusetzen, und betrachten Sie den Release Candidate als vorläufig – er wurde am 21. Mai 2026 eingefroren und wird voraussichtlich am 28. Juli finalisiert, wobei sich der Spezifikationstext im Validierungsfenster noch ändern kann. Ein Gateway, das während der Übergangsphase sowohl die experimentelle als auch die erweiterte Form beherrscht, ist hier äußerst nützlich, genau wie es Sie beim Übergang zum zustandslosen Transport absichert.
Apps und Tasks verstärken ein Muster, auf das diese Serie immer wieder zurückkommt: Das Protokoll definiert den Mechanismus, und das Gateway liefert die Governance, die das Protokoll offen lässt. Das MCP-Gateway sitzt bereits vor jedem registrierten MCP-Server als zentraler Punkt für Discovery, Authentifizierung, RBAC und Request-Tracing – genau die richtige Ebene, um App-Inhalte zu prüfen und Task-Lebenszyklen zu überwachen und zu begrenzen.

Konkret bedeutet das, dass von Apps gerenderte Inhalte durch dieselben Output-Guardrails fließen wie jeder andere modellnahe Output, und eine Task als langlebiger Span nachverfolgt wird, dessen Tokens und Kosten dem startenden Agenten zugeordnet werden – unter Verwendung der Discovery, RBAC und Observability, die das MCP Gateway bereits bereitstellt, anstatt ein zweites Governance-System auf jeden Server aufzusetzen. Die Arbeitsteilung ist die gewohnte: Der Server implementiert die App oder Task; das Gateway steuert, wer sie nutzen darf, was sie rendern darf, wie lange sie laufen darf und was sie kostet.
Sind MCP-Apps nur eine Möglichkeit, HTML zurückzugeben?
Genauer gesagt erweitert eine App ein Tool um eine interaktive UI-Ressource, die der Host in einem isolierten Iframe rendert – das Tool nimmt weiterhin JSON entgegen und gibt es zurück, und die App ist die optionale Hülle darüber. Für die Governance ist das deshalb wichtig, weil die gerenderten Inhalte generiert werden, oft aus nicht vertrauenswürdigen Eingaben, und durch das Verhalten des Hosts, Tool-Outputs oder UI-initiierte Aktionen in den Modellkontext zurückfließen können. Das macht sie zu einem Fall für Output-Guardrails, anstatt sie als bloße, inerte Präsentation zu behandeln.
Macht das zustandslose Protokoll Tasks überflüssig?
Nein – sie lösen unterschiedliche Probleme. Stateless Transport bedeutet, dass kein Request an eine bestimmte Instanz gebunden ist; Tasks modellieren Arbeitsschritte, die länger dauern als ein einzelner Request-Response-Zyklus, unabhängig davon, welche Instanz die jeweilige Abfrage bedient. Tatsächlich ist das Task-Handle genau das Muster für expliziten Status, das das zustandslose Modell fördert: ein vom Server erstellter Bezeichner, den der Client weiterreicht, sodass jede Instanz den Status der Aufgabe abrufen kann.
Was ist das größte neue Risiko, das es zu berücksichtigen gilt?
Zwei Punkte. Erstens: Bei Apps muss nicht vertrauenswürdiger Inhalt, der auf der Oberfläche gerendert wird, wie eine Ausgabe behandelt werden, die auf Injektionen und personenbezogene Daten (PII) geprüft werden muss – nicht als harmloses Markup. Zweitens: Bei Tasks muss unbegrenzte, lang laufende Arbeit kontrolliert werden – setzen Sie ein Timeout und ein Token-Budget, damit eine außer Kontrolle geratene Aufgabe per Richtlinie zwangsweise abgebrochen wird, und verfolgen Sie den Lebenszyklus, damit dieser kein „Black Box“-Prozess bleibt. Beides sind Governance-Maßnahmen, die Sie um die Spezifikation herum aufbauen, nicht Verhaltensweisen, die die Spezifikation selbst vorgibt.
Muss ich jetzt migrieren?
Planen Sie jetzt; der Release Candidate wurde am 21. Mai 2026 eingefroren und wird voraussichtlich am 28. Juli finalisiert. Falls Sie die experimentelle Tasks-API verwendet haben, wird es Breaking Changes geben. Die zwölfmonatige Übergangsfrist bedeutet, dass zum Stichtag nichts sofort ausfällt, aber neue Projekte sollten auf den Erweiterungs-Lebenszyklus ausgerichtet sein und Funktionen explizit aushandeln. Betrachten Sie den RC bis zur Ratifizierung als vorläufig.
App- oder Task-Governance – Gateway oder Anwendung?
Das Gateway ist für die übergreifenden Kontrollen zuständig: Welche Agenten dürfen Apps und Tasks starten, wie hoch sind die Timeouts und Budgetobergrenzen, welche Sicherheitsfilter gelten für gerenderte Inhalte und wie sieht das Lebenszyklus-Tracing aus – alles einheitlich angewendet auf jeden MCP-Server. Die Anwendung selbst behält die Hoheit über die Domänenlogik, also was die App anzeigt und was die Aufgabe bewirkt, da dies Wissen erfordert, über das das Gateway nicht verfügt.
Das Release vom 28. Juli 2026 wird vor allem für den Wechsel zur Zustandslosigkeit in Erinnerung bleiben, aber Apps und Tasks sind der Teil, der die Art und Weise, wie Sie entwickeln, grundlegend verändert. Sie fügen eine gerenderte und eine lang laufende Oberfläche hinzu, wobei die Spezifikation Ihnen den Mechanismus an die Hand gibt, die Governance jedoch offen lässt. Schließen Sie diese Lücke am Gateway – filtern Sie, was gerendert wird, begrenzen Sie, was ausgeführt wird, und verfolgen Sie beides –, dann wird aus Hanas guter Demo ein produktionsreifes System.
Wenn das Gateway der Ort ist, an dem Sie diese Oberflächen steuern, ist es hilfreich, dass dieselbe Steuerungsebene auch der Ort ist, an dem die Agenten laufen, die sie nutzen. TrueFoundrys AI Gateway ist der einheitliche Einstiegspunkt für Modell-, MCP- und Tool-Traffic, und sein Agent Harness ist die Laufzeitumgebung, die die Plan-Act-Observe-Schleife eines Agenten orchestriert, sowie Sandboxing, Genehmigungen und Tracing darüber hinaus – sodass die App-Inhalte, die ein Agent rendert, und die Tasks, die er startet, von derselben Ebene geprüft, begrenzt und nachverfolgt werden, die auch den Agenten ausführt, anstatt durch eine nachträglich aufgesetzte Governance-Schicht.
Northwind und Hana dienen der Veranschaulichung. Die Details zu MCP Apps und Tasks basieren auf den offiziellen Materialien zum Model Context Protocol Release Candidate vom 28. Juli 2026 und zugehörigen Berichten vom späten Mai 2026; der RC wurde am 21. Mai eingefroren und wird voraussichtlich am 28. Juli 2026 ratifiziert. Da sich der Text der Spezifikation noch ändern kann, sollten Protokollspezifikationen – Methodennamen, Funktionsumfang und Lebenszyklus-Zustände – als vorläufig betrachtet und mit der finalen Spezifikation abgeglichen werden. Codebeispiele dienen der Veranschaulichung der dokumentierten Muster und sind nicht aus einer Referenzimplementierung kopiert. Die Funktionen von TrueFoundry sind aus der öffentlichen Produktdokumentation zusammengefasst und werden sich weiterentwickeln.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet