



October 13, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Viele Teams, die ihren dritten oder vierten produktiven Agenten veröffentlichen, bemerken dasselbe Muster: Ein Großteil des Codes in jeder Agenten-Datei besteht aus Infrastruktur, nicht aus Agenten-Logik. Retry-Wrapper, das Laden von Anmeldedaten, Tool-Registries, Sitzungsstatus, Sandboxing – alles kopiert und eingefügt aus dem vorherigen Agenten, mit leichten Abweichungen. Eine zunehmend verbreitete Lösung ist eine Managed Agent Layer, die diese Aufgaben zentral übernimmt, dem Agenten-Code eine schlanke API bereitstellt und die eigentliche Arbeit über die Gateways leitet, die die Plattform ohnehin betreibt. Dieser Beitrag definiert diese Schicht, erläutert ihre fünf Komponenten und zeigt, wie das AI-Gateway und das MCP-Gateway integriert werden – gipfelnd in der Veröffentlichung der Managed Agents von Anthropic im April 2026 als Beispiel für diese grundlegende Trennung.
Mittwoch bei Northwind. Devi, Senior Engineer im Plattform-Team, öffnet den PR für den vierten Agenten, den ihr Team in diesem Quartal veröffentlicht – einen Release-Notes-Generator, der mit dem Deploy-Bot verbunden ist. Der Diff umfasst 312 Zeilen. Sie weiß aus Erfahrung, dass vielleicht 30 dieser Zeilen die eigentliche Reasoning-Schleife des Agenten sind. Die restlichen ca. 280 Zeilen sind dieselben fünf Dinge, die sie nun schon viermal geschrieben hat: eine Tool-Registry, die MCP-Server-Konfigurationen von zwei Orten lädt; eine Retry-Logik mit exponentiellem Backoff, die nicht ganz mit der Version des vorherigen Agenten übereinstimmt; das Laden von Anmeldedaten aus einer Mischung von Umgebungsvariablen und dem Secrets-Manager; Sitzungsstatus, der mit einer geschätzten TTL in Redis gespeichert wird; und eine Try/Except-Kaskade, die zwischen Ratenbegrenzungen, Authentifizierungsfehlern und Provider-Ausfällen unterscheidet.
Bei vier Agenten in Produktion sind das etwa 1.120 Zeilen Infrastruktur-Code, die über das Team verteilt sind, wobei jede Kopie leicht abweicht. Wenn sich die Ratenbegrenzungsrichtlinie des Providers nächsten Monat ändert, sind vier PRs erforderlich, um dies zu beheben. Wenn sich das Verfahren zur Rotation von Anmeldedaten ändert, sind es vier weitere. Die Agenten-Logik selbst – der Teil, der entscheidet, welches Tool wann aufgerufen wird – ist der kleinste und am wenigsten angefasste Teil jeder Datei. Die Infrastruktur drumherum ist das, was die Zeit der Ingenieure frisst.
Die Lösung ist nicht eine bessere Disziplin beim Kopieren und Einfügen. Das Muster, für das dieser Beitrag plädiert, ist eine Schicht zwischen Agenten-Code und Runtime, die die Infrastruktur zentral verwaltet und den Agenten-Code zu dem macht, was er sein soll: Agenten-Logik. Es ist eine Architektur unter vielen – Workflow-Graphen und Durable-Execution-Engines sind valide Alternativen –, aber es ist diejenige, die sich in aktuellen, vom Provider verwalteten Agenten-Produkten am deutlichsten herauskristallisiert hat und in die die Gateway-Primitive von TrueFoundry direkt hineinpassen.
Hier ist eine gekürzte Darstellung der verstrickten Version eines von Devis Agenten. Die vollständige Datei umfasst etwa 200 Zeilen; das Folgende sind die ersten 35.
Python – naiver Agent, Infrastruktur vermischt mit Logik (gekürzt)
import os, time, random, json, yaml, redis
import anthropic, openai
from github import Github

class CodeReviewAgent:
    def __init__(self):
        # Credential loading — three different patterns across our four agents
        self.anthropic_key = os.environ.get("ANTHROPIC_API_KEY") \
            or self._load_from_vault("anthropic")
        self.openai_key = os.environ.get("OPENAI_API_KEY") \
            or self._load_from_vault("openai")
        self.github_token = self._load_from_vault("github-pat")  # different vault path

        # Tool registry — drifted from review-agent-v2's version
        with open("mcp_servers.yaml") as f:
            self.tools = self._build_tool_registry(yaml.safe_load(f))

        # State store — TTL was 30min in v2, 1h here, nobody remembers why
        self.redis = redis.Redis.from_url(os.environ["REDIS_URL"])
        self.session_ttl = 3600

        self.anthropic = anthropic.Anthropic(api_key=self.anthropic_key)

    def run(self, pr_id):
        # Retry loop — slightly different in every agent file we own
        for attempt in range(5):
            try:
                response = self.anthropic.messages.create(...)
                break
            except anthropic.RateLimitError:
                time.sleep(2 ** attempt + random.random())
            except anthropic.APIStatusError as e:
                if e.status_code >= 500:
                    time.sleep(2 ** attempt + random.random())
                else:
                    raise
        # ... 170 more lines like this. The actual reasoning loop starts around line 130.
Nichts davon ist der Agent. Es ist das Substrat, auf dem der Agent läuft. Und jeder Agent, den das Team veröffentlicht, hat seine eigene, leicht abweichende Kopie davon, weil es keine Schicht gibt, die dies zentral verwaltet.
Die Managed Agent Layer ist die Abstraktion, die das Substrat besitzt. Sie stellt dem Agenten-Code drei schlanke APIs zur Verfügung und sonst nichts:
Python – die API-Oberfläche, die die Managed Layer dem Agenten-Code bereitstellt
class ManagedAgent:
    # Tool invocation — routes through the MCP gateway, handles auth/RBAC/audit.
    # Credentials are fetched from the secret store and injected by the runtime
    # at call time; agent code references tools by logical name, never by token.
    async def call_tool(self, name: str, **args) -> dict: ...

    # Model inference — routes through the AI gateway, handles routing/guardrails/cost
    async def llm(self, messages: list, **opts) -> str: ...

    # Session state — keyed under the conversation ID, runtime owns persistence
    async def save_state(self, key: str, value: object) -> None: ...
    async def load_state(self, key: str) -> object | None: ...
Der Agenten-Code ist für drei Dinge verantwortlich, und nur für diese: das Ziel (was der Agent erreichen soll), die Reasoning-Schleife (wann welches Tool aufgerufen und wie Ergebnisse interpretiert werden) und das Ausgabeformat (was der Agent zurückgibt, wenn er fertig ist). Alles andere – Authentifizierung, Retries, Sandboxing, Status-Persistenz, Observability – gehört zur Runtime. Bemerkenswert ist, dass es keine get_credential-Methode gibt: Geheimnisse fließen nicht durch den Agenten-Code, auch nicht auf Anfrage.
Hier ist derselbe Code-Review-Agent auf der Managed Layer. Der PR ist jetzt kleiner als seine alte Testdatei:
Python – derselbe Agent auf der Managed Layer, reine Logik
from truefoundry.agent import ManagedAgent

class CodeReviewAgent(ManagedAgent):
    """Reviews a pull request against the repo's style guide."""

    async def run(self, pr_id: str):
        diff = await self.call_tool("github.get_pr_diff", pr_id=pr_id)
        review = await self.llm([
            {"role": "system", "content": REVIEW_PROMPT},
            {"role": "user", "content": diff},
        ])
        await self.call_tool("github.post_review", pr_id=pr_id, body=review)
        return {"status": "ok", "review_length": len(review)}
Keine Anmeldedaten. Keine Retry-Schleife. Kein Status-Code. Kein Provider-SDK. Die Infrastruktur, die früher in jeder Agenten-Datei lebte, existiert nun einmalig in der Runtime, wo sie unabhängig getestet, versioniert und bereitgestellt werden kann.
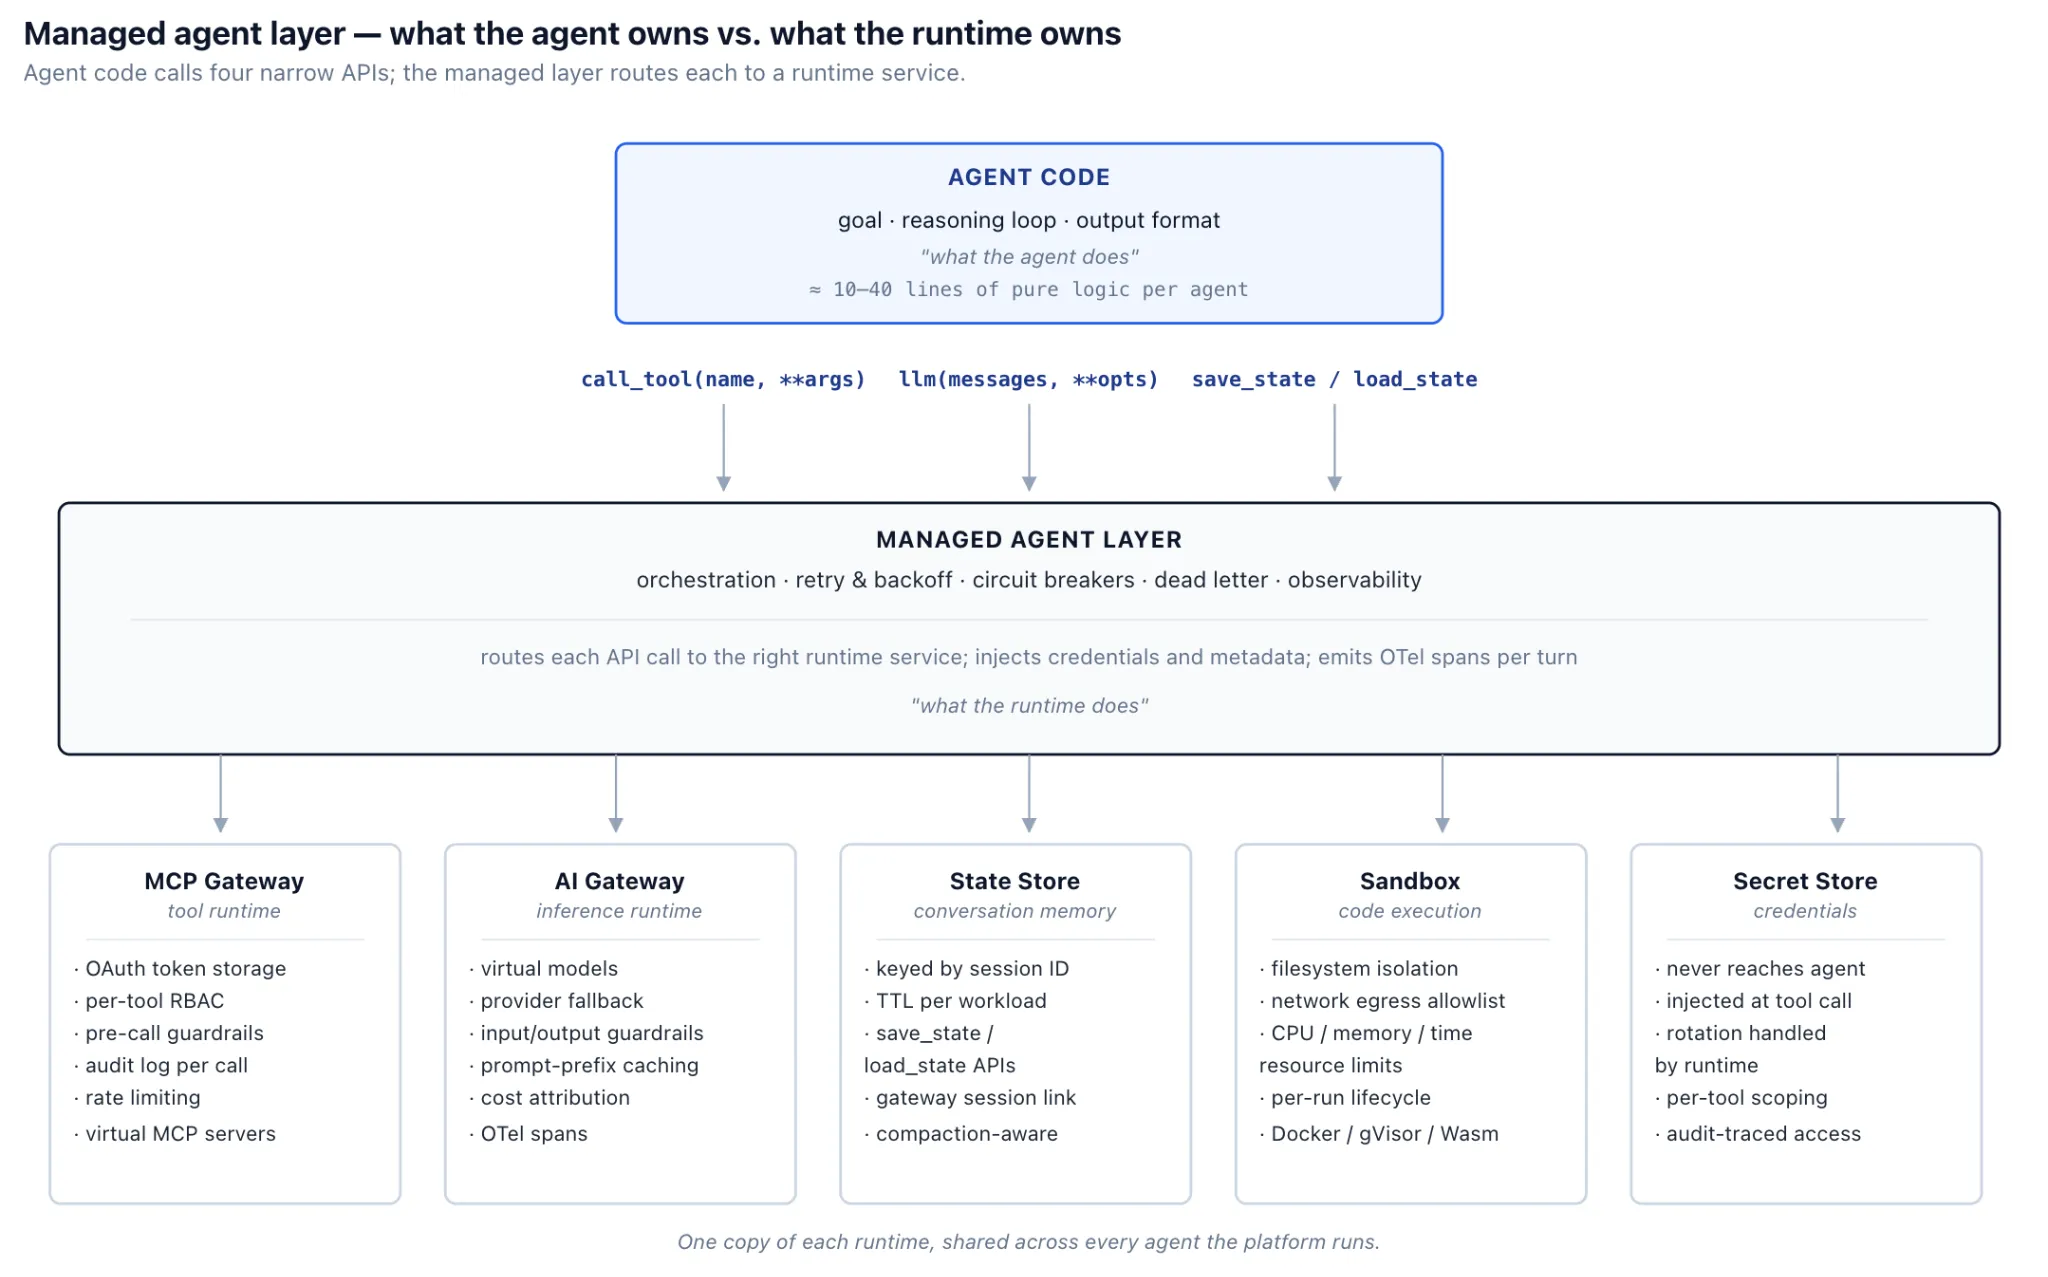
Orchestrierung. In einer Architektur mit verwalteter Laufzeitumgebung steuert die Laufzeitumgebung die Agentenschleife – sie ruft den Denkprozess des Agenten auf, analysiert die Modellausgabe auf Werkzeugaufrufe, leitet diese weiter, speist Ergebnisse zurück und erkennt den Abschluss. (Workflow-Graphen und dauerhafte Ausführungsmodelle kehren dies um – der Agent steuert den Graphen und die Laufzeitumgebung stellt die Grundfunktionen bereit; der Kompromiss besteht in einer expliziteren Ablaufsteuerung auf Kosten eines höheren Aufwands auf Agentenseite.) Abbruchbedingungen sind in beiden Modellen nicht trivial: ein explizites „Fertig“ des Modells, eine Ausgabe, die kein Werkzeug mehr anfordert, ein hartes Limit für die Anzahl der Durchläufe zur Begrenzung von Endlosschleifen oder ein „Stuck-Detector“, der auslöst, wenn der Agent dreimal hintereinander dasselbe Werkzeug mit denselben Argumenten aufruft.
Sandboxing. Ein Coding-Agent, der Tests ausführt, um seine eigenen Änderungen zu verifizieren, benötigt eine isolierte Ausführungsumgebung – keinen Zugriff auf das Host-Dateisystem außerhalb eines festgelegten Arbeitsbereichs, keinen ausgehenden Netzwerkverkehr außer zum KI-Gateway und registrierten MCP-Servern sowie strikte CPU-, Speicher- und Zeitlimits. Die Sandbox ist für jeden Durchlauf neu und vergänglich.
Zustandsverwaltung. Zwischen den einzelnen Schritten müssen der Gesprächsverlauf, der Notizblock des Agenten, Zwischenergebnisse der Werkzeuge und etwaige Fortschrittsmarkierungen gespeichert werden. Die Laufzeitumgebung stellt hierfür save_state und load_state bereit, die über die Sitzungs-ID referenziert werden, mit einer für die Arbeitslast angemessenen TTL.
Anmeldedaten-Injektion. Der Agentencode sieht niemals ein unverschlüsseltes Geheimnis. Die Laufzeitumgebung ruft Anmeldedaten aus einem sicheren Speicher ab und injiziert sie im Moment des Werkzeugaufrufs – typischerweise als Authorization-Header, den der Agentencode nicht lesen kann. Derselbe Mechanismus übernimmt die Rotation: Wenn ein Anmeldedatum rotiert wird, verwendet der nächste Werkzeugaufruf den neuen Wert, ohne dass der Agentencode geändert werden muss.
Wiederholungs- und Fehlerbehandlung. Exponentielles Backoff bei Ratenbegrenzungen, Circuit Breaker bei Ausfällen von Anbietern, eine Dead-Letter-Queue für Durchläufe, die nach erschöpften Wiederholungsversuchen fehlschlagen. Die Laufzeitumgebung klassifiziert jeden Fehler – vorübergehend, dauerhaft, Authentifizierung – und wendet die entsprechende Richtlinie an. Der Agentencode sieht entweder ein erfolgreiches Ergebnis oder eine finale, klassifizierte Ausnahme, nicht den rohen Wiederholungsstatus.
Die llm()-API der verwalteten Schicht ruft kein Anbieter-SDK direkt auf. Sie leitet Anfragen über das KI-Gateway, das die Kopplung an den Anbieter im Namen des Agenten übernimmt.
Python – was ein Agent NICHT tut, im Vergleich zu dem, was die Laufzeitumgebung für ihn erledigt
# What agent code looks like with the managed layer:
review = await self.llm(messages, model="claude-sonnet-4-6")

# What the runtime does on the agent's behalf, via the gateway:
#   1. Resolves "claude-sonnet-4-6" through the virtual-model config — could
#      be routed to a different provider entirely based on cost or availability.
#   2. Applies the team's input guardrails (PII scrubbing, prompt-injection
#      detection) before the call leaves the platform.
#   3. Picks an upstream account by load and rate-limit headroom; falls
#      back to a configured alternate on provider outage.
#   4. Streams the response back; applies output guardrails and emits OTel
#      spans with the team/app metadata from the previous post in this series.
#   5. Computes per-trace cost at span close, books it against the team budget.
Die Entkopplung ist strukturell. Der Agentencode weiß nicht – und muss auch nicht wissen –, ob sein Aufruf an OpenAI, Anthropic oder ein selbst gehostetes Modell ging. Wenn das Plattformteam einen neuen Anbieter hinzufügt, ein Modell wechselt oder eine neue Sicherheitsrichtlinie einführt, sind keine PRs für den Agenten erforderlich. Der Vertrag des Agenten ist die API-Schnittstelle, nicht das Upstream-System.
Dasselbe Muster gilt für Werkzeuge. Der Agentencode ruft call_tool() mit einem logischen Namen auf; das MCP-Gateway löst diesen in einen spezifischen MCP-Server auf, injiziert das richtige OAuth-Token, wendet RBAC an, führt Sicherheitsprüfungen vor der Ausführung durch, protokolliert den Aufruf und gibt das Ergebnis zurück.
Python – Agentencode ruft ein Werkzeug über das MCP-Gateway auf
diff = await self.call_tool("github.get_pr_diff", pr_id="4127")
issues = await self.call_tool("linter.check", diff=diff, ruleset="strict")
await self.call_tool("slack.post_message", channel="#code-review", text=summary)
Hinter dieser Schnittstelle verwaltet das Gateway die OAuth-Token für jeden von der Plattform unterstützten MCP-Server, zugeordnet zur Identität des aufrufenden Benutzers oder Dienstes. Es aktualisiert die Token bei Ablauf. Es erzwingt RBAC auf Werkzeugebene – „dieser Agent darf github.get_pr_diff aufrufen, aber nicht github.create_pr“ – unabhängig davon, was der Code des Agenten vorgibt. Es protokolliert jeden Aufruf mit Argumenten, Rückgabewerten sowie den IDs von Agent und Sitzung und erstellt so ein zentrales Audit-Log für die Werkzeugnutzung auf der gesamten Plattform (vorbehaltlich der üblichen Einschränkungen – Log-Pipelines können Daten verlieren, sampeln oder verzögert sein). Das MCP-Gateway von TrueFoundry fügt eine virtuelle MCP-Server-Abstraktion hinzu: einen einzigen logischen Endpunkt, der Werkzeuge von mehreren physischen MCP-Servern aggregiert, sodass sich die Werkzeugliste eines Agenten nicht ändert, wenn sich die Backend-Implementierungen ändern.
Der Vertrag für den Agentencode ist derselbe wie beim KI-Gateway: API mit einem logischen Namen aufrufen, Ergebnis erhalten und die Laufzeitumgebung die Anmeldedaten verwalten lassen.
Wenn ein Agent Code ausführt – sei es ein Coding-Agent, der Tests durchführt, ein Daten-Agent, der Python auf einer CSV-Datei ausführt, oder ein Tooling-Agent, der einen beliebigen Shell-Befehl absetzt –, muss dieser Code in einer vom Host isolierten Umgebung laufen. Im Mai 2026 gibt es drei ernstzunehmende Optionen, wobei die Zahlen für Kaltstarts als grobe Größenordnung dienen (die tatsächlichen Werte hängen stark von Image-Größe, Warm-Pools, Snapshotting und Knotenstatus ab):
Die Wahl hängt von Mandantenfähigkeit und Latenz ab. Ein Single-Tenant-Agent, der eine lange Coding-Sitzung pro Aufgabe ausführt, nutzt Docker – die Kosten für den Kaltstart fallen einmalig an und amortisieren sich über Hunderte von Code-Ausführungen. Eine Multi-Tenant-Plattform, die nicht vertrauenswürdigen Agenten-Code ausführt, setzt auf gVisor – der gemeinsame Kernel herkömmlicher Container ist ein echtes Sicherheitsrisiko, wenn der Code beliebig ist. Eine latenzempfindliche Arbeitslast, die für jeden Tool-Aufruf (z. B. Taschenrechner oder Regex-Tool) eine Sandbox startet, nutzt Wasm – ein einsekündiger Kaltstart pro Aufruf ist inakzeptabel, wenn der Aufruf selbst nur zwanzig Millisekunden dauert.
Das alles muss den Agenten nicht kümmern. Die Laufzeitumgebung stellt die Schnittstelle „Führe diesen Code aus, hier ist das Ergebnis“ bereit und wählt die passende Sandbox für die jeweilige Arbeitslastklasse aus.
Wo der Arbeitsspeicher des Agenten zwischen den einzelnen Schritten liegt, lässt sich auf drei Arten lösen:
Die meisten produktiven Agenten verwenden eine Kombination: Gateway-Sitzungen für die Zusammenfassung der Konversation und die Beobachtbarkeit, externen Speicher für den expliziten Notizblock und Fortschrittsmarkierungen des Agenten sowie den In-Context-Speicher für die letzten Schritte. Die Laufzeitumgebung stellt save_state und load_state als API für den Agenten bereit, unabhängig davon, an welches Backend sie die Daten weiterleitet.
Anthropic's Managed Agents, die sich seit dem 9. April 2026 in der öffentlichen Beta befinden (Beta-Header: managed-agents-2026-04-01), lassen sich als Beispiel für dieselbe grundlegende Trennung zwischen Agentenlogik und Ausführungsinfrastruktur verstehen. Ihre „Meta-Harness“-Architektur bietet Komponenten, die den Großteil dessen abdecken, was in diesem Beitrag beschrieben wird: eine orchestrierte Agentenschleife, sandkastenbasierte Codeausführung (anfangs von Anthropic gehostet, mit selbst gehosteten Sandboxes in einem späteren Release), Sitzungskontinuität mit zustandsbehaftetem Anhalten und Fortsetzen, Anmeldeinformationsverwaltung für externe Systeme sowie Beobachtbarkeit durch Traces. Anthropic selbst verwendet das Bild von Gehirn und Händen: Claude und das Harness laufen auf der Infrastruktur von Anthropic (das Gehirn); die Sandbox, in der Shell-Befehle und Code ausgeführt werden, sind die Hände.
Für Teams, die Agenten bei einem einzigen Anbieter aufbauen, ist das Produkt von Anthropic der einfachste Weg – das Harness ist standardmäßig für jedes Claude-API-Konto aktiviert und die API-Oberfläche ist der neue Managed-Agents-Beta-Header. Für Teams, die Agenten über mehrere Anbieter hinweg betreiben oder eigene Anforderungen an Sandboxing und Tooling haben, lässt sich dasselbe Muster aus Gateway-Primitiven zusammenstellen: ein KI-Gateway als Inferenz-Laufzeitumgebung (Multi-Provider, mit Kostenzuordnung und Budgetdurchsetzung, wie in den früheren Beiträgen dieser Serie beschrieben), ein MCP-Gateway als Tool-Laufzeitumgebung sowie eine Sandbox- und Speicher-Ebene, die vom Plattformteam verwaltet wird. TrueFoundry's AI Gateway und MCP Gateway sind die beiden Ebenen, die wir als Produkte anbieten; die Orchestrierungs- und Sandbox-Ebenen darüber sind bewusst austauschbar, da sie dort liegen, wo arbeitslastspezifische Entscheidungen getroffen werden.
Ist die Managed-Agent-Ebene nur ein Framework wie LangGraph oder AutoGen?
Frameworks wie LangGraph und AutoGen sind Bibliotheken für Agentenschleifen – sie übernehmen die Orchestrierungskomponente dessen, was dieser Beitrag als Managed Layer bezeichnet, überlassen Anmeldeinformationen, Sandboxing, Zustandspersistenz und Anbieter-Routing jedoch in der Regel der Anwendung. Eine Managed-Agent-Ebene im hier verwendeten Sinne übernimmt all diese Aufgaben und führt sie als Plattforminfrastruktur aus, anstatt sie als Code innerhalb des Agentenprozesses laufen zu lassen.
Was sind die Alternativen zu einer Managed Runtime und wann sind sie besser?
Die wichtigsten Alternativen, grob sortiert nach dem Grad ihrer Unterschiede:
Dieser Beitrag plädiert für eine bestimmte Architektur. Keine dieser Ansätze ist falsch; sie befinden sich lediglich an unterschiedlichen Punkten auf derselben Skala zwischen Flexibilität und operativer Konsistenz.
Was sind die Nachteile einer verwalteten Laufzeitumgebung?
Vier Punkte, bei denen man ehrlich sein sollte: (1) Weniger lokale Flexibilität – der Agent-Code kann die Laufzeitumgebung nicht umgehen, um clevere, tool-spezifische Anmeldedaten-Verwaltung oder benutzerdefinierte Wiederholungsrichtlinien zu implementieren. (2) Schwierigeres Experimentieren – um einen Agenten lokal auszuführen, muss nun die Laufzeitumgebung verfügbar sein, nicht nur ein Python-Interpreter. (3) Laufzeit-Lock-in – den Agenten von der Laufzeitumgebung zu lösen, ist eine echte Migration, kein einfaches Neukompilieren. (4) Abstraktionsverlust bei Fehlern – das Debuggen eines fehlerhaften Agenten erfordert nun die Analyse der Agenten-Logik, der Orchestrierung durch die Laufzeitumgebung und der darunterliegenden Gateways, wobei drei Log-Streams korreliert werden müssen. Der Artikel argumentiert, dass sich dieser Aufwand ab dem dritten oder vierten produktiven Agenten meist lohnt; für den ersten jedoch oft nicht.
Wenn Anthropic verwaltete Agenten als Produkt anbietet, warum sollte man dann eigene bauen?
Für Agenten, die vollständig auf Claude basieren, ist das Managed-Agents-Produkt von Anthropic meist der einfachste Weg. Teams bauen ihre eigenen Lösungen in der Regel dann, wenn sie Multi-Provider-Routing benötigen (denselben Agenten für verschiedene Workloads gegen unterschiedliche Modelle laufen lassen), spezifisches Sandboxing für Workloads brauchen (ein selbst gehosteter gVisor-Pool für nicht vertrauenswürdigen Code) oder eine Integration in bestehende Plattform-Infrastruktur (ein unternehmensweiter Secrets-Manager, ein bestehender Observability-Stack) erforderlich ist. Das Muster bleibt gleich; die Frage ist nur, was man einkauft und was man selbst zusammenbaut.
Wie funktioniert das bei Agenten, die keinen Code ausführen?
Die Sandbox-Komponente ist optional. Ein reiner Tool-nutzender Agent – einer, der MCP-Aufrufe orchestriert und strukturierte Ausgaben erzeugt – benötigt keine Code-Ausführung, und die Laufzeitumgebung kann die Sandbox komplett überspringen. Die anderen vier Komponenten (Orchestrierung, Status, Anmeldedaten, Wiederholungslogik) gelten weiterhin.
Wie sieht die Laufzeitumgebung bei Streaming-Antworten oder Teilausgaben aus?
Die llm()-API bietet sowohl Batch- als auch Streaming-Varianten. Beim Streaming erhält der Agent-Code einen asynchronen Iterator von Chunks; die Laufzeitumgebung verwaltet den zugrunde liegenden Provider-Stream, wendet bei Eintreffen der Chunks Output-Guardrails an und gibt beim Schließen des Streams OTel-Spans pro Turn aus.
Wie wird das getestet? Man kann nichts unit-testen, das von einem LLM und einer Sandbox abhängt.
Die Managed-Layer-Schicht macht Agenten testbar. Die drei APIs (call_tool, llm, save_state/load_state) bilden die gesamte Abhängigkeitsoberfläche des Agenten und können jeweils gemockt oder wiederholt werden. Eine Test-Suite kombiniert in der Regel ein deterministisches Mock-LLM mit aufgezeichneten Tool-Antworten, sodass die Reasoning-Schleife des Agenten ohne Zugriff auf einen Provider oder eine Sandbox ausgeführt werden kann. Die Laufzeitumgebung selbst wird separat auf der Plattformebene getestet.
Wo ordnet sich TrueFoundry ein?
Das TrueFoundry AI Gateway und das MCP Gateway stellen die Inferenz- und Tool-Laufzeitschichten der hier beschriebenen Architektur bereit – Modell-Routing mit Provider-Fallback, Guardrails, Kostenzuordnung und Budgets auf der KI-Seite; OAuth-Handling, RBAC, virtuelle MCP-Server und Audit-Logging auf der Tool-Seite. Die darüber liegenden Schichten für Orchestrierung, Sandbox und State-Store liegen bewusst in der Verantwortung des Plattformteams, da dort arbeitslastspezifische Entscheidungen getroffen werden. Für Teams, die ein vollständig vertikal verwaltetes Produkt auf Basis von Claude suchen, sind die Managed Agents von Anthropic der richtige Vergleich.
Der praktische erste Schritt für ein Team, das seinen dritten oder vierten Agenten geschrieben und das Muster in Devis PR erkannt hat, besteht darin, die call_tool- / llm- / save_state-Schnittstelle in eine kleine gemeinsame Bibliothek auszulagern und jede über die Gateways zu leiten, die die Plattform bereits betreibt. Anmeldedaten und die Authentifizierung pro Tool werden von Anfang an durch die Laufzeitumgebung verwaltet und niemals direkt in den Agenten-Code integriert. Alles Weitere ergibt sich aus diesem Vertrag.
Northwind, Devi und die Codebasis mit vier Agenten dienen der Veranschaulichung; das Architekturmuster, das Problem der Verflechtung und die Zerlegung auf Gateway-Basis zeigen, wie produktive Agenten-Plattformen im Jahr 2026 tatsächlich aufgebaut werden, wobei die Managed Agents von Anthropic das bekannteste Beispiel eines einzelnen Anbieters sind. Das AI Gateway und das MCP Gateway von TrueFoundry sind marktreife Produkte, die die Inferenz- und Tool-Laufzeitschichten bereitstellen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















