October 24, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Wir haben GuideLLM-Lasttests für drei 8B-Parameter-Modelle auf einer einzelnen NVIDIA A10 (24 GB) GPU durchgeführt: Qwen3-8B, Llama 3.1 8B Instruct und Ministral 8B. Dieser vLLM-Benchmark testete die Parallelität von 4 bis 256 gleichzeitigen Nutzern bei zwei Workloads: kurzem Chat und Intent-Klassifizierung. Ein Modell hielt dem gesamten Bereich stand. Die anderen beiden nicht.
Alle drei Modelle liefen in FP16 auf vLLM und wurden über den standardmäßigen /v1/chat/completions-Streaming-Endpunkt bereitgestellt. GuideLLM hielt pro Parallelitätsstufe (4, 8, 16, 32, 64, 128, 256) jeweils genau N Anfragen für 90 Sekunden aktiv, mit einer Abkühlphase von 30 Sekunden zwischen den Stufen.
Zwei Workloads:
Gleiche vLLM-Version, gleiche Gateway-Konfiguration, gleiche GPU für alle drei. Die unten aufgeführten Ergebnisse spiegeln diese Bedingungen wider.
Die Zusammenfassungstabelle verwendet 64 gleichzeitige Nutzer für den Vergleich des kurzen Chats. Dies ist die letzte Parallelitätsstufe, bei der Llama fehlerfrei lief (0 % Fehler), und stellt somit die fairste gemeinsame Basis für alle drei Modelle dar.
Qwen3 hat die niedrigste typische Wartezeit (524 ms p50) und die stabilste Tail-Latenz (2.840 ms p95). Llama erreicht 11 % mehr Tokens pro Sekunde, aber der durchschnittliche Nutzer wartet 2.569 ms auf das erste Token, verglichen mit 524 ms bei Qwen3. Ein Punkt stach in den Daten hervor: Llamas E2E p95 (10,4 s) ist niedriger als der von Qwen3 (11,4 s), obwohl die TTFT deutlich schlechter ist. Llama startet langsam, dekodiert aber schnell. Sobald die Tokens fließen, tun sie dies schneller als bei Qwen3. Für Streaming-UIs ist jedoch die Verzögerung bis zum ersten Token das, was Nutzer tatsächlich wahrnehmen.
Vollständige Perzentil-Aufschlüsselungen für jede Parallelitätsstufe, Ergebnisse für Poisson-Burst-Traffic und herunterladbare CSV-Dateien finden Sie im interaktiven Benchmark- Bericht.
Bei geringer Parallelität starteten alle drei Modelle mit einer ähnlichen TTFT p50 von etwa 350 ms. Qwen3 blieb auf diesem Niveau. Bei 16 gleichzeitigen Nutzern lag der p50-Wert von Qwen3 bei 388 ms. Der von Llama war bereits auf 794 ms angestiegen.
Qwen3 hat jede Anfrage bei jedem Parallelitätsgrad bis 256 erfolgreich verarbeitet. Es gab keine abgebrochenen Anfragen. Bei 64 gleichzeitigen Anfragen lag der TTFT p50 bei 524 ms mit einem Durchsatz von 851 Tok/s.
Unsere Arbeitshypothese für die Stabilität unter Last: Qwen3 verwendet QK-LayerNorm, was die Attention-Scores bei langen KV-Caches stabilisiert. Zudem bietet der etwas geringere KV-Footprint pro Layer vLLM mehr Spielraum bei der Planung, bevor Anfragen am Gateway in die Warteschlange geraten. Llamas größere FFN (14.336 gegenüber 12.288 bei Qwen3) sorgt zwar für einen höheren Durchsatz pro Token, füllt aber die Decode-Pipeline schneller, was bei steigender Parallelität weniger Platz für neue Prefills lässt. Wir untersuchen das noch, aber der Architekturunterschied scheint hier eine Rolle zu spielen.
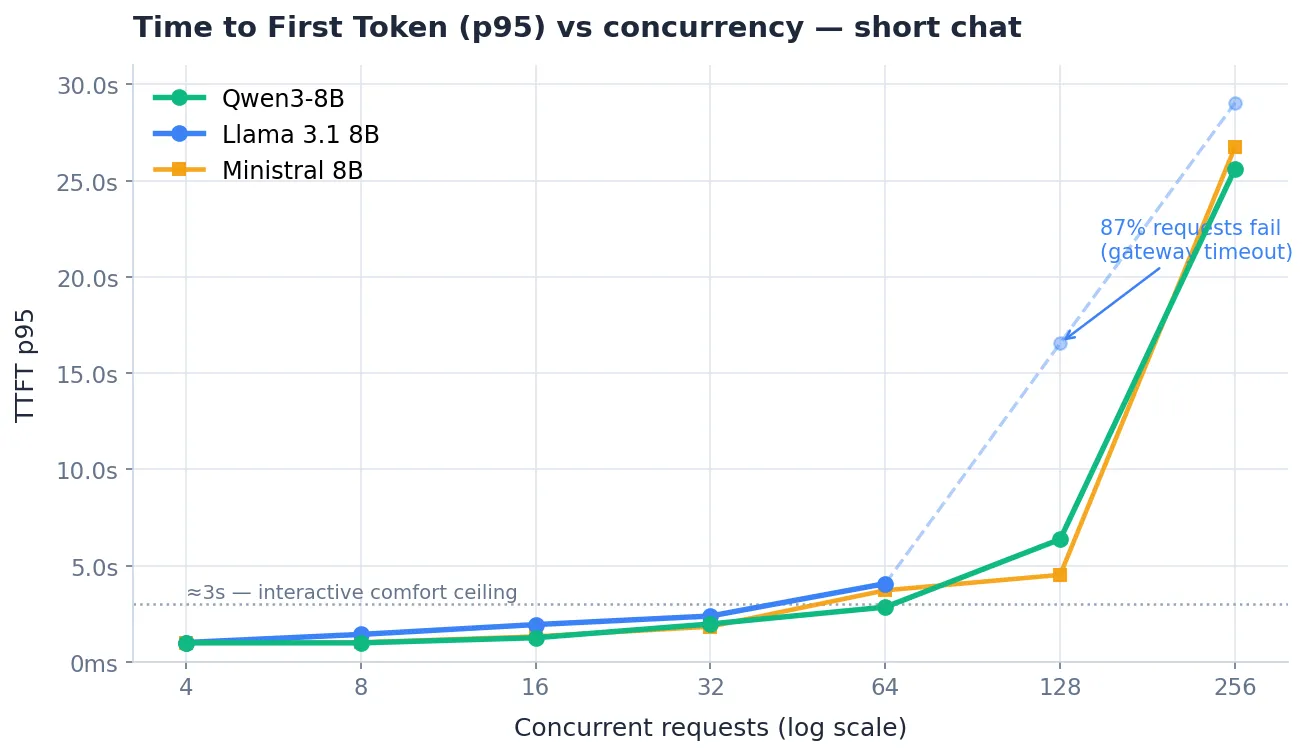
Llama erzielte in der Spitze den höchsten Rohdurchsatz: 1.181 Tok/s bei einer Parallelität von 256. Bei einer Parallelität von 128 erhielten jedoch 86,9 % der Anfragen 408-Timeouts. Der Wert von 1.181 Tok/s stammt von den wenigen Anfragen, die durchkamen, nachdem der Server bereits den Großteil seiner Warteschlange abgeworfen hatte.
Bei 64 gleichzeitigen Anfragen (dem letzten sauberen Punkt) lieferte Llama 947 Tok/s mit einem TTFT p95 von 4.062 ms und 0 % Fehlern. Das sind 11 % mehr Durchsatz als bei Qwen3 unter gleicher Last. Für Batch-Inferenz oder asynchrone Pipelines, bei denen Wiederholungsversuche akzeptabel sind, ist dieser Durchsatzvorteil real. Für interaktive Anwendungen sollte man das Limit auf 32-64 gleichzeitige Anfragen setzen.
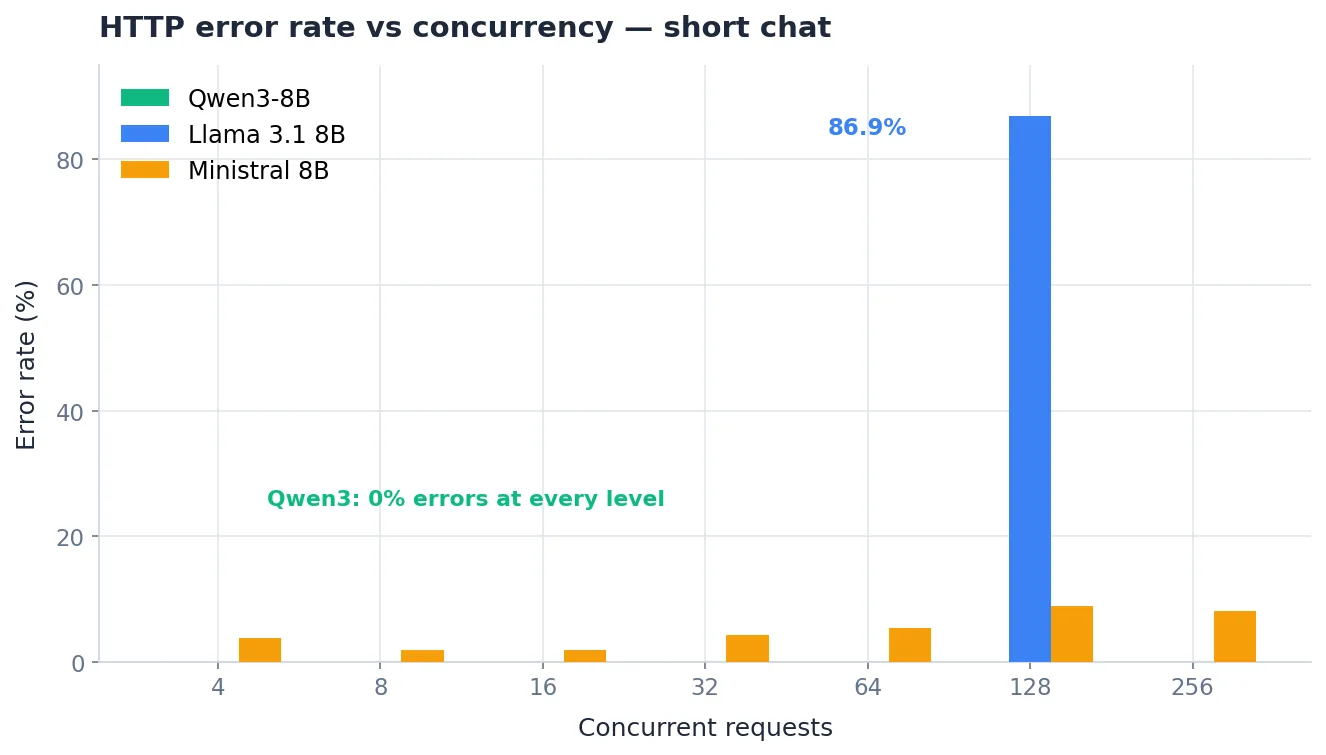
Wir müssen hier ehrlich sein: Ministral zeigte bereits bei einer Parallelität von 4, der geringsten von uns getesteten Last, 3,8 % echte HTTP-Fehler. Bei 64 gleichzeitigen Anfragen waren es 5,3 %, bei 128 stieg der Wert auf 8,9 %. Dies waren echte 408/503-Fehler, keine Artefakte des Benchmarks. Dies spiegelt wahrscheinlich eher eine Instabilität der Bereitstellung während unseres Testzeitraums wider als eine grundlegende Einschränkung des Modells, aber die Daten sind nun einmal so.
Wo Anfragen erfolgreich waren, war die Latenz von Ministral wettbewerbsfähig: TTFT p50 von 350 ms bei Basislast und 512 ms bei 64 gleichzeitigen Anfragen, nahe an den 524 ms von Qwen3. Latenzzahlen sagen jedoch wenig aus, wenn etwa jede 20. Anfrage nie eine Antwort erhält.
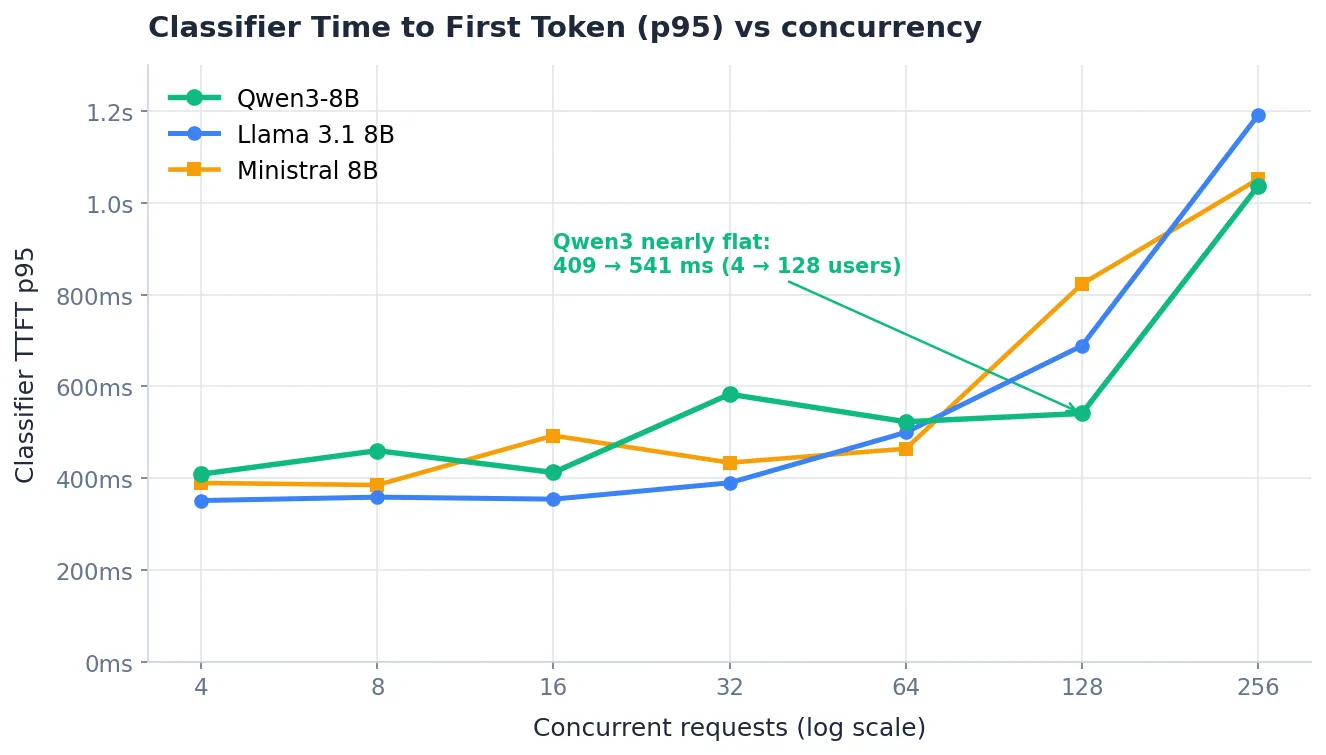
Beim Klassifizierungs-Workload liefen alle drei Modelle bis zu 256 gleichzeitigen Nutzern fehlerfrei. Llama führte bei den rohen Anfragen pro Sekunde (173 RPS), gefolgt von Qwen3 (157 RPS) und Ministral (143 RPS).
Aussagekräftiger ist, wie sich die Latenz unter Last veränderte. Der TTFT p95 von Qwen3 lag bei 128 gleichzeitigen Anfragen bei 541 ms, nur 32 % über dem Basiswert von 409 ms. Der p50 stieg von 358 ms auf 467 ms. Bei Llama verdoppelte sich der p95 fast (von 351 ms auf 689 ms). Bei Ministral mehr als verdoppelte er sich (von 390 ms auf 823 ms).
Wenn Sie einen Intent-Router oder Klassifikator mit vorhersehbarer Latenz bei stoßartigem Datenverkehr benötigen, ist die flache Kurve von Qwen3 beachtenswert. Die GPU nimmt kurze Klassifizierungsanfragen in einen einzigen Batch auf, ohne dass Warteschlangen entstehen – und das zeigt sich in den Zahlen.
Alle drei starten am gleichen Punkt und skalieren bis 16 gleichzeitige Nutzer linear. Danach öffnet sich die Schere.
Jenseits von 64 steigt der Durchsatz von Llama auf dem Papier weiter an (1.181 Tok/s bei 256), aber die meisten Anfragen werden abgelehnt. Qwen3 pendelt sich bei etwa 830-850 Tok/s ein und bedient jede Anfrage. Ministral liegt bei 64 gleichzeitigen Anfragen etwa 15 % unter Qwen3, selbst bei den Anfragen, die erfolgreich waren.
Ein roher Spitzenwert ohne die dazugehörige Fehlerrate ist für die Kapazitätsplanung nahezu bedeutungslos. Alle drei vLLM-Benchmarks verdeutlichen das.

Wir haben diesen vLLM-Benchmark auf einer einzelnen A10-Spot-Instanz durchgeführt, die über TrueFoundry bereitgestellt wurde. Die vollständige vLLM-Konfiguration und die GuideLLM-Befehle werden im ausführlichen Blogbeitrag veröffentlicht.
Die Modell-Serving-Ebene von TrueFoundry stellt vLLM-Backends auf jeder GPU-Klasse (A10, A100, H100) direkt über die Control Plane bereit. Sie wählen das Modell aus, legen max_model_len sowie tensor_parallel_size fest, und TrueFoundry kümmert sich um den Container, die GPU-Zuweisung und die Health Checks. Das Modell wird über einen standardmäßigen, OpenAI-kompatiblen Endpunkt bereitgestellt.
Vor dem vLLM fügt das AI Gateway von TrueFoundry einen Overhead von etwa 3-4 ms hinzu, während es über 350 RPS auf einer einzelnen vCPU verarbeitet. Es bietet Ihnen Ratenbegrenzungen pro Modell, Kostenzuordnung, Fallback-Routing über verschiedene Anbieter hinweg sowie eine vollständige Anfragen-Nachverfolgung. Wenn Sie mehrere Modelle vergleichen (wie in diesem Benchmark), können Sie alle drei über denselben Gateway-Endpunkt leiten und durch Ändern des Modellfelds in der Anfrage zwischen ihnen wechseln. URL und Anmeldedaten bleiben dabei gleich.
TrueFoundry unterstützt über 1.000 LLMs über eine einzige OpenAI-kompatible API. Der Wechsel von einem getesteten Open-Weight-Modell zu einem kommerziellen Anbieter erfordert daher keine clientseitigen Änderungen.
Für Teams, die Open-Weight-Modelle hinter einem Gateway selbst hosten, hält diese Architektur die Serving-Ebene von Routing und Governance getrennt. Lesen Sie Die 10 besten Tools zur LLM-Observability im Jahr 2026 für die Überwachung Ihrer vLLM-Bereitstellung, sobald diese läuft.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




A vLLM benchmark measures how a model served via vLLM performs under concurrent load. The key metrics are time to first token (TTFT), end-to-end latency, token throughput, and error rates at different concurrency levels. The most useful vLLM benchmarks sweep from low to high concurrency to find the point where performance degrades or requests start failing, since peak throughput numbers without error rates are misleading.
In this benchmark, Qwen3-8B was the only model to complete every request at every concurrency level through 256 concurrent users with zero errors. Llama 3.1 8B was clean through 64 concurrent but hit 87% error rates at 128. Ministral 8B had persistent errors starting at concurrency 4.
Based on this vLLM performance benchmark, 64 concurrent users is the last clean operating point for Llama 3.1 8B on a 24 GB A10. At 128 concurrent, 87% of requests fail with gateway timeouts. For interactive workloads, stay at or below 64. For batch jobs with retry logic, you can push higher.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet