



November 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Klassisches API Rate Limiting geht davon aus, dass Anfragen austauschbar sind: Ein GET /users/42 kostet in etwa so viel wie die nächste Anfrage, sodass das Zählen von Anfragen ein guter Indikator für die Last ist. Jedes Rate Limiter-System, das Sie bisher konfiguriert haben, basiert auf diesem Prinzip.
LLM-Traffic bricht mit dieser Logik. Derselbe Endpunkt, dieselbe Minute, derselbe Benutzer: „Fasse dies in einer Zeile zusammen“ entspricht vielleicht 50 Tokens Roundtrip; ein 150-seitiger Vertrag, der an ein Reasoning-Modell gesendet wird, liegt nahe bei 200.000. Beide sind jeweils eine Anfrage, und ein Limit von 1.000 Anfragen pro Minute erlaubt beides.
Diese Varianz ist die normale Form von Produktions-Traffic, sobald Agenten im Spiel sind. Denn ein Agenten-Schritt überträgt bei jedem Schritt die gesamte Konversation plus Tool-Ergebnisse plus abgerufenen Kontext zurück in den Prompt. Die Anzahl der Anfragen bleibt gleich, während die Anzahl der Tokens um eine Größenordnung steigt – die Mechanik hinter der agentischen Token-Explosion in CI/CD.
Ändern Sie also die Einheit. Zählen Sie Tokens, denn Tokens sind das, was Sie bezahlen. Die Anzahl der Anfragen ist weiterhin wichtig – sie schützt das Gateway und die Anbieterverbindung –, führen Sie also beides aus.
Die meiste Verwirrung entsteht hier durch die Begrifflichkeiten. Vier Probleme, vier Mechanismen, und Teams richten routinemäßig einen Mechanismus ein, im Glauben, sie hätten einen anderen installiert:
Rate Limits sind eine Verfügbarkeitssteuerung; Budgets sind eine Finanzsteuerung. Sie schlagen unterschiedlich fehl und haben unterschiedliche Verantwortliche – Platform Engineering verantwortet das erste, Finance das zweite.
Der häufigste Fehler besteht darin, ein Token Rate Limit einzurichten und es als Kostenkontrolle zu bezeichnen. 20.000 Tokens pro Minute bei einem günstigen Modell entsprechen einigen Dollar pro Tag; bei einem Frontier Reasoning-Modell ist es ein ganz anderer Betrag, der sich jedes Mal ändert, wenn ein Anbieter die Preise anpasst. Token-Durchsatz ist kein Geld.
Provider-Limits verdienen eine Warnung, da Teams sich oft unbeabsichtigt auf sie verlassen. Ihr OpenAI- oder Anthropic-Org-Limit ist ein einzelner gemeinsamer Pool: Wenn ein Batch-Job diesen auslastet, wird Ihr kundenorientiertes Produkt von einem System gedrosselt, das die Priorisierung „der Assistent gewinnt immer“ nicht ausdrücken kann. Daher benötigen Sie ein Gateway unter Ihrer Kontrolle.
Der Algorithmus entscheidet, wie viel Burst-Traffic durchgelassen wird – kein unwichtiges Detail für Agenten.
Algorithmus Wie er zählt und was als Burst durchgelassen wird Fixed Window Ein Zähler pro Zeitintervall, der an der Grenze zurückgesetzt wird. Im schlimmsten Fall wird das 2-fache des Limits erlaubt – volles Kontingent um 11:59:59 und erneut um 12:00:00 Sliding Window Unter-Buckets, die über einen gleitenden Zeitraum summiert werden, sodass die Spitzen an den Grenzen durch die Größe der Unter-Buckets begrenzt werden Token Bucket Tokens werden mit einer festgelegten Rate nachgefüllt und jede Anfrage verbraucht einige. Dies ermöglicht einen Burst bis zur Bucket-Tiefe, bevor auf die Nachfüllrate gedrosselt wird
Für menschlichen Chat-Traffic ist ein Fixed Window völlig ausreichend – Menschen koordinieren ihre Anfragen nicht zeitgleich. Agenten hingegen tun dies unbeabsichtigt. Sie wiederholen Anfragen bei Fehlern, führen parallele Aufrufe aus und laufen nach Zeitplänen. Daher treffen viele Aufrufer auf denselben Zeitpunkt der Echtzeituhr, wodurch die Verdopplung des Limits keine Theorie mehr bleibt. Sliding Windows beheben dies, da es keinen festen Rücksetzzeitpunkt gibt. Token Bucket beantwortet eine andere Anforderung – es eignet sich für Traffic, bei dem Sie kurze Bursts wünschen –, allerdings um den Preis eines weiteren zu konfigurierenden Parameters.
Ein Downgrade wird am seltensten genutzt: Wenn ein Limit auf Modellebene erreicht wird, kann eine Fallback-Kette Anfragen über einen zweiten Provider bedienen, anstatt einem Benutzer einen HTTP-429-Fehler zurückzugeben – genau der Failover-Mechanismus aus unserem Artikel über LLM-Router, bei dem 429 als auslösender Statuscode dient. Eine Überschreitung des Budgets ist etwas anderes: Wenn das Geld aufgebraucht ist, ist es aufgebraucht. Stillschweigend Geld an einer günstigeren Stelle auszugeben, entspricht nicht den Anforderungen der Finanzabteilung.
Generische Regel steht über der spezifischen Regel. Bei einer Auswertung nach dem Prinzip „First-Match-Wins“ schluckt eine breit angelegte Regel weiter oben Traffic, der eigentlich zu einer spezifischeren Regel weiter unten hätte passen sollen. Die spezifische Regel wird nie ausgelöst.
Ein gemeinsamer Zähler wird als Limit pro Benutzer behandelt. „20.000 Tokens pro Minute“ ohne nähere Abgrenzung bedeutet einen einzigen Zähler für alle. Der erste Aufrufer verbraucht das gesamte Kontingent.
Die Annahme, dass fehlerhafte Anfragen kostenlos sind. Für anfragenbasierte Limits trifft das nicht zu – und für Token-Limits sieht die Antwort anders aus.
Zwei bewusst getrennte Policy-Objekte: Rate Limiting steuert den Durchsatz, Budgets steuern das Geld.
Rate-Limiting-Regeln akzeptieren sechs Einheiten – das vollständige Set:
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
Es gibt keine Einheit pro Sekunde; eine einzelne LLM-Anfrage kann mehrere zehn Sekunden dauern, sodass Limits pro Sekunde lediglich Rauschen messen würden. Die Konfiguration erfolgt im Tab Config:
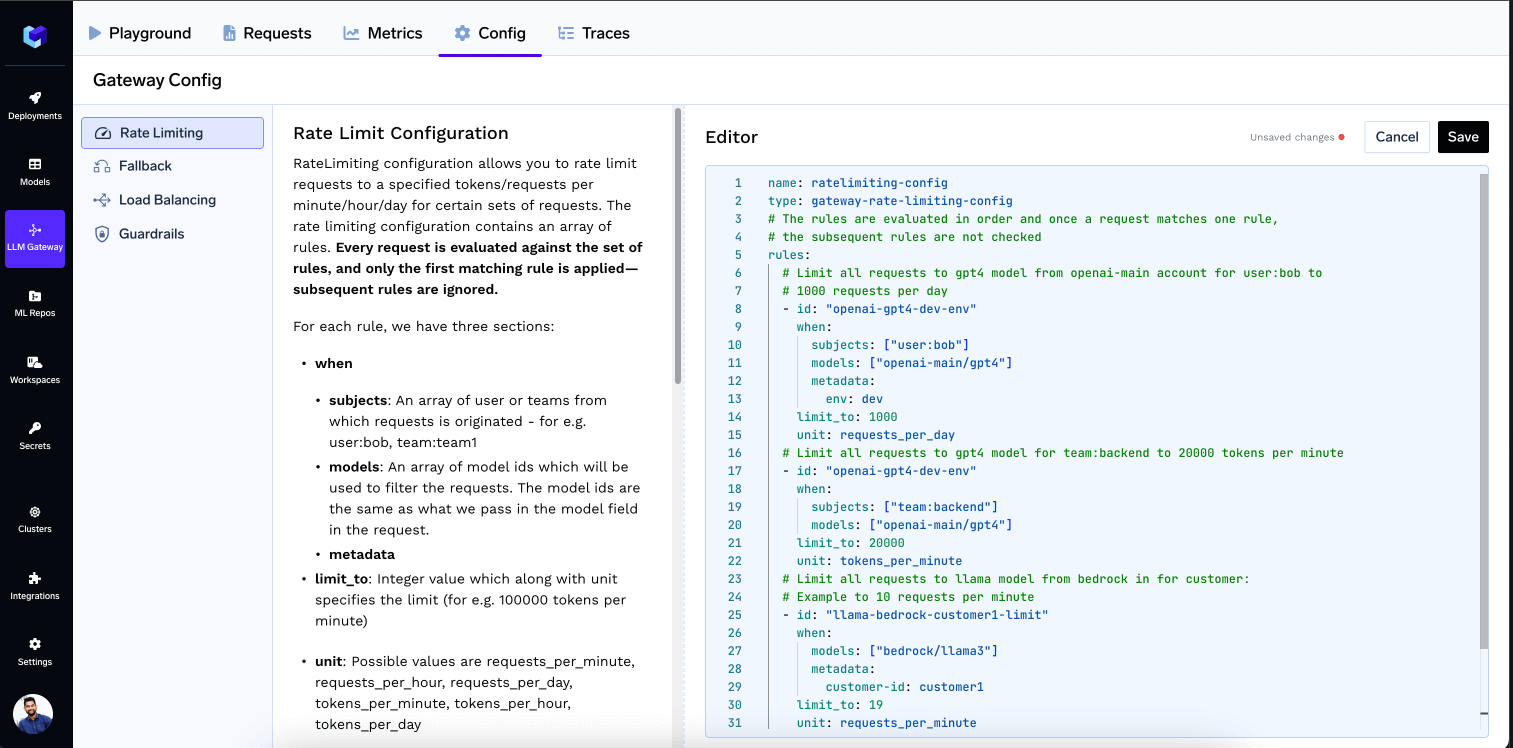
Ein Regelset hat den Typ type: gateway-rate-limiting-config mit einer Liste von Regeln. Jede Regel besitzt eine statische id, einen when-Block, dessen Bedingungen für Subjects, Models und Metadata mit AND kombiniert werden, ein Ganzzahl-Limit limit_to, eine Einheit (unit) und optional rate_limit_applies_per. Subjects sind mit Präfixen versehen – user:, team:, virtualaccount: – und Metadaten werden aus dem X-TFY-METADATA-Header gelesen.
Da die kleinste Einheit pro Minute gilt, verwaltet das Gateway ein 60-Sekunden-Fenster. Es speichert zeitbasierte Buckets alle 10 Sekunden für jeden Benutzer, jedes Modell, jedes Team oder jedes benutzerdefinierte Segment und summiert die letzten 6 Buckets zur Auswertung des Zählers. Ältere Buckets verfallen. Die 10-Sekunden-Auflösung ist die entscheidende Kennzahl: Ein Burst wird über sechs Teilintervalle geglättet, anstatt zweimal an einer einzelnen Rücksetzgrenze erlaubt zu werden.
Ohne diesen Parameter ist eine Regel ein einzelner gemeinsamer Zähler für alles, worauf sie zutrifft. Mit ihm wird der Zähler pro Entität aufgeteilt. Zulässige Werte sind user, virtualaccount, model und metadata.* mit Ihrem eigenen Schlüssel. Maximal zwei Werte pro Regel.
['user'] gibt jedem Benutzer ein eigenes Kontingent und ['model'] jedem Modell. Die letzte Regel entspricht dem Muster, das die meisten Teams am Ende benötigen: Obergrenze pro Projekt, basierend auf Metadaten, die die Anwendung bereits sendet – ganz ohne Anpassung der Regeln, wenn ein neues Projekt hinzukommt.
Dies hat ein dynamisches Regel-ID-Format ersetzt. Die Migration erfolgt mechanisch – {user}-daily-limit wird zu id: 'user-daily-limit' plus ['user'], und project-{metadata.project_id}-limit wird zu id: 'project-limit' plus ['metadata.project_id']:
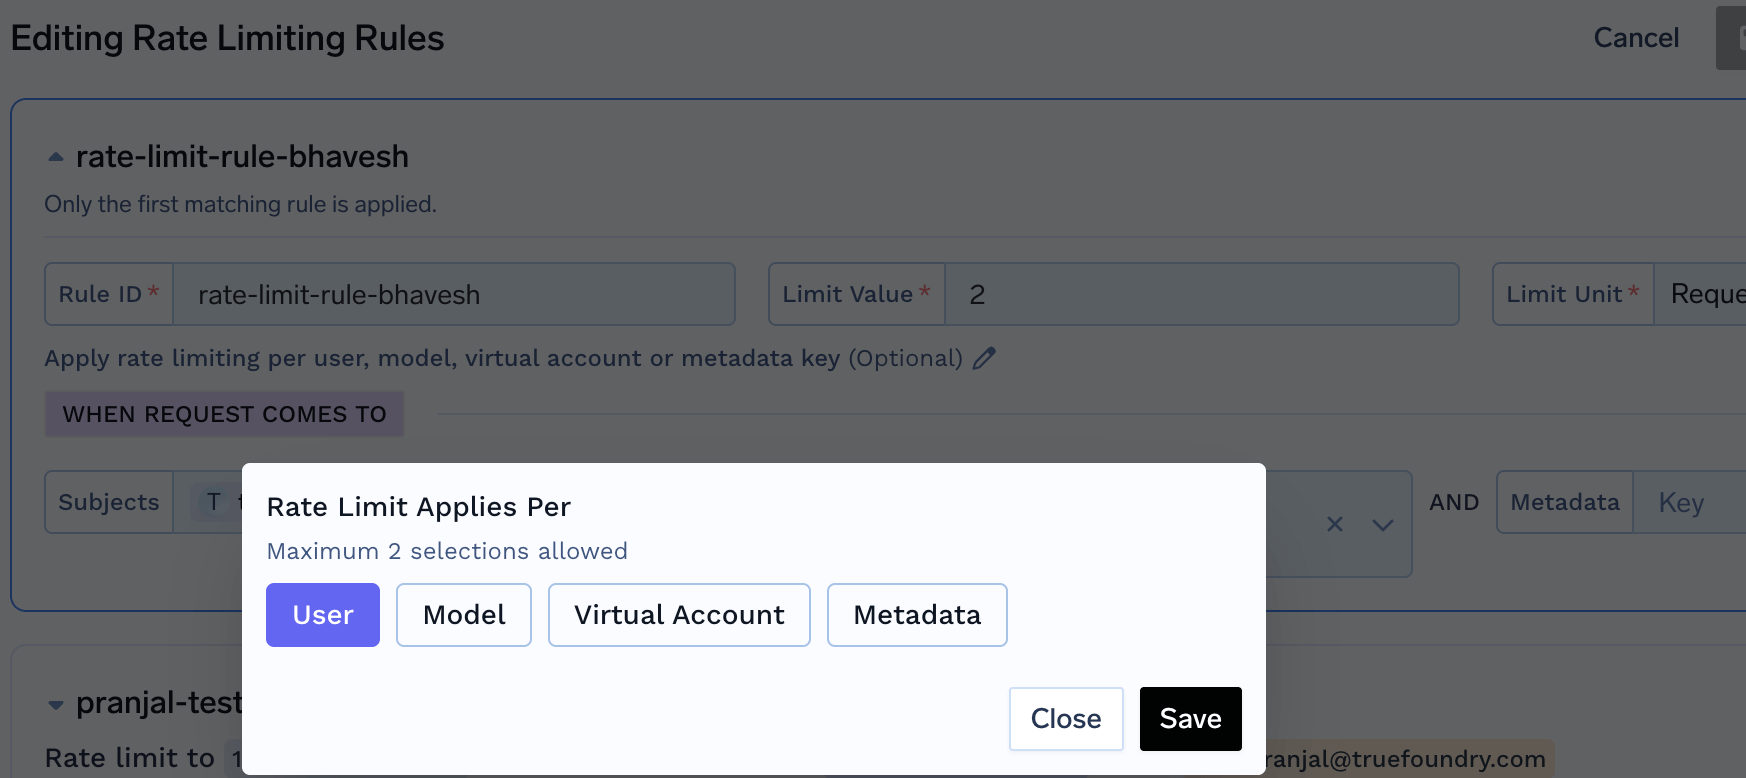
Jede Anfrage wird gegen jede Regel ausgewertet, aber nur die erste passende Regel wird durchgesetzt. Spätere Übereinstimmungen blockieren die Anfrage nie. Der Verbrauch wird jedoch für jede Regel gezählt, auf die die Anfrage zutrifft.
Platzieren Sie spezialisierte Regeln daher weiter oben. Ein dokumentierter Fehler: Wird app-a-limit (10.000 rpm, virtualaccount:app-a) oberhalb von tenant-wide-limit (5.000 rpm, when: {}) platziert, lastet der Traffic von App A – der für beide gezählt wird – den Mandantenzähler alleine aus. Jeder Aufrufer, dessen erste Übereinstimmung die Mandantenregel ist, erhält dann einen 429-Fehler weit unterhalb von 5.000 rpm. Die Lösung besteht nicht im Umstellen der Reihenfolge, sondern in der Abgrenzung durch: rate_limit_applies_per: ['user', 'virtualaccount'].
Jede Anfrage, die vom Gateway abgelehnt wird oder beim Provider mit einem 4XX/5XX-Fehler fehlschlägt, wird als eine Anfrage für jede passende requests_per_*-Regel gezählt. Eine Ausnahme: Eine Anfrage, die bereits durch das Rate Limiting selbst mit einem 429-Fehler abgelehnt wurde. Dadurch wird verhindert, dass ein Retry-Storm die Situation weiter verschlimmert.
Token-Limits verhalten sich anders. Fehlerhafte Anfragen verbrauchen kein Token-Kontingent, da eine fehlerhafte Anfrage keine Tokens zurückmeldet. Es gibt nichts zu zählen. Aus diesem Grund kann eine Retry-Schleife Ihr Anfragen-Budget aufbrauchen, während das Token-Dashboard unauffällig bleibt.
Eine Überschreitung gibt den Status HTTP 429 mit error.type: "RateLimitError" und error_origin_level: "rate_limit_budget" zurück, zusammen mit einem x-tfy-applied-rules-Header, der die ausgelöste Regel benennt.
Budgets dienen der finanziellen Steuerung und beziehen sich ausschließlich auf Kosten als cost_per_* in USD. Es gibt kein Budget auf Token-Basis – wenn Sie eine Token-Obergrenze wünschen, handelt es sich um ein Rate Limit.
Budget V2 wurde in v0.158.0 eingeführt und kehrt die Durchsetzungslogik um: Jede passende Regel wird geprüft und alle müssen die Anfrage zulassen (eine AND-Verknüpfung über alle Budgets). Rate Limiting funktioniert nach dem Prinzip „First-Match-Wins“; Budgets nach dem Prinzip „All-Must-Pass“. V1 nutzte noch „First-Match-Wins“, weshalb die Migration eine semantische Änderung darstellt, keine syntaktische.
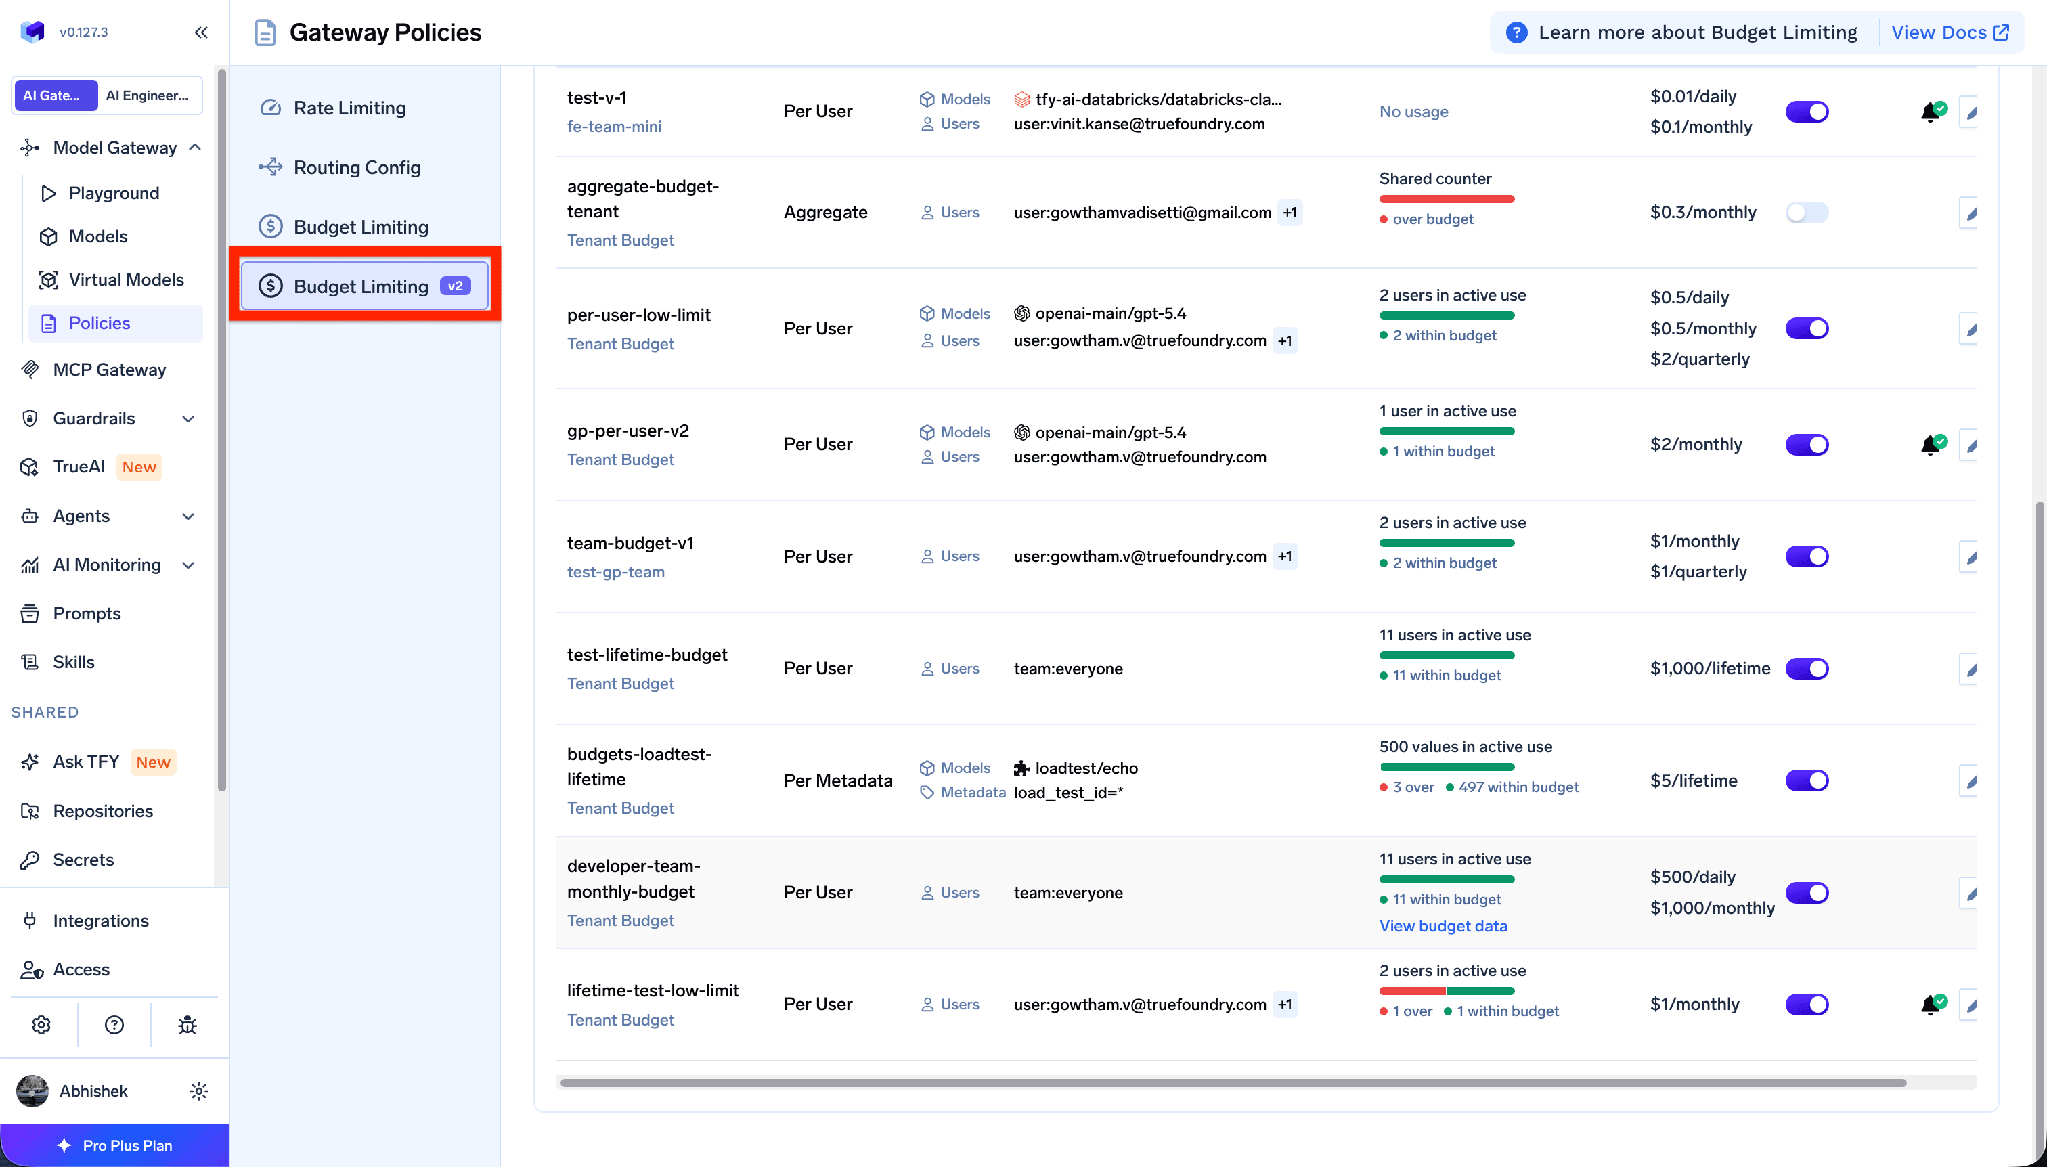
Regeln werden unter AI Gateway → Policies → Budget Limiting → Add Rule in zwei Bereichen definiert: Tenant (tenant-budget-config) oder Team (team-budget-config mit einem per RBAC durchgesetzten team_name).
Fünf Rücksetzzeiträume, alle in UTC: Daily (00:00), Weekly (Montag 00:00), Monthly (1. des Monats), Quarterly (1. Jan., 1. Apr., 1. Jul., 1. Okt.) und Lifetime (wird nie zurückgesetzt) – das Spend Cap aus der obigen Tabelle:
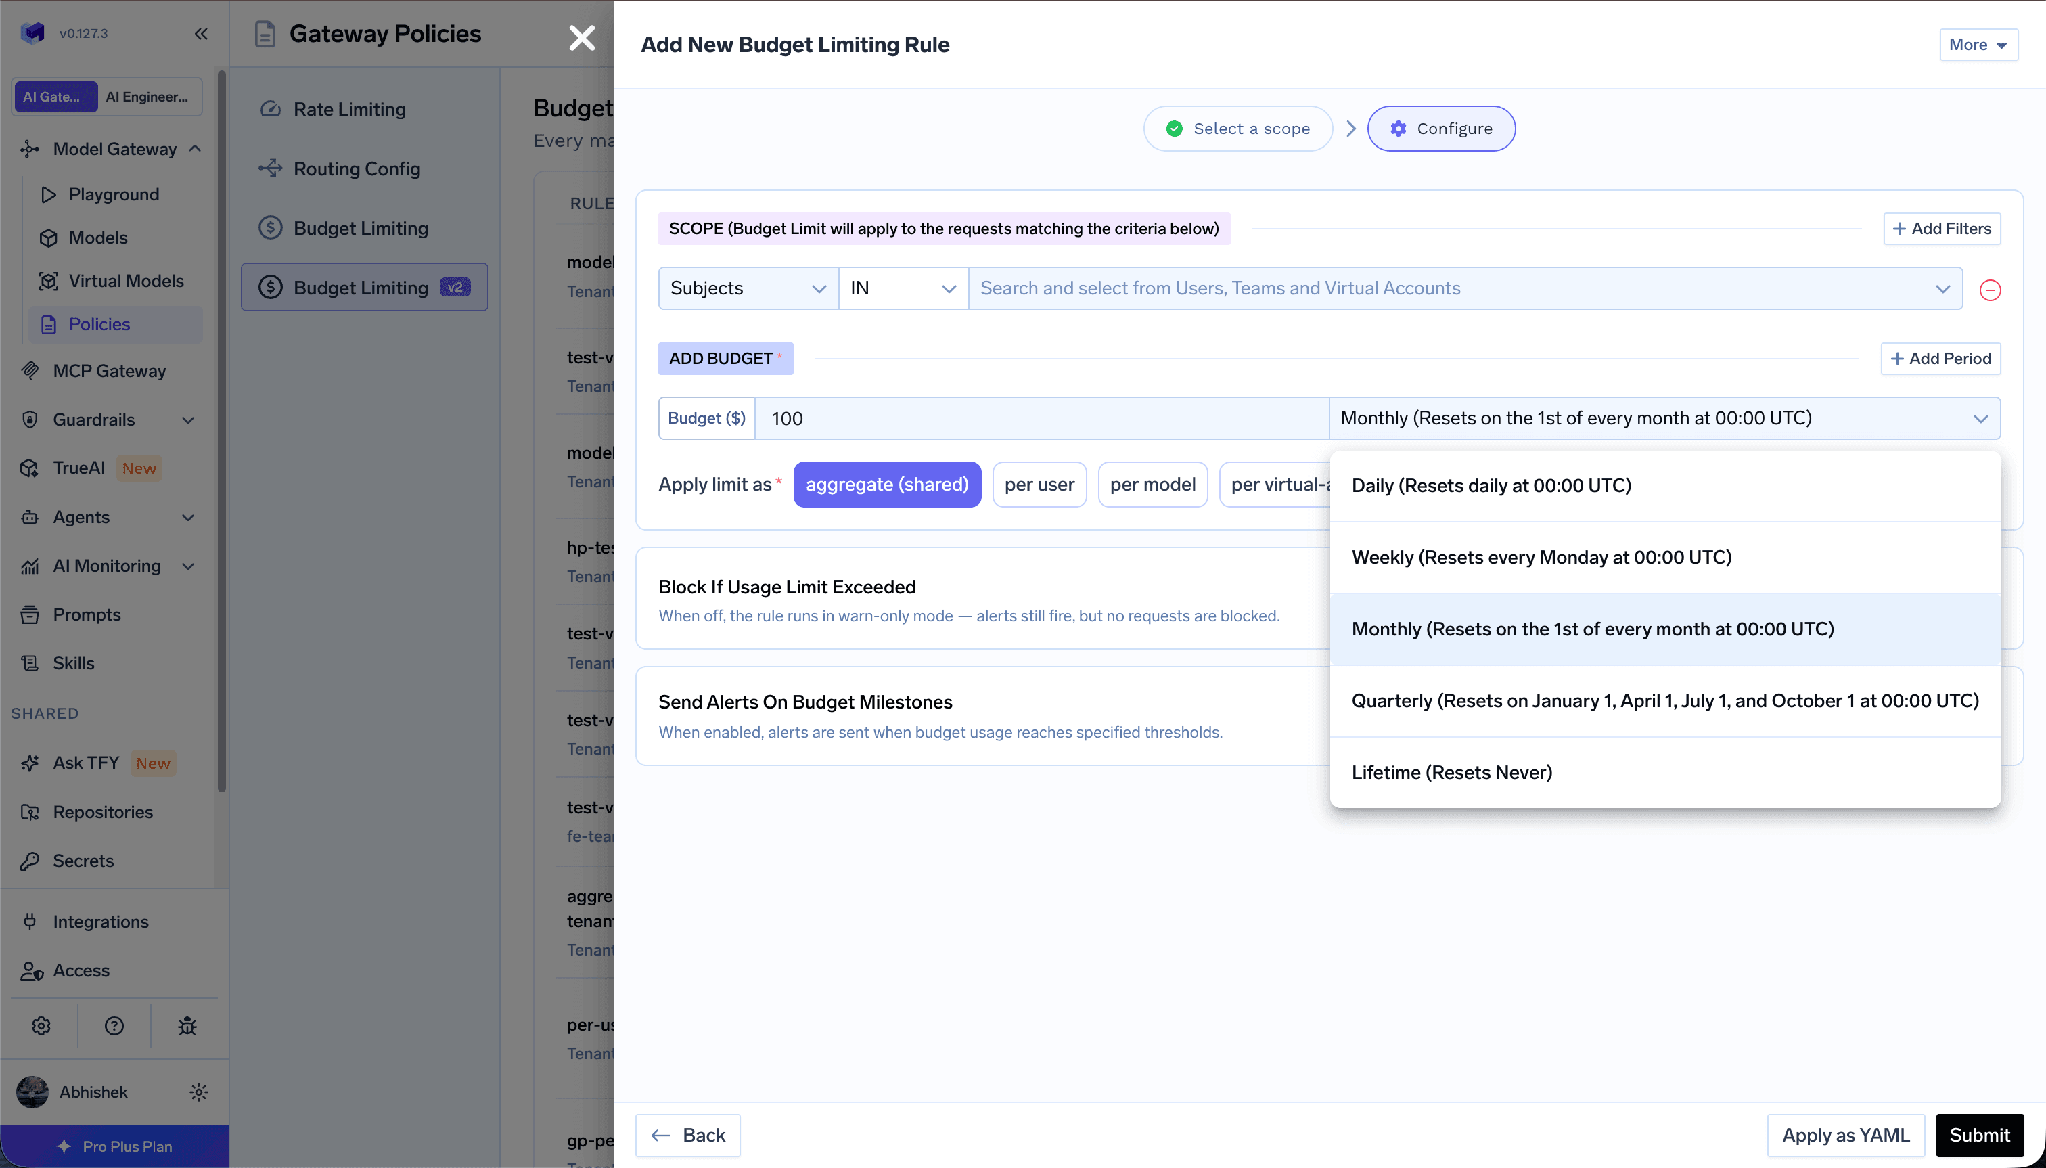
Eine einzelne Regel kann mehrere Zeiträume gleichzeitig durchsetzen und blockieren, wenn einer davon überschritten wird. Das Multi-Period-Cap-Beispiel aus der Dokumentation legt cost_per_day: 0.5, cost_per_month: 0.5 und cost_per_quarter: 2 gemeinsam fest. Bereichsfilter – Subjects, Models, Provider accounts, Metadata – unterstützen IN/NOT IN und werden mit AND verknüpft:
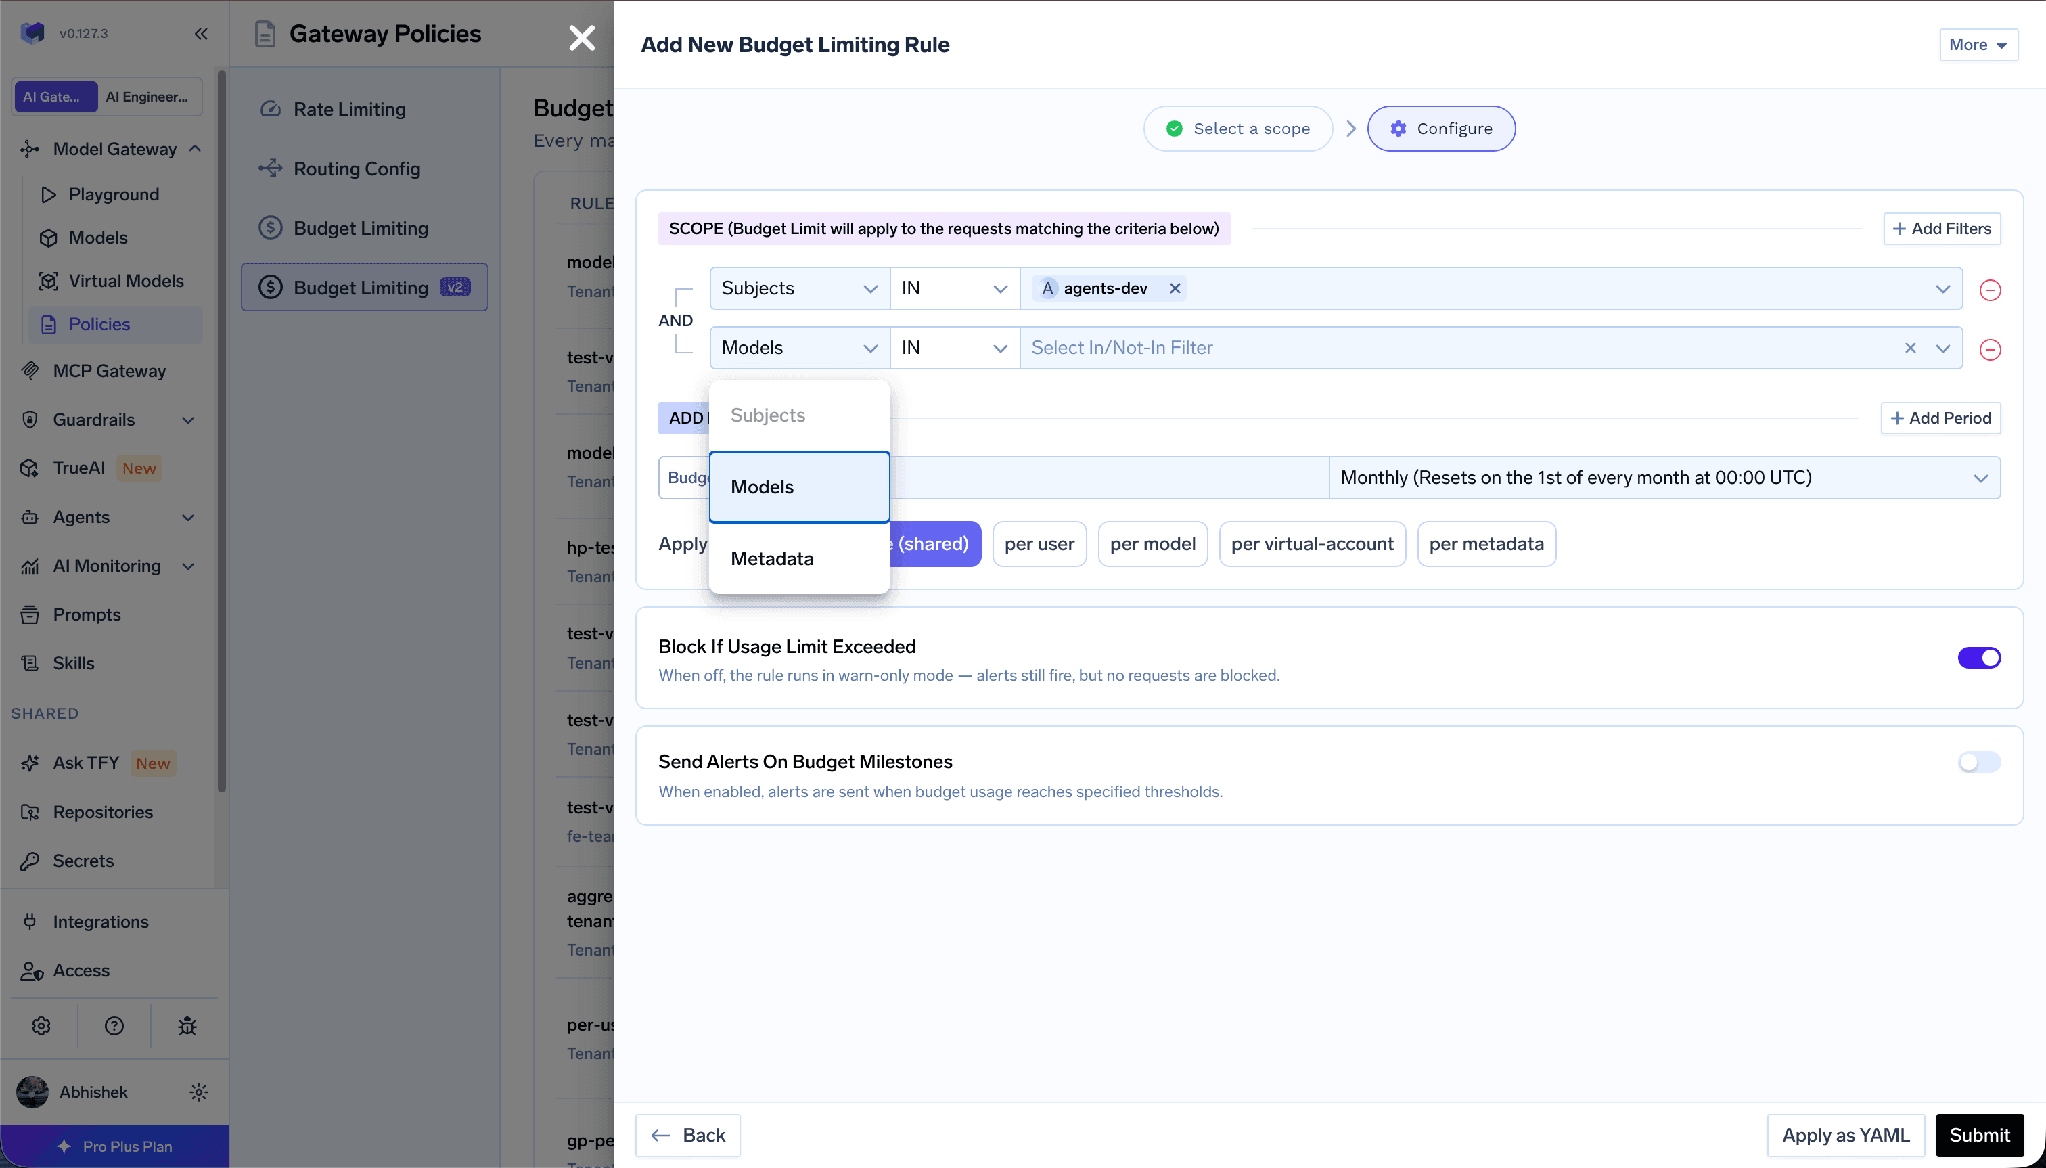
Apply limit as (applies_to.type) akzeptiert aggregate, per-user, per-model, per-virtual-account oder metadata mit einem Schlüssel und kann nach der Erstellung nicht mehr geändert werden. Entitätsbezogene Regeln unterstützen Overrides für namentlich genannte Benutzer, Modelle, Virtual Accounts oder Metadatenwerte:
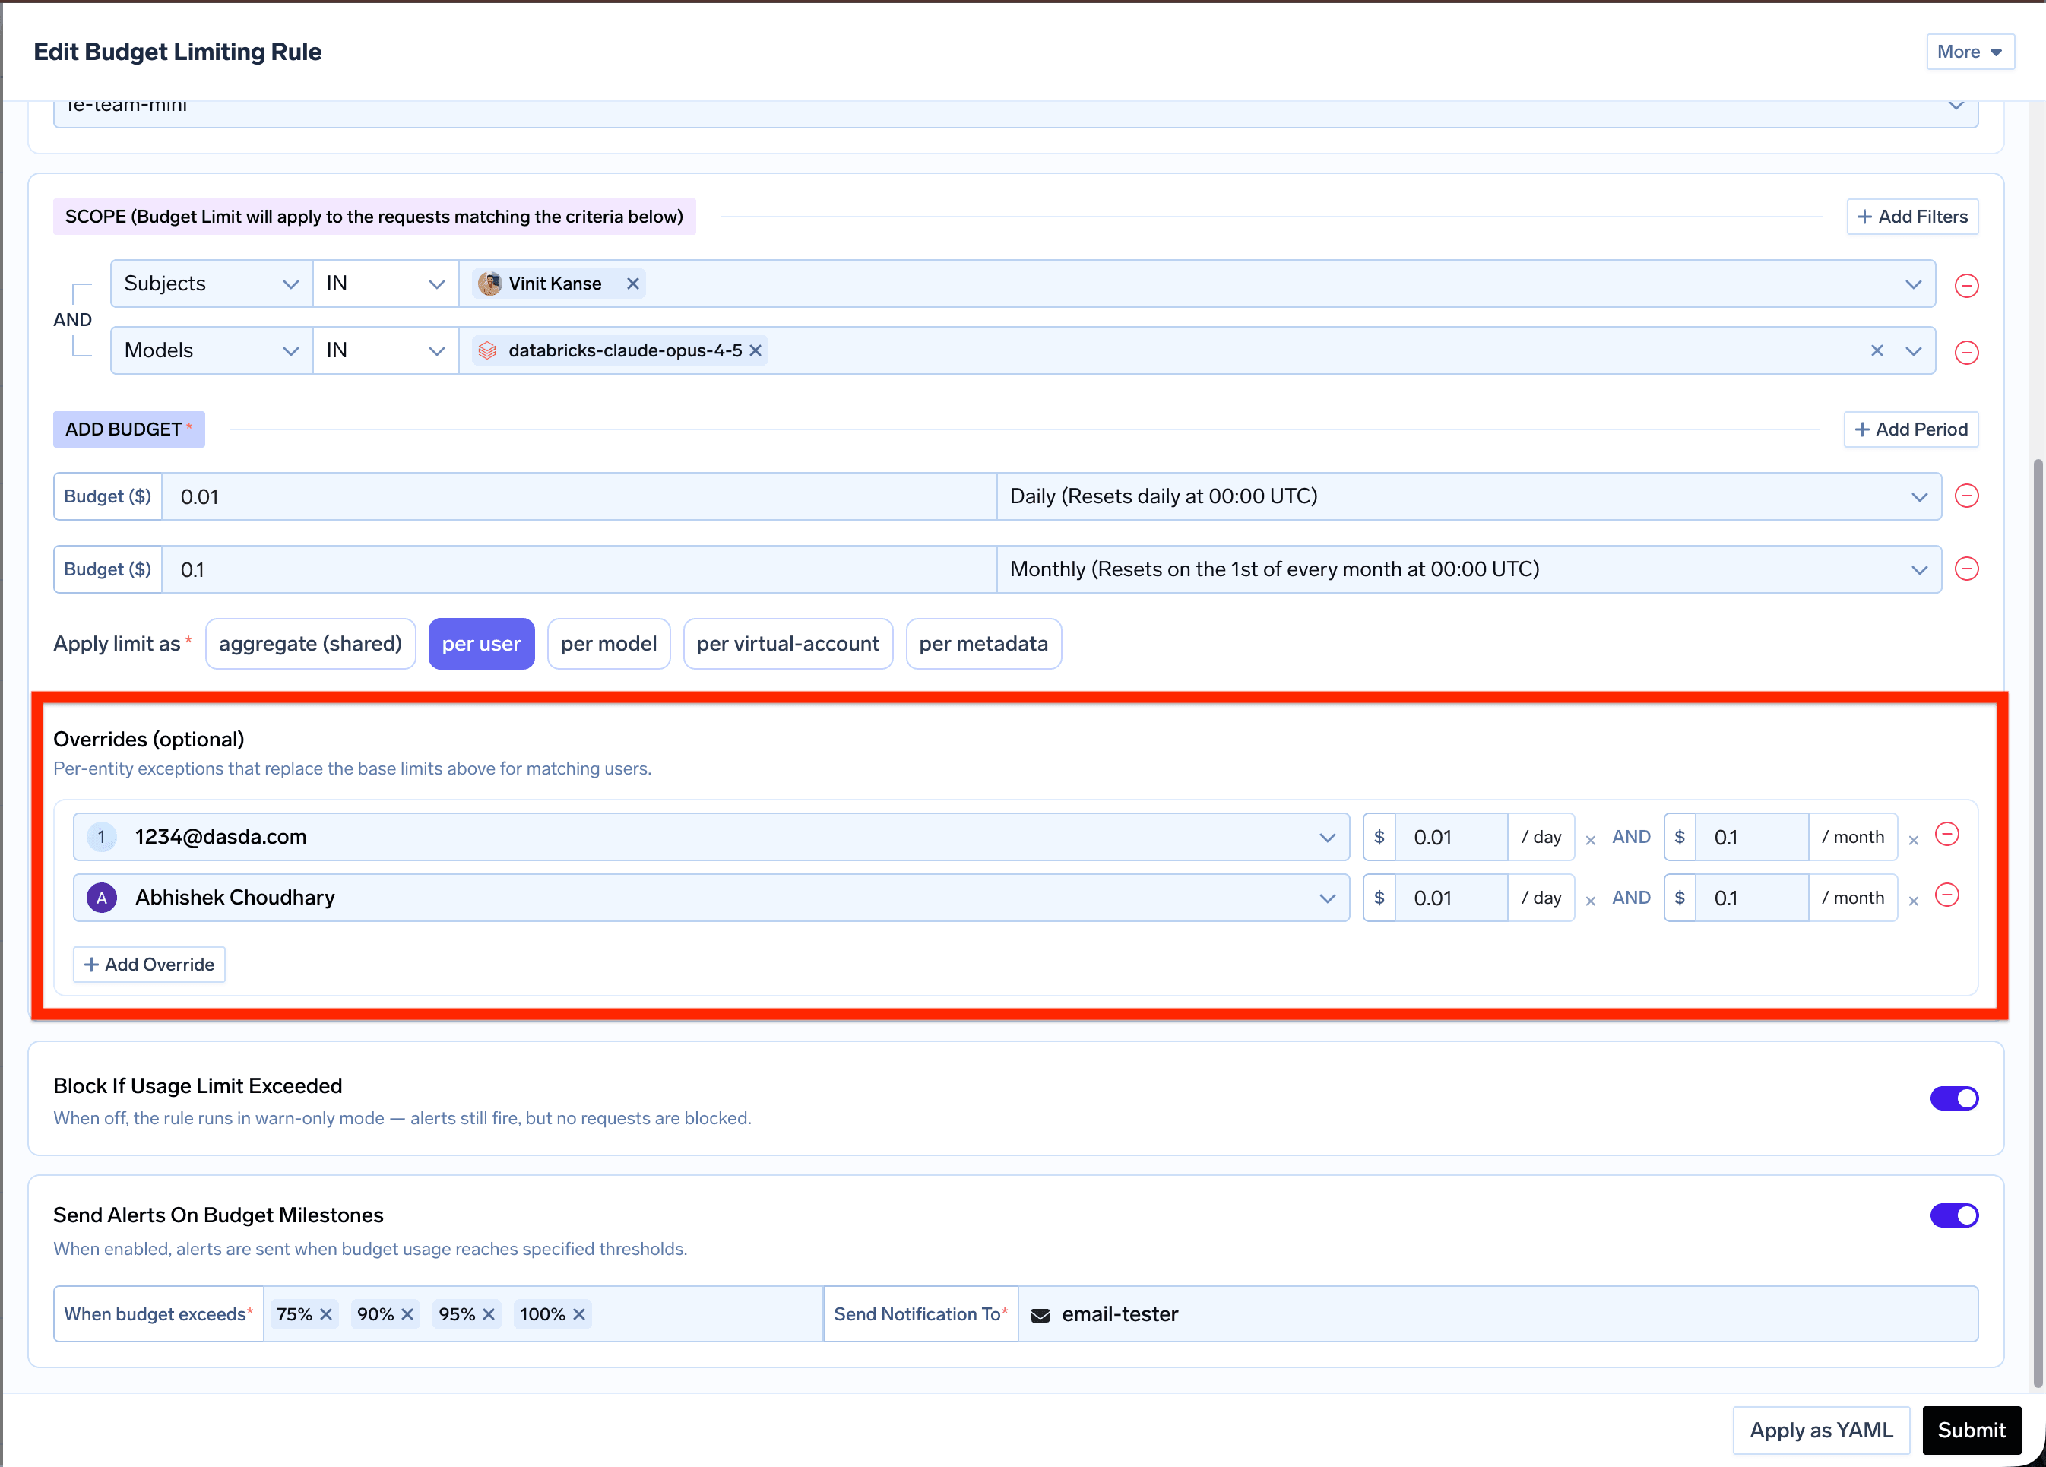
Ein Override ersetzt alle Zeiträume für diese Entität. Wenn die Basisregel tägliche und vierteljährliche Obergrenzen festlegt und der Override nur eine tägliche Obergrenze definiert, gilt für diese Entität überhaupt keine vierteljährliche Obergrenze mehr. Geben Sie daher jeden Zeitraum an, der angewendet werden soll.
Drei Modi: enforce (Standard, ablehnen), audit (durchlassen, weiterhin nachverfolgen und benachrichtigen) und soft_enforce – wird nur blockiert, wenn kein anderes passendes Budget die Anfrage noch zulassen kann. Hat ein anderes Budget noch Kapazität, wird die Anfrage durchgelassen und die Überschreitung wie ein Audit-Verstoß protokolliert. Ein strikter Enforce-Verstoß an beliebiger Stelle setzt sich immer durch.
Benachrichtigungen werden bei 75, 90, 95 und 100 Prozent ausgelöst, jeweils einmal pro Budgetzeitraum und separat für jede Entität bei einem entitätsbezogenen Budget. Lifetime-Budgets benachrichtigen einmalig pro Schwellenwert. Ziele: E-Mail, slack-webhook, slack-bot, pagerduty, ms-teams-webhook, mit {{user.email}} für benutzerbezogene Zustellung.
Ein wichtiger Hinweis: Budgetzähler starten mit der Regelerstellung, nicht zu Beginn des Zeitraums. Bisherige Ausgaben werden nicht rückwirkend berücksichtigt, sodass eine Mitte des Monats erstellte Regel nicht mit Ihrer Abrechnung für diesen Zeitraum übereinstimmt.
Budgets sind nur so gut wie die zugrunde liegende Preisgestaltung, daher ist diese Preisgestaltung offen einsehbar. Der Katalog unter github.com/truefoundry/models dient als Preisdatenbank für das öffentliche Kostentracking und ist unter truefoundry.com/models einsehbar. Prüfen Sie den angewendeten Tarif; reichen Sie einen PR ein, falls Angaben fehlerhaft sind.
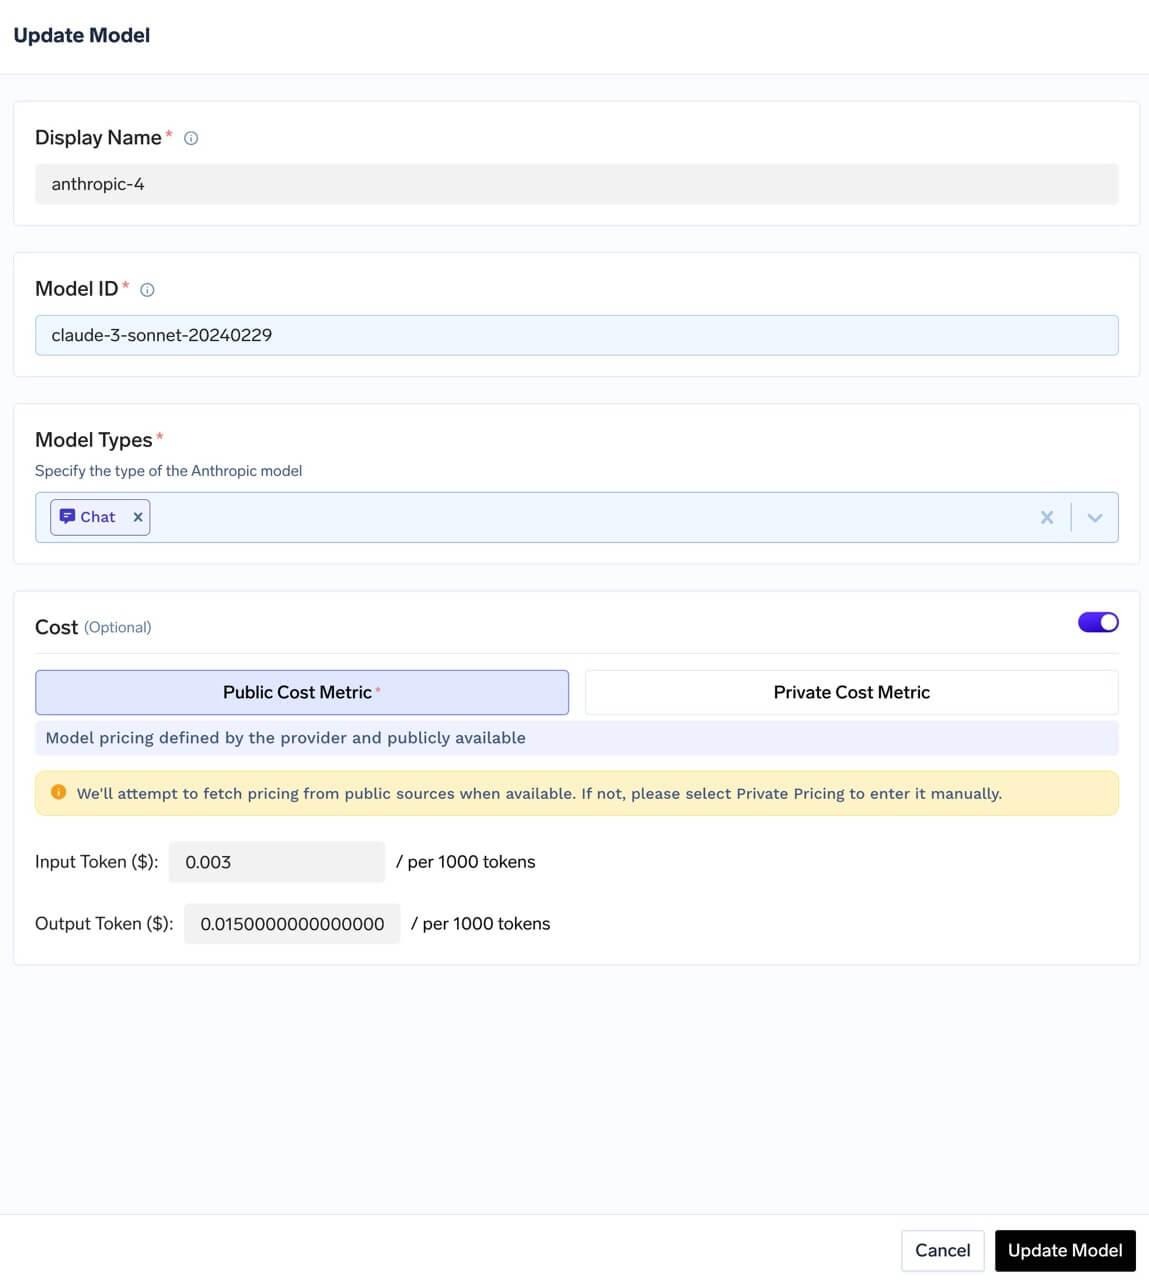
Zwei Details sind hierbei wichtig. Regionenspezifische Preisgestaltung: providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml enthält unterschiedliche Input- und Output-Tarife für us-west-2, us-west-1, eu-central-1 und eu-west-1, sodass Traffic über mehrere Regionen hinweg nicht durch einen Pauschaltarif falsch berechnet wird. Gestaffelte Preisgestaltung: providers/google-gemini/gemini-2.5-pro.yaml enthält Basistarife sowie höhere Tarife ab 200K Tokens, und gemini-1.5-flash.yaml staffelt ab 128K Tokens. Langer Kontext wird nicht linear abgerechnet. Modelle ohne öffentliche Preisgestaltung nutzen einen Eintrag vom Typ Private Cost.
Ein benutzerbezogenes Budget funktioniert nur, wenn Anfragen zuverlässig zugeordnet werden. Drei Mechanismen stellen dies automatisch sicher, anstatt sich auf manuelle Disziplin bei der Entwicklung zu verlassen:
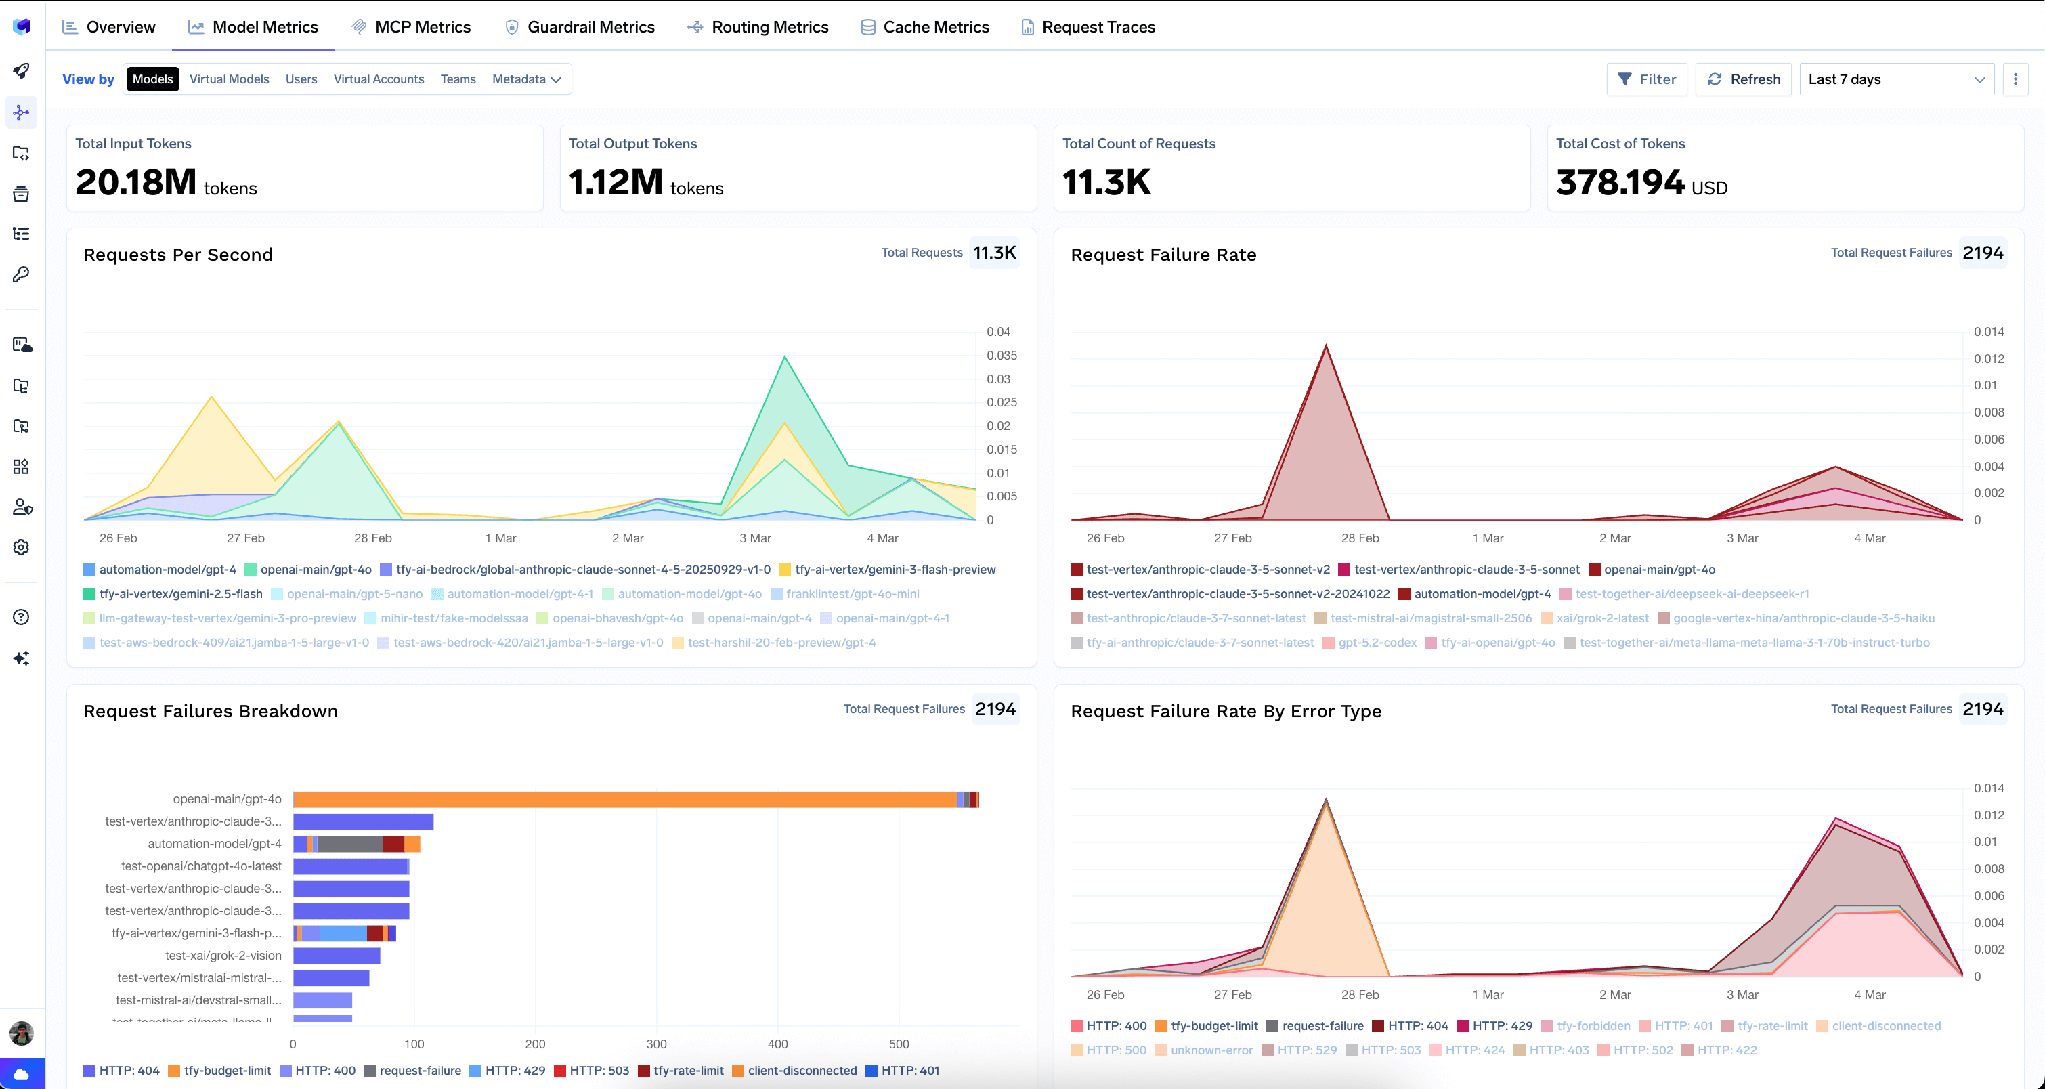
Model Metrics erfasst Total Input Tokens, Total Output Tokens und Total Cost of Tokens in USD. Diese Daten können über Metrics → 3 Punkte → Download Raw Data exportiert werden, gruppiert nach username, model_name oder teams:
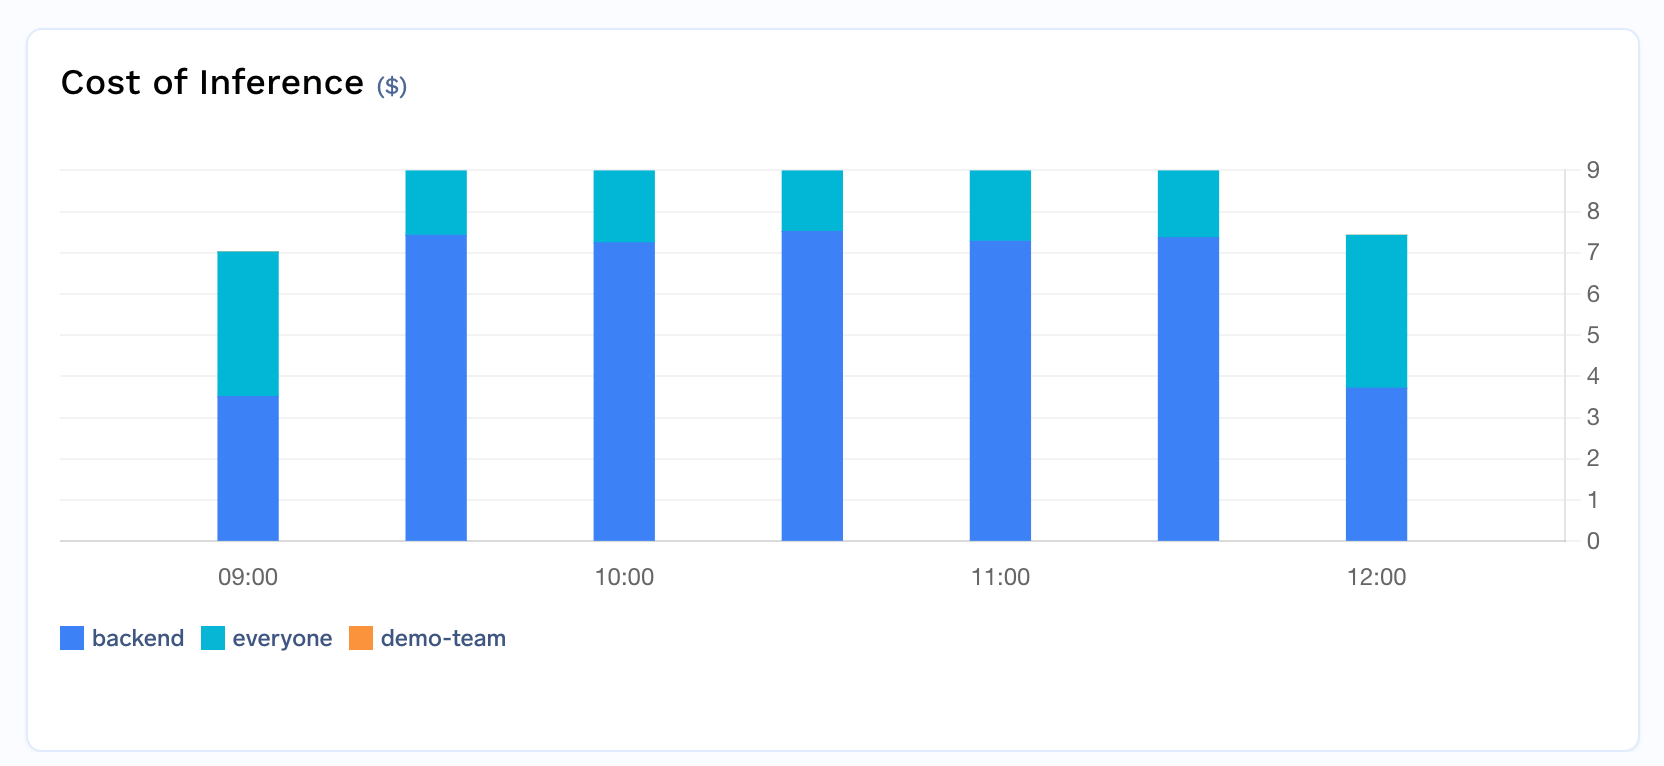
Ein Gateway, drei Gruppen: Ein kundenorientierter Assistent, ein interner Coding-Agent und ein Datenteam für Bulk-Extraktion – alle über ein einziges Provider-Konto. Der Coding-Agent hatte im letzten Monat einen fehlerhaften Nachmittag, woraufhin alle anderen Benutzer 429-Fehler erhielten.
Verhindern Sie Ressourcen-Engpässe. Das Problem war ein gemeinsamer Zähler, nicht ein fehlendes Limit. Platzieren Sie eine coding-agent-tpm-Regel (200.000 tokens_per_minute, subjects: ["virtualaccount:coding-agent"]) über einer allgemeinen tenant-wide-Regel (500.000 tokens_per_minute, when: {}). Versehen Sie die allgemeine Regel mit rate_limit_applies_per: ['virtualaccount'], damit der Agent nicht das Kontingent aller anderen verbraucht, indem er auf beide Regeln zutrifft. Fügen Sie außerdem eine requests_per_minute-Regel für dieselben Subjects hinzu: Fehlgeschlagene Anfragen werden für diese gezählt, jedoch nicht für die Token-Regel.
Fügen Sie die finanzielle Obergrenze hinzu. Ein monatliches Budget pro Benutzer für den Coding-Agenten mit einem Override für einen Entwickler sowie einer Lifetime-Obergrenze für das Extraktionsprojekt:
Beide Regeln werden bei jeder passenden Anfrage geprüft und beide müssen erfüllt sein. Der Override erweitert das Limit eines einzelnen Entwicklers, ohne die Vorgaben für andere zu lockern. Da er alle Zeiträume ersetzt, wiederholt er auch die der Basisregel.
Starten Sie im Audit-Modus, danach zuordnen. Führen Sie mode: audit eine Woche lang aus: Der Verbrauch wird erfasst und Benachrichtigungen werden ausgelöst, aber es wird nichts blockiert. Werten Sie die 75%-Warnungen aus, passen Sie die Einstellungen an den realen Traffic an und schalten Sie erst dann auf Durchsetzung um. Taggen Sie jeden Virtual Account und machen Sie die Teamauswahl bei PATs zur Pflicht – so erstellt sich der Bericht zur Kostenverteilung von selbst, genau der Zweck von Kostenattribution nach Teams.
Die beiden Systeme setzen Regeln in entgegengesetzter Logik durch. Rate Limiting funktioniert nach dem Prinzip „First-Match-Wins“; genau eine Regel blockiert. Budget V2 funktioniert nach dem Prinzip „All-Must-Pass“; jede passende Regel kann blockieren. Übertragen Sie nicht das mentale Modell des einen Systems auf das andere, da Ihre Policies sonst unerwartetes Verhalten zeigen.
Budgets können nicht in Tokens und Rate Limits nicht in Dollar definiert werden. Sie benötigen beides. Und die URL der Dokumentation lautet /ai-gateway/ratelimiting, in einem Wort – mit Bindestrich führt sie zu einem 404-Fehler.
Die Kostenerfassung für Audio ist eingeschränkter als für Tokens. Sie deckt ElevenLabs sowie Google Vertex Text-to-Speech und Speech-to-Text ab. Andere Audio-Provider erfassen zwar die Nutzung, jedoch keine Kosten pro Zeichen oder Sekunde. Private Audio-Preise werden nur für Google Vertex unterstützt. Speech-to-Text ohne vom Provider gemeldete Dauer wird mit null Kosten berechnet – ein Budget lässt daher unbegrenzten Traffic zu, den es als kostenlos einstuft.
Der Wechsel von Anfragen zu Tokens erfordert nur wenig Konfigurationsaufwand, hat aber große Auswirkungen. Ein Anfragenzähler zeigt Ihnen, wie ausgelastet Ihr System ist; ein Tokenzähler zeigt Ihnen, was Sie einkaufen; ein Budget zeigt Ihnen, wann Schluss ist.
Stimmt die Strukturierung der Ebenen, ergibt sich der Rest von selbst: Token-Limits glätten die Minute, Anfragen-Limits sichern den Pfad, Budgets steuern den Monat und ein Lifetime-Cap fängt den Rest ab. Das hier beschriebene Verhalten entspricht der TrueFoundry-Dokumentation mit Stand September 2026.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Dieselbe Idee – begrenzen, was ein Aufrufer in einem Zeitfenster verbrauchen darf –, aber die Einheit ändert sich. Klassisches API-Rate-Limiting zählt Anfragen, was funktioniert, wenn Anfragen ungefähr gleich viel kosten. LLM-Anfragen unterscheiden sich in der Token-Anzahl um Größenordnungen, sodass ein Token-Limit den tatsächlichen Verbrauch weit besser abbildet. Nutzen Sie beides: Tokens steuern die Ausgabenrate, Anfragen schützen die Verbindung vor Retry-Stürmen.
Beides. Ein Token-Limit ist eine Durchsatzkontrolle über ein rollierendes Zeitfenster: Es verhindert, dass ein Aufrufer gerade jetzt die Kapazität monopolisiert. Ein Budget ist eine Finanzkontrolle über einen Kalenderzeitraum: Es verhindert, dass ein Team in diesem Monat zu viel ausgibt. Ein Token-Limit kann keine Dollarbeträge ausdrücken, weil dieselbe Token-Anzahl bei verschiedenen Modellen unterschiedlich viel kostet – und ein Budget sagt nichts über die aktuelle Minute aus.
Eine fehlgeschlagene Anfrage – vom Gateway abgelehnt oder vom Anbieter mit einem 4XX oder 5XX beantwortet – zählt als eine Anfrage für jede requests_per_*-Regel, auf die sie zutraf. Die einzige Ausnahme ist eine Anfrage, die bereits vom Rate Limiting selbst mit einem 429 abgelehnt wurde. Token-Limits bleiben unberührt: Eine fehlgeschlagene Anfrage meldet keine Tokens.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Etwa 3–4 ms Overhead, bei mehr als 350 RPS auf einer einzelnen vCPU und über 1.000 unterstützten LLMs. Die Ausnahme ist der optionale LLM-Klassifikator, der vor der Weiterleitung der Anfrage einen echten Modellaufruf hinzufügt.
Ja. Das Gateway ist OpenTelemetry-konform und lässt sich an Grafana, Datadog oder Prometheus anbinden. Jeder Aufruf des LLM-Klassifikators erzeugt einen eigenen Span, sodass die Latenz des Klassifikators getrennt von der des ausgelieferten Modells sichtbar ist.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















