October 7, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Im Juni 2026 berichtete Yahoo Finance, dass Meta etwa 6.000 Mitarbeitern in einem internen Memo mitgeteilt hatte, die Überwachung ihrer KI-Token-Nutzung zu verschärfen und Ausgabenkontrollen einzuführen – nur Wochen nachdem das Unternehmen dieselben Mitarbeiter dazu ermutigt hatte, KI verstärkt zu nutzen. Diesen Berichten zufolge steuert allein die interne KI-Nutzung bei Meta im Jahr 2026 auf Kosten in Milliardenhöhe zu. Innerhalb weniger Wochen wurde berichtet, dass Amazon seine interne Bestenliste zur KI-Nutzung abgeschaltet hat, und es wurde berichtet, dass Uber sein gesamtes geplantes KI-Programmierbudget für 2026 bereits in den ersten vier Monaten des Jahres aufgebraucht hatte. Die Presse prägte einen Namen für diese Kehrtwende: Token-Minimierung.
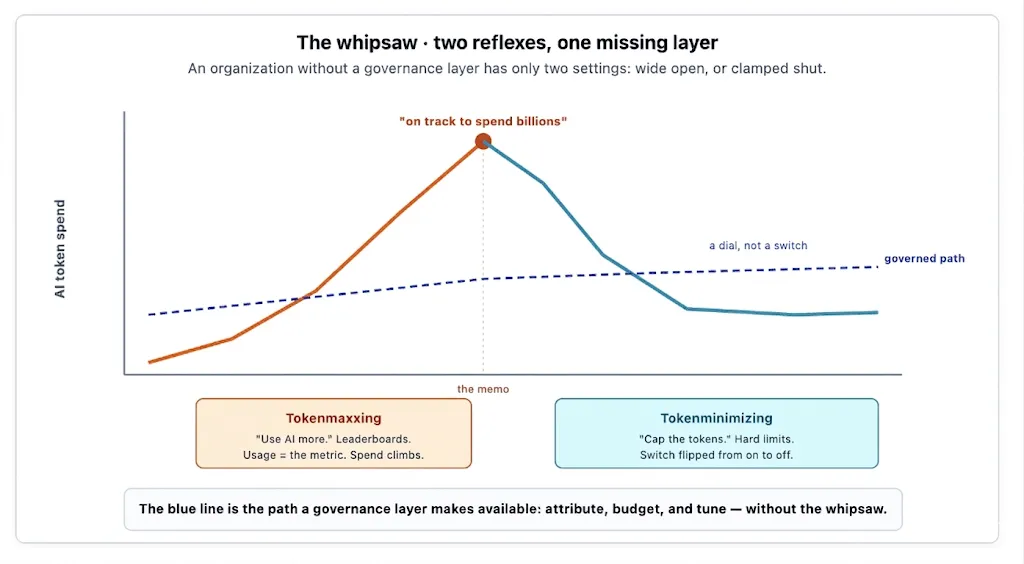
Dies ist der Anhang, den die Token-Maximierungs-Trilogie schon immer gebraucht hätte. Die Trilogie argumentierte – noch bevor die Reaktion einsetzte –, dass das Feiern des Token-Verbrauchs das Falsche misst und dass eine Organisation ohne Governance-Ebene am Ende nur zwei Einstellungen kennt: weit offen oder komplett abgeriegelt. Die Reaktion der Token-Minimierung ist die zweite Einstellung. Der Punkt dieses Beitrags ist nicht, dass die Vorhersage korrekt war; es geht darum, dass beide Einstellungen derselbe Fehler sind. Die aktuelle Berichterstattung über drei große Technologieunternehmen verdeutlicht dies innerhalb eines einzigen Quartals, und es gibt eine dritte Option, die dieses Hin und Her überflüssig macht.
Die hier genannten Fakten stammen vollständig aus veröffentlichten Berichten, und wir führen jede Behauptung auf ihre Quelle zurück, anstatt sie unabhängig aufzustellen. Wir nennen diese Unternehmen nur, weil ihre internen Schritte durch diese Berichterstattung öffentlich wurden; wir stellen keine unabhängigen Behauptungen über die internen Abläufe eines Unternehmens auf, die über das hinausgehen, was diese Medien veröffentlicht haben.
Meta. Wie Yahoo Finance berichtete (unter Wiederveröffentlichung eines Berichts von StockTwits über ein Memo, das The Information vorlag), teilte Meta etwa 6.000 Mitarbeitern mit, dass das Unternehmen Ausgabenkontrollen, Budgets und Nutzungslimits einführen werde, da die internen KI-Kosten 2026 voraussichtlich in die Milliarden gehen werden. Laut diesem Bericht hatten Mitarbeiter und Teams nur begrenzten Einblick in ihren eigenen Verbrauch, und das Unternehmen plant, bis 2027 zu einem strukturierten Rahmenwerk für Budgets und Zuweisungsentscheidungen überzugehen. Um dies zu erreichen, so der Bericht, hat Meta ein zentrales Dashboard namens „AI Gateway“ entwickelt, um Nutzung und Ausgaben an einem Ort zu verfolgen, inklusive automatisierter Warnmeldungen bei ungewöhnlichen Spitzen. Dieses Detail ist bemerkenswert: Ein Unternehmen von Metas Größe, das das Maximierungsexperiment durchgeführt hat, baut Berichten zufolge genau die Kategorie von System – Echtzeit-Attribution, Ausgabenverfolgung, Spitzen-Warnungen, strukturierte Budgets –, von der diese Serie von Anfang an argumentiert hat, dass sie in den Anforderungspfad gehört.
Amazon. Wochen zuvor, wie TheStreet und weitere Quellen berichteten (unter Berufung auf die Financial Times, die die Geschichte zuerst aufgriff), dass Amazon eine interne Rangliste namens „KiroRank“ abgeschafft hat, in der Mitarbeiter nach ihrer KI-Aktivität auf der Entwicklerplattform Kiro bewertet wurden. Diesen Berichten zufolge hatten Mitarbeiter ihre Punktzahlen in die Höhe getrieben, indem sie minderwertige Aufgaben durch KI-Agenten ausführten, um in der Rangliste aufzusteigen – ein Verhalten, das in der Branche inzwischen als „Tokenmaxxing“ bezeichnet wird –, was die Rechenkosten in die Höhe trieb. Wie berichtet wird, ersetzte Amazon die Rangliste durch eine Kennzahl namens „normalisierte Bereitstellungen“, also KI-gestützter Code, der tatsächlich veröffentlicht wird. Ein leitender Angestellter soll die Mitarbeiter angewiesen haben, KI nicht nur um der KI willen zu nutzen. Dieser Ersatz ist die von Amazon selbst konkret umgesetzte Korrektur vom Input zum Output: Aufhören, verbrauchte Token zu zählen, und anfangen, die tatsächlich geleistete Arbeit zu zählen.
Uber. Und wie im selben Yahoo-Finance-Bericht und bereits zuvor bei Business Insidererwähnt, soll Uber sein gesamtes geplantes KI-Programmierbudget für 2026 bereits in den ersten vier Monaten des Jahres ausgeschöpft haben; derselbe Bericht merkt an, dass der COO von Uber erklärte, das Unternehmen habe keinen klaren Zusammenhang zwischen höheren KI-Ausgaben und tatsächlich gelieferten Ergebnissen feststellen können. Drei Unternehmen, drei verschiedene Mechanismen, ein Quartal, dasselbe Muster.
Die Begriffe „Tokenmaxxing“ und „Tokenminimizing“ lassen es so klingen, als handele es sich um zwei Trends. Es ist hilfreicher, sie als ein Muster mit zwei Phasen zu betrachten, das nun bei drei verschiedenen Unternehmen sichtbar ist: Die Einführung wird ohne eine darunter liegende Governance-Ebene gefördert, die Nutzung wird zur sichtbaren Kennzahl, die Kosten überraschen die Führungsebene und der einzige verfügbare Hebel ist ein stumpfes Instrument.
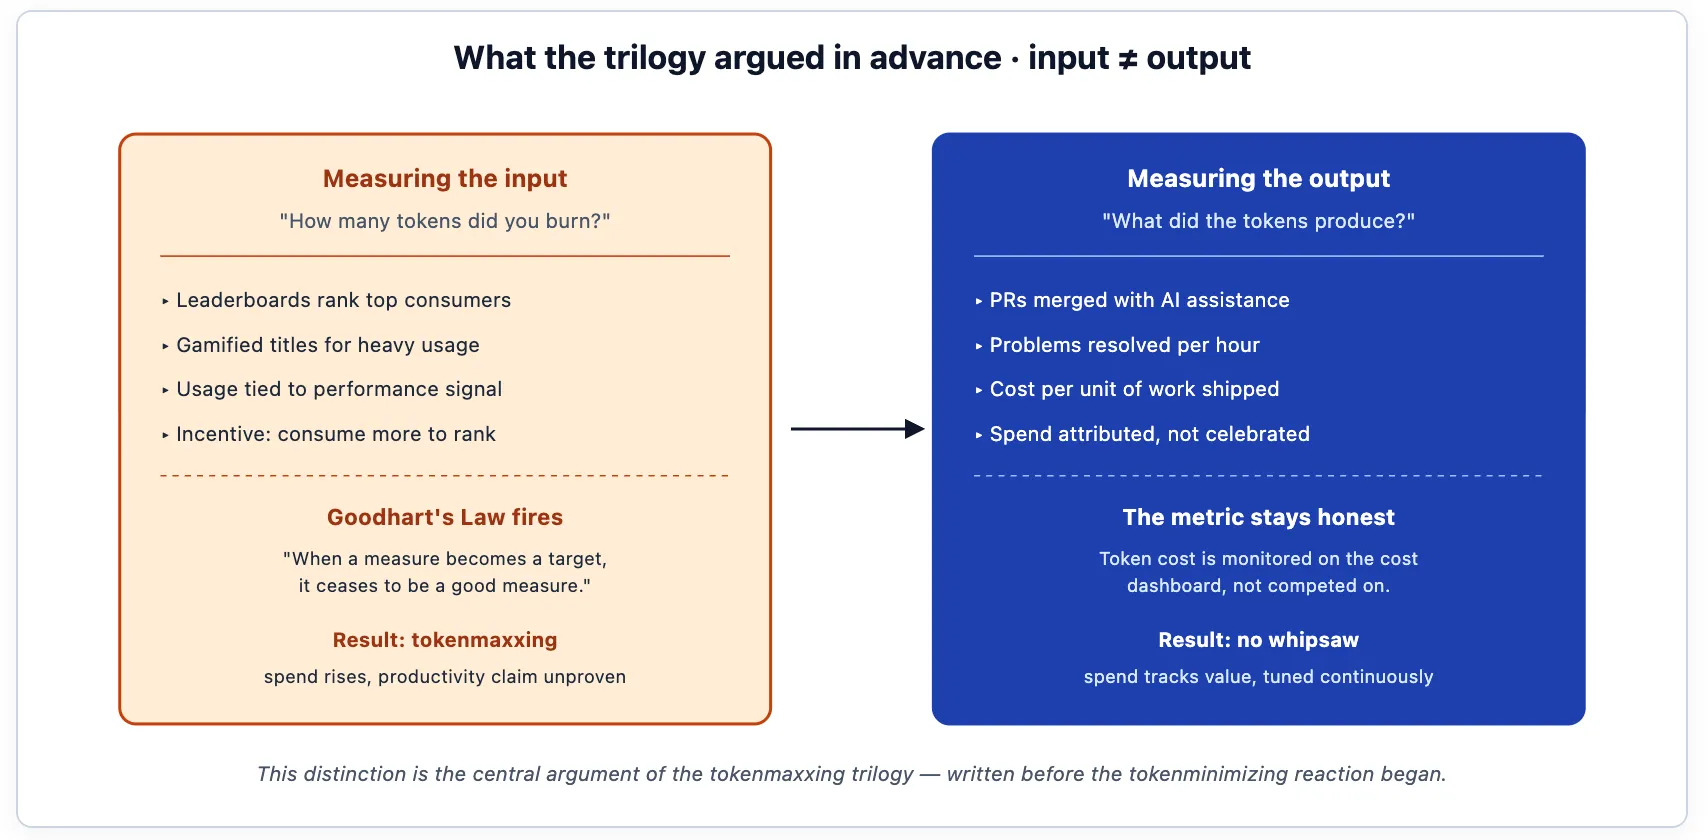
Die Tokenmaxxing-Trilogie (alle Links finden sich in den Referenzen) war kein Loblied auf den Token-Verbrauch. Sie war eine Kritik daran. Das zentrale Argument, das in allen drei Teilen vorgebracht wurde, ist die Unterscheidung zwischen Input und Output: Token sind etwas, das man ausgibt, und die Arbeit, die diese Token hervorbringen, ist das, was tatsächlich zählt. Eine Rangliste, die Mitarbeiter nach verbrauchten Token bewertet, misst den Input und belohnt dessen Maximierung – und in dem Moment, in dem eine Messgröße zum Ziel wird, hört sie gemäß dem Gesetz von Goodhart auf, eine gute Messgröße zu sein. Die Trilogie sagte dies deutlich, während die Maxxing-Phase noch in vollem Gange war und die vorherrschende Stimmung steigende Token-Grafiken als eindeutigen Beweis für Produktivität wertete.
Das ist der Punkt, bei dem man präzise sein muss, denn es ist leicht, diesen Beitrag als Siegeszug misszuverstehen. Das ist er nicht. Die Trilogie hat nicht vorhergesagt, dass ein bestimmtes Unternehmen im Juni 2026 ein Memo verschicken würde. Sie lieferte ein strukturelles Argument – dass die Messung des Inputs zwangsläufig zu einer schmerzhaften Korrektur führen würde –, und genau dieses strukturelle Argument wird nun durch die Berichterstattung über mehrere Unternehmen hinweg illustriert. Die Bemerkung, die Meta-CTO Andrew Bosworth in der Berichterstattung von MLQ zugeschrieben wird – dass die Token-Nutzung allein kein Maß für die Wirkung ist –, liest sich wie die These der Trilogie in den Worten eines CTOs, zu der er Berichten zufolge unabhängig unter dem Druck einer Milliarden-Dollar-Prognose gelangte. Und der Fall Amazon wurde in der Branchenberichterstattung als ein Lehrbuchbeispiel für das Gesetz von Goodhartbeschrieben: In dem Moment, in dem der Token-Verbrauch zum Ziel einer Rangliste wurde, so das Argument, hörte er auf, Produktivität zu messen, und begann, Wettbewerbsangst zu messen. Das ist das Argument der Trilogie fast wortwörtlich, zu dem Beobachter unabhängig voneinander gelangten, während sie dasselbe Scheitern verfolgten.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet