



October 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 10, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Der Aufsatz von Anthropic aus dem September 2025 über Kontext-Engineering hat die Disziplin neu definiert: weg von der Wahl der richtigen Worte für einen einzelnen Prompt, hin zur Entscheidung, welche Informationen sich bei jedem Schritt der Arbeit eines Agenten im Kontextfenster befinden sollten. Dieser Beitrag befasst sich mit der Infrastruktur, die diese Entscheidungen auf Gateway-Ebene umsetzt. Sitzungsverfolgung, Konversationskomprimierung und Präfix-Caching sind die Grundbausteine auf Gateway-Ebene, die Kontext-Engineering in der Produktion erst ermöglichen – nicht als Strategie (das ist Aufgabe des Agenten), sondern als Substrat, das diese Strategie über Tausende von lang laufenden Prozessen hinweg durchsetzbar macht.
Freitagnachmittag bei Northwind. Maya, Staff Engineer im Plattform-Team, öffnet den Slack-Thread mit dem Titel „#agent-help: code-review is failing on big PRs“. Sie findet die Ursache für den Fehler in PR #4127 – einem Refactoring von 600 Zeilen. Der Agent führte 23 Tool-Aufrufe aus: Er las vier Dateien, führte die Test-Suite zweimal aus, fragte den Linter ab und rief die Coverage ab. Im 24. Schritt gab das Modell eine Antwort zurück, die denselben Absatz dreimal wiederholte und mitten im Satz abbrach.
Die Sitzungsansicht des Gateways zeigt den entscheidenden Hinweis. Zum Zeitpunkt des Fehlers war das Request-Payload auf über 185.000 Token bei einem Modell mit 200.000 Kontext-Token angewachsen – allein die beiden Test-Suite-Durchläufe hatten jeweils zehntausende Token hinzugefügt. Der Agent bemerkte nie, dass ihm der Platz ausging; er fügte dem Konversations-Array weiterhin Tool-Ergebnisse hinzu, bis das Aufmerksamkeitsbudget des Modells erschöpft war.
Die Lösung ist meist kein intelligenteres Basismodell. Es ist eine Infrastruktur, die verhindert, dass der Agent sein Kontextbudget aufbraucht – und aus „wir haben versehentlich das Kontextfenster gefüllt“ ein „das Gateway hat bei der 150.000-Token-Schwelle komprimiert und der Agent konnte weiterarbeiten“ macht. Dieser Beitrag erklärt, wie diese Infrastruktur funktioniert.
In vielen Anwendungen der Ära 2023 bedeutete Prompt-Engineering die Wahl der richtigen Formulierung, Beispiele und Reihenfolge, um eine einzelne Antwort zu optimieren. Kontext-Engineering, wie Anthropic es in ihrem Aufsatz vom September 2025beschreibt, ist der Nachfolger – es stellt die Frage, welche Kontextkonfiguration am ehesten das gewünschte Modellverhalten über den gesamten Ablauf eines Agenten hinweg erzeugt, nicht nur bei einem einzelnen Aufruf.
Dieser Wandel ist wichtig, da lang laufende Agenten Zustände ansammeln. Jedes Tool-Ergebnis, jede vorherige Modellantwort und jede Benutzerreaktion befindet sich entweder im Kontextfenster oder nicht. Das Modellverhalten verschlechtert sich – „Kontext-Verfall“ in der Terminologie von Anthropic – lange bevor das nominelle Kontextlimit erreicht ist, wobei die genaue Kurve der Verschlechterung vom Modell, der Aufgabe und der Position der relevanten Informationen im Fenster abhängt. Der Agent muss also Entscheidungen treffen: Was soll behalten, was zusammengefasst, was verworfen, wofür soll der volle Preis gezahlt und was soll zwischengespeichert werden? Diese Entscheidungen liegen beim Agenten. Die Mechanismen zu deren Ausführung liegen beim Gateway – der Schicht, die in TrueFoundrys AI Gatewaybereits bei jedem Aufruf aktiv ist: einen Request mit einer Konversations-ID versehen, berechnen, welcher Anteil des Kontexts System-Prompt und welcher wachsende Historie ist, den Komprimierungs-Endpunkt bei Erreichen eines Schwellenwerts aufrufen, das Präfix-Cache nutzen, anstatt für denselben 12.000-Token-System-Prompt bei jedem Aufruf zu bezahlen. Der Agent entscheidet über die gewünschte Kontextkonfiguration; das Gateway implementiert diese Konfiguration effizient. Der Rest dieses Beitrags behandelt diese Mechanismen.
Ein einzelner Agenten-Durchlauf besteht aus vielen Provider-Aufrufen. Ein Code-Review-Agent, der einen PR bearbeitet, führt möglicherweise 10–30 davon aus – einen zur Planung, mehrere zum Lesen von Dateien, mehrere zum Ausführen von Tests, einen zum Entwurf des Reviews, einen zur Überarbeitung nach einem Tool-Fehler. Ohne Sitzungs-Metadaten sieht der Trace-Speicher 30 unzusammenhängende Requests; mit ihnen sieht er eine 30-stufige Konversation, die von Anfang bis Ende nachvollzogen werden kann.
Die Konvention ist ein Header, der vom Agenten beim äußeren Aufruf gesetzt wird. In TrueFoundrys AI Gateway ist dies der Header X-TFY-CONVERSATION-ID – das Präfix X-TFY- ist der Namespace von TrueFoundry, gepaart mit dem Header X-TFY-METADATA aus dem Beitrag zur Kostenattribuierung. Betrachten Sie den spezifischen Namen als anschauliche Gateway-Konvention und nicht als Industriestandard; der entsprechende Header könnte beliebig benannt sein. Wichtig ist nur, dass der Wert durch den Span-Tree propagiert wird:
HTTP – die Anwendung markiert jeden Schritt eines Multi-Turn-Agenten mit einer Konversations-ID
POST /v1/responses HTTP/1.1
Host: gateway.northwind.internal
Authorization: Bearer ...
Content-Type: application/json
X-TFY-CONVERSATION-ID: conv-pr-4127-review-2026-05-22-14-03
X-TFY-METADATA: {"team": "platform-eng", "app": "code-review-agent",
                 "feature": "pr-review", "env": "production",
                 "pr_id": "northwind/cargo-copilot#4127"}

{"model": "claude-sonnet-4-6", "input": [...], "tools": [...]}
Was das Gateway pro Sitzung aufzeichnet: die geordnete Abfolge von Provider-Aufrufen innerhalb der Konversation samt Trace-IDs; kumulative Eingabe-, Ausgabe-, Cache-Lese- und Cache-Schreib-Token, sowohl pro Turn als auch über die gesamte Konversation hinweg; die Metadatenfelder jedes Aufrufs (unter Beibehaltung des Kosten-Attributionsschemas aus dem vorherigen Beitrag); sowie Referenzen auf Trace-IDs anstelle des vollständigen Textes – das gerenderte Kontextfenster verbleibt beim Provider, der Sitzungsdatensatz bleibt klein.
Dies ist für das Debugging entscheidend. Ein Agent mit 20 Turns, der bei Turn 15 fehlschlägt, lässt sich nicht als 20 isolierte Anfragen debuggen. Er muss als Sequenz betrachtet werden: Turn 14 lieferte ein Tool-Ergebnis, das das fehlerhafte Verhalten in Turn 15 auslöste; die Eingabe in Turn 13 erreichte bereits 95 % des Kontextlimits. Die Sitzungsansicht fasst 20 Traces in einer abfragbaren Timeline zusammen, inklusive kumulativer Token-Anzahl, Latenzprofil und Cache-Trefferraten pro Turn.
Das Kontextfenster eines Coding-Agenten wächst nach einem vorhersehbaren Muster. Gehen wir für das untenstehende vereinfachte Modell von einem System-Prompt mit 12.000 Token (Tool-Definitionen, Styleguide, Beispiele) bei Turn 0 aus und davon, dass jeder weitere Turn etwa 6.000 gerenderte Token hinzufügt – bestehend aus einem Tool-Ergebnis, der Antwort des Assistenten und dem Overhead pro Turn. Dies ergibt einen linearen Anstieg von etwa 6.000 Token pro Turn (tatsächliche Abläufe sind sprunghafter; siehe Hinweis unter der Tabelle):
Was passiert, wenn sich das Fenster füllt, ist nicht direkt ein Ausfall, sondern eine Verschlechterung. Die Genauigkeit des Modells bei der Informationsbeschaffung und Befolgung von Anweisungen lässt oft schon deutlich vor dem nominalen Limit nach. Schlimmer noch: Das Modell gibt kein Signal, dass die Qualität abgenommen hat – es liefert selbstbewusste, gut formatierte Ausgaben, die schlichtweg falsch sind. Wenn das Fenster voll ist, neigt das Modell eher dazu, zu halluzinieren, sich zu wiederholen, Anweisungen zu ignorieren oder fehlerhafte Tool-Aufrufe zu tätigen. Diese Verschlechterung verläuft graduell, nicht abrupt. Wann sie einsetzt, hängt vom Modell, der Aufgabe und der Position der relevanten Token ab – doch die betriebliche Konsequenz bleibt dieselbe: Die Infrastruktur muss handeln, bevor das Verhalten kollabiert, nicht danach. (Die obige Tabelle ist ein illustratives lineares Modell; reale Coding-Agent-Abläufe sind typischerweise sprunghafter – ein einzelner Grep über eine große Codebasis oder ein ausführlicher Testlauf können in einem einzigen Turn 20.000 Token hinzufügen.)
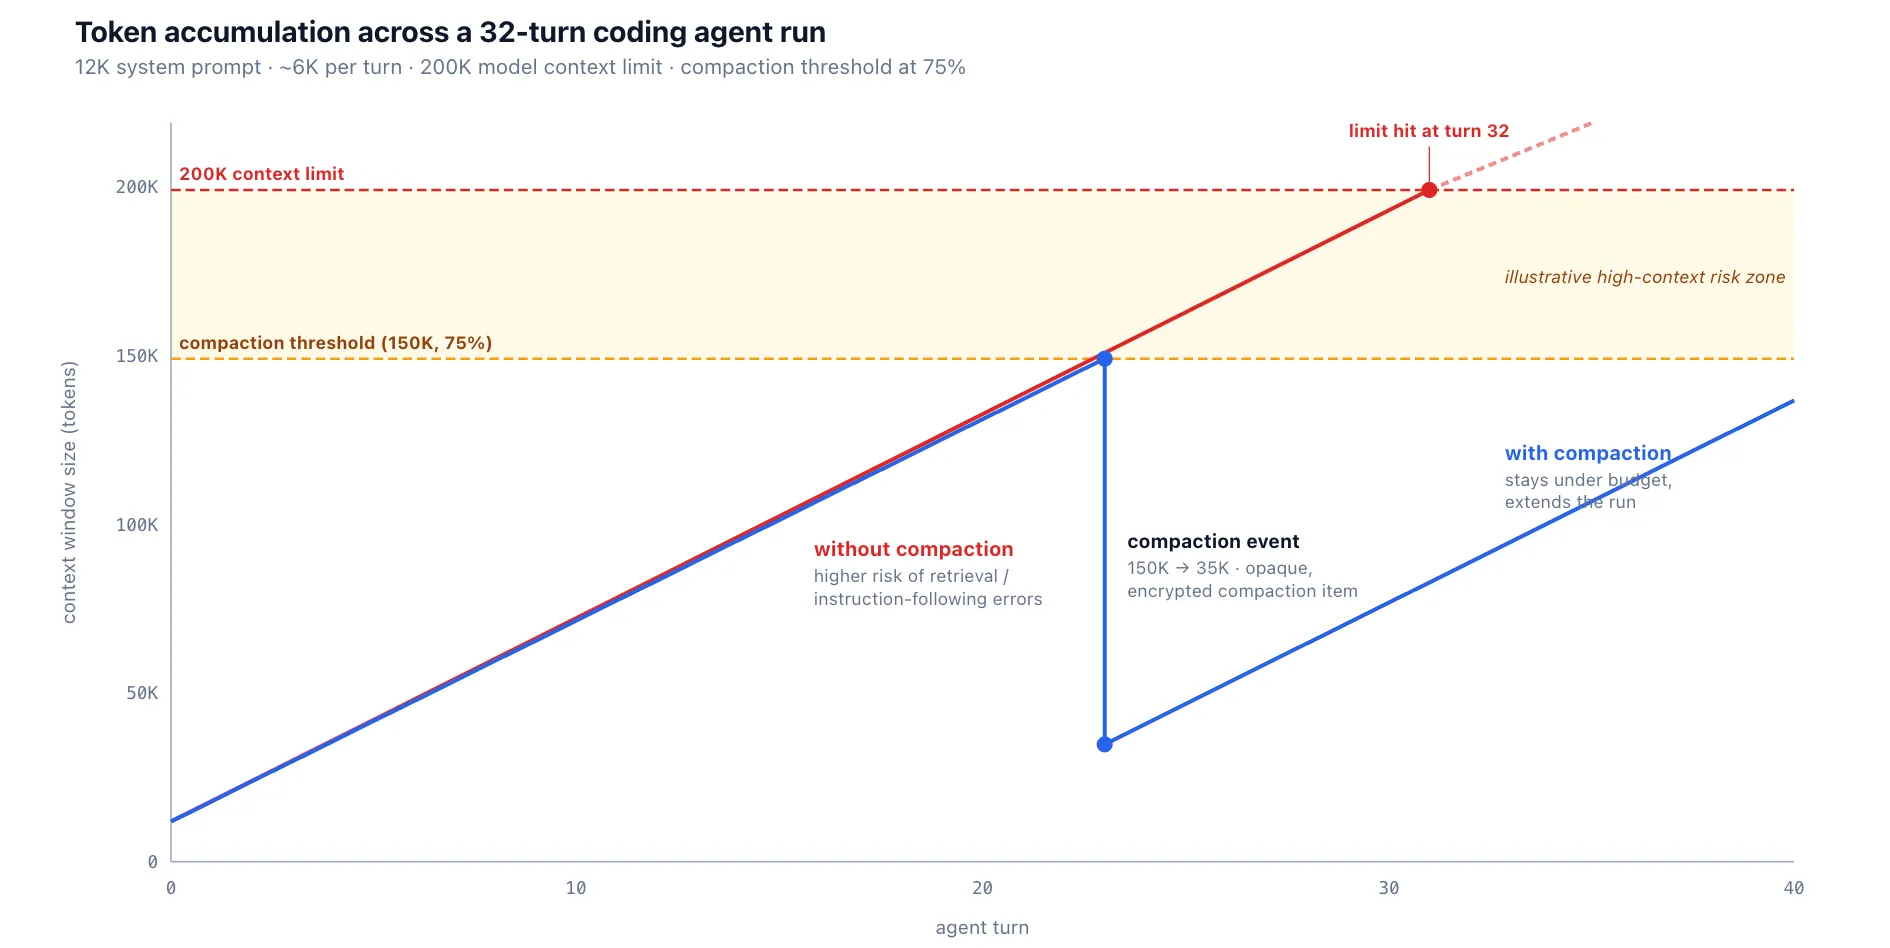
Der Agent könnte entscheiden, gar nicht erst so groß zu werden – alte Tool-Ergebnisse löschen, Zusammenfassungen auf die Festplatte schreiben oder für jeden Tool-Aufruf Sub-Agenten mit frischem Kontext starten. Das sind legitime Strategien, die in den Verantwortungsbereich des Agenten fallen. Die Rolle des Gateways besteht darin, die Alternative – die Kompaktierung – so einfach wie möglich konsistent anwendbar zu machen: sie zu routen, zu beobachten, ihre Auswirkungen auf Token und Latenz zuzuordnen und Richtlinien für den Auslösezeitpunkt durchzusetzen. In TrueFoundrys AI Gatewaystammen die Token-Zahlen pro Turn, die diese Tabelle real machen, aus demselben Sitzungs-Rollup, das den Fehler in der Einleitung aufgedeckt hat – die Akkumulation ist etwas, das man beim Wachsen beobachten kann, nicht etwas, das man erst entdeckt, nachdem das Modell versagt hat.
Die OpenAI Responses API unterstützt Kompaktierung als erstklassiges Primitiv in zwei Modi.
Standalone (explizit). Die Anwendung erkennt das Kontextwachstum, ruft POST /v1/responses/compact mit der vollständigen Konversation als Eingabe auf und erhält ein neues, kompaktiertes Kontextfenster. Der nächste /responses-Aufruf verwendet dieses zurückgegebene Fenster anstelle der vorherigen Konversationshistorie – es wird unverändert weitergegeben, da es den vom Modell benötigten Status enthält (und möglicherweise einige frühere Elemente neben dem Kompaktierungselement beibehält).
Python – explizite Kompaktierung nach Entscheidung der Anwendung
from openai import OpenAI
client = OpenAI()

# Up to this point the agent has been appending tool results to `conv`.
# `conv` is now a long list of items totaling ~150K rendered tokens.
compacted = client.responses.compact(
    model="gpt-5.5",
    input=conv,             # the full pre-compaction conversation
)

# The returned window is the canonical next context. Pass it as-is — it
# generally holds more than just the compaction item (it can retain earlier
# items too), and the docs say not to prune it.
next_input = [
    *compacted.output,
    {"type": "message", "role": "user", "content": new_user_msg},
]

response = client.responses.create(
    model="gpt-5.5",
    input=next_input,
    tools=tools,
    store=False,            # ZDR-friendly — set on create, not on compact
)
Server-side (automatisch). Die Anwendung fügt context_management mit einem compact_threshold in die ursprüngliche /responses-Anfrage ein. Wenn die Anzahl der gerenderten Token während des Streams den Schwellenwert überschreitet, kompaktiert der Server in-band, gibt ein verschlüsseltes Kompaktierungselement im Antwort-Stream aus und setzt die Inferenz ohne separaten Round-Trip fort.
Python – automatische serverseitige Kompaktierung via context_management
response = client.responses.create(
    model="gpt-5.5",
    input=conversation,
    tools=tools,
    store=False,
    context_management=[
        {"type": "compaction", "compact_threshold": 150_000}
    ],
)

# Append all output items as usual. If the server compacted mid-stream, the
# compaction item is included among them.
conversation.extend(response.output)

# Latency tip: after appending, you may drop items before the most recent
# compaction item to keep the next request smaller. (Skip this if you chain
# with previous_response_id — let the server prune.)
last_compaction = None
for i, item in enumerate(conversation):
    if getattr(item, "type", None) == "compaction":
        last_compaction = i
if last_compaction is not None:
    conversation = conversation[last_compaction:]

conversation.append(
    {"type": "message", "role": "user", "content": new_user_msg}
)
Das Kompaktierungselement selbst ist für den Client undurchsichtig. Sie können es weder auslesen noch bearbeiten oder seinen Inhalt einsehen. Es führt den Status und die Schlussfolgerungen mit, die das Modell zum Fortfahren benötigt, und ist deutlich kleiner als die ursprüngliche Konversation. Es ist ZDR-kompatibel, wenn store=false in der ursprünglichen Anfrage gesetzt ist.
Zwei Chaining-Muster nach erfolgter Kompaktierung. Stateless Input-Array-Chaining: Hängen Sie die Ausgabe-Elemente (einschließlich des Komprimierungselements) an das nächste Eingabe-Array an und verwerfen Sie Elemente vor dem aktuellsten Komprimierungselement, um die Anfragen klein zu halten. Verkettung von previous_response_id: Übergeben Sie in der nächsten Anfrage nur die neue Benutzernachricht und lassen Sie den Server den vorherigen Status auflösen. Die erste Methode gibt der Anwendung die explizite Kontrolle über die übertragenen Daten; die zweite lagert dies aus. Für ZDR-sensitive Workloads ist der zustandslose Modus mit store=false das Standardmuster. In jedem Fall bleibt die Komprimierung ein Feature des Anbieters; Das Gateway von TrueFoundry leitet den Aufruf weiter und protokolliert ihn auf der Sitzungs-Timeline, sodass der Token-Wegfall ein nachvollziehbarer Schritt ist, den Sie dem Komprimierungsaufruf zuordnen können, anstatt eines unerklärlichen Abfalls im Konversations-Array.
Bei den meisten produktiven Agenten sind nicht die wachsenden Konversationen der Hauptkostenfaktor, sondern der System-Prompt, der bei jedem Aufruf unverändert mitgesendet wird. Ein 12.000-Token-System-Prompt kostet bei der Preisgestaltung von Claude Sonnet 4.6 (3 $ pro Million Eingabe-Token) ohne Caching 0,036 $ pro Aufruf. Bei 1.000 Aufrufen pro Stunde sind das 36 $/Stunde allein für die unveränderlichen Anweisungen. Über ein Jahr hinweg belaufen sich die Kosten für einen einzigen produktiven Agenten allein für den System-Prompt auf rund 315.000 $.
Anbieterseitiges Präfix-Caching ist die Lösung. Anthropic ermöglicht dies über cache_control-Breakpoints im Prompt; OpenAI wendet es automatisch bei Präfix-Übereinstimmungen von 1.024 Token oder mehr an. Da der Abgleich auf dem exakten Präfix basiert, gilt bei beiden Anbietern die gleiche praktische Regel: Platzieren Sie den stabilen Inhalt (System-Prompt, Tool-Definitionen) zuerst und den variablen Inhalt (die Eingabe des Benutzers) zuletzt, damit der cachefähige Kopf über alle Aufrufe hinweg Byte-identisch bleibt. Die Wirtschaftlichkeit bei Anthropic ist explizit: Cache-Lesezugriffe werden mit 10 % der Eingaberate berechnet (0,30 $ pro Million für Sonnet 4.6); der erste Aufruf, der den Cache erstellt, zahlt einen Aufschlag von 25 % für die 5-minütige TTL oder 100 % für die 1-stündige TTL.
JSON — Anthropic cache_control-Breakpoint für den System-Prompt
{
  "model": "claude-sonnet-4-6",
  "system": [
    {
      "type": "text",
      "text": "<12,000 tokens of tool definitions, style guide, examples>",
      "cache_control": {"type": "ephemeral"}
    }
  ],
  "messages": [
    {"role": "user", "content": "Review PR #4127"}
  ]
}
Die Wirtschaftlichkeit bei einem 12K-System-Prompt × 1.000 Aufrufe/Stunde mit einer Warm-Hit-Rate von 85 % (Cache-Miss beim Kaltstart, Cache-Read beim Warmstart):
Eine Senkung von 36 $/Stunde auf 9,81 $/Stunde ist der entscheidende Unterschied, der Prompt-Präfix-Caching zur ersten Optimierung macht, zu der Teams bei lang laufenden Agenten-Workloads greifen. Der Mechanismus folgt dem zentralen ökonomischen Prinzip des Prompt-Cachings: Stabiler Kontext sollte wiederverwendet statt bei jeder Anfrage neu verarbeitet werden – das Gateway macht die Durchsetzung operativ trivial. Die Cache-Read- und Cache-Write-Token landen in derselben nutzungsbasierten Abrechnung pro Aufruf, die das Gateway von TrueFoundry bereits für die Kosten zuordnet. Der oben genannte Rabatt ist also etwas, das Sie anhand Ihres eigenen Traffics in der Kostenübersicht aus dem vorherigen Beitrag verifizieren können, und nicht nur eine grobe Schätzung.
Komprimierung erhöht die Latenz; Cache-Lesezugriffe nicht. Diese Asymmetrie bestimmt die produktiven Heuristiken.
Ein eigenständiger Aufruf von /v1/responses/compact ist ein synchroner Round-Trip – er muss die gesamte Eingabe lesen, einen anbieterseitigen Komprimierungsvorgang mit seinen eigenen Latenz- und Kostenmerkmalen ausführen und das komprimierte Fenster zurückgeben. Bei einer Eingabe von 150.000 Token kann dies zu einer spürbaren Latenz führen; messen Sie dies anhand Ihrer eigenen Traces, bevor Sie Schwellenwerte festlegen. Der Agent pausiert während dieser Zeit.
Serverseitige Komprimierung ist besser, aber nicht kostenlos. Der Komprimierungsvorgang erfolgt im Stream während des nächsten /responses-Aufrufs, sodass die TTFT für diesen Aufruf sowohl den Komprimierungs-Overhead als auch die normale Inferenzzeit umfasst. Wenn die Komprimierung bei jedem Überschreiten des Schwellenwerts bei einem stark ausgelasteten Agenten ausgelöst wird, wird die für den Benutzer sichtbare TTFT bimodal: Die meisten Durchläufe sind schnell, einige sind spürbar langsam. Da das Gateway von TrueFoundry die Latenz jedes Aufrufs im Sitzungs-Trace aufzeichnet, ist dieses bimodale Muster direkt in der Ansicht der Anfrage-Traces sichtbar – die langsamen Durchläufe sind diejenigen, die den Komprimierungs-Overhead tragen. Dies ermöglicht es Ihnen, den Schwellenwert anhand realer Zahlen anzupassen, anstatt zu raten.
Zwei Heuristiken, die in der Produktion wichtig sind:
Kompaktieren Sie proaktiv, nicht reaktiv. Wenn die Kompaktierung erst bei Erreichen des tatsächlichen Kontextlimits ausgelöst wird, hat der Agent seine letzten Runden bereits im Risikobereich verbracht, in dem die Qualität tendenziell nachlässt. Setzen Sie den Schwellenwert deutlich unter das Limit – üblicherweise bei 75 % –, damit der Agent weniger Zeit in diesem Bereich verbringt. Bei einem Modell mit 200.000 Token Kontext entspricht dies einem Schwellenwert von 150.000.
Kompaktieren Sie keine kurzen Konversationen. Bei einer Aufgabe mit 5 Runden, die maximal 30.000 Token erreicht, übersteigt der Kompaktierungsaufwand den Nutzen – die Kosten für den Roundtrip sind real, auch wenn die Inferenz gering ist. Ein sinnvoller Mindestwert: Kompaktieren Sie niemals unter ca. 75.000 Token oder vor der 10. Runde, je nachdem, was zuerst eintritt. Unterhalb dieser Schwelle ist selbst ein vollständiger Kontextdurchlauf im schlimmsten Fall günstiger als ein Kompaktierungs-Roundtrip.
Ein praktischer Standardwert für eine produktive Agentenplattform: ein compact_threshold bei 75 % des Modell-Kontextlimits mit einer Mindestgrößen-Absicherung bei ca. 75.000 Token, implementiert durch serverseitige Kompaktierung mit zustandsloser Verkettung.
Kompaktierung ist zudem nur ein Werkzeug unter vielen und nicht immer das richtige. Die Wahl hängt von der Art der Aufgabe ab:
Diese Methoden ergänzen sich, anstatt zu konkurrieren – ein produktiver Agent speichert oft seinen System-Prompt zwischen, ruft Daten aus einem Korpus ab, schreibt Notizen auf die Festplatte und kompaktiert die verbleibende Konversation. Die Rolle des Gateways ist bei all diesen Vorgängen dieselbe: jeden Schritt beobachtbar und zuordenbar zu machen, anstatt eine Auswahl für den Agenten zu treffen.
Die Verbindung zwischen den Prinzipien des Kontext-Engineerings und den konkreten Gateway-Primitiven ist direkt:
Das Gateway trifft keine Entscheidungen zum Kontext-Engineering. Es macht diese implementierbar, debuggbar und einheitlich über alle Anbieter hinweg, mit denen der Agent kommuniziert – genau dafür ist ein KI-Gateway wie TrueFoundry da: ein zentraler Ort, an dem Sitzungsgruppierung, Transparenz über das Token-Budget und Kostenzuordnung identisch angewendet werden, egal ob der Agent mit OpenAI oder Anthropic kommuniziert.
Müssen wir die Responses API verwenden, um Kompaktierung zu erhalten?
Für die API-native serverseitige Version: ja. Chat Completions verfügt über kein natives Kompaktierungs-Primitiv – Anwendungen müssen ihre eigene Lösung implementieren (üblicherweise: Zusammenfassung der vorherigen Konversation durch einen separaten Modellaufruf und Weitergabe der Zusammenfassung). Die Responses API bietet Kompaktierung als expliziten Vorgang mit der opaken Kompaktierungselement-Semantik, die ZDR-sicher ist.
Wie interagiert Kompaktierung mit Prompt-Caching?
Wenn das statische Präfix für System/Entwickler/Tools Byte-identisch bleibt und vor der kompaktierten Historie steht, sollte die Kompaktierung Cache-Treffer für dieses Präfix nicht beeinträchtigen – Cache-Treffer erfordern eine exakte Übereinstimmung des Präfixes, sodass der unveränderte Anfang des Prompts weiterhin übereinstimmt. Was sich ändert, ist die Cache-Fähigkeit des Konversationsverlaufs: Nachfolgende Anfragen müssen einen neuen Cache-Eintrag für das Präfix nach der Kompaktierung aufbauen. Dies ist ein praktischer Grund, selten zu kompaktieren, anstatt dies alle paar Runden zu tun – jedes Kompaktierungsereignis macht den Cache für den Konversationsabschnitt ungültig, auch wenn der größere Teil des System-Prompts unberührt bleibt.
Kann das Gateway über mehrere Anbieter hinweg kompaktieren?
Nein. Kompaktierung ist anbieterspezifisch und das Kompaktierungselement ist opak und an den jeweiligen Anbieter gebunden – Sie können nicht mit OpenAI kompaktieren und bei Anthropic fortfahren. Das Gateway kann Kompaktierungsaufrufe weiterleiten und die resultierenden Elemente in der Sitzungsansicht anzeigen, aber die Fortsetzung muss beim selben Anbieter verbleiben.
Was ist, wenn der Agent Unter-Agenten anstelle von Kompaktierung verwendet?
Sub-Agents sind eine valide Alternative – da jeder Teilprozess einen eigenen, frischen Kontext erhält, wächst er nie über sein spezifisches Teilproblem hinaus, und der Orchestrator führt die Ergebnisse am Ende zusammen. Sub-Agents eignen sich, wenn Teilprobleme klar zerlegbar sind; Kompaktierung ist sinnvoll, wenn der Agent über viele Schritte einer zusammenhängenden Aufgabe hinweg Kontinuität benötigt. Beides schließt sich nicht aus.
Wie verhalten sich die Session-Token-Zahlen zu den OTel-Spans, die wir bereits erfassen?
Ein Trace pro Provider-Aufruf, eine Session pro Konversation. Die Session ist eine Zusammenfassung der Traces einer Konversation; sie liefert kumulierte Token-Zahlen, Latenzprofile und Cache-Trefferraten über alle Interaktionsschritte hinweg.
Wo ordnet sich TrueFoundry ein?
Das in diesem Beitrag beschriebene Muster ist Gateway-agnostisch: Ein Gateway ist der natürliche Ort, um Session-Gruppierungen, die Sichtbarkeit von Token-Budgets pro Schritt, die Zuordnung von Cache-Treffern sowie das Routing von Provider-Kompaktierungsaufrufen abzubilden, da es ohnehin bei jeder Anfrage zwischengeschaltet ist. Das TrueFoundry AI Gateway bietet die Session- und Observability-Ebene, auf der diese Funktionen aufbauen – zentralisiertes Tracing, Metadaten-Tagging sowie die in früheren Beiträgen behandelte Kosten- und Budgetzuordnung pro Trace, aggregiert auf Konversationsebene. Kompaktierung und Caching sind Funktionen des Providers; der Beitrag des Gateways besteht darin, diese zu routen, ihre Auswirkungen auf Token-Verbrauch und Kosten zuzuordnen und einen langen Agenten-Lauf als eine einzige Timeline abfragbar zu machen. (Der spezifische Header-Name X-TFY-CONVERSATION-ID dient hier als beispielhafte Konvention; betrachten Sie die genauen Primitive als Möglichkeiten, die ein Gateway bereitstellen kann, nicht als festen Standard.) Die Agenten-Plattform bestimmt die Kontext-Strategie; das Gateway liefert die nötige Sichtbarkeit und Steuerung.
Wenn Sie heute einen langlebigen Agenten in der Produktion betreiben, ist die effektivste Maßnahme die Aktivierung von Prefix-Caching für den System-Prompt. Bei OpenAI geschieht dies automatisch und erfordert keine Code-Änderungen; bei Anthropic fügen Sie cache_control-Breakpoints um das stabile Präfix hinzu und validieren Sie die Wirtschaftlichkeit von Schreib- und Lesezugriffen für Ihre Workload, da für Cache-Schreibvorgänge eigene Preise gelten. In beiden Fällen amortisiert sich die Investition in die Plattform meist innerhalb weniger Wochen. Kompaktierung ist der nächste Schritt, sobald der Agent regelmäßig 60–70 % des Kontextlimits des Modells überschreitet. Session-Tracking ist die Voraussetzung, um beide genannten Maßnahmen debuggen zu können.
Northwind, Maya und PR #4127 dienen der Veranschaulichung. Die Beispiele für Kompaktierung und Prompt-Caching spiegeln das dokumentierte Verhalten der OpenAI Responses API und der Anthropic API mit Stand Mai 2026 wider. Token-Akkumulation, Schwellenwerte, Latenz und Cache-Trefferraten sind repräsentative Annahmen für Workloads, keine Messwerte – messen Sie diese anhand Ihrer eigenen Agenten-Traces, bevor Sie Produktionsrichtlinien festlegen. Die genannten Provider-Preise und Kontextlimits basieren auf den öffentlichen Preislisten und Modellseiten der Anbieter zum jeweiligen Zeitpunkt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















