



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
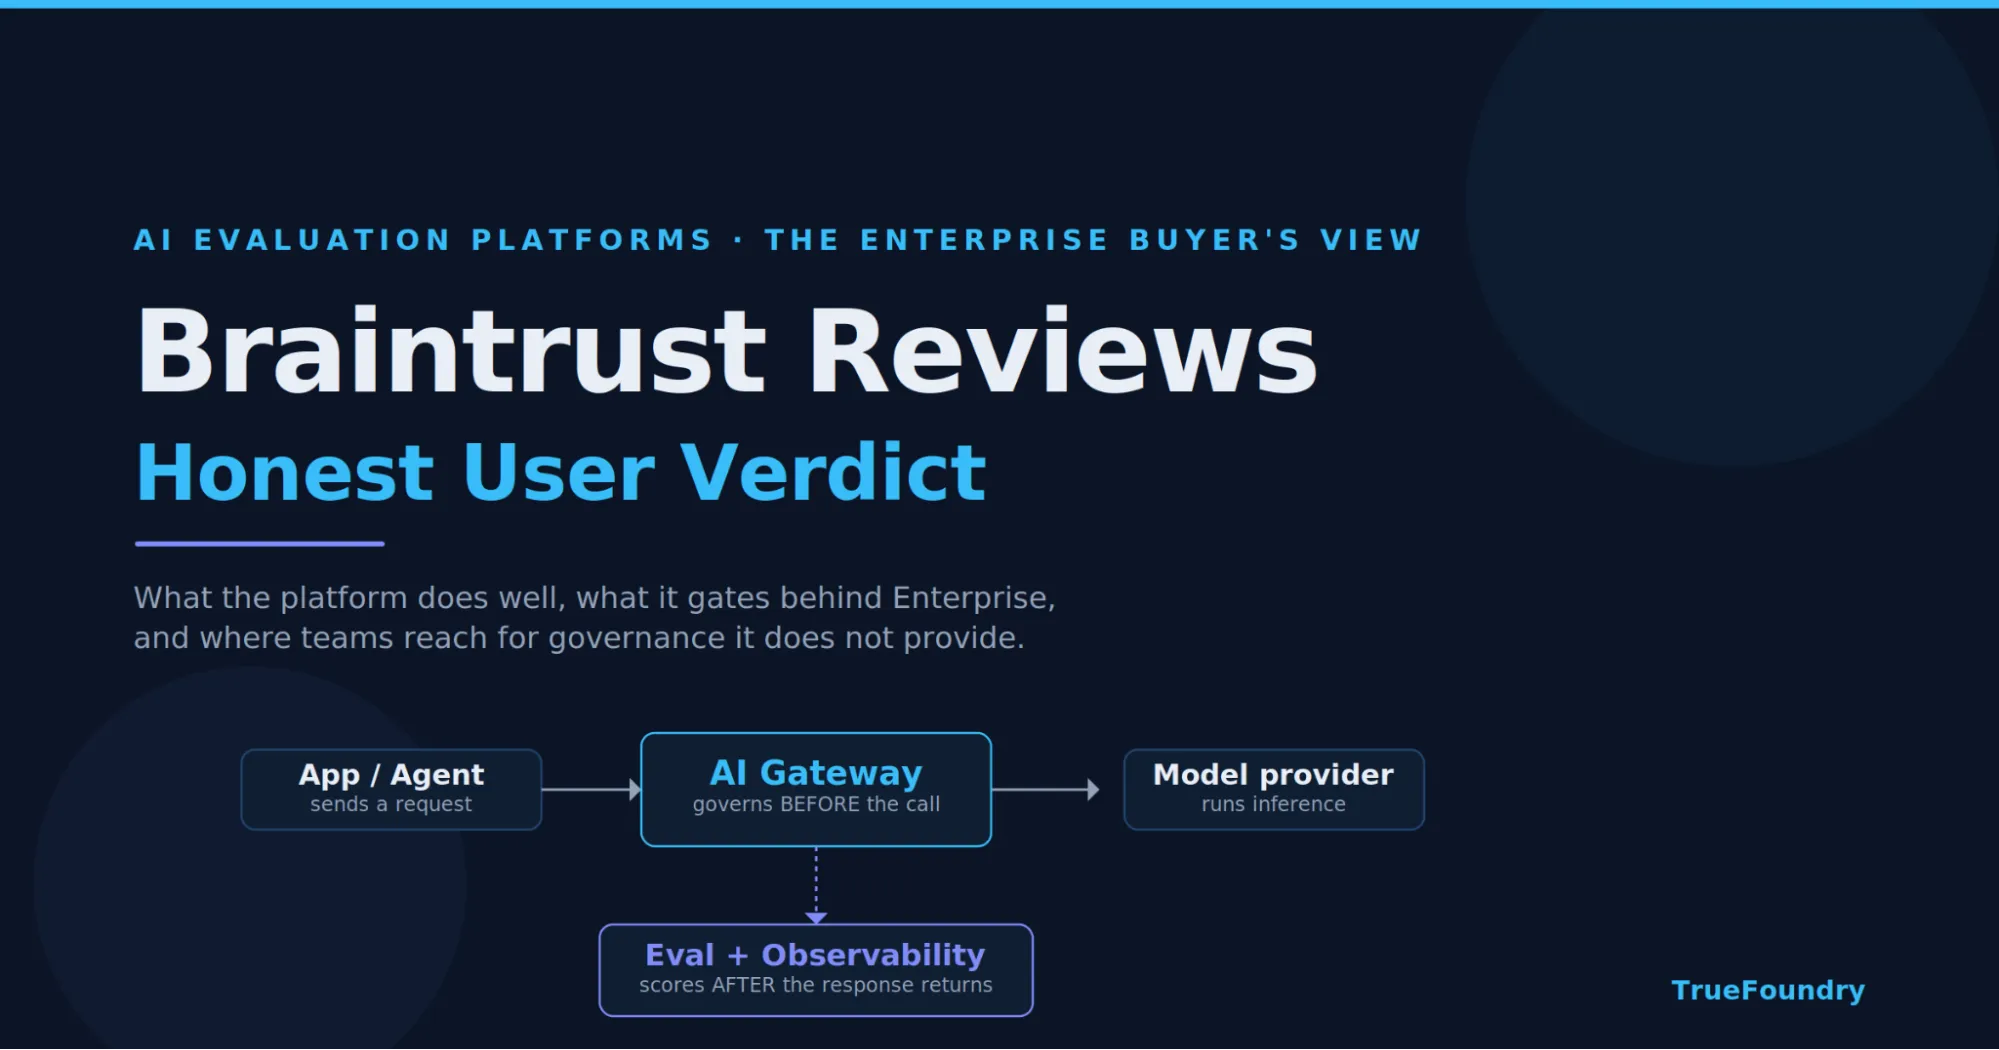
Evaluierungsplattformen lösen ein echtes Problem für KI-Teams. Ändert man einen Prompt, wechselt das Modell oder passt das Retrieval an, kann sich die Qualität verbessern oder verschlechtern. Braintrust-Bewertungen sind größtenteils positiv, da die Plattform Teams dabei hilft, diese Veränderungen zu messen, bevor die Nutzer sie bemerken.
Die Frage für Unternehmen geht über die reine Output-Evaluierung hinaus. Die Evaluierung zeigt Teams, was ihre KI nach der Inferenz produziert hat. Sie entscheidet jedoch nicht darüber, wer ein Modell aufrufen darf, begrenzt keine Team-Budgets, regelt nicht die Tool-Nutzung und sorgt nicht dafür, dass Prompts in einer privaten Umgebung bleiben.
Diese Unterscheidung ist wichtig, da Braintrust nach der Inferenz ansetzt. Governance, Zugriffskontrolle und die Durchsetzung von Richtlinien für den Anforderungspfad finden vor der Inferenz statt. Unternehmen, die Braintrust-Bewertungen lesen, sollten diese Grenze verstehen, bevor sie Braintrust mit einem KI-Gateway vergleichen.
Es gibt zudem ein Namensproblem, das früh geklärt werden sollte. Zwei unabhängige Unternehmen nutzen den Namen Braintrust, weshalb viele öffentliche Bewertungen ein Recruiting-Produkt beschreiben und nicht die KI-Evaluierungsplattform. Dieser Leitfaden unterscheidet beide und erklärt, wo Braintrust Dev einzuordnen ist.
Braintrust Dev ist eine Plattform für KI-Evaluierung und Observability für Engineering-Teams, die LLM-Anwendungen in der Produktion bereitstellen. Sie hilft Teams dabei, Evals durchzuführen, Traces zu untersuchen, Prompts zu vergleichen und Regressionen vor der Veröffentlichung zu erkennen. Braintrust hat 2026 eine Series-B-Finanzierung in Höhe von 80 Millionen US-Dollar unter der Leitung von ICONIQ erhalten.
Braintrust Dev deckt drei miteinander verbundene Workflows ab:
Die Plattform ist nützlich für Teams, die auf Traces basierende Qualitäts-Workflows benötigen. Sie hilft Entwicklern, Projektmanagement, Prompt-Updates, Evals und Release-Entscheidungen miteinander zu verknüpfen. Käufer sollten dennoch die Stärke der Evaluierung von den Anforderungen an die Governance des Anforderungspfads trennen.
Braintrust-Bewertungen sind durchweg positiv in Bezug auf ein zentrales Thema: Die Plattform macht die KI-Entwicklung messbar, indem sie Traces, Evals, Experimente und Prompt-Änderungen miteinander verbindet. Nutzer schätzen die Trace-Benutzeroberfläche, den Evaluierungs-Workflow, den Playground und die Möglichkeit, das Modellverhalten vor der Veröffentlichung zu vergleichen.
Das Volumen öffentlicher Bewertungen für Braintrust Dev ist geringer, als es das Finanzierungsprofil des Unternehmens vermuten lässt. Ein wesentlicher Grund dafür ist die Namensüberschneidung mit Braintrust AIR. Suchen nach Braintrust-Bewertungen oder Braintrust-KI-Gateway-Bewertungen können Feedback zum Recruiting mit Recherchen zur KI-Evaluierung vermischen.
Das bedeutet, dass Unternehmenskäufer Bewertungsdaten mit Vorsicht genießen sollten. Einige positive Bewertungen können bestätigen, dass Braintrust für Evals gut funktioniert. Sie können jedoch nicht alle Fragen zu Incident-Support, Multi-Team-Governance, privater Bereitstellung und Zugriffskontrolle in großem Maßstab beantworten.
Die praktische Einschätzung ist ausgewogen. Braintrust Dev bietet einen hohen Produktnutzen für Evaluierung und Observability. Es sollte nicht als Gateway, Sicherheitsebene oder Governance-Plattform für Produktions-Inferenz bewertet werden, da dies außerhalb seiner Kernfunktionen liegt.
Lassen wir die Lücken kurz beiseite, denn Braintrust verdient sich seinen Ruf in der Evaluierungsebene. Seine größten Stärken liegen darin, Teams dabei zu unterstützen, Produktänderungen mit messbarer Ausgabequalität zu verknüpfen. Diese Stärken spiegeln sich in der Dokumentation, der Produktpositionierung und dem öffentlichen Nutzerfeedback wider.
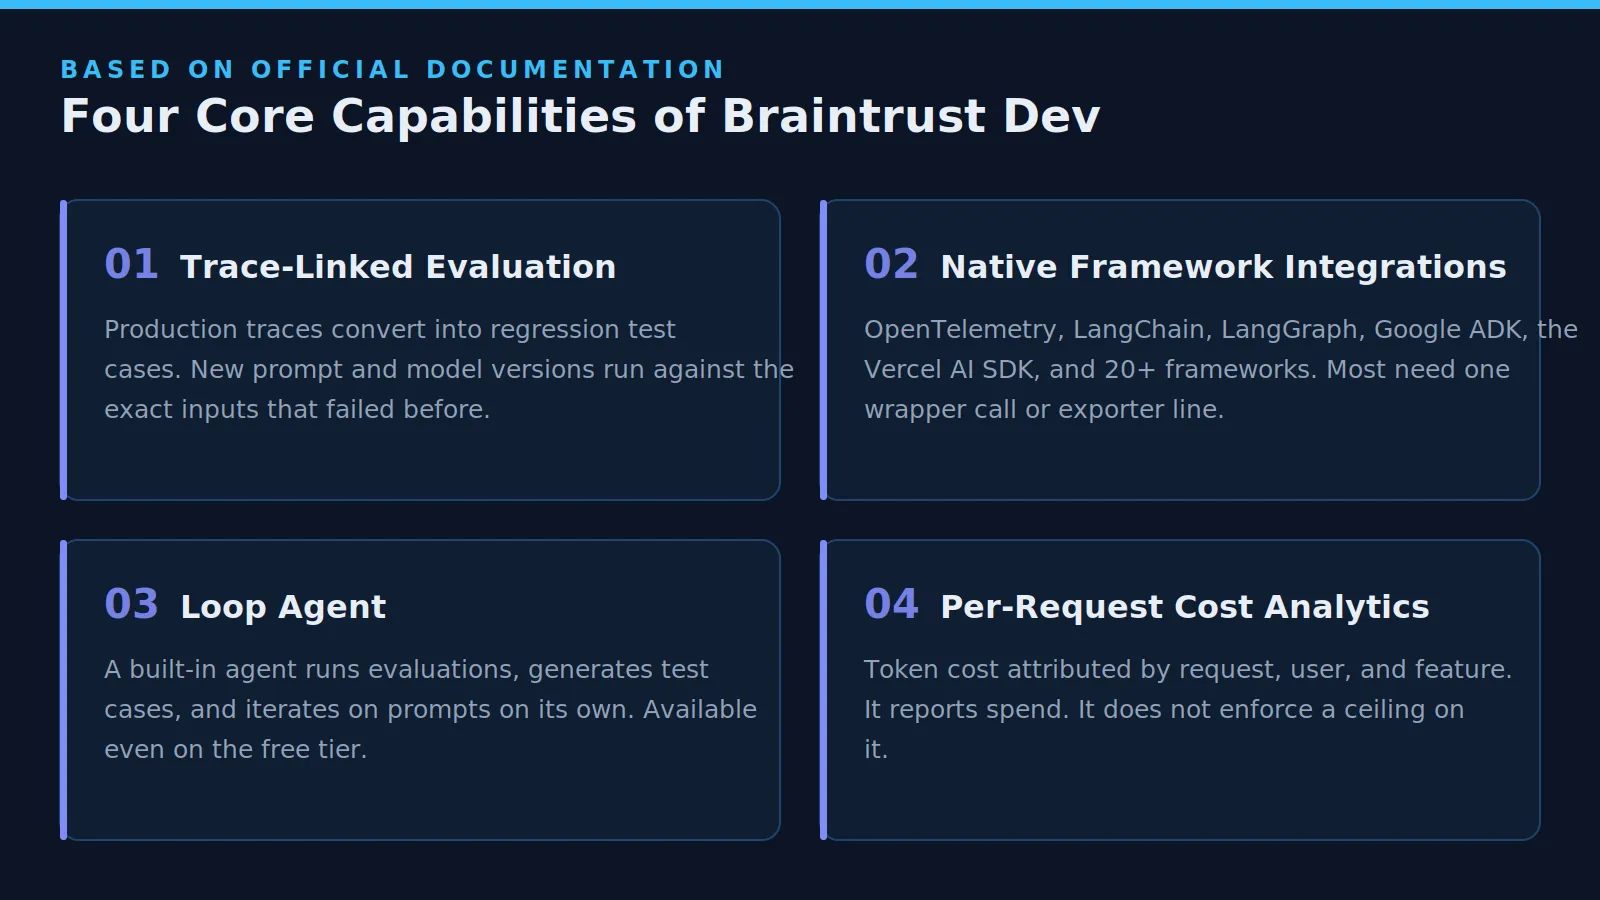
Braintrust ermöglicht es Teams, Produktions-Traces in Evaluierungs-Testfälle umzuwandeln. Dadurch können Regressions-Suiten auf Basis echter Fehler statt künstlicher Beispiele wachsen. Wenn sich ein Prompt oder ein Modell ändert, können Teams gegen Eingaben testen, die zuvor Probleme verursacht haben.
Dieser Workflow erhöht das Vertrauen in Releases, da die Tests produktionsnahen Kontext nutzen. Traces bleiben über Offline-Evaluierungsläufe und Live-Logging hinweg konsistent. Entwickler können Regressionen in derselben Benutzeroberfläche debuggen, in der sie den Fix getestet haben.
Die Einführung scheitert oft, wenn die Instrumentierung umfangreiche Änderungen an der Anwendung erfordert. Braintrust senkt diese Hürde durch Integrationen für OpenTelemetry, Vercel AI SDK, OpenAI Agents SDK, LangChain, LangGraph, Google ADK, Mastra, Pydantic AI und verwandte Frameworks.
Die meisten Integrationen er fordern lediglich einen Wrapper-Aufruf oder eine Exporter-Konfiguration. Teams, die bereits OpenTelemetry nutzen, können Braintrust einfach als weiteren Span-Exporter hinzufügen. Das verringert den Einrichtungsaufwand und hilft Entwicklern, schneller wiederholbare Evaluierungs-Workflows zu erstellen.
Braintrust enthält einen integrierten Agenten namens Loop. Er kann Evaluierungen durchführen, Testfälle generieren und Prompts automatisch iterieren. Für Teams, die das Einrichten von Evaluierungen als mühsam empfinden, ist dies ein nützliches Unterscheidungsmerkmal gegenüber reinen Logging-Tools.
Es gibt jedoch eine wichtige Einschränkung: Autonome Iteration funktioniert am besten, wenn die Bewertungskriterien klar definiert sind. Ein vages Ziel führt zu vagen Vorschlägen; Teams benötigen daher disziplinierte Kriterien, bevor sie sich auf die Automatisierung verlassen.
Braintrust ordnet Token-Kosten auf Anfrage-, Nutzer- und Feature-Ebene zu. Teams können sehen, welcher Workflow-Schritt oder welches Nutzersegment die Kosten treibt, ohne eine eigene Zuordnungspipeline aufbauen zu müssen. Diese Transparenz ist für KI-Produktteams wertvoll.
Die Grenze ist ebenso wichtig: Braintrust meldet Kosten erst, nachdem die Aktivität stattgefunden hat. Es erzwingt keine harten Limits vor der Inferenz, weshalb Teams es oft mit einem Gateway kombinieren, um Produktionsbudgets zu kontrollieren.
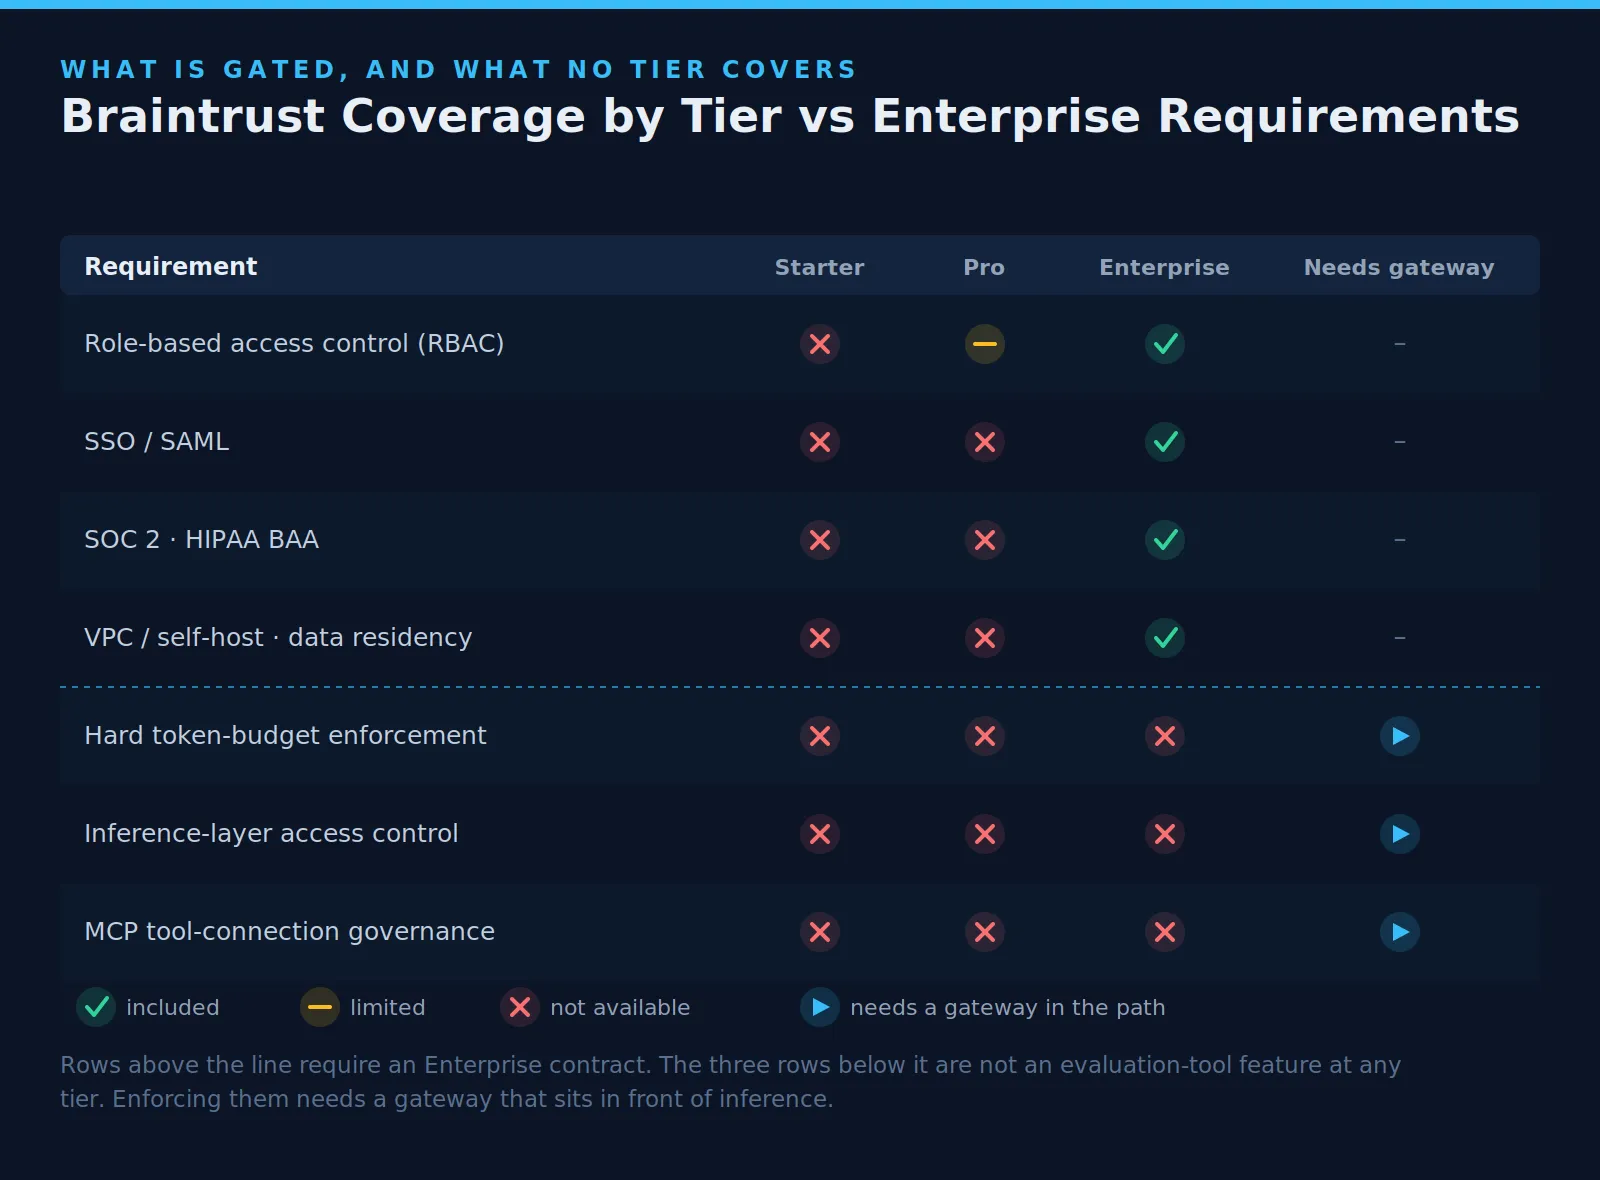
Um Braintrust-Bewertungen fair zu lesen, muss man die Preise und Stufenlimits mit einbeziehen. Mehrere Kontrollfunktionen, die für Enterprise-Teams unverzichtbar sind, sind nur in der Enterprise-Version verfügbar. Dies beeinflusst die Bewertung, da eine positive Produktrezension möglicherweise nicht mit der Stufe übereinstimmt, die Ihr Unternehmen benötigt.
Braintrust hat seinen kostenlosen Plan im März 2026 in „Starter“ umbenannt und nutzt verarbeitete Daten für die Abrechnung. Zu den verarbeiteten Daten gehören Eingaben, Ausgaben, Prompts, Metadaten und Traces, die in die Plattform aufgenommen werden. Ein Gigabyte verarbeiteter Daten entspricht bei typischen Payload-Größen etwa einer Million Spans.
Die Nutzung über die enthaltenen Limits hinaus wird über Mehrverbrauch abgerechnet. Das bedeutet, dass ein intensiver Monat zu einer höheren Rechnung führt, anstatt den Dienst hart zu unterbrechen. Der Preisvorteil liegt in unbegrenzten Nutzern, Projekten, Datensätzen, Playgrounds und Experimenten über alle Tarife hinweg, was größeren Teams hilft, kostenintensive nutzerbasierte Preismodelle zu vermeiden.
Die Haupteinschränkung betrifft den Enterprise-Plan. Benutzerdefinierte RBAC, SAML-SSO, HIPAA-BAA, S3-Export, individuelle Aufbewahrungsfristen sowie On-Premise- oder gehostete Bereitstellungen erfordern den Enterprise-Plan. Teams mit strengen Anforderungen an Compliance, Identitätsmanagement, Datenaufbewahrung oder Bereitstellung sollten dies bei ihrer Evaluierung berücksichtigen.
Keine dieser Lücken schwächt Braintrust in seinem Kernbereich. Es handelt sich um architektonische Grenzen. Braintrust empfängt und analysiert Daten nach der Inferenz, was für Evaluierung und Observability korrekt ist. Es ist jedoch der falsche Ort, um Richtlinien durchzusetzen, bevor eine Anfrage das Modell erreicht.
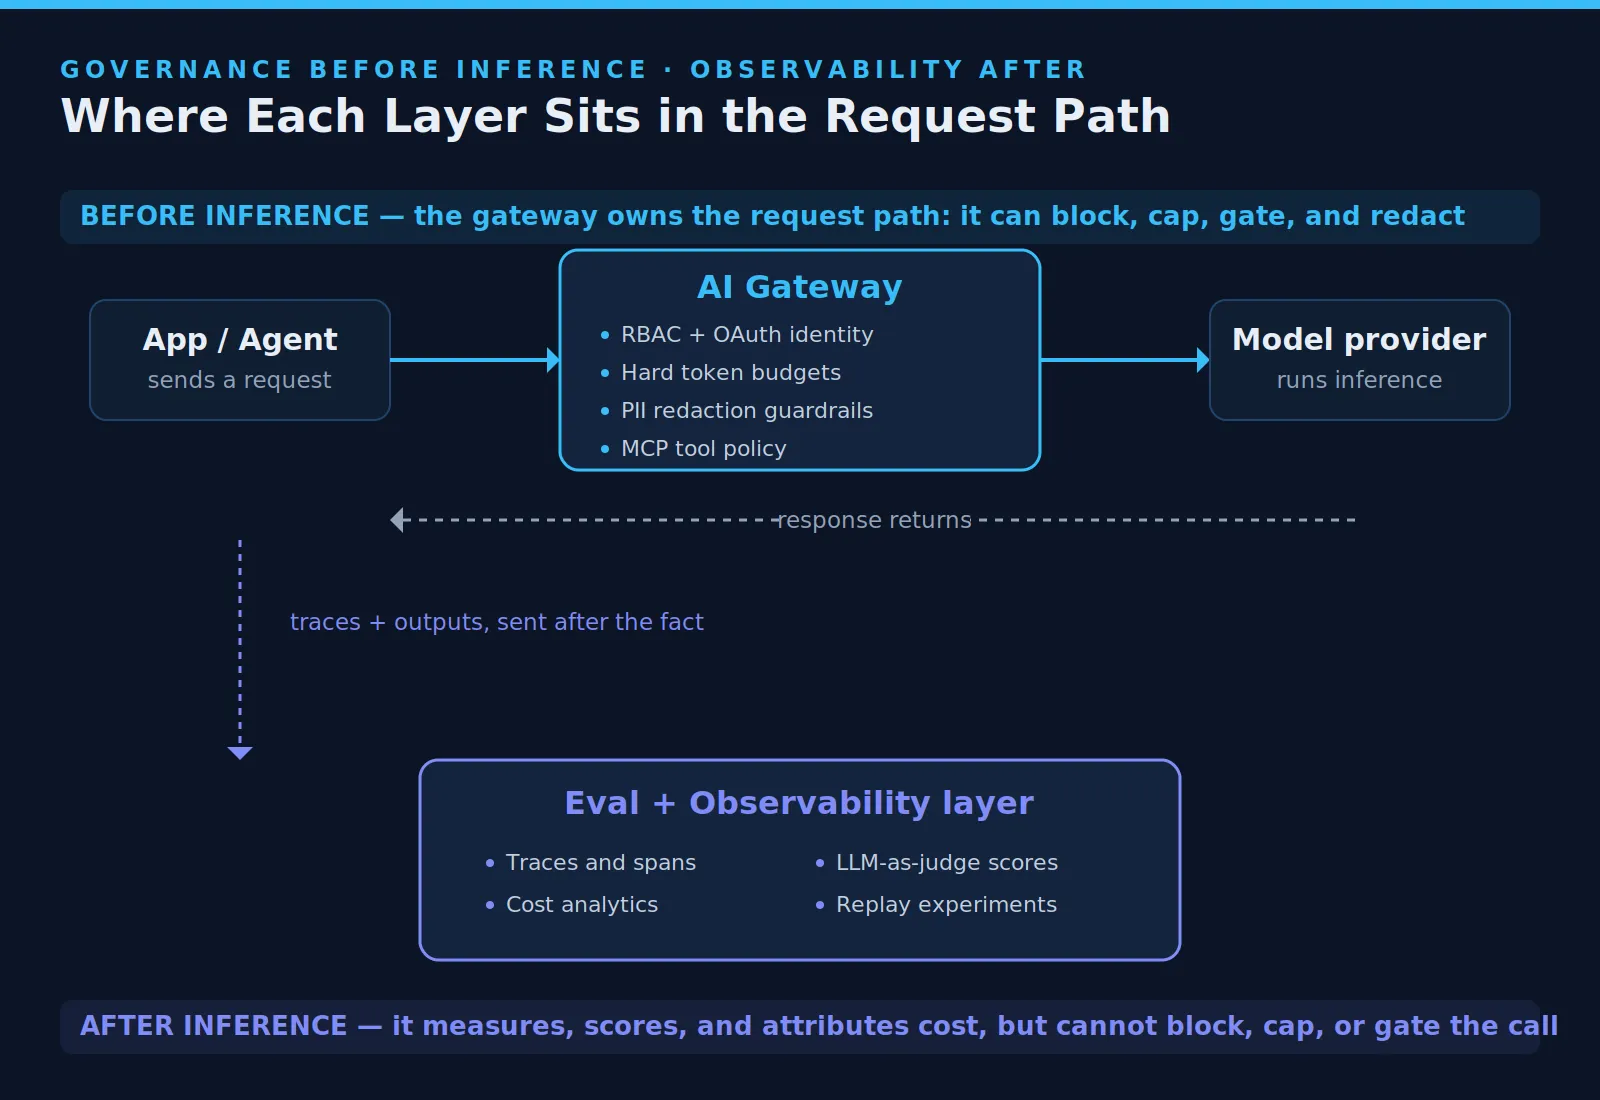
Braintrust beobachtet, was Modellaufrufe produzieren, indem es Tracing-Daten von Anwendungen empfängt. Es bietet zudem einen optionalen Proxy, der mehrere Anbieter hinter einem einzigen OpenAI-kompatiblen Endpunkt bündeln kann. Dies kann Teams helfen, den Zugriff zu zentralisieren und Antworten zwischenzuspeichern.
Der Proxy ersetzt dennoch keine identitätsbasierte Inferenz-Governance. Er entscheidet nicht, welcher interne Nutzer, Dienst oder Agent auf welches Modell zugreifen darf. Teams, die Zugriffsentscheidungen auf Anfrageebene benötigen, benötigen ein separates AI-Gateway , das diesen Kontrollpunkt verwaltet.
Kostenanalysen und Budgetdurchsetzung sind unterschiedliche Aufgaben. Braintrust übernimmt Ersteres, indem es die Kosten pro Trace verfolgt und Ausgaben nach Nutzer oder Funktion aufschlüsselt. Es kann Teams zudem benachrichtigen, wenn die Nutzung sich den Limits nähert.
Eine Warnung stoppt jedoch keine Ausgaben. Eine außer Kontrolle geratene Agenten-Schleife oder ein falsch konfigurierter Batch-Job kann weiterlaufen, während das Dashboard erst im Nachhinein aktualisiert wird. Um Obergrenzen durchzusetzen, müssen Anfragen abgelehnt oder gedrosselt werden, bevor sie den Anbieter erreichen.
In den Tarifen Starter und Pro laufen Trace-Daten über die verwaltete Cloud von Braintrust. Unterhalb des Enterprise-Plans gibt es keine Self-Hosted-Option. Für Organisationen mit Anforderungen an die Datenresidenz gemäß DSGVO, HIPAA oder branchenspezifischen Regeln stellt dies eine tarifbedingte Einschränkung dar.
Die Lösung innerhalb von Braintrust ist der Enterprise-Plan mit Self-Hosting und individuellen Konditionen. Das mag für manche Käufer funktionieren. Kleinere Teams mit strengen Datenkontrollvorgaben könnten den Sprung jedoch als schwierig empfinden.
Agenten verbinden sich zunehmend über das Model Context Protocolmit externen Systemen. Diese Verbindung schafft eine Sicherheitsgrenze, da Tools auf Daten zugreifen, Systeme aktualisieren und Aktionen auslösen können. Braintrust kann im Nachhinein nachvollziehen, was passiert ist.
Es befindet sich jedoch nicht vor dem Tool-Aufruf, um diesen zu genehmigen, zu blockieren, zu filtern oder eine Nutzeridentität anzuwenden. Da agentische Workloads zunehmend in regulierte Umgebungen vordringen, wird die ungeregelte MCP-Schnittstelle zu einer erheblichen Sicherheitslücke.
In der Kategorie Evaluierung und Observability konkurriert Braintrust am direktesten mit Langfuse, Arize Phoenix und Helicone. Jede Plattform richtet sich an ein anderes Nutzerprofil. Die richtige Wahl hängt davon ab, ob ein Team Wert auf Open-Source-Kontrolle, ein breites Spektrum an ML-Monitoring, kostengünstiges Tracing oder tiefgreifendere Evaluierungs-Workflows legt.
Das Alleinstellungsmerkmal von Braintrust gegenüber dieser Gruppe liegt in der Tiefe seines Evaluierungs-Workflows, dem Loop-Agenten und Brainstore, seiner speziell entwickelten Datenbank. Das Unternehmen gibt an, dass Brainstore KI-Traces laut eigenen Benchmarks 80-mal schneller abfragt als ein Standard-Data-Warehouse, mit medianen Abfragezeiten von unter einer Sekunde bei Terabytes an Daten. Auch wenn dies ein Hersteller-Benchmark ist, bleibt der architektonische Punkt valide: KI-Traces sind auf mehrere Megabyte angewachsen, und allgemeine Observability-Speicher stoßen bei dieser Datenlast an ihre Grenzen.
Nichts davon ändert etwas an der Ebene, auf der Braintrust operiert. Schnellere Trace-Abfragen machen ein Observability-Tool zwar besser, fügen jedoch keine Governance zur Inferenzzeit hinzu.
TrueFoundry und Braintrust Dev lösen unterschiedliche Probleme im KI-Stack. Braintrust hilft Teams dabei, Ausgaben nach der Inferenz zu bewerten und Qualitätsregressionen zu identifizieren. TrueFoundry steuert, was vor der Inferenz geschieht, einschließlich Zugriff, Budgets, Routing, Tool-Aufrufen und Audit-Logging.
Teams, die beide Ebenen benötigen, können sie gemeinsam nutzen. TrueFoundry steuert den Anforderungspfad über sein AI Gateway, während Braintrust die Ausgaben nachgelagert bewertet. Dies bietet Teams Governance vor der Ausführung und Evaluierung nach Erhalt der Antwort.
Für Teams, die weniger Systeme bevorzugen, kann TrueFoundry auch direkt Observability unterstützen. Es protokolliert Modellaufrufe, Agentenaktionen, Nutzung, Kostenmetadaten und Richtlinienergebnisse. Diese Protokolle können innerhalb der VPC des Kunden verbleiben und mit bestehenden Monitoring-Tools verbunden werden.
TrueFoundry ist besonders relevant, wenn Teams Folgendes benötigen:
Braintrust Dev bleibt nützlich, wenn der Schwerpunkt auf der Bewertung von Ausgaben, dem Tracking von Scores und der Regressionsanalyse liegt. TrueFoundry ist die stärkere Ebene, wenn Teams Inferenz-Governance, strikte Budgets, Tool-Kontrolle, private Bereitstellung und prüfungssichere Audit-Trails benötigen.
Buchen Sie eine Demo, um zu sehen, wie TrueFoundry Inferenz, Budgets, Zugriff und Audit-Logs sicher steuert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















