August 31, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Arthur AI-Integration mit dem Truefoundry AI Gateway
Jedes Team, das eine LLM-Anwendung bereitstellt, stößt irgendwann an dieselben Grenzen. Entwickler wollen schnell vorankommen und das Modell nutzen, das die Aufgabe am besten erfüllt. Sicherheits- und Risikoteams hingegen benötigen die Gewissheit, dass keine toxischen, manipulierten oder halluzinierten Inhalte an die Nutzer gelangen. Beide Seiten haben recht. Die Herausforderung besteht darin, beides gleichzeitig zu erreichen – und zwar über alle Modelle hinweg, die Ihre Teams nutzen, ohne für jede App ein eigenes SDK implementieren zu müssen. Die große Frage lautet: Wie validieren Sie jeden Prompt und jede Antwort Ihrer KI, ohne dass Sicherheit zu einem eigenen, komplexen Engineering-Projekt wird?
Wir freuen uns, die Integration von Arthur AI in das TrueFoundry AI Gateway bekannt zu geben. Indem Sie die Arthur Engine als benutzerdefiniertes Guardrail in das Gateway einbinden, können Sie KI-Inputs und -Outputs in Echtzeit über alle Ihre Modelle hinweg zentral validieren – mit einheitlichen Richtlinien und einer einzigen Integration.
Die Stärke des TrueFoundry AI Gateway
Das TrueFoundry AI Gateway ist die zentrale Lösung für Entwickler und Plattformteams, um KI-Anwendungen zu verwalten, zu überwachen und zu skalieren. Es bietet einheitlichen Zugriff auf Hunderte von Large Language Models, tiefgreifende Observability und intelligentes Routing in einer einzigen Ebene. Mit zunehmender Verbreitung von KI verlagert sich die Herausforderung vom reinen Modellzugriff hin zur Verwaltung des gesamten Umfelds: verschiedene Anbieter, sich ändernde APIs und strenge Compliance-Anforderungen können Teams schnell ausbremsen.
Das Gateway bringt Ordnung in diese Komplexität. Es fungiert als Kontrollzentrum für Enterprise-KI, vereinheitlicht den Zugriff, setzt Sicherheitsrichtlinien durch und bietet volle Transparenz über alle Modelle und Umgebungen hinweg. Guardrails werden einmalig in diese Ebene integriert und gelten überall, sodass eine im Dashboard getroffene Sicherheitsentscheidung für jede Anfrage durchgesetzt wird, die das System durchläuft.
Arthur AI: Validierung in Echtzeit
Arthur AI fungiert als Validierungsebene zwischen Ihrer Anwendung und Ihren Modellen. Die ArthurEngine prüft Prompts und Vervollständigungen in Echtzeit und liefert ein klares Urteil darüber, ob sie sicher verarbeitet werden können.
Von Haus aus prüft Arthur auf die Risiken, die im Produktivbetrieb am wichtigsten sind. Es erkennt Prompt Injection, bei der ein Angreifer Eingaben manipuliert, um das Modell zu kapern und von seinen Anweisungen abzubringen. Es identifiziert toxische Inhalte sowohl bei der Eingabe als auch bei der Ausgabe, damit schädliche Sprache weder Ihr Modell noch Ihre Nutzer erreicht. Zudem führt es Halluzinationsprüfungen anhand des von Ihnen bereitgestellten Kontextes durch und erkennt Antworten, die von den Fakten abweichen, bevor diese als verlässliche Informationen ausgegeben werden.
Ein wichtiges Detail bestimmt, wie sich Arthur einfügt: Es ist rein validierend. Es teilt Ihnen schnell und zustandslos mit, ob eine Prüfung bestanden wurde oder nicht. Anstatt Texte im Hintergrund umzuschreiben, meldet es Probleme direkt, was das Verhalten vorhersehbar und leicht prüfbar macht.
Gemeinsam stärker: Ein Vertrag, jedes Modell
Die Integration verbindet Arthur über einen leichtgewichtigen, bereitstellbaren Wrapper und den Custom-Guardrail-Vertrag des Gateways mit TrueFoundry. Sie stellen einen kleinen FastAPI-Dienst bereit, verweisen das Gateway darauf und registrieren zwei Guardrail-Konfigurationen im Dashboard: eine für die Eingabe und eine für die Ausgabe. Ab diesem Moment kann jedes Modell hinter dem Gateway von Arthur validiert werden, ohne dass pro Anwendung Codeänderungen erforderlich sind.
Das ist der eigentliche Vorteil. Anstatt Arthur manuell in jede Anwendung einzubinden, schließen Sie es einmalig am Gateway an. Verknüpfen Sie es mit einem Modell, damit jeder Aufrufer geschützt ist, oder entscheiden Sie sich pro Anfrage mit einem einzigen Header dafür, wenn Sie den Schutz nur für bestimmte Aufrufe benötigen. Dieselbe Richtlinie gilt für jedes Team, jedes Modell und jede Umgebung, und jedes Ergebnis wird zusammen mit der Anfragenverfolgung von TrueFoundry für einen sauberen Audit-Trail erfasst.
So funktioniert die Integration von Arthur AI und TrueFoundry
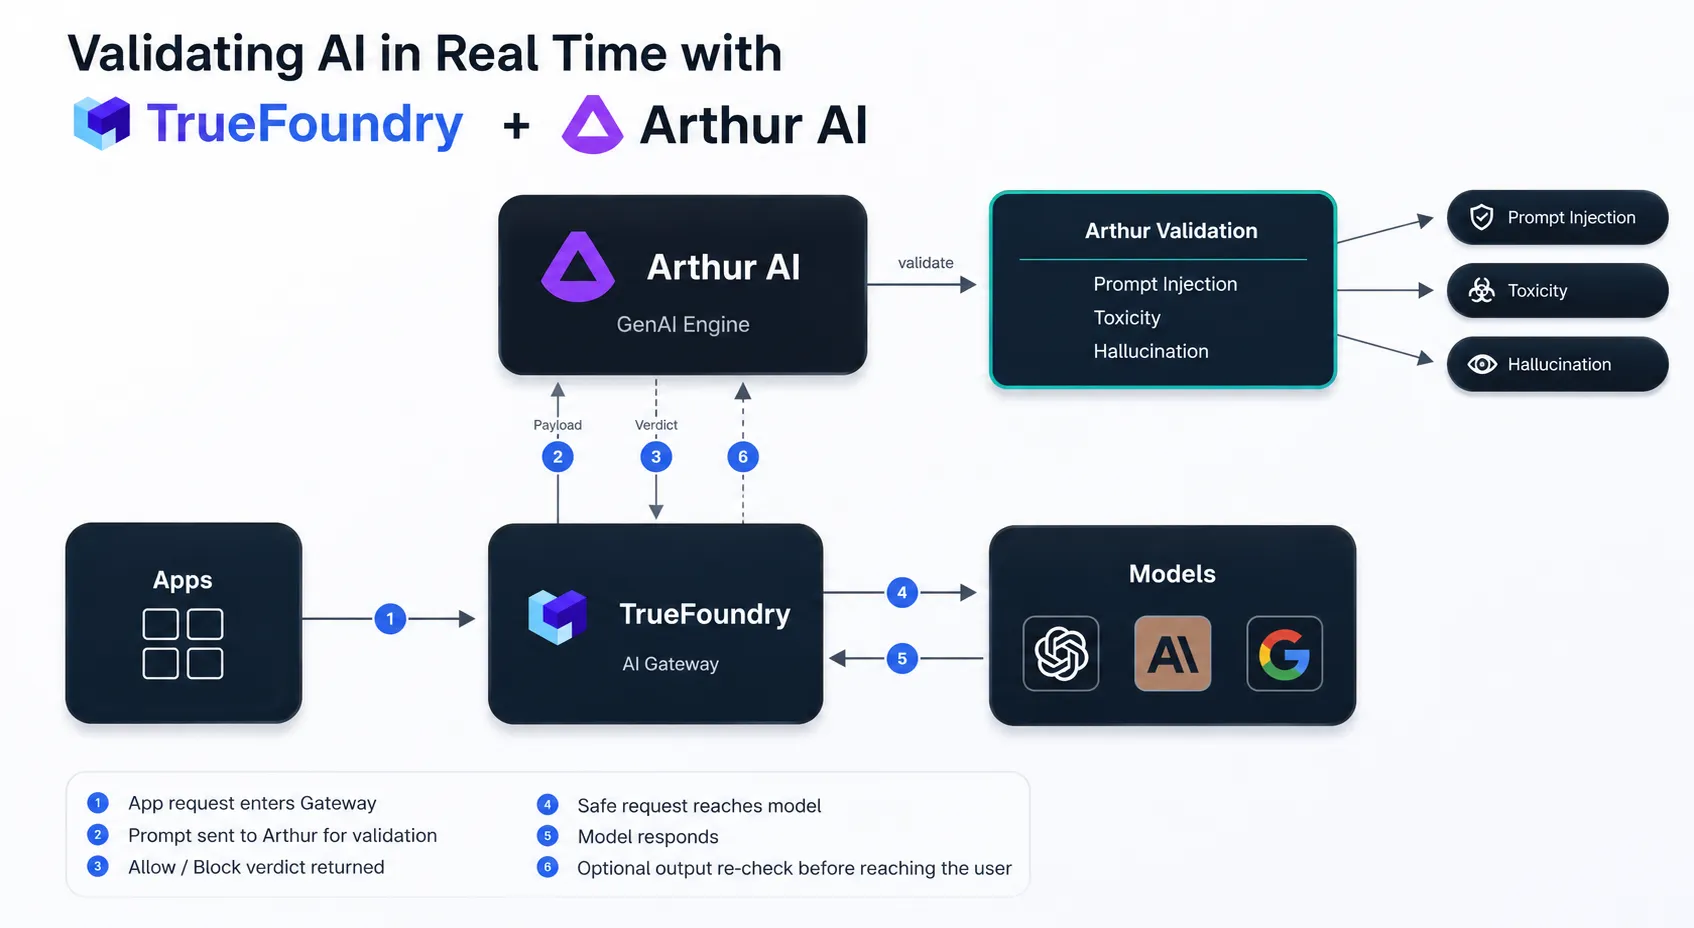
Die Integration führt einen mehrschichtigen Validierungsablauf ein, der leicht nachvollziehbar ist:
Eine subtile, aber wichtige Designentscheidung sorgt für Robustheit: Richtlinienentscheidungen werden über einen normalen HTTP-200-Status mit einem Ergebnis-Feld übermittelt, während echte Infrastrukturfehler als 5xx-Fehler ausgegeben werden. Mit der empfohlenen Durchsetzen, aber bei Fehlern ignorieren -Strategie wird der Datenverkehr bei einem vorübergehenden Ausfall durchgelassen, während eine echte Richtlinienblockade die Anfrage immer stoppt. Für sicherheitskritische Bereiche können Sie auf eine strikte Durchsetzung umstellen und den Zugriff im Fehlerfall blockieren.
Erste Schritte
Die Absicherung Ihrer KI sollte sich nicht wie ein kompletter Umbau anfühlen. Mit Arthur AI auf dem TrueFoundry AI Gateway ist die Echtzeit-Validierung eher wie das Umlegen eines Schalters als ein komplexes Verkabelungsprojekt: Wrapper bereitstellen, zwei Guardrail-Konfigurationen hinzufügen, mit Ihren Modellen verknüpfen – und schon validieren Sie Prompts und Antworten über Ihren gesamten Stack hinweg.
Um genau zu sehen, wie es funktioniert, besuchen Sie den Integrationsleitfaden für Arthur AI in der TrueFoundry-Dokumentation, in dem die vollständige Einrichtung, der Antwortvertrag und die Konfiguration benutzerdefinierter Prüfungen Schritt für Schritt erläutert werden.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet