



October 27, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
(In diesem Artikel bezieht sich „KI-Architektur“ spezifisch auf das KI-Gateway bzw. die Steuerungsebene, die zwischen Anwendungen und Modellanbietern angesiedelt ist – dort, wo Routing, Governance, Observability und Kostenkontrolle stattfinden.)
Wenn Sie einen Anbieter für die Skalierung Ihrer KI-Initiativen evaluieren, stellen Einkaufs- und Plattformteams bei der Bewertung der Enterprise-KI-Architektur regelmäßig die folgenden Fragen.
Wenn Ihre KI-Architektur diese Fragen nicht klar beantworten kann, verzögert sich die Bewertung der Enterprise-KI-Architektur, Sicherheitsprüfungen weiten sich aus und Pilotprojekte bleiben im Experimentierstadium stecken.
Bei der Bewertung der Enterprise-KI-Architektur prüfen Einkaufsteams selten nur das zugrunde liegende Modell. Sie bewerten die operative Architektur rund um die Modelle, also die Infrastruktur, die bestimmt, wie KI-Systeme innerhalb des Unternehmens geroutet, gesteuert, überwacht, gesichert und betrieben werden.
In den meisten Enterprise-GenAI-Umgebungen umfasst diese Ebene Komponenten wie KI-Gateways, Anbieter-Abstraktionssysteme, Routing-Logik, Authentifizierungskontrollen, Observability-Pipelines, Governance-Richtlinien, Prompt-Management-Systeme, Telemetrie-Infrastruktur, Budgetkontrollen und Failover-Mechanismen. Zunehmend gehören dazu auch Agenten-Governance und die Verwaltung von Tool-Berechtigungen, da Unternehmen mit MCP-Servern und autonomen Workflows experimentieren.
Mit der Zeit wird diese Architektur effektiv zum Betriebssystem für die Unternehmens-KI. Sie definiert, wie Anwendungen mit Modellen interagieren, wie Richtlinien durchgesetzt werden, wie Datenbewegungen überwacht werden und wie Kosten teamübergreifend kontrolliert werden.
Deshalb konzentrieren sich Einkaufsteams heute selten nur noch auf die Modellqualität. Die wichtigere Frage ist meist operativer Natur:
„Wie schwierig wird es sein, dieses System in den nächsten Jahren zu steuern, zu prüfen, zu skalieren und zu ersetzen?“
Die Antwort auf diese Frage entscheidet oft darüber, ob eine KI-Initiative über die Experimentierphase hinausgeht und unternehmensweit eingeführt wird.
So gestalten Unternehmen, die den Beschaffungsprozess erfolgreich durchlaufen, ihren KI-Stack.
Ein Satz fällt bei der Bewertung der Enterprise-KI-Architektur immer wieder:
Alle behaupten, sie seien OpenAI-kompatibel. Was bedeutet das eigentlich für Bedrock oder Gemini?
Die Sache ist die: Viele Teams sagen zwar „wir sind OpenAI-kompatibel“, aber das gilt oft nur für sehr begrenzte Modelle. Sobald Sie AWS Bedrock, Gemini oder On-Premise-Modelle (Cloudera, interne GPUs) einbinden, schleichen sich Formatinkonsistenzen in den Anwendungscode ein.
Der Einkauf erkennt das sofort:
Wenn ein Anbieterwechsel bedeutet, jede einzelne Anwendung anfassen zu müssen, sind Sie gefangen – ob Sie wollen oder nicht.
Diese Unterscheidung ist wichtig. In der Zusammenarbeit mit vielen Großunternehmen haben wir festgestellt, dass ein Hyperscaler zwar seine eigenen Modelle gut unterstützt, aber die Modellformate anderer Hyperscaler nicht nativ übersetzt. Wenn Sie eine Multi-Cloud-Strategie verfolgen, bedeutet das, dass Sie die Übersetzungslogik intern selbst schreiben und pflegen müssen.
Diese Logik erscheint im ersten Jahr nicht kostspielig. Im dritten Jahr wird sie jedoch sehr teuer. Hier ist der Grund:
„Wenn wir nächstes Jahr den Modellanbieter wechseln, wie viele Repositories müssen geändert werden?“
Wenn die Antwort nicht „fast keine“ lautet, haben Sie keine einkaufssichere Architektur.
TrueFoundry bietet eine anbieterunabhängige API-Schicht, die OpenAI, Bedrock, Gemini, Anthropic und selbst gehostete Modelle hinter einem einzigen Vertrag normalisiert – sodass Anwendungen niemals anbieterspezifische Logik enthalten.
Eine weitere wichtige Frage zur KI-Architektur, die Einkaufsteams bei der Evaluierung stellen, lautet:
„Wenn sich ein Kunde beschwert, können wir den vollständigen KI-Entscheidungspfad rekonstruieren?“
Herkömmliche API-Logs helfen Ihnen hier nicht weiter. LLM-Systeme sind Multi-Modell- Workflows mit mehreren Interaktionsrunden und Richtlinien.
Unternehmen, die bei der Evaluierung ihrer KI-Architektur erfolgreich sind, trennen zwei operative Ebenen strikt voneinander.
In großen Unternehmen fällt die Entscheidung meist explizit aus: Sie möchten einen zentralisierten Observability-Stack (zum Beispiel Arize) betreiben, unabhängig davon, welches Gateway oder welche KI-Plattform sie wählen, da sie eine Analytik-Ebene benötigen, die Daten aus verschiedenen Systemen jenseits des Gateways erfassen kann. Die Herausforderung liegt nicht im Kauf von Arize, sondern darin, die richtigen Daten zu erfassen, bevor sie dorthin übertragen werden:
„Wenn der Anbieter morgen vom Markt verschwindet, haben wir dann noch verwertbare Audit-Daten?“
Wenn Observability-Daten nur innerhalb einer proprietären Benutzeroberfläche existieren, werden Rechts- und Compliance-Abteilungen bei der Evaluierung der KI-Architektur erhebliche Bedenken anmelden.
TrueFoundry bietet von Haus aus KI-natives Tracing (Chat-Ansichten, Prompt-/Modell-Wiedergabe, Kostenaufschlüsselungen), das die tägliche Fehlersuche und Governance abdeckt.
Für Unternehmen mit zentralen Observability-Vorgaben bietet TrueFoundry strukturierte, unternehmenseigene Telemetriedaten, die Tools wie Arize ergänzen, anstatt sie zu ersetzen.
Das wirkt zunächst unbedeutend, bis es zum Problem wird.
In vielen Unternehmen sieht es heute so aus:
Die Beschaffungsabteilung hat nicht deshalb Einwände, weil es „schlechtes Engineering“ ist.
Sie hat Einwände, weil dadurch versteckte Betriebskosten entstehen.
In großen Unternehmen ist eine hohe Frequenz bei der Prompt-Iteration zu erwarten – insbesondere bei externen oder kundenorientierten Anwendungsfällen. Jedes Redeploy bedeutet Reibungsverluste, Risiko und Kosten. Stellen Sie sich beispielsweise vor, eine Vorschrift ändert sich (z. B. der EU AI Act) und ein Disclaimer-Prompt muss in 50 Apps aktualisiert werden – können Sie das zentral in 5 Minuten erledigen oder benötigen Sie dafür 50 teure Engineering-Sprints?
Diese Frage ist bei der Evaluierung der KI-Architektur im Unternehmen von entscheidender Bedeutung.
Das ist kein „Nice-to-have“. Es ist der entscheidende Unterschied, ob KI von Business-Teams bedient werden kann oder dauerhaft durch die Entwicklung ausgebremst wird.
„Wie viele Produktions-Releases erfordert eine einzige Prompt-Änderung?“
Wenn die Antwort größer als null ist, ist Ihre TCO-Rechnung falsch.
TrueFoundry unterstützt die Prompt-Hydrierung am Gateway. Dadurch können Anwendungen Prompts per ID referenzieren, während Fachexperten die Versionen zentral und mit vollständiger Historie verwalten.
Einer der am schnellsten wachsenden Bereiche bei der Bewertung von KI-Architekturen betrifft die Governance.
Wir haben viele große Unternehmen erlebt, die dachten: „Gateways bieten uns jetzt eine Modellvereinheitlichung, aber MCP, Tool-Zugriff und Agenten-Governance werden später unser Problem sein.“
Viele Teams unterschätzen, wie schnell die Komplexität der Governance wächst:
Wenn Governance nicht am Gateway durchgesetzt wird, bauen Teams später ein paralleles System auf – mit Beratern, Übergaben und einer dauerhaften Wartungslast.
„Wenn wir die Anzahl der Apps im nächsten Jahr verdoppeln, verdoppeln sich dann auch die Governance-Kosten?“
Wenn ja, wird die Beschaffungsabteilung dies als zukünftiges Risiko einstufen.
Das KI-Gateway von TrueFoundry umfasst ein produktionsreifes MCP-Gateway mit zentraler Richtliniendurchsetzung für Tools, Agenten und Identitäten. Es ist darauf ausgelegt, die Governance zu skalieren, ohne den Personalbestand zu erhöhen.
Eine der praktischsten Fragen zur KI-Architektur, die Beschaffungsteams bei der Bewertung stellen, betrifft die Preisgestaltung und Kostenzuordnung.
Die Abrechnung über Service-Accounts fördert schlechte Praktiken (geteilte Schlüssel, fehlende Zuordnung). Sie benötigen Kostentransparenz pro Anwendung oder Workload, statt verschleierter Nutzung.
„Können wir die Ausgaben für eine App begrenzen, ohne andere zu beeinträchtigen?“
Wenn nicht, wird die Finanzabteilung einer Skalierung der Nutzung niemals zustimmen.
Die Zuordnung pro App bzw. Workload ist möglich, da Apps als eigenständige Identitäten eingebunden werden können (statt die Nutzung geteilter Service-Accounts zu fördern).
Kosten-Leitplanken können zentral durchgesetzt werden (Quoten, Routing, Drosselung), damit Teams die Kosten nicht versehentlich in die Höhe treiben und sich dann mit einem „Hoppla“ herausreden können.
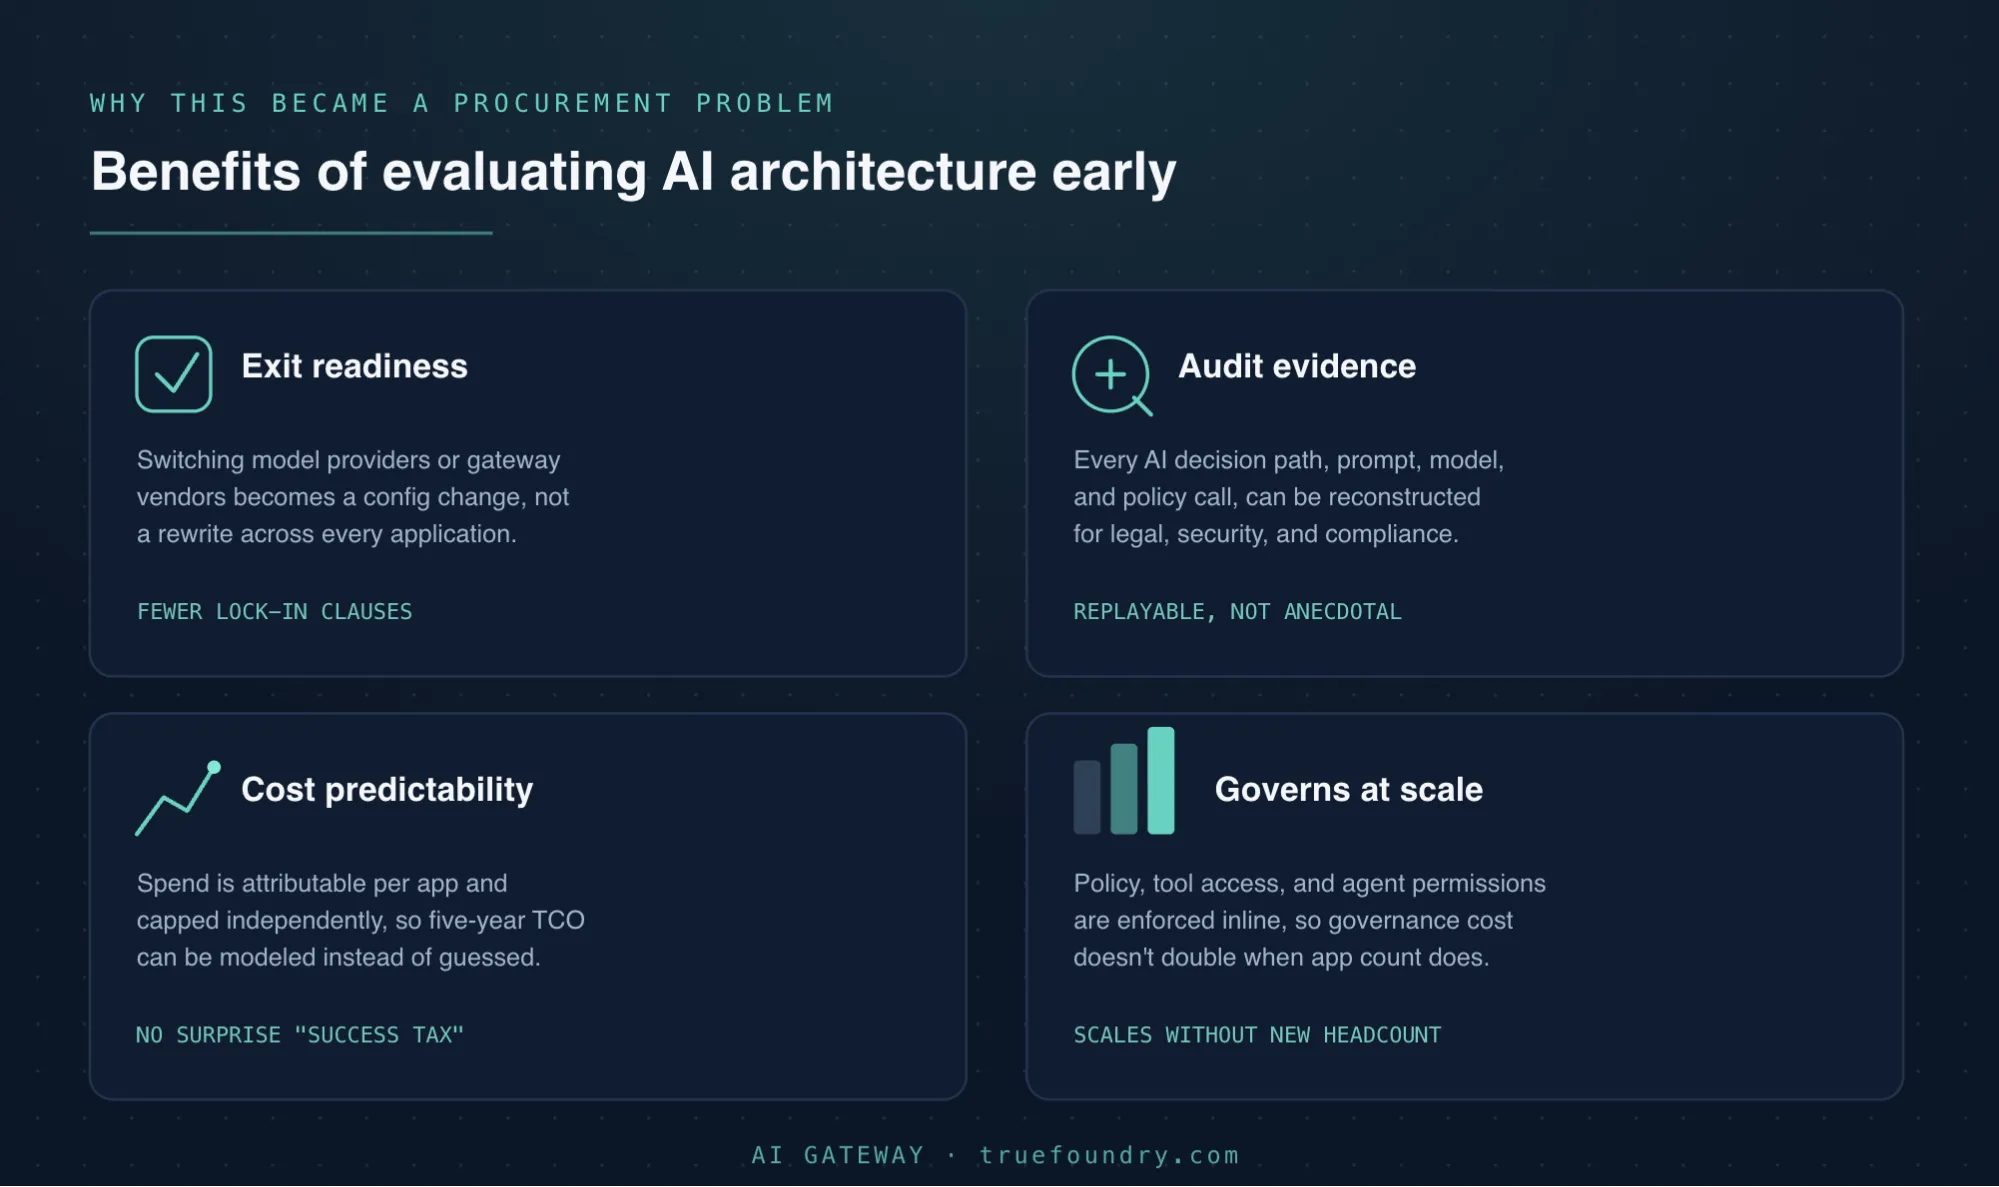
Früher lag die Bewertung von KI-Architekturen fast ausschließlich bei den Engineering-Teams. Heute ist sie in Unternehmen ebenso sehr ein Thema für Beschaffung, Finanzen, Sicherheit und Compliance.
Der Grund ist einfach: KI-Systeme im Unternehmen schaffen langfristige betriebliche Abhängigkeiten, die später nur schwer rückgängig zu machen sind. Sobald sich eine Organisation auf einen bestimmten KI-Stack festlegt, wählt sie nicht mehr nur einen Modellanbieter, sondern entscheidet sich für ein Ökosystem aus Governance-Schichten, Observability-Systemen, Routing-Infrastruktur, Compliance-Tools, Cloud-Abhängigkeiten und Agent-Frameworks, die das Unternehmen über Jahre hinweg prägen können.
Beschaffungsteams erkennen zunehmend, dass Entscheidungen aus der Pilotphase oft zu dauerhaften architektonischen Vorgaben werden. Ein System, das während eines Proof of Concept flexibel erscheint, kann extrem teuer in der Migration werden, sobald Dutzende Anwendungen, Workflows und interne Teams davon abhängen.
Deshalb prüfen Unternehmenskäufer KI-Architekturen heute deutlich sorgfältiger als noch vor einem Jahr. Eine glänzende Demo mag Führungskräfte anfangs beeindrucken, doch Beschaffungsteams konzentrieren sich auf tiefergehende betriebliche Fragen: Wie schwierig ist ein späterer Anbieterwechsel? Kann das Unternehmen das KI-Verhalten zuverlässig prüfen? Wird die Governance mit zunehmender Verbreitung schwieriger? Sind die Kosten für eine langfristige Budgetierung vorhersehbar? Unterstützt das System eine realistische Multi-Cloud-Strategie?
In der Praxis ähneln KI-Architekturprüfungen in Unternehmen immer mehr Infrastrukturbewertungen als klassischen Software-Evaluierungen. Die Sorge gilt nicht mehr nur der Frage, ob die KI heute funktioniert, sondern ob die Architektur über die nächsten fünf Jahre steuerbar, portabel und wirtschaftlich nachhaltig bleibt.
Eine beschaffungsfreundliche GenAI-Architektur besteht aus drei unverzichtbaren Ebenen:
Ihre Anwendung ruft ein Gateway auf, nicht direkt eine Modell-API. Prompts, Tools und Guardrails werden einmalig definiert. Der Wechsel von OpenAI zu Anthropic oder einem selbst gehosteten Modell wird so zu einer Konfigurationsänderung statt zu einer kompletten Neuentwicklung.
Warum das wichtig ist: Wenn ein Anbieter die Preise verdreifacht, haben Sie Alternativen. Wenn ein Modell eingestellt wird, geraten Sie nicht in Bedrängnis. Exit-Klauseln werden damit glaubwürdig.
Ihre Architektur leitet Anfragen basierend auf der Absicht weiter, nicht nur nach Verfügbarkeit. Einfache Anfragen gehen an schnelle, kostengünstige Modelle. Komplexe Aufgaben werden von leistungsstarken Spitzenmodellen übernommen. Wenn die Kosten steigen, passen Sie einfach die Routing-Regeln an. Sie müssen nicht in Panik über Verträge neu verhandeln.
Warum das wichtig ist: Die TCO über fünf Jahre werden planbar. CFOs können Kostenkurven modellieren. Der Einkauf kann Budgetzusagen rechtfertigen, weil Sie das System auf Kostenschwankungen ausgelegt haben.
Jede Anfrage wird protokolliert: welches Modell, welche Richtlinie wurde angewendet, auf welche Daten wurde zugegriffen, wurden Inhalte durch Guardrails blockiert? Wenn die Rechtsabteilung fragt: „Hat diese Kundeninteraktion GPT-4 genutzt?“, zeigen Sie den Trace, statt zu raten.
Warum das wichtig ist: Compliance wird systematisch statt manuell. Die Rechtsabteilung kann Audits durchführen. Der Einkauf kann dem Vorstand gegenüber Risiken fundiert begründen.
Der Einkauf ist nicht gegen KI. Er ist gegen unumkehrbare Entscheidungen.
Das eigentliche Ziel der Evaluierung einer Enterprise-KI-Architektur ist die Reduzierung langfristiger operativer, regulatorischer und finanzieller Risiken, bevor die KI-Nutzung im gesamten Unternehmen skaliert.
Und hier ist der entscheidende Punkt: Diese Architektur kommt auch der Technik zugute.
Weniger Umschreiben. Weniger ungeplante Eskalationen. Sauberere Abstraktionen.
Der schnellste Weg, GenAI im Unternehmen zu skalieren, sind keine besseren Demos, sondern das System so sicher zu machen, dass es gekauft werden kann.
TrueFoundry unterstützt Unternehmen dabei, GenAI-Systeme zu entwickeln, die einfacher zu steuern, zu skalieren und weiterzuentwickeln sind, ohne Anwendungen an einen einzigen Modellanbieter zu binden. Von Multi-Modell-Routing und zentraler Governance bis hin zu Observability, Prompt-Management und Kostenkontrolle: TrueFoundry AI Gateway wurde entwickelt, um Plattform-, Beschaffungs- und Engineering-Teams dabei zu helfen, KI-Projekte mit weniger operativen Überraschungen in die Produktion zu bringen. Demo buchen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















