نوفمبر 21, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.


Blazingly fast way to build, track and deploy your models!
أشارت أداة التقييم لدينا إلى أن الذاكرة المؤقتة للمطالبات في OpenRouter عملت على موديلات Anthropic. بينما ذكر تقريرنا بعد بضعة أيام أنها لم تعمل. كلاهما كان خاطئًا.
أرسل الاختبار كتلة طويلة من النص المرجعي إلى Claude Haiku 4.5 مع وجود cache_control عليها، في المكان الذي تنص وثائق OpenRouter تمامًا على وضعه فيه. رصدت أداة التقييم حقول الذاكرة المؤقتة في الاستجابة وعلمت على الميزة بأنها تعمل. عندما نظرنا إلى الأرقام لاحقًا، كان cache_write_tokens صفرًا، لذلك اعتبرناها ملغاة. كانت الإجابة موجودة في الوثائق طوال الوقت: لا يقوم Haiku 4.5 بتخزين المطالبات التي تقل عن 4,096 token في الذاكرة المؤقتة، وكانت مطالباتنا تبلغ حوالي 3,600 token.
تظهر معظم مشاكل الذاكرة المؤقتة للمطالبات على OpenRouter بالطريقة نفسها. ينجح الطلب، وتكون الميزة مفعّلة. لكن الاستجابة لا تخبرك بوضوح متى لم يحدث التخزين المؤقت، أو متى حدث وكلف أكثر مما وفر.
تستخدم OpenRouter الكلمة لميزتين ليس بينهما تقريبًا أي شيء مشترك.
الذاكرة المؤقتة لمطالبات المزود تتبع المزود. فهي تقوم بتخزين البادئة (prefix) المعالجة لمطالبتك بحيث يتخطي الطلب التالي الذي يحمل البادئة نفسها إعادة قراءتها، ويتم محاسبة تلك الـ tokens بخصم. بينما يظل الموديل يعمل ويكتب إجابة جديدة. أما الذاكرة المؤقتة للاستجابة فتتبع OpenRouter. فهي تخزن الاستجابة بأكملها وترجعها عند تقديم طلب مطابق تمامًا، ولا يعمل الموديل على الإطلاق.
الأسعار والحدود الأدنى وأوقات العيش (TTLs) أدناه تتعلق بالذاكرة المؤقتة لمطالبات المزود. إذا كنت تفاضل بين الذاكرة المؤقتة للاستجابة المطابقة تمامًا (exact-match) والجمالية (semantic)، فإن دليلنا لمتى يجب أن تتشارك الأسئلة المتشابهة إجابة واحدة يغطي ذلك. تملك الذاكرة المؤقتة للاستجابة في OpenRouter قسمًا خاصًا بها بالقرب من النهاية.
تقوم OpenRouter بتمرير تسعير الذاكرة المؤقتة لكل مزود دون إضافة هامش ربح لكل token. تفرض رسومها على مشتريات الرصيد بدلاً من ذلك، وهو ما يغطيه تفصيل أسعار OpenRouter. المضاعفات أدناه هي بالنسبة لسعر الإدخال العادي للموديل.
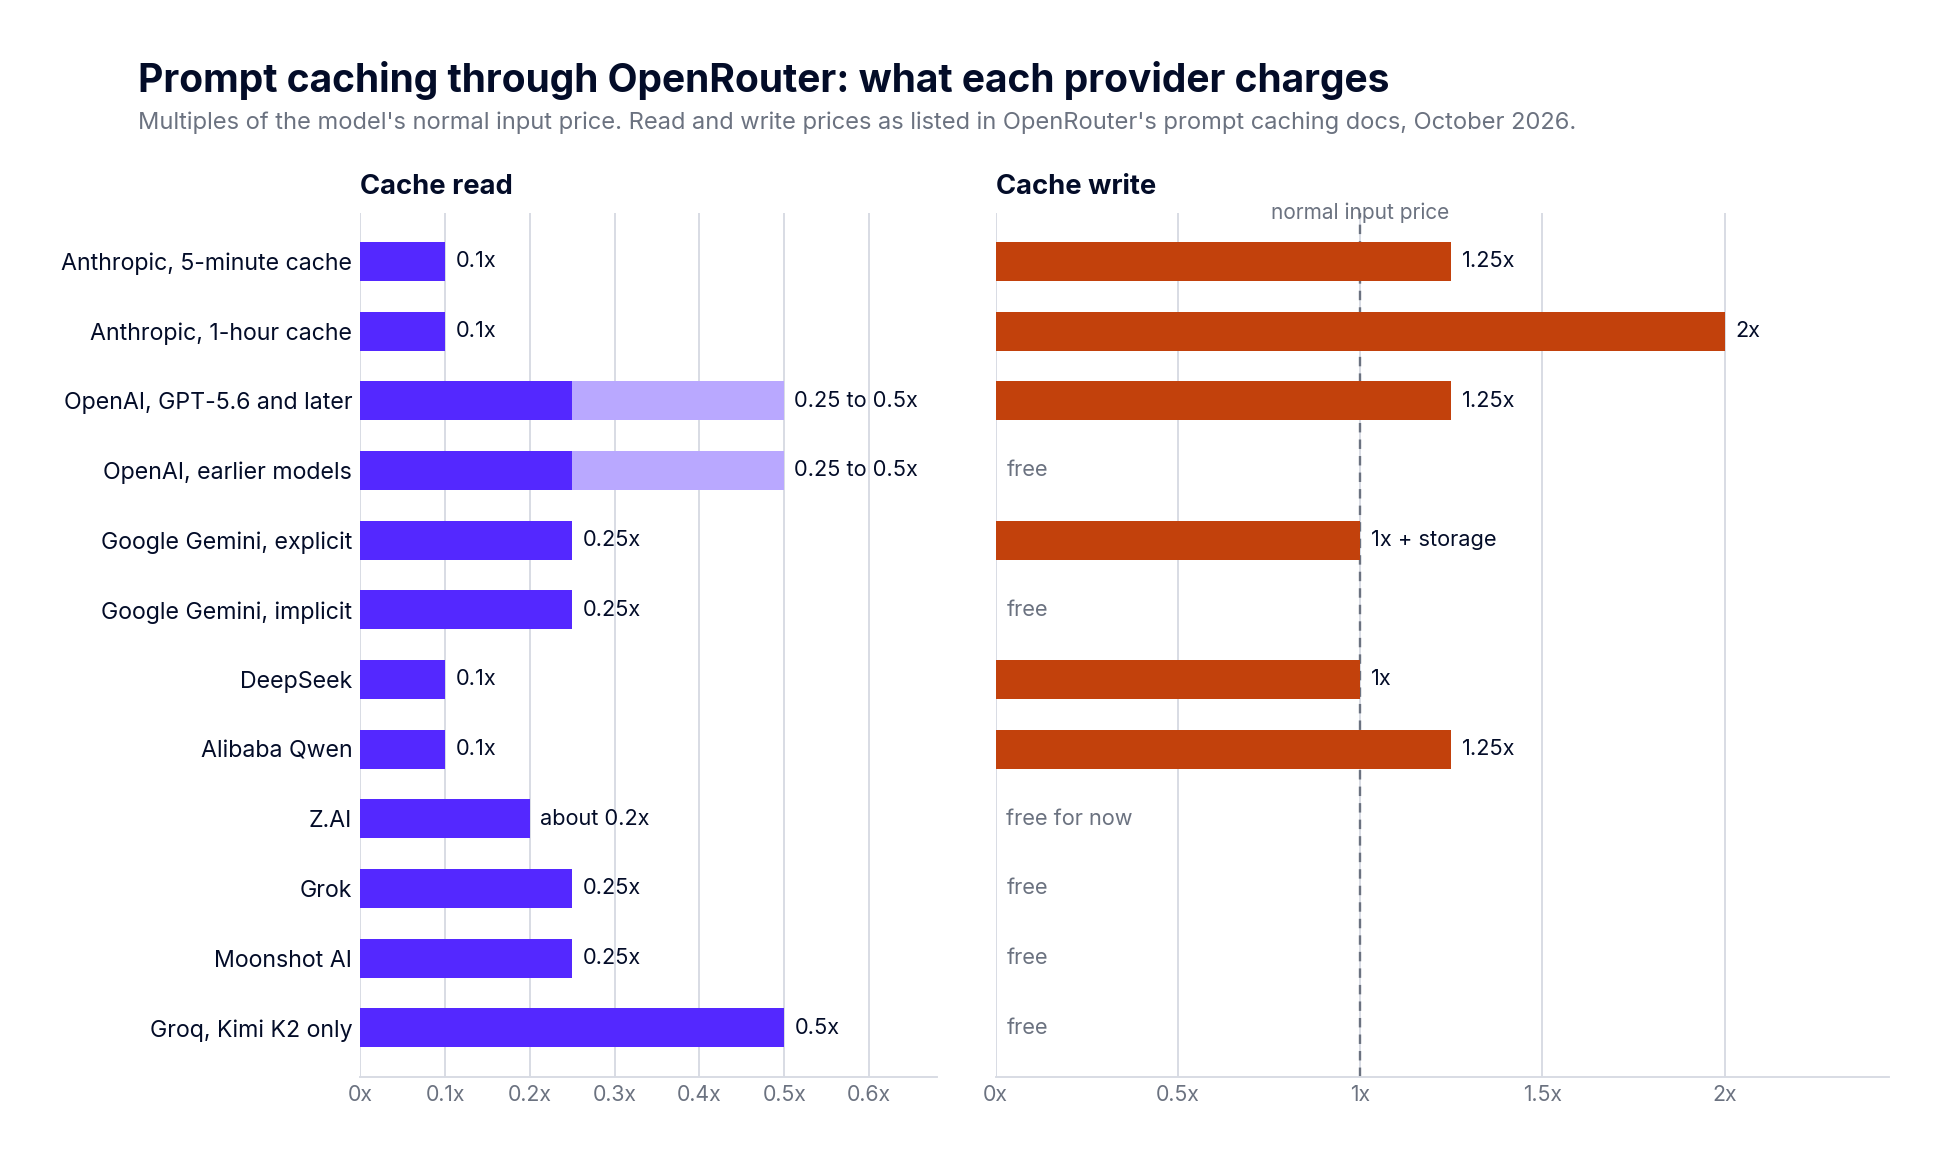
تتراوح أسعار القراءة من عشُر سعر الإدخال إلى نصفه، والكتابة من مجانية إلى الضعف. خمسة من المزودين التسعة ليس لديهم حد أدنى لطول المطالبة مدرج في وثائق OpenRouter. ومع الموديلات البديلة (fallbacks) أو Auto Router، يمكن لطلب واحد أن يهبط على صف مختلف عن الطلب السابق، مع ذاكرة مؤقتة باردة.
ما إذا كان التخزين المؤقت يوفر المال يعتمد على عدد المرات التي يتم فيها إرسال البادئة نفسها بينما تزال الذاكرة المؤقتة دافئة. باستخدام المضاعفات أعلاه، وحساب الجزء المخزن مؤقتًا فقط من المطالبة:
بقية كل طلب، سؤال المستخدم وأي شيء بعد آخر كتلة مخزنة مؤقتًا، تُحسب بالطريقة نفسها في كلتا الحالتين، لذا تنطبق هذه النسب على البادئة فقط.
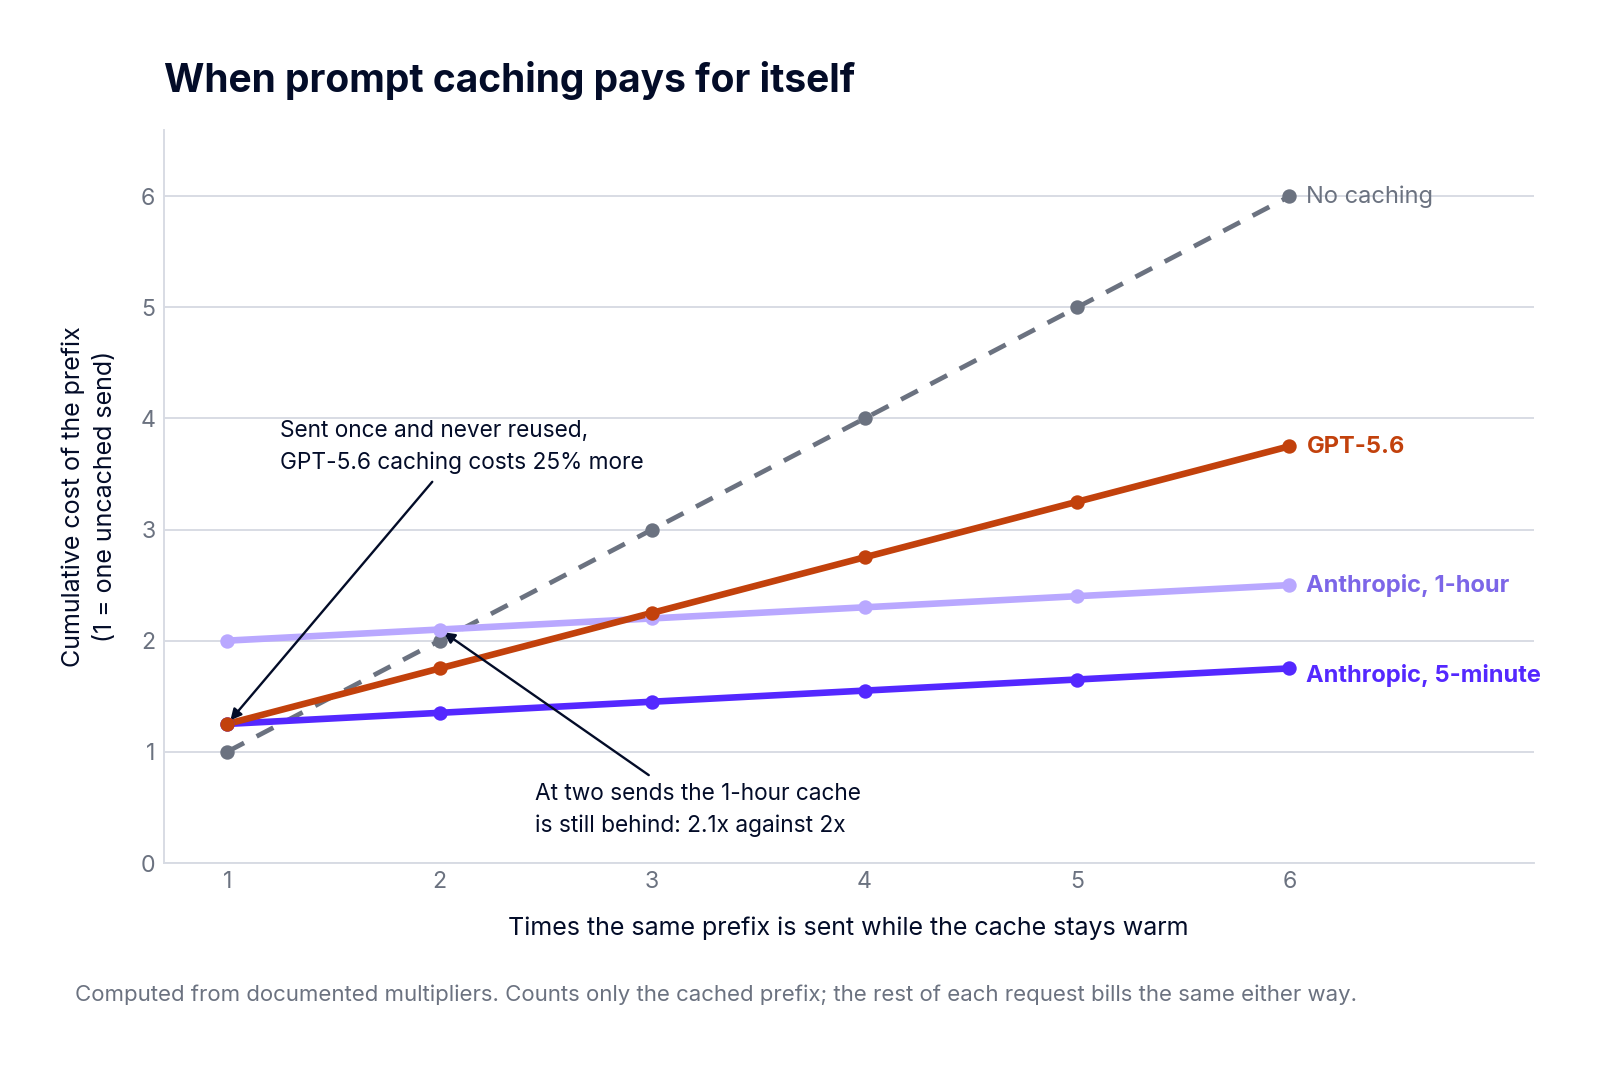
بالنسبة لمستويات معظم الجدول، تكون كتابة الذاكرة المؤقتة مجانية أو قريبة من ذلك، لذا فإن التخزين المؤقت خيار مجاني. غيرت GPT-5.6 ذلك بالنسبة لـ OpenAI. بدءًا من تلك العائلة، تُحسب كتابة الذاكرة المؤقتة بسعر 1.25x من سعر الإدخال تحت التخزين المؤقت التلقائي أيضًا، والتخزين التلقائي مفعّل سواء طلبته أم لا. أي مطالبة بحجم 1,024 token أو أكثر ترسلها مرة واحدة تدفع قيمة الكتابة ولا تستفيد أبداً من القراءة.
خذ مطالبة بحجم 2,000 token مُرسلة مرة واحدة. بدون تخزين مؤقت تُحسب كـ 2,000 token إدخال. مع تفعيل التخزين المؤقت، تدفع قريبًا مما تكلفه مطالبة بحجم 2,500 token. في مهمة ليليّة تلخص مليون مستند فريد وطويل، حيث يأتي المستند أولاً ولا يتكرر أي شيء في البداية مطلقًا، فهذه زيادة بنسبة 25% على معظم الإدخالات الخاصة بك.
الحل يتمثل في القراءة العكسية. اضبط prompt_cache_options.mode على "explicit" ولا تقم بتعليم أي كتلة محتوى بـ prompt_cache_breakpoint. يوقف الوضع الصريح (Explicit mode) نقاط الكسر التلقائية لـ OpenAI، ومع عدم وجود نقاط صريحة لا توجد بادئة قابلة للتخزين المؤقت، وبالتالي لا يتم كتابة أي شيء. يعود cache_write_tokens كصفر، وهو المكان الوحيد في هذه المقالة الذي يعني فيه الصفر ما تريده تمامًا.
الآن الجانب الآخر. Claude Sonnet 4.6 مع مطالبة نظام بحجم 5,000 token، و100 طلب عبر يوم عمل، تصل في 20 دفعة من خمسة طلبات مع وجود فواصل زمنية بين الدفعات تبلغ حوالي 20 دقيقة. بحساب مطالبة النظام فقط، مقاسه بالـ tokens المحسوبة بسعر الإدخال العادي:
تخفض الذاكرة المؤقتة لـ 5 دقائق التكلفة بمقدار الثلثين. وتخفض الذاكرة المؤقتة لـ ساعة واحدة التكلفة بنسبة 88%، لأن الفجوة البالغة 20 دقيقة تقضي على الذاكرة المؤقتة القصيرة في كل مرة ولا تصل إلى الطويلة أبداً. تحدّث Anthropic عمر الذاكرة المؤقتة في كل مرة تقرأ فيها، لذا يظل الإدخال الخاص بالساعة دافئًا طوال اليوم.
غير حركة المرور وتتغير الإجابة. إذا وصلت تلك الـ 100 طلب بشكل منتظم، واحد كل أربع دقائق تقريبًا، فلن تنتهي صلاحية الذاكرة المؤقتة لـ 5 دقائق أيضًا، وسيؤدي خيار الساعة الواحدة إلى دفع 10,000 مقابل كتابة تتعامل معها الذاكرة المؤقتة القصيرة بسعر 6,250. اختر الـ TTL من الفجوات بين طلباتك، وليس من عدد الطلبات التي ترسلها.
يحدد كل مزود حدًا أدنى لطول المطالبة لا يتم تخزين أي شيء تحته في الذاكرة المؤقتة. بالنسبة لـ Claude، وفقًا لوثائق OpenRouter:
حد OpenAI الأدنى هو 1,024. وحد Gemini هو 1,024 في 2.5 Flash و4,096 في 2.5 Pro. تحت الحد الأدنى ينجح الطلب، ويُحسب بسعر الإدخال الكامل، ويعود بحقول الذاكرة المؤقتة الخاصة به مضبوطة على صفر. لا يوجد خطأ، ولا يوجد تحذير.
هناك نتيجتان لهذا من السهل إغفالهما.
الموديلات الأحدث تملك حدودًا أدنى أعلى. مطالبة نظام بحجم 3,000 token تُخزن مؤقتًا على Sonnet 4.6 وتتوقف عن التخزين في اليوم الذي تنقلها فيه إلى Opus 4.7، دون تغيير في الكود ولا يوجد شيء في الاستجابة يخبرك بذلك. والانتقال من Haiku 3.5 إلى Haiku 4.5 يفعل الشيء نفسه لأي شيء بين 2,048 و4,096 token. ترقية الموديل تعد تغييرًا في التخزين المؤقت، لذا تحقق من معدل نجاح الذاكرة المؤقتة (cache hit rate) بعد الترقية.
ولا يمكنك التحقق من التخزين المؤقت من خلال البحث عن حقول الذاكرة المؤقتة. هذا ما تسبب في الخطأ باختبارنا الخاص. ترجع OpenRouter حقول cached_tokens وcache_write_tokens في الاستجابات من كل مزود، بما في ذلك المزودين الذين لا يدعمون التخزين المؤقت كخاصية أصلية، لذا فإن وجود الحقول لا يثبت أي شيء. والأصفار لا تثبت الكثير أيضًا. فهي تعني أنه تم تجاهل العلامة أو أن المطالبة كانت تحت الحد الأدنى، وفي Haiku 4.5 عند 3,600 token كان السبب هو الحد الأدنى.
إليك اختبار يخبرك بشيء مفيد:
cache_write_tokens أعلى من الصفر في الاستدعاء الأول. وتوقع أن يكون cached_tokens أعلى من الصفر في الاستدعاء الثاني.cache_discount في جسم الاستجابة. يكون سالبًا في كتابة Anthropic وموجبًا في القراءة.تقوم OpenRouter بترجمة علامات الذاكرة المؤقتة بين المزودين، وهو أمر مفيد. فكتلة النص التي تحمل نمط Anthropic مثل cache_control تصبح prompt_cache_breakpoint عند توجيهها إلى موديل GPT-5.6، وتصبح prompt_cache_breakpoint افتراضيًا cache_control لدى Anthropic أو Google.
لكن الـ TTL لا ينتقل معها. فالـ ttl في cache_control يتم إسقاطه في الطريق إلى OpenAI. وprompt_cache_options، حيث يعيش TTL الخاص بـ OpenAI، ينطبق فقط على OpenAI. ولا يحتوي prompt_cache_breakpoint على حقل TTL، لذا فإن أي شيء يصبح عليه في جانب Anthropic يحصل على الافتراضي وهو 5 دقائق.
تتصرّف أوقات العيش أيضًا بشكل مختلف بمجرد ضبطها. تتجدد ذاكرة Anthropic عند كل قراءة. بينما تستمر الذاكرة المؤقتة الصريحة لـ Gemini لمدة خمس دقائق من الكتابة ولا تتجدد. والذاكرة المؤقتة الضمنية لـ Gemini موثقة بأنها تستغرق من ثلاث إلى خمس دقائق في المتوسط، وتتغير. لذا فإن جسم طلب واحد يطلب ساعة قد يحصل على ساعة، أو خمس دقائق ثابتة، أو أي شيء تطبقه OpenAI، اعتمادًا على مكان هبوطه. يضيف Responses API فجوة أخرى: فهو لا يعرض cache_control لـ Anthropic لكل كتلة، لذا استخدم Chat Completions أو Messages endpoint إذا كنت بحاجة إلى TTL على كتلة محددة.
تكون الذاكرة المؤقتة مفيدة فقط إذا وصل طلبك التالي إلى المزود الذي يحتفظ بها. تتعامل OpenRouter مع ذلك من خلال التوجيه الثابت للمزود (provider sticky routing): بعد طلب يستخدم التخزين المؤقت، تذهب الطلبات المتابِعة للموديل نفسه إلى نقطة نهاية المزود نفسها.
يتم تتبع الثبات لكل حساب، ولكل موديل، ولكل محادثة، حيث يتم تحديد المحادثة عن طريق تجزئة (hashing) رسالة النظام الأولى ورسالة غير النظام الأولى. وتنتهي صلاحيته بعد 10 دقائق بدون طلب.
تميل الوكلاء (Agents) إلى كسر هذا الإعداد الافتراضي، لأن رسائل افتتاحها تتغير بين الأدوار. مرر session_id في الجسم أو ترويسة x-session-id وستستخدمها OpenRouter كمفتاح ثبات بدلاً من ذلك، بدءًا من الطلب الناجح الأول بدلاً من الانتظار لتحقيق إصابة في الذاكرة المؤقتة (cache hit). يعمل prompt_cache_key الخاص بـ OpenAI كمفتاح بديل إذا كنت ترشحه بالفعل.
ضبط provider.order يوقف التوجيه الثابت وتكون الأولوية لقائمتك. طالما أن خيارك الأول يعمل بجودة، فإن ذلك يكلف القليل، لأن التثبيت يرجعك إلى مزود واحد بأي حال. يظهر الاختلاف بعد الفشل والانتقال التلقائي (failover)، حيث كان التوجيه الثابت سيتبع المزود الذي خدمك بينما يبدأ التثبيت مرة أخرى من أعلى قائمتك. يظل التثبيت هو الخيار الصحيح عندما تحتاج إلى سعة متوقعة، كما ناقشنا في مقالنا حول حدود المعدل في OpenRouter. يملك Auto Router ميزة مماثلة: إذا سقط الموديل الذي اختاره من مرشحيه في دور لاحق، فستذهب الذاكرة المؤقتة معه.
بشكل منفصل عن كل ما سبق، ستقوم OpenRouter بتخزين الاستجابات بأكملها في الذاكرة المؤقتة إذا أرسلت X-OpenRouter-Cache: true. ترجع إصابة الذاكرة المؤقتة الاستجابة المخزنة دون الاتصال بالمزود، ولا تحسب أي رسوم، ولا تُحسب ضد حدود معدل المزود.
قمنا بقياس ذلك عبر ثلاث جولات من 100 إعادة طلب متطابقة لكل منها، على GPT-4o mini وClaude Haiku 4.5. كانت كل إعادة طلب عبارة عن إصابة ناجحة. كان متوسط وقت الاستجابة (Median latency) 2,867 ميلي ثانية عند الخطأ (miss) و59 ميلي ثانية عند الإصابة (hit)، وكانت إصابات Haiku أسرع عند 39 ميلي ثانية مقابل 64 إلى 69 ميلي ثانية لـ GPT-4o mini. في الجولة التي تم فيها اقتطاع الرسوم من الرصيد، كلف 100 خطأ 0.0174 دولار ولم يكلف 100 إصابة أي شيء.
تعتمد الإدخالات على مفتاح API بالإضافة إلى الموديل، ونوع نقطة النهاية، ووضع التدفق (streaming mode)، وجسم الطلب الكامل، لذا فإن الخدمات ذات المفاتيح المنفصلة لا تتشارك أي شيء وأي تغيير في المعاملات يعتبر خطأً (miss). وجد فحص TTL الخاص بنا، عينة واحدة لكل فترة زمنية، أن الإدخالات نشطة عند 120 ثانية واختفت بحلول 300 ثانية. لا يوجد TTL منشور، ولا يوجد تطابق جمالي (semantic matching) ولا يوجد تطهير (purge) موثق. إنها تمتص إعادة المحاولات والإرسالات المكررة. التكرار الساعي سيعتبر خطأً.
تقوم البوابة الخاصة بنا بالتخزين المؤقت في طبقة الاستجابة في وضعين. المطابقة التامة (Exact-match) ترجع استجابة مخزنة لطلب مطابق. بينما يقوم الوضع الجمالي (Semantic mode) بتضمين (embeds) الرسالة الأخيرة ويرجع استجابة مخزنة عندما يكون طلب سابق قريبًا بدرجة كافية، ويخدم إصابات المطابقة التامة أيضًا، لذا تشغل وضعًا واحدًا وليس كلاهما. يتم تشغيله باستخدام ترويسة طلب، مدعومًا بـ Redis، ويتكامل مع الذاكرة المؤقتة لمطالبات المزود: في حالة حدوث خطأ في البوابة، يظل التخزين المؤقت للبادئة الخاص بالمزود مفعلاً.
في نموذج SaaS، يكون موديل التضمين هو text-embedding-3-small بـ 1,536 بعدًا وغير قابل للتهيأة؛ أما في البيئة المحلية (on-prem) فتختاره على مستوى البوابة بأكملها. المطابقة الجمالية تملك وضع فشل لا تملكه المطابقة التامة. يفتتح دليل التخزين المؤقت الجمالي بذلك: يطلب عميلان معلومات حول تسليم الشحنة بفارق دقائق، وتتضمّن الأسئلة في متجهين متشابهين جدًا، ويحصل العميل الثاني على إجابة تتبع طلب العميل الأول. هذا خطأ في نطاق الوصول (scope bug). تغيير عتبة التشابه يغير مدى تكرار حدوث ذلك، ولكنه لا يوقف ذاكرة مؤقتة مشتركة بين العملاء.
ضيف عملية البحث في الذاكرة المؤقتة ما يقرب من 3 إلى 4 ميلي ثانية، وتتعامل البوابة مع أكثر من 350 RPS على vCPU واحد.
session_id لجلسات الوكلاء حتى يظل التوجيه على المزود الذي يحتوي على الذاكرة المؤقتة الخاصة بك.cached_tokens غير الصفرية، وليس بمجرد وجود الحقل.تعمل الذاكرة المؤقتة للمطالبات في OpenRouter، والوثائق هنا أكثر وضوحًا مما هي عليه للعديد من الميزات المحيطة. لا يزال لديك تسعة مخططات تسعير، وحدود أدنى ترتفع في الموديلات الأحدث، وأوقات عيش تتغير في الترجمة، واستجابة تبدو كما هي سواء حدث التخزين المؤقت أم لا. تحقق من الحد الأدنى، ضع النص الثابت أولاً، وتحقق باستخدام الأرقام بدلاً من الحقول.
لتهيأة التخزين المؤقت مرة واحدة لكل مزود، مع وجود المطابقة الجمالية أعلى الذاكرة المؤقتة للبادئة الخاصة بالمزود، شاهد كيف تتعامل TrueFoundry AI Gateway مع التخزين المؤقت.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Yes, as long as the prompt clears the model's minimum length. Claude Haiku 4.5 and Opus 4.5 and later need 4,096 tokens, and Sonnet 4.x needs 1,024. Below that floor the request succeeds at full price with cache fields at zero, which looks exactly like the marker being ignored.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
نعم. تعمل TrueFoundry في VPC الخاصة بك أو محلياً أو في بيئة معزولة عن الشبكة أو هجينة، فلا تغادر التعليمات والردود نطاقك أبداً حتى وأنت توجّه الطلبات عبر مزوّدين كثيرين.



أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد