


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
اختر تقريبًا أي منتج قائم على LLM تم إطلاقه في السنوات الثلاث الماضية وافحص API الخاص به. ستكون الاحتمالات عالية في أنه يقبل طلبًا يحتوي على حقل model، ومصفوفة messages من كائنات {role, content}، وtemperature، ويرجع مصفوفة choices مع كتلة usage تحسب الرموز (Tokens). لم يأتِ هذا الشكل من هيئة معايير قياسية، بل جاء من Chat Completions API الخاص بـ OpenAI، وقد فرض سيطرته.
بالنسبة لفريق المنصة، تعد عبارة "المتوافق مع OpenAI" عبارة أساسية وتحمل أهمية كبرى. فهي السبب في أنه يمكنك تقييم نموذج مفتوح الوزن جديد يوم الجمعة وجعله يخدم حركة المرور يوم الاثنين دون إعادة كتابة تطبيقك. وهي أيضًا عبارة تفرط في الوعود بصمت: إذ يمكن لنقطتي نهاية أن تكونا "متوافقين مع OpenAI" ومع ذلك تختلفان في كيفية إرجاع استدعاءات الأدوات، وكيفية حساب الرموز، وما إذا كانت المعلمة التي تعينها تؤدي شيئًا بالفعل.
يشرح هذا المنشور ما هو المعيار الفعلي، وما يضمنه "التوافق" وما لا يضمنه، وكيف تحول البوابة العديد من المزودين المتوافقين جزئيًا إلى نقطة نهاية واحدة يمكنك البناء عليها بثقة.
هل تريد نقطة نهاية واحدة متوافقة مع OpenAI عبر كل مزود، مع خدمة تجاوز الفشل وتتبع التكاليف؟ احجز عرضًا توضيحيًا.
عادة ما تنجح المعايير لواحد من سببين: إما لأنها إجبارية، أو لأنها تصل أولاً ويتم اعتمادها قبل أن يصمم أي شخص بديلاً. ومخطط Chat Completions ينتمي تمامًا إلى النوع الثاني.
نشرت OpenAI نقطة النهاية /v1/chat/completions، والأهم من ذلك أنها أطلقت حزم SDK رسمية بـ Python وJavaScript لتغليفها. وتم دمج حزم SDK تلك في البرامج التعليمية، والقوالب الأولية، وتكاملات أطر العمل، وقواعد البرمجيات الإنتاجية عبر الصناعة. وبحلول الوقت الذي أصبح فيه لدى المزودين المنافسين نماذج تستحق التقديم، كانت واجهة التكامل قد أصبحت معيارية بالفعل في الممارسة العملية: حيث كانت ملايين الأسطر البرمجية تعرف بالفعل كيفية استدعاء client.chat.completions.create(...).
واجه المزود الجديد حينها خيارين: إما تصميم API أنيق خاص بك ومطالبة النظام البيئي بأكمله بتعلمه، أو تطبيق مخطط OpenAI والاقتران بكل حزمة SDK وإطار عمل وأداة مجانًا. اختار الجميع تقريبًا المسار الثاني. واعترمدت مجموعات التقديم مفتوحة الوزن هذا المخطط بحيث يمكن الوصول فورًا إلى أي شيء يعمل عليها من الرموز البرمجية الحالية. والنتيجة هي معيار واقعي دون وثيقة معايير رسمية: المخطط هو "كل ما ترسله حزمة SDK الخاصة بـ OpenAI وتتوقع استلامه".
هذا هو السبب في أن العبارة أكثر أهمية مما تبدو عليه. التوافق ليس ميزة يضيفها البائع للتحسين. بل هو تذكرة الدخول إلى النظام البيئي، وهو يحدد كيفية بناء هندستك البرمجية حول خيار النموذج.
إذا جردنا الأمر، فإن التوافق هو عقد حول أربعة أشياء: نقطة النهاية، ونمط الطلب، ونمط الاستجابة، والبث (Streaming).
نقطة النهاية. تقبل الخدمة المتوافقة POST /v1/chat/completions مع الترويسة Authorization: Bearer <key>. ويطبق العديد منها أيضًا /v1/models، و/v1/embeddings، و/v1/completions. يتغير URL الأساسي حسب المزود؛ بينما لا يتغير المسار.
نمط الطلب. كحد أدنى: سلسلة نصية لـ model ومصفوفة messages من الكائنات التي تحتوي على role (system، user، assistant، tool) وcontent. تتضمن المعلمات الاختيارية التي يمكن للعميل إرسالها temperature، top_p، max_tokens (تستخدم نماذج OpenAI الأحدث max_completion_tokens)، stream، stop، tools، tool_choice، وresponse_format.
نمط الاستجابة. كائن JSON يحتوي على مصفوفة choices؛ يحتوي كل خيار على index، وmessage مع role وcontent (وtool_calls عندما يستدعي النموذج دالة)، وfinish_reason (stop، length، tool_calls، content_filter). يبلغ كائن usage عن prompt_tokens، وcompletion_tokens، وtotal_tokens.
البث. مع stream: true، تكون الاستجابة عبارة عن text/event-stream من الأحداث المرسلة من الخادم (Server-sent events). يحمل كل خط data: قطعة (Chunk) يحتوي choices[].delta الخاص بها على الرمز (أو الرموز) المتزايدة. ينتهي البث بنص صريح data: [DONE].
إليك الميزة الملموسة. يستهدف جسم الطلب هذا OpenAI:
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
لتشغيل نفس الموجه (Prompt) ضد مزود مختلف من خلال نقطة نهاية متوافقة، يمكنك تغيير أمرين: URL الأساسي وقيمة model. حقول messages، وtemperature، وstream تبقى كما هي دون تغيير. ولا تتغير برمجية التحليل الخاصة بك، التي تقرأ choices[0].message.content وusage.total_tokens، على الإطلاق. تلك هي القيمة المقترحة الكاملة في فارق واحد: أصبح اختيار النموذج مجرد سلسلة نصية، وليس إعادة كتابة للرمز البرمجي.
والاستجابة، أيًا كانت الخلفية التي قدمتها، تعود بالشكل التالي:
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
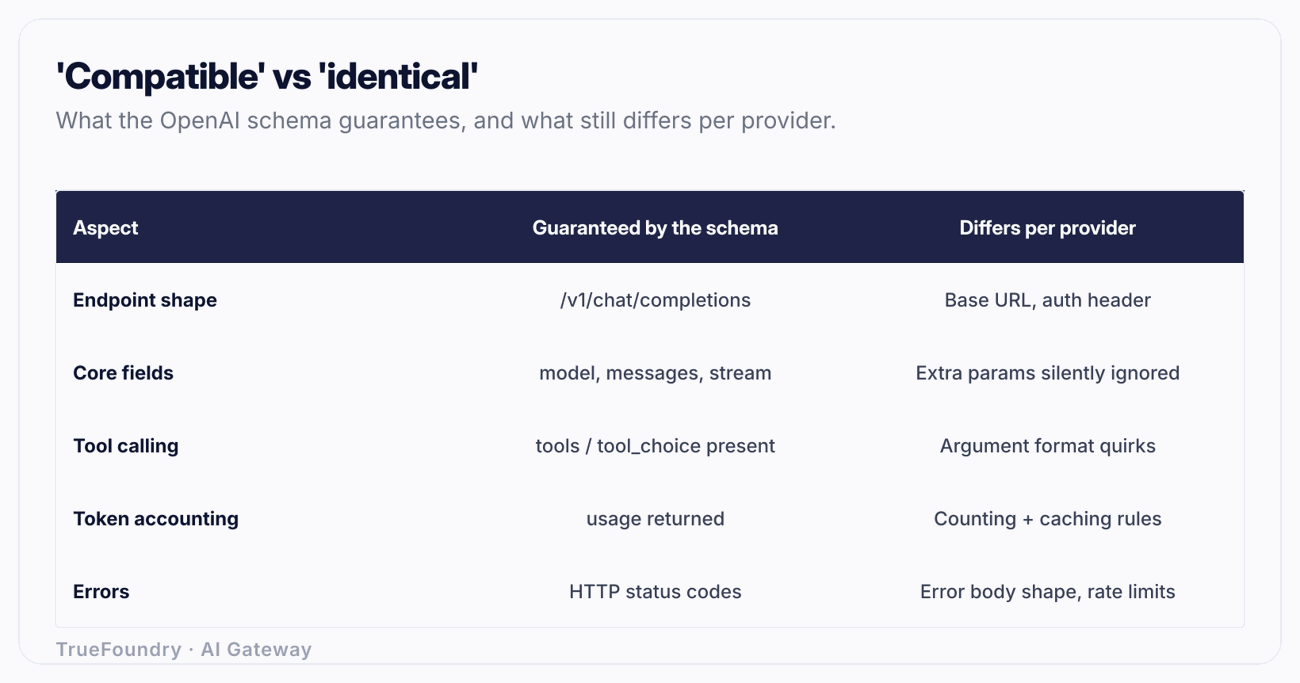
هنا تقع الفرق في الأخطاء. "المتوافق مع OpenAI" هو ادعاء حول المخطط، وليس ضمانًا للسلوك المطابق. الإطار الخارجي يتطابق؛ بينما قد تختلف المحتويات بطرق لا تظهر إلا تحت ضغط العمل أو في الحالات الخاصة.
لهجات استدعاء الأدوات (Tool-calling). التباين الأكبر. ترجع OpenAI استدعاءات الدوال في message.tool_calls، كل منها مع id، وtype، وكائن function تكون قيمته في arguments عبارة عن كتلة JSON منسقة كسلسلة نصية يجب عليك تحليلها. ترجع بعض الخلفيات المتوافقة الوسائط ككائن تم تحليله بالفعل، أو تصدر حقل function_call الفردي القديم، أو تبث فروق استدعاء الأدوات بشكل مختلف، أو تتعامل مع استدعاءات الأدوات المتوازية بشكل غير متسق. والرمز البرمجي الذي يقوم بتحليل الوسائط عبر JSON.parse بشكل أعمى سيتوقف عن العمل على خلفية قامت بتحليلها بالفعل.
حساب الرموز. يتم حساب إجمالي usage بواسطة المحلل اللغوي (Tokenizer) الخاص بكل مزود. يؤدي نفس الموجه المرسل إلى نموذجين إلى قيم مختلفة لـ prompt_tokens لأن المحللات اللغوية تختلف. والأسوء من ذلك، أن بعض الخلفيات تحذف usage تمامًا في استجابات البث ما لم تقم بتعيين علامة (Flag)، لذا فإن تتبع التكلفة الذي يعتمد عليه يقرأ صفرًا بصمت.
معلمات لا تنفذ شيئًا بصمت. يمكنك إرسال seed، أو logit_bias، أو frequency_penalty، أو presence_penalty، أو response_format: {type: "json_schema"} إلى نقطة نهاية متوافقة وتستلم 200 OK بالمقابل، مع تجاهل المعلمة تمامًا. قبلت نقطة النهاية الحقل لأن المخطط يسمح به؛ لكن الخلفية لا تطبقه ببساطة. هذا هو أخطر أنواع الأخطاء البرمجية لأنه لا يظهر أي خطأ. وخط المعالجة "المحدد" الذي يعتمد على seed يصبح غير محدد بصمت.
التعامل مع موجه النظام والأدوار. تدمج بعض الخلفيات رسالة system في دور المستخدم الأول، أو تدعم رسالة نظام واحدة فقط، أو تتعامل مع content الفارغ بشكل مختلف. ويمكن أن ينحرف السلوك متعدد الأدوار.
دلالات سبب الإنهاء (Finish-reason). عندما يتوقف النموذج لأنه يريد استدعاء أداة، تبلغ OpenAI عن finish_reason: "tool_calls". لا تستخدم كل الخلفيات نفس السلسلة النصية، مما يكسر حلقات الوكيل (Agent loops) التي تتفرع بناءً عليها.
يفصل الجدول أدناه بين ما يقدمه لك المعيار بموثوقية وما يجب عليك التحقق منه لكل مزود.
النتيجة ليست "التوافق وهمي". بل هي "التوافق يمنحك 90% مجانًا ويجب عليك اختبار الـ 10% الأخيرة لكل مزود". وتلك الـ 10% الأخيرة هي بالتحديد العمل الذي يمكن للبوابة امتصاصه حتى لا يراه تطبيقك أبدًا.
شاهد كيف تتيح لك TrueFoundry تبديل النماذج بالاسم دون لمس الرمز البرمجي للتطبيق. احجز عرضًا توضيحيًا.
إذا كان كل مزود متوافقًا غالباً ولكن مختلفًا بشكل خفي، فإن المعمارية النظيفة هي التوقف عن جعل تطبيقك يتحدث إلى كل مزود. ضع نقطة نهاية واحدة متوافقة مع OpenAI أمامهم جميعًا ودع تلك الطبقة تتولى الترجمة والتسوية.
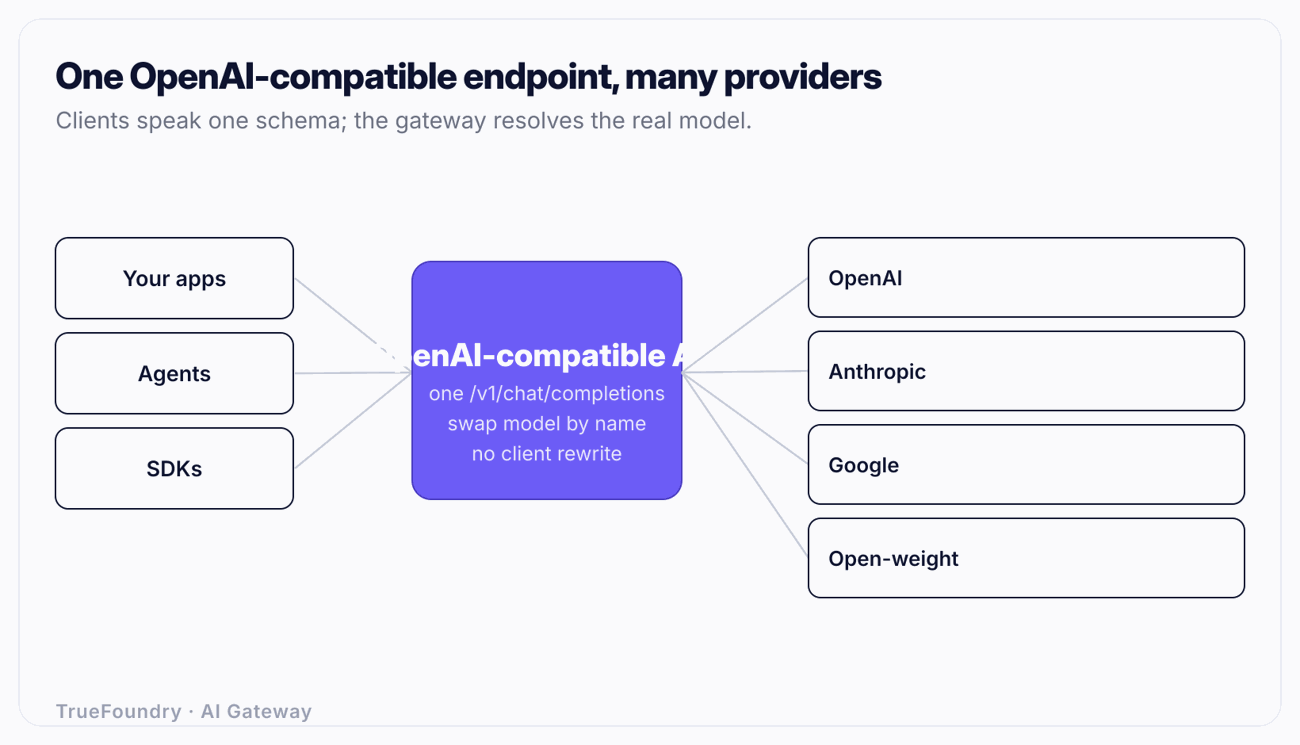
هذا ما تفعله بوابة الذكاء الاصطناعي (AI Gateway)، وهي تنظيميًا نفس فكرة وكيل LLM (LLM Proxy): باب أمامي منطقي واحد، وخلفه العديد من الخلفيات. تعرض TrueFoundry API موحدًا ومتوافقًا مع OpenAI أمام كل مزود. يستمر تطبيقك في إرسال نمط Chat Completions الذي يعرفه بالفعل. للتبديل بين النماذج، يمكنك تغيير قيمة model إلى اسم منطقي تقوم البوابة بتحليله؛ بينما يظل كل شيء آخر، نص الطلب، وحزمة SDK، والتحليل، ثابتًا.
ولأن البوابة تقوم بتسوية الفروق الموضحة أعلاه، فإن رمزك البرمجي يتوقف عن الاهتمام بما إذا كانت خلفية معينة تحول وسائط استدعاء الأدوات إلى نص أو تبلغ عن usage في البث المباشر. حيث تقدم البوابة لهجة واحدة متسقة. وقد جعلت المكتبات مفتوحة المصدر مثل LiteLLM طبقة الترجمة هذه شائعة في الرمز البرمجي؛ ويشرح مقالنا حول ما هو LiteLLM هذا النهج وأين تتفوق البوابة المدارة.
ولكن السبب في اعتماد هذا النمط ليس مجرد واجهة مرتبة. بمجرد تدفق كل طلب عبر نقطة نهاية واحدة، فإنك تفتح إمكانيات من المستحيل إضافتها إلى التكاملات المشتتة لكل مزود:
التوجيه (Routing). يمكن أن يكون اسم النموذج المنطقي مدعومًا بعدة أهداف حقيقية، وتختار البوابة من بينها حسب زمن الانتقال (Latency)، أو الوزن، أو الأولوية. راجع ما هو موجه LLM لاختيار النماذج بناءً على التكلفة والجودة.
تجاوز الفشل (Fallback). إذا أرجع المزود خطأ 500 أو انتهت مهلته، تعيد البوابة المحاولة أثناء الطلب ضد هدف بديل، بحيث لا يظهر انقطاع المزود الواحد كخطأ للمستخدم. هذا هو موضوع تجاوز الفشل في LLM.
التخزين المؤقت (Caching). يقلل التخزين الدقيق والتخزين المؤقت الدلالي عند البوابة من زمن الانتقال والإنفاق للموجهات المكررة أو شبه المكررة، بشفافية، خلف نفس نقطة النهاية.
إمكانية الملاحظة ونسب التكلفة. لأن كل طلب يمر عبر مكان واحد، فإنك تحصل على مقاييس التكلفة والرموز وزمن الانتقال لكل طلب، مخصصة حسب المستخدم، والفريق، والنموذج، مما يغذي إمكانية ملاحظة LLM ونسب التكلفة لميزانيات الفريق. لا يمنحك التكامل المباشر مع كل مزود أيًا من هذا دون أدوات قياس مخصصة على كل منها.
لم تتطلب أي من هذه الميزات اعتماد API جديد. بل جاءت من توحيد الواجهة الواحدة التي تستخدمها بالفعل. إذا كنت تزن الخيارات، فإن مقال كيفية اختيار بوابة الذكاء الاصطناعي يوضح المعايير.
القرار ليس عقائديًا؛ بل يتعلق بعدد المزودين الذين تتعامل معهم ومدى اهتمامك بالمرونة وشفافية التكلفة.
التكامل المباشر مبرر عندما تستدعي مزودًا واحدًا فقط ولن تستدعي غيره أبدًا. ولكن في اللحظة التي تريد فيها نموذجًا ثانيًا، أو المرونة ضد الانقطاع، أو مصدرًا واحدًا للحقيقة بشأن التكلفة، فإن البوابة تغطي تكاليفها بنفسها.
افتراض أن المتوافق يعني المطابق. المخطط يتطابق؛ أما السلوك فلا يتطابق دائمًا. تنقل الفرق الموجه إلى خلفية أرخص، وتراه "يعمل"، ثم تقوم بالنشر، لتكتشف بعد أسابيع أن seed تم تجاهله وأن المخرجات لم تكن قابلة للتكرار أبدًا. اختبر المعلمات التي تعتمد عليها بالفعل ضد كل خلفية.
الثقة في usage للتكلفة دون التحقق من البث. تحذف عدة خلفيات كتلة usage في استجابات البث ما لم يُطلب ذلك صراحةً. ولوحات معلومات التكلفة المبنية عليها تقرأ صفرًا وتبدو رائعة حتى تصل الفاتورة الحقيقية. تحقق من وجود الاستخدام في نمط الطلب الدقيق الذي تشغله في الإنتاج.
كتابة URL الأساسي وحزمة SDK بشكل ثابت لكل مزود. هذا يعيد خلق التشتت الذي كان من المفترض أن يقضي عليه المعيار. يصبح كل نموذج جديد مشروع تكامل ويصبح كل انقطاع للمزود انقطاعًا لديك. وحد العمل على نقطة نهاية واحدة واجعل اختيار النموذج عبارة عن تكوين، وليس رمزًا برمجيًا.
تحليل وسائط استدعاء الأدوات دون حماية التنسيق. ترجع بعض الخلفيات arguments كسلسلة نصية، والبعض الآخر ككائن. والتحليل الأعمى عبر JSON.parse يتوقف عند الأخير. قم بتوحيد الشكل قبل التحليل، أو دع البوابة تقوم بتوحيده لك.
التعامل مع البوابة كبنية تحتية مجردة. نقطة النهاية هي الجزء السهل. القيمة الحقيقية تكمن فيما تتيحه نقطة الاختناق الواحدة: التوجيه، وتجاوز الفشل، والتخزين المؤقت، والميزانيات، ونسب التكاليف، وهي أمور لا يمكنك إضافتها بتكلفة منخفضة على N من التكاملات المباشرة.
أصبح مخطط OpenAI Chat Completions معيارًا ليس بقرار رسمي بل بوصوله أولاً واعتماده في كل مكان. "المتوافق مع OpenAI" هو تذكرة الدخول إلى ذلك النظام البيئي: أرسل نمط الطلب المألوف، وقم بتفكيك الاستجابة المألوفة. يمنحك هذا قدرة كبيرة، خيار النموذج كسلسلة تكوين، طالما أنك تحترم أن المتوافق ليس مطابقًا وتختبر السلوكيات التي تعتمد عليها بالفعل.
الطريقة الأنسب للحصول على هذه الميزة دون مشاكل هي التوحيد على نقطة نهاية واحدة متوافقة مع OpenAI أمام كل مزود. يحتفظ تطبيقك بالواجهة التي يعرفها بالفعل، وتتمتص البوابة تفاصيل كل مزود مع إضافة التوجيه، وتجاوز الفشل، والتخزين المؤقت، والميزانيات، ونسب التكلفة التي لا يمكنك إضافتها أبدًا إلى التكاملات المشتتة. واجهة واحدة في الأمام؛ وكل النماذج خلفها.
وحد كل مزود لـ LLM خلف API واحد متوافق مع OpenAI. احجز عرضًا توضيحيًا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




