


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Updated: نوفمبر 20, 2026
Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
سؤال "ما هو أفضل نموذج لغوي كبير للبرمجة؟" هو سؤال خاطئ، لأنه لا توجد إجابة ثابتة له. فالنموذج الذي يكتب دالة نظيفة من 40 سطراً ليس هو نفسه الذي تريده أن يستهلك الرموز (tokens) في عملية إعادة هيكلة تشمل 30 ملفاً، والنموذج الذي يحل ثغرة معقدة في التزامن (concurrency) هو خيار مبالغ فيه لمجرد الإكمال التلقائي لدالة getter. تتغير نتائج الاختبارات المعيارية كل بضعة أسابيع؛ فالفريق الذي يبرمج نموذجاً واحداً في أدواته في يناير سيضطر لإعادة تقييم قراره بحلول أبريل.
السؤال الأفضل هو: بالنسبة لهذه الفئة من مهام البرمجة، وضمن هذه الميزانية، إلى أي نموذج يجب أن أوجه الطلب؟ وكيف يمكنني التحكم في الإنفاق والأمان عندما يقوم مئة مطور بالإجابة على هذا السؤال بطرق مختلفة؟ هذا هو السؤال الذي تجيب عليه هذه المقالة. سنستعرض المتنافسين بناءً على نقاط قوتهم الفعلية، ونقدم لك إطار عمل لاتخاذ القرار بناءً على نوع المهمة، وهو إطار يدوم طويلاً بغض النظر عن أي اختبار معياري، ثم نغطي الجزء الذي تتجاهله معظم الفرق: طبقة التوجيه والحوكمة التي تجعل اختيار النموذج مجرد قيمة إعدادات بدلاً من إعادة كتابة الكود.
ملاحظة أولية حول الدقة: أسعار نماذج Claude من Anthropic المذكورة أدناه تم التحقق منها حتى نوفمبر 2026. أما أرقام الاختبارات المعيارية للمنافسين فهي أرقام مُبلغ عنها أو مجمعة؛ وقد قمنا بذكر مصادرها وتواريخها، وعليك إعادة التحقق منها مع كل مزود قبل استثمار أموالك فيها.
هل ترغب في تتبع التكاليف لكل مطور ووضع ضوابط أمان عبر جميع نماذج البرمجة؟ احجز عرضاً توضيحياً.
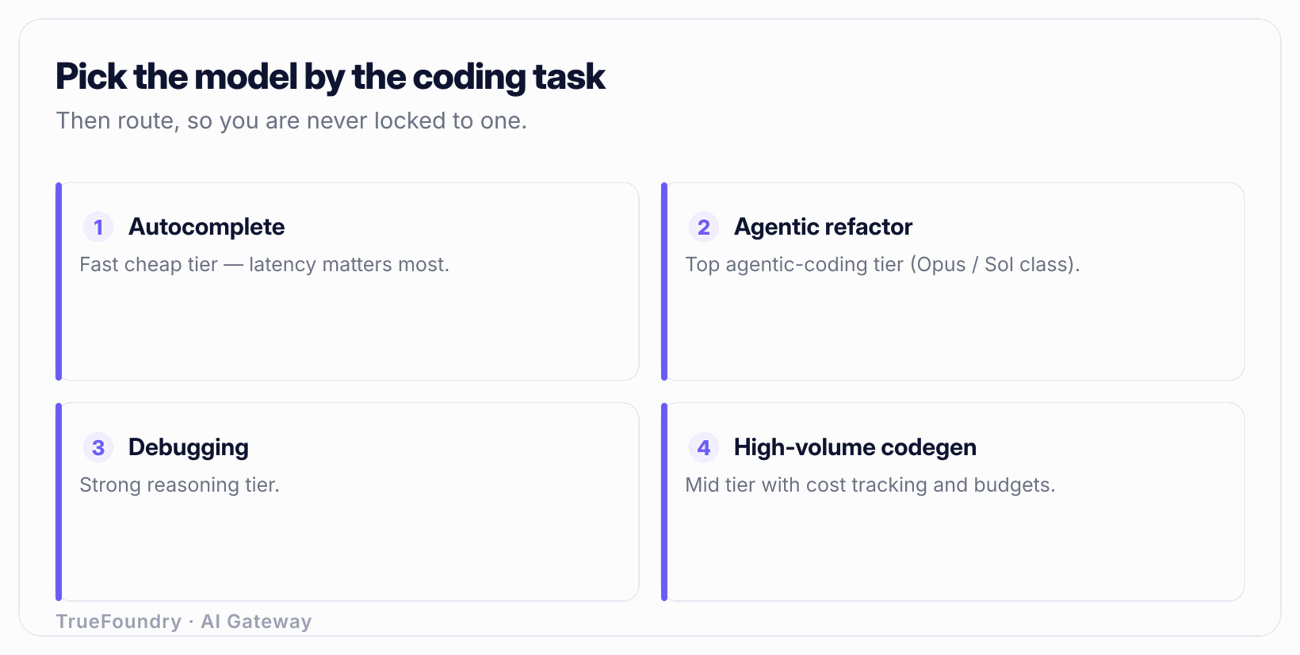
قبل أن تتمكن من اختيار نموذج، يجب أن تحدد طبيعة العمل. تفشل معظم مقارنات "أفضل نموذج لغوي للبرمجة" لأنها تعتمد على متوسط أداء مهام ذات متطلبات متناقضة. قسّم البرمجة إلى أربعة أنماط وسيتضح لك الاختيار بشكل أكبر.
الإكمال التلقائي / الإكمال المضمن. يتوقع النموذج الأسطر القليلة التالية أثناء الكتابة. زمن الاستجابة هو كل شيء؛ فأي تأخير يتجاوز 300-500 مللي ثانية يقطع تدفق العمل. السياق محدود (الملف الحالي بالإضافة إلى بضعة ملفات مجاورة). أنت تقوم بآلاف الطلبات من هذا النوع يومياً لكل مطور، لذا فإن تكلفة الوحدة هي العامل الحاسم. أنت بحاجة إلى نموذج سريع ورخيص، وليس النموذج الأكثر ذكاءً.
إعادة الهيكلة متعددة الملفات (Agentic). يقوم النموذج بالتخطيط، وقراءة العديد من الملفات، وإجراء تعديلات على عدة ملفات، وتشغيل الاختبارات، والتكرار؛ وهي حلقة عمل قد تستمر لدقائق وتستهلك مئات الآلاف من الرموز في مهمة واحدة. هنا تظهر قيمة عمق التفكير، وتماسك السياق الطويل، والقدرة على الالتزام بالخطة عبر خطوات متعددة. وهذا أيضاً هو المكان الذي يكون فيه النموذج الضعيف أكثر تكلفة، لأنه يهدر الرموز في محاولات فاشلة ثم يقدم لك تعديلات برمجية (diff) معطلة.
التصحيح العميق للأخطاء. مشكلة صعبة واحدة: حالة سباق (race condition)، أو تسريب ذاكرة، أو خطأ غامض لا يظهر إلا تحت ضغط العمل. حجم العمل منخفض، لكن قيمة حله بشكل صحيح عالية جداً. أنت تريد أقصى جودة في التفكير ومستعد للدفع مقابل ذلك لكل حالة على حدة.
توليد الكود عالي الحجم. الهياكل الأساسية، الكود المتكرر (boilerplate)، نماذج الاختبار، نصوص الترحيل، توثيق الدوال (docstrings)؛ كميات كبيرة من الكود المباشر. متطلبات الجودة متوسطة؛ بينما الأداء وتكلفة التوليد هما العاملان الحاكمان. عادة ما يتفوق النموذج متوسط المستوى في إجمالي تكلفة الملكية.
نادراً ما تتوافق هذه الأنماط الأربعة مع نموذج واحد. فالمطور نفسه، وفي الساعة نفسها، يحتاج إلى نموذج سريع ورخيص للإكمال التلقائي، ونموذج تفكير عميق للخطأ الذي يعيقه، ونموذج قوي لإعادة الهيكلة التي بدأها في الخلفية. هذا هو السبب الهيكلي لفشل توحيد المعايير على نموذج واحد.
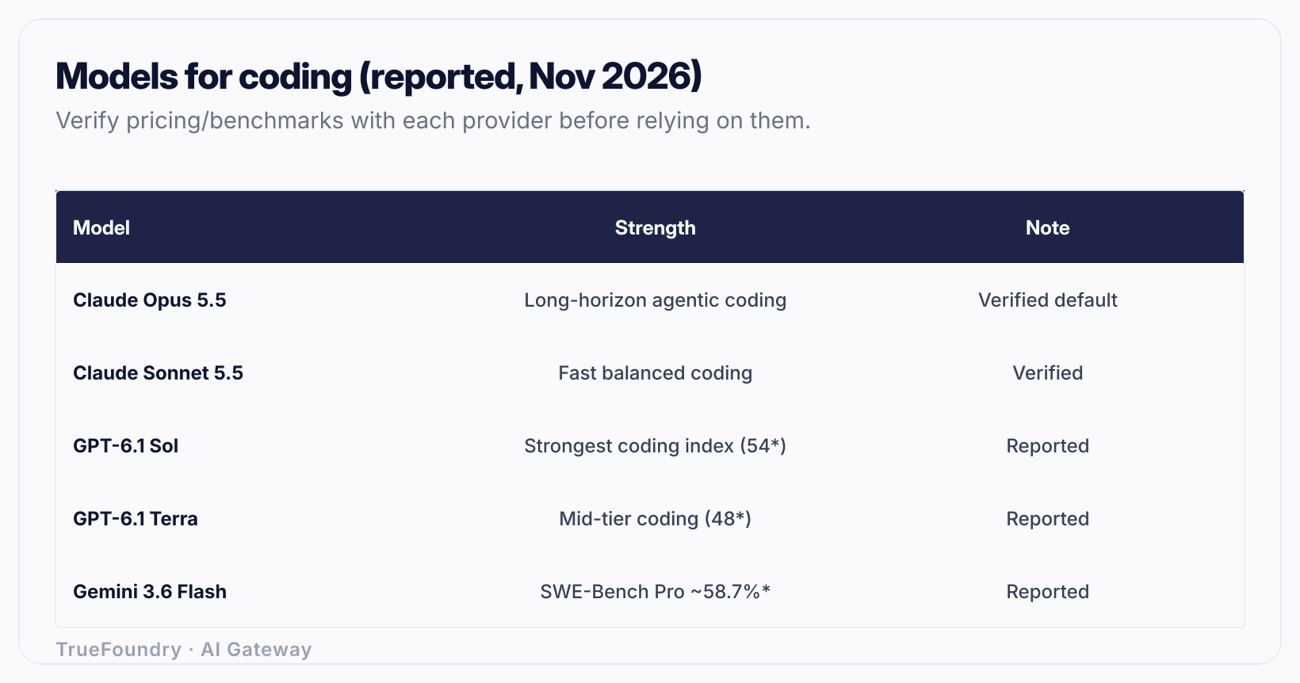
إليك الوضع الراهن بكل شفافية حتى نوفمبر 2026. أسعار Claude مؤكدة، أما البقية فهي تقارير وينبغي التحقق منها مجدداً.
تتوزع نماذج Claude 5.5 بوضوح على أنماط المهام المذكورة أعلاه:
النمط العملي هو استراتيجية التدرج ضمن Claude وحده — Haiku للإكمال التلقائي والمهام الضخمة، Sonnet لمعظم أعمال الوكلاء، وOpus لإعادة الهيكلة الصعبة وجلسات تصحيح الأخطاء المعقدة.
حتى نوفمبر 2026، تشير التقارير إلى وضع GPT-6.1 Sol في صدارة قدرات البرمجة العامة، بمؤشر برمجة تجميعي يبلغ حوالي 54، و GPT-6.1 Terra في مرتبة تالية عند حوالي 48. تم وضع Sol كنموذج برمجي رائد، بينما Terra كفئة أسرع وأرخص. تعامل مع أرقام المؤشر كدلالات توجيهية فقط، فهي تأتي من تجميع طرف ثالث وليس من اختبار معياري موحد، كما يجب التأكد من أسعار OpenAI وأسماء فئاتها على موقعهم الرسمي قبل تخصيص الميزانية.
Gemini 3.6 Flash سجلت نسبة 58.7% تقريبًا في اختبار SWE-Bench Pro، وهو معيار يقيس الإصلاحات البرمجية التي تحاكي طلبات السحب (pull requests) في مستودعات برمجية حقيقية. إذا ثبتت صحة هذا الرقم، فإن Flash يعد منافسًا قويًا في مهام هندسة البرمجيات العملية ضمن فئة تركز على السرعة والتكلفة. نكرر: هذه أرقام مُبلغ عنها حتى نوفمبر 2026، يرجى التحقق منها عبر Google.
تقيس اختبارات SWE-Bench ومؤشرات البرمجة قدرة النموذج على إنتاج تصحيح برمجي صحيح لمشكلات مختارة بعناية. لكنها لا تقيس كيفية أداء النموذج داخل وكيلك ، أو على وكيلك قاعدة برمجية خاصة بك وكيلك ، أو مع استخدام أدوات وحدود سياق معينة. قد يتفوق نموذج بنقطتين في اختبار عام، لكنه قد يفشل فشلًا ذريعًا في الواقع إذا كان أبطأ، أو كان نافذة سياقه الفعلية أصغر، أو إذا كان أداؤه أسوأ مع لغتك أو إطار عملك. استخدم المعايير لإنشاء قائمة مختصرة، ثم قم بإجراء تقييمك الخاص على مهام تشبه عملك الفعلي.
إليك المشهد العام كما ورد في هذا الجدول. اقرأ التنبيه الموجود أدناه قبل الاستشهاد بأي من هذه الأرقام.
تنبيه: أسعار Claude تم التحقق منها حتى نوفمبر 2026. جميع أرقام المنافسين هي أرقام مُبلغ عنها أو مجمعة من أطراف ثالثة حتى نوفمبر 2026، وهي غير قابلة للمقارنة المباشرة عبر أدوات قياس مختلفة؛ لذا يرجى إعادة التحقق من المواصفات والتوافر والأسعار مع كل مزود قبل الاعتماد عليها.
بدلًا من اختيار "أفضل نموذج"، اختر نموذجًا افتراضيًا لكل نوع من المهام و مسار تصعيد. هذا هو الجزء الذي يظل صحيحًا حتى عندما تتغير ترتيبات لوحة الصدارة في الشهر المقبل.
المنطق هو: ابدأ كل مهمة بأقل فئة تكلفة تنجح بشكل موثوق، ولا تلجأ للتصعيد إلا عند وجود إشارة ملموسة؛ مثل فشل الاختبارات، أو كون التغييرات البرمجية كبيرة جدًا، أو وقوع الوكيل في حلقة مفرغة. إن إعادة هيكلة برمجية قد يفسدها نموذج متوسط المستوى في عشر محاولات مكلفة، ستكون أقل تكلفة عند استخدام نموذج من الفئة الأولى ينجزها في محاولتين. وبالمقابل، فإن إكمال مهمة بسيطة قد يتقنها نموذج من الفئة الأولى لا يزال خيارًا غير اقتصادي، لأنك تقوم بهذا الإجراء عشرة آلاف مرة يوميًا.
لاحظ ما يتطلبه هذا الإطار عمليًا: القدرة على إرسال طلبات مختلفة إلى نماذج مختلفة بناءً على نوع المهمة والإشارات، دون الحاجة إلى إعادة كتابة التطبيق. هذا هو التوجيه (routing)، وهنا يأتي دور البوابة (gateway). راجع اختيار النموذج الواعي بالتكلفة والجودة لمعرفة كيفية برمجة هذا المنطق، و ماهية موجه نماذج اللغة (LLM router) للآليات.
اكتشف كيف تقوم TrueFoundry بتوجيه حركة بيانات البرمجة وتحديد سقف للإنفاق لكل مطور. احجز عرضاً توضيحياً.
تخيل مؤسسة تضم 200 مطور. يعمل البعض على Cursor، والبعض الآخر على Claude Code، بينما يفضل قلة منهم Copilot في VS Code، ويقوم فريق البيانات باستدعاء النماذج مباشرة من دفاتر الملاحظات (notebooks). تعتمد كل أداة على نماذج مختلفة، ولكل مطور تفضيلاته الخاصة. حتى لو فرضت نموذجاً واحداً اليوم، سيظهر نموذج أفضل بعد ستة أسابيع، وسيتجاوز أفضل مهندسيك هذا القرار.
هذا ليس فشلاً في الانضباط، بل هو الوضع النهائي الصحيح. فالمهام المختلفة تتطلب نماذج مختلفة، والأدوات المختلفة توفر نماذج متنوعة، كما أن حدود التكنولوجيا تتغير شهرياً. إن محاربة هذا التشتت معركة خاسرة. الحركة الذكية هي التوقف عن محاولة توحيد النموذج وبدلاً من ذلك توحيد نقطة التحكم أمام النماذج.
بشكل ملموس، يعني هذا أن كل وكيل برمجي في المؤسسة — سواء كان Claude Code أو Cursor أو Copilot أو نصوصاً برمجية داخلية — يتصل بنقطة نهاية واحدة متوافقة مع OpenAI بدلاً من الاتصال المباشر بواجهة برمجة تطبيقات كل مزود. خلف نقطة النهاية هذه، يمكنك تحديد التوجيه، ورؤية كل طلب، وفرض السياسات. يصبح النموذج مجرد قيمة في الإعدادات. استبدال Sonnet بنموذج أحدث، أو إضافة GPT-6.1 Sol لتصحيح الأخطاء، يصبح مجرد تغيير في الإعدادات، وليس ترحيلاً برمجياً على مستوى المؤسسة بالكامل.
تقوم بوابة الذكاء الاصطناعي (AI gateway) بالتمركز بين وكلائك البرمجيين ومزودي النماذج، موفرة واجهة برمجة تطبيقات موحدة ومتوافقة مع OpenAI. بالنسبة للبرمجة تحديداً، هناك أربع قدرات جوهرية.
تخصيص التكلفة لكل مطور وفريق ونموذج. تستهلك الوكلاء البرمجيون كميات هائلة من الرموز (tokens) بشكل يفاجئ الإدارة المالية. يمكن لعملية إعادة هيكلة برمجية واحدة أن تستهلك أكثر من 300,000 رمز في مهمة واحدة. بدون تخصيص التكاليف، ستحصل على فاتورة واحدة غير مفصلة من المزود ولن تعرف ما إذا كان الإنفاق ناتجاً عن عمليات إعادة الهيكلة التي يقوم بها فريق المنصة أم بسبب حلقة برمجية مفرطة لمطور واحد. تقوم البوابة بتصنيف كل طلب حسب المستخدم والفريق والنموذج، مما يتيح لك الإجابة على سؤال "من أنفق ماذا وعلى أي نموذج" وصولاً إلى مستوى الطلب الفردي. هذا هو أساس تخصيص التكاليف وميزانيات الفرق و العمليات المالية للذكاء الاصطناعي (FinOps for AI) بشكل عام.
الميزانيات وحدود المعدل لكل مطور أو فريق. حدد ميزانية شهرية بالدولار لكل فريق وحدًا أقصى لمعدل الطلبات لكل مطور. عند تجاوز الحد، تُرجع البوابة رمز الخطأ HTTP 429 بدلاً من تراكم التكاليف بصمت. هذا ما يمنع الوكيل الذي تمت تهيئته بشكل خاطئ من الدخول في حلقة مفرغة قد تؤدي إلى فواتير باهظة بين عشية وضحاها. يتم شرح الآليات في تحديد معدل الرموز والميزانيات.
ضوابط الحماية ضد تسريب الأسرار. تقرأ وكلاء البرمجة الكود المصدري الخاص بك. قد يحتوي الكود على بيانات اعتماد مشفرة، وأسماء مضيفين داخلية، وبيانات عملاء في ملفات الاختبار، ومعلومات تعريف شخصية (PII). يمكن إرسال أي من هذه البيانات إلى مزود النموذج ضمن المطالبة. يمكن للبوابة فحص الطلبات الصادرة بحثاً عن الأسرار ومعلومات التعريف الشخصية وحظرها أو تنقيحها قبل مغادرتها لشبكتك. بالنسبة للمؤسسات الخاضعة للتنظيم، غالباً ما يكون هذا هو الفارق بين "الموافقة" و"الحظر". راجع ضوابط حماية الذكاء الاصطناعي لمعرفة أنواع الكشف المتاحة.
التدقيق والمراقبة. سجل كامل لكل طلب — من المستخدم، وما هو النموذج المستخدم، وعدد الرموز، وزمن الاستجابة، والتكلفة، وحالة النجاح/الفشل في ضوابط الحماية. عندما يسأل فريق الأمن "هل تسرب أي من أكوادنا إلى نموذج خارجي في الربع الأخير؟"، ستكون لديك إجابة واضحة بدلاً من التخمين. اربط سجل البوابة بـ أدوات مراقبة النماذج اللغوية الكبيرة (LLM) لتتبع زمن الاستجابة والجودة بمرور الوقت.
توفر بوابة الذكاء الاصطناعي من TrueFoundry مستوى التحكم هذا بالضبط؛ فهي واجهة برمجة تطبيقات موحدة متوافقة مع OpenAI، وتتميز بتوجيه يعتمد على زمن الاستجابة/الأوزان/الأولوية، ونسخ احتياطي تلقائي، وإعادة محاولة الطلبات، وتخزين مؤقت دقيق ودلالي، وميزانيات وحدود معدل استخدام لكل مستخدم/فريق/نموذج، ومراقبة كاملة لكل طلب، بالإضافة إلى حواجز حماية لمعلومات التعريف الشخصية (PII) والأسرار وحقن الأوامر. يمكن نشرها كخدمة سحابية (SaaS)، أو داخل سحابتك الخاصة (VPC)، أو محلياً، أو في بيئات معزولة تماماً، مما يضمن بقاء البيانات التي تحمل الكود المصدري الخاص بك داخل شبكتك.
لنضع الأمر في إطار ملموس. ثلاثة مطورين، أسبوع واحد، مهام عمل مختلفة:
ثلاثة مطورين، ثلاثة أنماط من المهام، ثلاث فئات، وإجمالي إنفاق أسبوعي يقارب 40 دولاراً؛ حيث تكلف عملية إعادة الهيكلة العميقة للمطور ج حوالي 14 ضعف تكلفة عمليات الإكمال للمطور أ. الآن تخيل وجود 200 مطور دون نظام لتخصيص التكاليف: سترى فاتورة واحدة ولن تتمكن من التمييز بين الاستخدام الفعال والاستخدام المفرط. مع البوابة، ستعرف أن إعادة هيكلة المطور ج كانت مكلفة ومستحقة، وأن عمليات الإكمال للمطور أ تتسم بالكفاءة، وإذا بدأ وكيل مطور رابع في العمل بشكل متكرر في الساعة الثانية صباحاً، فإن سقف الميزانية سيوقف العملية عند رمز الخطأ 429 قبل أن يتفاقم الأمر.
الأرقام أعلاه تستخدم أسعار Claude المعتمدة وأرقاماً تقريبية للتوضيح؛ ستختلف أعداد الرموز الفعلية لديك. المغزى هو الهيكلية: طبيعة المهمة تحدد الفئة، والفئة تحدد التكلفة، وتخصيص التكاليف هو ما يحول إجمالي الفاتورة المخيف إلى بند مالي مُدار.
مطاردة صدارة التصنيفات. تقوم الفرق بإعادة اختيار "نموذج البرمجة الموحد" الخاص بها في كل مرة يتم فيها تحديث معيار قياس (benchmark)، مما يضطرهم لإعادة ضبط الأدوات في كل مرة. عادة ما يكون الفرق في الأداء الناتج عن المعيار أصغر من تكلفة هذا التغيير المستمر. اختر إعدادات افتراضية لكل نمط مهمة، وقم بالتوجيه، واترك البوابة تتعامل مع تغييرات النماذج كتعديلات في الإعدادات.
توجيه كل شيء إلى النموذج الأقوى. إن استخدام نماذج مثل Opus 5.5 أو GPT-6.1 Sol للإكمال التلقائي يبدو خياراً آمناً، لكنه في الواقع استنزاف صامت للموارد؛ فأنت تدفع تكاليف باهظة مقابل مهام ذات حجم كبير وقيمة منخفضة. وازن بين مستوى النموذج وطبيعة المهمة، فالنموذج الأقل تكلفة الذي ينجز المهمة بنجاح هو الخيار الأمثل.
لا توجد آلية لتحديد التكاليف إلا عند وصول الفاتورة. تكتشف العديد من الفرق حجم الإنفاق على وكلاء البرمجة فقط عندما يثير القسم المالي الأمر. وبحلول ذلك الوقت، لا يمكنهم تحديد الفريق أو السلوك الذي تسبب في هذا الإنفاق. يجب أن تكون آلية تحديد التكاليف قائمة قبل توسيع نطاق التراخيص، وليس بعده.
تجاهل تسرب الأسرار والمعلومات الشخصية (PII) من الكود المصدري. إن أكبر خطر يواجه وكلاء البرمجة ليس في كتابة كود خاطئ، بل في تسريب كود صحيح. تحتوي ملفات المصدر على بيانات اعتماد ومعلومات عملاء، ويقوم الوكلاء بإرسالها إلى نماذج طرف ثالث. إذا لم تكن لديك حواجز حماية للمخرجات، فأنت تعرض أسرارك للتسريب ولن تكتشف ذلك إلا أثناء مراجعة الحوادث الأمنية.
التعامل مع اختيار النموذج كمسألة برمجية داخل التطبيق. إن تضمين أسماء النماذج ومفاتيح واجهة برمجة التطبيقات (API keys) بشكل ثابت داخل كل أداة وخدمة يعني أن أي تغيير في النموذج يتطلب عملية نشر برمجية جديدة. اجعل الاختيار خلف بوابة (Gateway)، وبذلك يصبح اختيار النموذج قراراً سياسياً يُتخذ مرة واحدة ويُطبق في كل مكان.
إن مفهوم "أفضل نموذج لغوي للبرمجة" هو هدف متغير، وملاحقته مضيعة للوقت. الاستراتيجية المستدامة هي التوقف عن اختيار نموذج واحد والبدء في إدارة محفظة نماذج: فئة اقتصادية وسريعة لعمليات الإكمال والمهام الضخمة، وفئة متوازنة لعمل اليومي للوكلاء، وفئة متقدمة لإعادة الهيكلة المعقدة والتصحيح العميق، مع وجود إشارة تصعيد واضحة بينها. يتوافق تقسيم نماذج Claude (Opus/Sonnet/Haiku) حالياً مع هذا الإطار بشكل مباشر، كما تمنحك أرقام GPT-6.1 وGemini خيارات للتصعيد والمقارنة يمكنك إضافتها كإعدادات.
ما يجعل هذه المحفظة قابلة للحوكمة هو الطبقة التي تسبقها. قم بتوجيه كل وكيل برمجة عبر بوابة ذكاء اصطناعي واحدة، وسيصبح اختيار النموذج مجرد قيمة في الإعدادات، وتصبح التكاليف قابلة للتخصيص لكل مطور وفريق، وتوقف الميزانيات الإنفاق غير المنضبط عند حد 429، وتمنع حواجز الحماية تسريب أسرار الكود المصدري إلى مزود الخدمة. هكذا تظل في طليعة التكنولوجيا دون أن تفقد السيطرة على الفاتورة أو نطاق المخاطر.
تحكم في استخدام النماذج لوكلائك البرمجيين من خلال بوابة واحدة. احجز عرضاً توضيحياً.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد


