


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
تفتح Maxim AI لنفسها مساحة غير معتادة في سوق الأدوات. معظم الشركات تختار مساراً واحداً: إما أن تكون منصة تقييم، أو منصة مراقبة، أو بوابة. تقوم Maxim بالتقييم والمراقبة وتوفر أيضاً Bifrost، وهي بوابة مفتوحة المصدر مكتوبة بلغة Go توفر API متوافقاً مع OpenAI للعديد من المزودين، مع التبديل الآلي عند الفشل (failover)، والتخزين التلقائي الدلالي (semantic caching)، وبوابة MCP، وحوكمة المفاتيح الافتراضية، والنشر داخل VPC.
بالنسبة لبعض الفرق، هذا الشمول هو سبب الجذب: مزود واحد، علاقة واحدة، من التقييم حتى التوجيه (routing). وبالنسبة لفرق أخرى، هذا بالتحديد هو سبب بدئهم في البحث عن بدائل. الشمول عبر فئتين من المنتجات قد يعني أن أياً منهما ليس بعمق الأداة المتخصصة، كما أنه يطرح تساؤلاً عما إذا كنت تشتري لوحة تحكم واحدة متكاملة أم منتجين يتشاركان شعاراً واحداً.
هذا الدليل ليس هجوماً على الأداة. Maxim وBifrost هما أدوات موثوقة. الهدف هو مساعدة المشتري الذي يقيّمهما على فهم الأسباب التي تدفع الآخرين للبحث في مكان آخر، واستعراض البدائل الحقيقية مقسمة حسب احتياجك الفعلي: تقييمات عميقة، أم بوابة مؤسسية، أم كلاهما في مكان واحد.
هل تريد بوابة وحوكمة ومراقبة في لوحة تحكم واحدة للمؤسسات؟ احجز عرضاً توضيحياً.
لنبدأ بوصف منصف، لأن اختيار البديل يتطلب معرفة ما تقوم باستبداله.
Maxim (المنصة) هي منتج لتقييم ومراقبة AI. فهي تدعم دورة حياة التقييم، ومجموعات البيانات (datasets)، والتقييم دون اتصال (offline evaluation)، والتقييم باستخدام النموذج كحكم (LLM-as-judge scoring)، ومراقبة الإنتاج، والتتبع (tracing) لتطبيقات LLM والوكلاء (agents). إذا كانت مشكلتك هي "لا يمكننا قياس ما إذا كان تطبيق AI الخاص بنا يتحسن أم يسوء"، فهذا هو النصف من Maxim الموجه إليك.
Bifrost (البوابة) هي مكون منفصل ومفتوح المصدر: بوابة مكتوبة بلغة Go، وهو أمر مهم لأن Go تتجنب حد الأداء المتزامن (concurrency ceiling) الذي يؤثر على الوكلاء (proxies) المستندين إلى Python تحت الضغط العالي. تتحدث Bifrost عبر API متوافق مع OpenAI مع العديد من المزودين، وتوفر التبديل الآلي عند الفشل بينها، وتدعم التخزين التلقائي الدلالي، وتتضمن بوابة MCP للوصول إلى الأدوات، وتوفر حوكمة المفاتيح الافتراضية، ويمكن تشغيلها داخل VPC الخاص بك. كطبقة للتوجيه والتبديل عند الفشل، فهي تتمتع بإمكانيات قوية بالفعل.
أين يتردد المسبترون؟
لا شيء من هذا يجعل Maxim خياراً سيئاً. هي مجرد أسباب أدت بفرق معينة إلى تقييم الخيارات المتاحة، لذا دعنا نرسم خريطة لهذه الخيارات.
تنقسم البدائل بوضوح على طول الخط نفسه الذي يمر عبر Maxim نفسها: التقييم/المراقبة من جهة، والبوابة/الحوكمة من جهة أخرى. وقليل من الأدوات، بما في ذلك TrueFoundry، تغطي الكليتين.
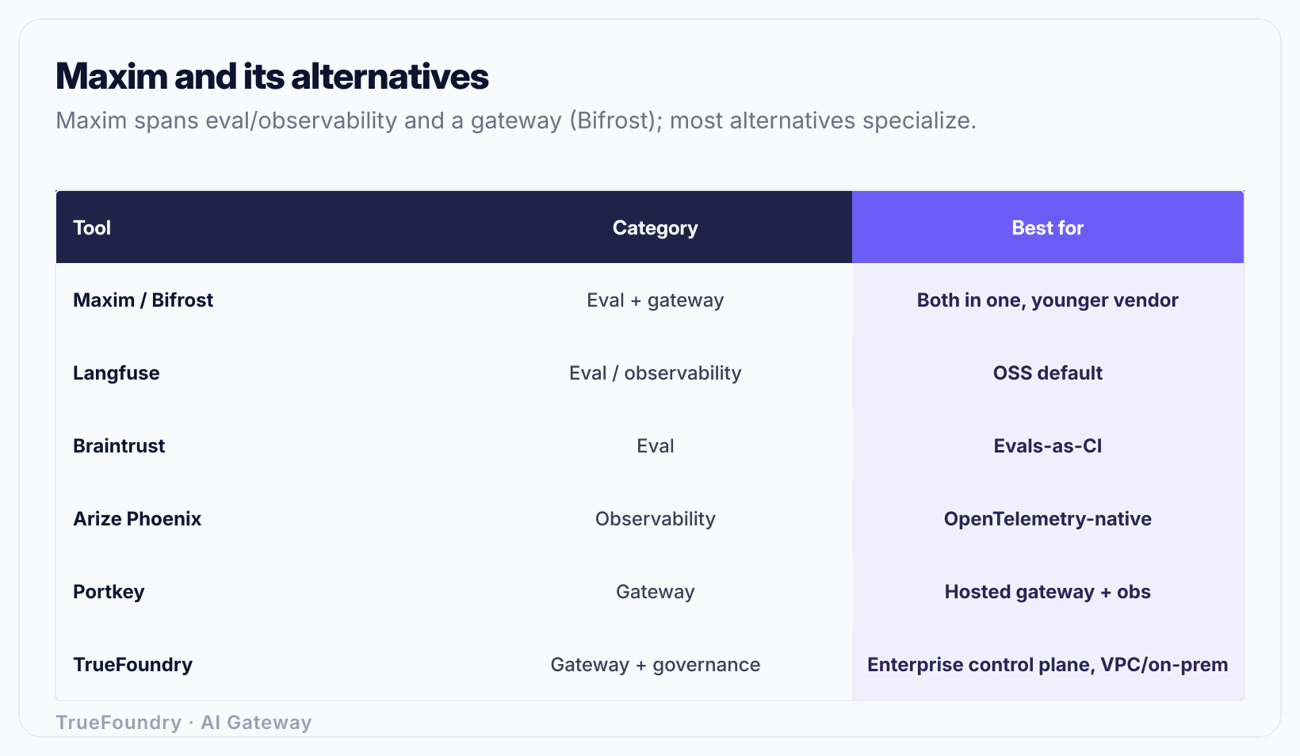
فهم الجانب الذي تقع فيه مشكلتك الحقيقية هو القرار بأكمله. إذا كنت تعاني من "عدم القدرة على تحديد ما إذا كانت الإجابات جيدة"، فأنت بحاجة إلى جانب التقييم. إذا كنت تعاني من "عدم وجود تحكم في المبالغ التي تنفقها الفرق وعلى أي نماذج، وتشتت الأسرار (secrets)"، فأنت بحاجة إلى جانب البوابة والحوكمة. تحتاج العديد من الفرق في النهاية إلى الكليتين، ولهذا السبب تبرز أهمية مسألة الدمج.
إذا كان ما جذبك إلى Maxim هو نصف التقييم والمراقبة، فهؤلاء هم المتخصصون.
Langfuse. مفتوحة المصدر، قابلة للاستضافة الذاتية أو مدارة. الخيار الأكثر اكتمالاً بين الأدوات مفتوحة المصدر، حيث يجمع بين التتبع (tracing)، والتقييمات، وإدارة التوجيهات (prompt management)، ومجموعات البيانات. الاختيار الطبيعي إذا كنت تريد إمكانيات التقييم/المراقبة في Maxim ولكن مع كونها مفتوحة المصدر وتحت سيطرتك الخاصة، خاصة لأسباب تتعلق بإقامة البيانات (data-residency).
Arize Phoenix. مفتوحة المصدر ومعتمدة أصلياً على OpenTelemetry. إذا كانت مؤسستك قد اعتمدت معيار OpenTelemetry، فإن تتبعات Phoenix تتكامل مع البنية التحتية الحالية وتتجنب تنسيقات التتبع الاحتكارية. قوية في تصحيح أخطاء RAG والاسترجاع (retrieval debugging).
Braintrust. مدارة، تركز على التقييم أولاً، ومبنية حول مفهوم التقييم كجزء من التكامل المستمر (evals-as-CI): التقييم مدمج في دورة التطوير بحيث يتم تقييم كل تغيير ومقارنته مثل التجميع والاختبار. الأفضل عندما تكون فجوتك الرئيسية هي حظر التراجع (regression gate) عند تغيير التوجيهات باستمرار.
LangSmith. مدارة، تم بناؤها بواسطة فريق LangChain ومتكاملة وثيقاً مع LangChain وLangGraph. إذا كانت بنيتك التقنية تعتمد بالفعل على LangChain، فإن رؤى التتبع ومسارات الوكلاء تأتي تقريباً بشكل تلقائي.
Comet Opik. مفتوحة المصدر، من سلالة أدوات Comet ML، وتغطي التتبع والتقييمات مع فحوصات مدمجة بأسلوب الحماية (guardrails). مناسبة لمستخدمي Comet الحاليين وللفرق التي تريد أداة تقييم مفتوحة المصدر تتضمن فحوصات الإشراف والضبط.
للاطلاع على زاوية المراقبة تحديداً، راجع مراجعتنا لـ أدوات مراقبة LLM وأفضل منصات مراقبة AI لـ LLMs.
إذا كان ما جذبك إلى Maxim هو Bifrost (البوابة)، فهذه هي البدائل، وهي تختلف كثيراً في مدى كون الحوكمة مدمجة أصلياً.
TrueFoundry. بوابة AI للمؤسسات بالإضافة إلى بوابة MCP والحوكمة، مع API موحد متوافق مع OpenAI. التوجيه (الزمن الانتقالي Latency، الوزن Weight، الأولوية Priority)، والتبديل عند الفشل مع إعادات المحاولة داخل الطلب (in-request retries)، والتخزين التلقائي الدقيق والدلالي، والميزانيات وحسب حدود المعدل (rate limits) لكل مستخدم وفريق ونموذج، ومراقبة كاملة لكل طلب مع إسناد التكلفة (cost attribution)، وحواجز حماية مدمجة (inline guardrails)، كل ذلك تحت لوحة تحكم واحدة مع RBAC وSSO وSCIM والتدقيق (audit). يمكن نشرها كـ SaaS، أو داخل VPC، أو في المقر (on-prem)، أو معزولة شبكياً (air-gapped)، مع بقاء طبقة البيانات داخل شبكتك. هذا هو بديل Bifrost للفرق التي تريد البوابة والحوكمة والمراقبة كمنتج واحد بدلاً من أجزاء مجمعة. نغطي المقارنة المباشرة في مقالنا عن بديل Bifrost.
Portkey. بوابة AI بالإضافة إلى المراقبة. يقوم النواة مفتوحة المصدر بالتوجيه والتبديل عند الفشل وموازنة الأحمال فقط، بينما تعيش المراقبة والمفاتيح الافتراضية والتخزين التلقائي وإدارة التوجيهات في المنتج المستضيف، وتتوفر خصائص SSO والامتثال وVPC وإخفاء هوية PII في خطة المؤسسات (Enterprise) فقط. قادرة، ولكن الإمكانية التي تحتاجها قد تكون وراء مستوى اشتراك يتعين عليك الدفع للوصول إليه. إذا كنت تفاضل بين الخيارات، فإن مقارنتنا لـ Portkey مقابل LiteLLM توضح هذه المستويات.
LiteLLM. مفتوحة المصدر (ترخيص MIT)، وكيل (proxy) لـ LLM بلغة Python يدعم أكثر من 100 مزود، مع مستوى للمؤسسات يضيف SSO وSCIM والميزانيات وحدود المعدل والتدقيق. وكيل ممتاز كبداية. الأسباب التي تجعل الفرق تتجاوزه محددة: حد الأداء المتزامن لـ Python يحدد إنتاجية العمليات والزمن الانتقالي تحت الضغط العالي، والوكيل يركز كل أسرار المزودين في مكان واحد (نطاق تأثير الخلل كبير)، والتوفر العالي المستضاف ذاتياً يقع على عاتقك. راجع مقال ما هو LiteLLM للحصول على الصورة الكاملة.
إليك المقارنة عبر الجانبين:
شاهد كيف تقارن TrueFoundry للفرق التي تحتاج إلى البوابة والحوكمة معاً. احجز عرضاً توضيحياً.
بدلاً من مقارنة قوائم الميزات، حدد أي وضع من الأوضاع الثلاثة التالية ينطبق عليك.
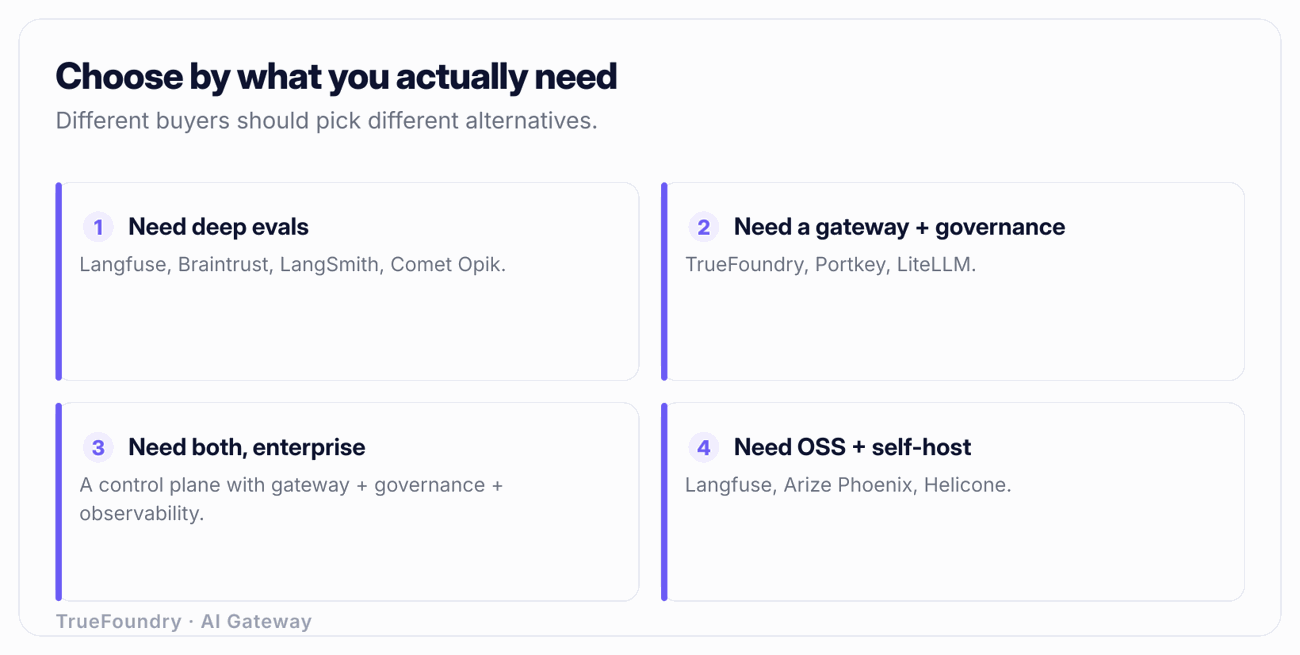
الانقسام الذي يسبب الارباك هو التعامل مع "التقييم" و"البوابة" على أنهما أمران قابلان للاستبدال لأن مزوداً واحداً يبيعهما معاً. هما وظيفتان مختلفتان. منصة التقييم تقيس جودة المخرجات مقابل مجموعات البيانات بمرور الوقت. أما البوابة فتيتحكم في مسار الطلب: التوجيه، والتبديل الآلي عند الفشل، والتخزين التلقائي، والميزانيات، وحواجز الحماية المدمجة. يمكنك شراؤهما بشكل منفصل من متخصصين، أو يمكنك الدمج، ولكن يجب أن تحدد أي مشكلة هي الأهم بالنسبة لك قبل أن تدع مزوداً يجمع المنتجات يحدد لك الإطار.
بالنسبة للمشتري الذي ينظر إلى Maxim لأنه يريد أكثر من أداة فردية — توجيه وحوكمة ومراقبة وتحكم في التكاليف — فإن TrueFoundry تتفرد بكونها لوحة تحكم واحدة للمؤسسات بدلاً من منتجين متجاورين.
بشكل عملي، يعني هذا: API واحداً موحداً متوافقاً مع OpenAI أمام كل مزود؛ التوجيه حسب الزمن الانتقالي والوزن والأولوية مع اختيار النموذج بناءً على التكلفة والجودة؛ التبديل عند الفشل مع إعادات المحاولة داخل الطلب؛ التخزين التلقائي الدقيق والدلالي؛ تطبيق الميزانيات وحدود المعدل لكل مستخدم وفريق ونموذج؛ إسناد التكلفة المسموم حسب الفريق حتى تعمل عمليات FinOps بالفعل؛ حواجز حماية مدمجة لـ PII وحقن التوجيهات (prompt injection)؛ والحوكمة (RBAC, SSO, SCIM, والتدقيق) عبر كل من بوابة LLM وبوابة MCP. خيارات النشر هي الميزة التنافسية الأخرى: SaaS، أو داخل VPC، أو في المقر (on-prem)، أو معزولة شبكياً بالكامل (air-gapped)، مع بقاء طبقة البيانات داخل شبكتك، وهو ما يحتاجه المسبترون في القطاعات التنظيمية والذي يصعب تقييمه في المنتجات ذات التسعير غير المعلن والتي تتطلب طلب الوصول.
الصياغة المنصفة: إذا كانت مشكلتك الوحيدة هي التقييم، فإن منصة تقييم متخصصة من القائمة أعلاه ستخدمك بشكل أفضل من أي بوابة، وعليك شراؤها. إذا كانت مشكلتك هي التحكم المؤسسي عبر أسطول متزايد من النواذج والوكلاء، وتفضل عدم ربط بوابة بأداة حوكمة منفصلة وأداة مراقبة منفصلة، فإن هذا الدمج هو السبب الرئيسي لاختيار TrueFoundry. دليلنا حول كيفية اختيار بوابة AI يستعرض معايير اختيار البوابة بالتفصيل.
شراء حزمة لتجنب التكامل، ثم القيام بالتكامل على أي حال. اختيار Maxim لأن "التقييم والبوابة من مزود واحد" يبدو أسهل لا يؤتي ثماره إلا إذا كان النصفان عبارة عن لوحة تحكم واحدة حقاً. عندما يكونان منتجين منفصلين، ستظل بحاجة لتكاملهما، وستكون قد قيدت خياراتك في كل نصف. تحقق مما إذا كانت الحزمة عبارة عن لوحة تحكم واحدة أم شعارين تجاريين.
تجاهل غموض التسعير حتى مرحلة متأخرة. سعر البوابة غير المعلن والذي يتطلب طلب الوصول أمر جيد للاستكشاف ولكنه ينطوي على مخاطرة عند التصميم بناءً عليه. الفرق التي تبني خطة إطلاق قبل الحصول على رقم تكتشف أحياناً أن الجوانب الاقتصادية لا تعمل بعد أن تكون قد بذلت جهداً كبيراً في التكامل. احصل على الرقم في وقت مبكر.
الخلط بين حواجز حماية البوابة ونتائج منصة التقييم. تقوم البوابة بحظر PII أو حقن التوجيهات في مسار الطلب، في الوقت الفعلي. بينما تقيم منصة التقييم جودة الإجابات بعد حدوثها مقابل مجموعات البيانات. اختيار أحدهما بتوقع أن يقوم بوظيفة الآخر يترك فجوة ستكتشفها في بيئة الإنتاج.
إعطاء وزن زائد للاختبارات المرجعية الذاتية. تبدو الاختبارات المرجعية لأي مزود جديد رائعة في مخططاته الخاصة. تعامل مع ادعاءات الإنتاجية والزمن الانتقالي كفرضيات لاختبارها على حجم عملك الخاص، وليس كحقائق مسلم بها، بغض النظر عن المزود الذي ينشرها.
التركيز على الميزات والفشل في المراجعة الأمنية للنشر. نادراً ما تحسم جدول الميزات صفقات المؤسسات؛ بل حسمها نموذج النشر وإقامة البيانات. إذا كانت بيانات العملاء لا يمكنها مغادرة شبكتك، فإن دعم VPC/في المقر/المعزولة شبكياً يلغي الخيارات بسرعة أكبر من أي إمكانية أخرى، لذا اجعل لها الأولوية أولاً.
تعتبر Maxim AI خياراً منطقياً، وBifrost بوابة ذات إمكانيات قوية. تبحث الفرق عن بدائل لأسباب عملية: تسعير البوابة غير المعلن، والفجوة بين منتج التقييم ومنتج البوابة، والاختبارات المرجعية الذاتية لمزود ناشئ. اعتمد البديل المناسب كلياً على النصف الذي كنت تشتري Maxim من أجله.
إذا كنت بحاجة إلى التقييم، اشترِ أداة تقييم متخصصة مثل Langfuse أو Phoenix أو Braintrust أو LangSmith أو Opik. إذا كنت بحاجة إلى بوابة للمؤسسات، فحدد ما إذا كنت تريد التوجيه والحوكمة والمراقبة في لوحة تحكم واحدة مع خيارات نشر VPC/في المقر/معزولة شبكياً، وهو ما توفره TrueFoundry، أم نقطة بداية أخف مثل LiteLLM أو Portkey. حدد مشكلتك الأساسية أولاً، وتضيق الخيارات سريعاً.
قيّم TrueFoundry إلى جانب قائمتك المختصرة. احجز عرضاً توضيحياً.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




