



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
A maioria das equipes descobre que precisa de uma plataforma de avaliação da mesma maneira: uma alteração de prompt que parecia boa em um notebook sofre regressão silenciosa em produção, um cliente tira print de uma resposta alucinada e ninguém sabe dizer se a nova versão do modelo é realmente melhor que a antiga ou apenas diferente. A pergunta "esta aplicação de LLM é boa?" revela-se sem resposta até que você tenha construído a estrutura para medi-la.
Essa estrutura é o que as plataformas de avaliação de LLM oferecem. Mas a categoria é ruidosa. Algumas ferramentas são focadas primeiro em avaliação com tracing adicionado depois. Algumas são focadas em observabilidade com avaliações integradas posteriormente. Algumas são bibliotecas open-source que você hospeda; algumas são SaaS gerenciados. E a complicação mais recente são os agentes: avaliar um único prompt-e-conclusão é um problema, avaliar um agente de dez etapas que chama ferramentas, recupera documentos e faz loops é outro muito mais difícil.
Este guia faz três coisas. Ele define o ciclo de vida da avaliação para que você saiba de quais recursos realmente precisa. Ele passa pelas principais plataformas (Langfuse, Arize Phoenix, Braintrust, LangSmith, Comet Opik, Maxim, Helicone) com detalhes sobre o que cada uma tem de bom e de ruim. E explica onde um gateway de IA se encaixa, porque os traces e dados de custo que um gateway produz são a matéria-prima que a maioria das plataformas de avaliação consome.
Quer traces por requisição, custos e guardrails em linha junto com suas avaliações? Agende uma demonstração.
A avaliação não é uma etapa única executada antes do lançamento. É um loop com quatro estágios, e uma plataforma séria suporta todos eles.
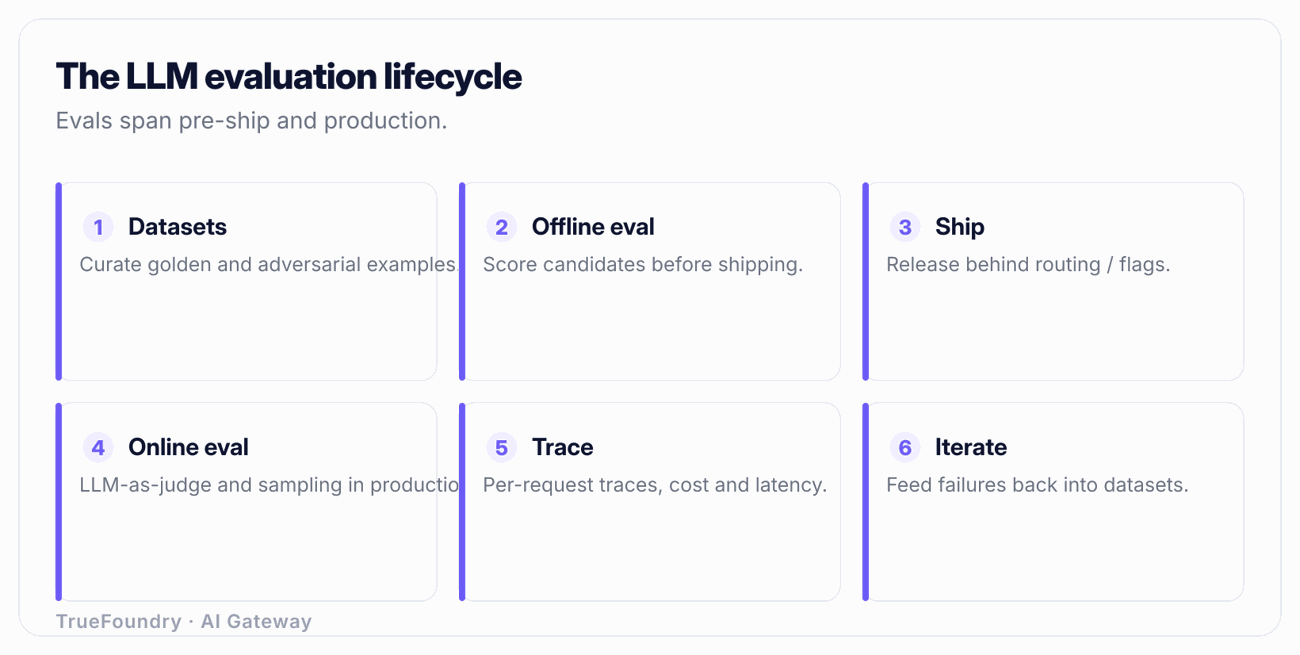
1. Datasets. Tudo começa com exemplos. Um dataset é um conjunto de entradas, opcionalmente com saídas esperadas ou respostas de referência, que representa o trabalho que sua aplicação realiza. Os melhores datasets não são sintéticos, são coletados da produção: as perguntas reais que os usuários fizeram, especialmente aquelas que deram errado. Uma equipe madura puxa continuamente traces de produção com falhas ou pontuação baixa de volta para o dataset, para que a suíte de avaliação fique mais difícil com o tempo, em vez de ficar congelada na dificuldade do dia do lançamento.
2. Avaliação offline. Antes de enviar uma alteração de prompt, modelo ou recuperação, você a executa contra o dataset e pontua as saídas. Os métodos de pontuação variam de determinísticos (correspondência exata, regex, validade de JSON-schema, execução do SQL) a pontuados por modelo (LLM-as-judge para precisão, relevância, tom). A avaliação offline é sua barreira pré-merge: ela responde "esta alteração melhorou ou piorou as coisas nos casos que eu já conheço?"
3. Avaliação online. Datasets offline nunca cobrem tudo o que a produção traz. A avaliação online executa pontuadores contra o tráfego ao vivo, geralmente em uma amostragem, para capturar regressões e modos de falha emergentes que seu dataset perdeu. É aqui que você mede coisas como taxa de alucinação em produção, relevância da resposta e violações de guardrails em sessões de usuários reais.
4. Tracing e observação. Dando suporte a ambos está o tracing: capturar cada etapa de uma execução como spans estruturados. Para um chatbot simples, trata-se de entrada do prompt, saída da conclusão, além de contagem de tokens e latência. Para um agente, é uma árvore: a etapa de planejamento, cada chamada de ferramenta com seus argumentos e resultado, cada recuperação com os chunks retornados, cada chamada de modelo com seu prompt e saída. Sem essa árvore, você pode pontuar a resposta final de um agente, mas não pode dizer por que ela estava errada, se a recuperação falhou, a ferramenta deu erro ou o modelo ignorou um bom contexto.
O loop se fecha quando as descobertas dos estágios 3 e 4 retornam ao estágio 1. Uma boa plataforma torna isso algo de um único clique: veja um trace ruim de produção, adicione-o ao dataset, execute novamente a avaliação offline contra ele para sempre.
A avaliação de agentes adiciona dois problemas. Primeiro, a trajetória importa, não apenas a resposta final. Um agente pode chegar a uma resposta correta por meio de um caminho quebrado (três chamadas de ferramenta redundantes, uma recuperação que retornou lixo que o modelo ignorou por sorte) e essa fragilidade afetará você mais tarde. Você precisa pontuar as etapas, não apenas o resultado. Segundo, o não-determinismo se acumula. Um agente de dez etapas em que cada etapa tem alguma variação produz execuções totalmente diferentes a partir da mesma entrada, portanto você precisa de várias execuções por caso e pontuação agregada, em vez de uma única aprovação ou falha.
Para qualquer coisa aberta, resumos, respostas de chat, campos extraídos com precisão imprecisa, você não pode escrever uma regex. O pontuador prático é outro LLM orientado a avaliar a saída: LLM-as-judge.
Funciona, mas com ressalvas que separam as equipes que confiam em suas avaliações daquelas que se dão mal:
Todas as plataformas abaixo oferecem LLM-as-judge. As diferenças estão em quão fácil elas tornam a calibração, a definição de rubricas e a manutenção do versionamento do juiz.
Nenhuma ferramenta única vence para todos. Aqui está um resumo honesto.
Langfuse. Open source (auto-hospedável ou cloud gerenciada) e a opção OSS mais completa. Ela combina tracing, evals, gerenciamento de prompts e datasets em um único sistema. Forte para equipes que desejam auto-hospedar por razões de residência de dados e obter observabilidade mais avaliação sem unir três ferramentas. O modelo de tracing é flexível e independente de framework. Se você quer uma plataforma open-source que cubra a maior parte do ciclo de vida, esta costuma ser a primeira a ser testada. Veja nossa visão geral sobre ferramentas de observabilidade de LLM para entender como ela se posiciona no cenário mais amplo de observabilidade.
Arize Phoenix. Open source e nativa em OpenTelemetry, o que é seu trunfo. O Phoenix utiliza as convenções semânticas de OTel para spans de LLM, portanto os traces se encaixam na infraestrutura que você já pode estar executando, evitando o bloqueio a um formato proprietário de trace. Forte na depuração de recuperação e RAG (inspeção de embeddings e chunks). Se a sua organização padronizou em OpenTelemetry, o Phoenix é a escolha natural. A Arize também vende um produto corporativo gerenciado acima do núcleo OSS.
Braintrust. Gerenciada, focada primariamente em avaliação. Sua tese é evals-as-CI: você conecta a avaliação ao seu loop de desenvolvimento para que cada alteração de prompt ou código seja executada contra datasets automaticamente, com pontuações comparadas como resultados de testes. Excelente UX de experimentação para comparar variantes de prompts e modelos lado a lado. Melhores para equipes cuja dor principal é "mudamos prompts constantemente e não temos uma barreira contra regressões". Mais leve no lado de auto-hospedagem e observabilidade total do que o Langfuse.
LangSmith. Gerenciada, construída pela equipe do LangChain e profundamente integrada ao LangChain e LangGraph. Se a sua stack já é LangChain, o tracing é quase gratuito, a instrumentação vem junto e as visualizações de trajetória do agente são fortes. O contraponto é que a experiência mais ajustada pressupõe o ecossistema LangChain; fora dele, ainda é utilizável, mas deixa de ser uma vantagem tão óbvia.
Comet Opik. Open source, vinda da linhagem do Comet (rastreamento de experimentos de ML). Cobre tracing, evals e notavelmente oferece verificações do tipo guardrail ao lado da avaliação. Boa opção para equipes que já usam o Comet para rastreamento de experimentos de ML clássico e querem o trabalho com LLMs no mesmo lugar, ou que desejam uma ferramenta de eval OSS com verificações do tipo moderação integradas.
Maxim AI. Uma plataforma de avaliação e observabilidade que também distribui o Bifrost, um gateway de IA open-source. A proposta combinada é "avaliar, observar e rotear em um único fornecedor". A lacuna que os compradores encontram é que as avaliações e o gateway são efetivamente produtos separados em vez de um único plano de controle, os preços do gateway não são públicos (requer solicitação de acesso) e é um fornecedor mais recente cujos benchmarks são em grande parte autorrelatados. Se você está avaliando especificamente o Maxim ou seu gateway Bifrost, considere a profundidade da avaliação e a profundidade do gateway e da governança separadamente, pois poucas ferramentas são as melhores da categoria em ambos.
Helicone. Open source, orientada a observabilidade e proxy. Ela atua como um proxy leve na frente das suas chamadas de modelo e captura logs, latência e custo com integração mínima (alterar uma URL base). As avaliações estão presentes, mas são mais leves do que as de uma plataforma de avaliação dedicada. Melhor quando sua prioridade é uma observabilidade rápida, barata e com baixo custo de configuração, tratando a avaliação profunda como algo secundário.
Aqui está a comparação condensada:
Veja como a TrueFoundry adiciona observabilidade e governança à sua stack de avaliação. Agende uma demonstração.
Escolher a partir da lista acima resume-se a alguns eixos. Pontue os candidatos em relação a estes pontos, em vez de se basear no marketing de contagem de recursos.
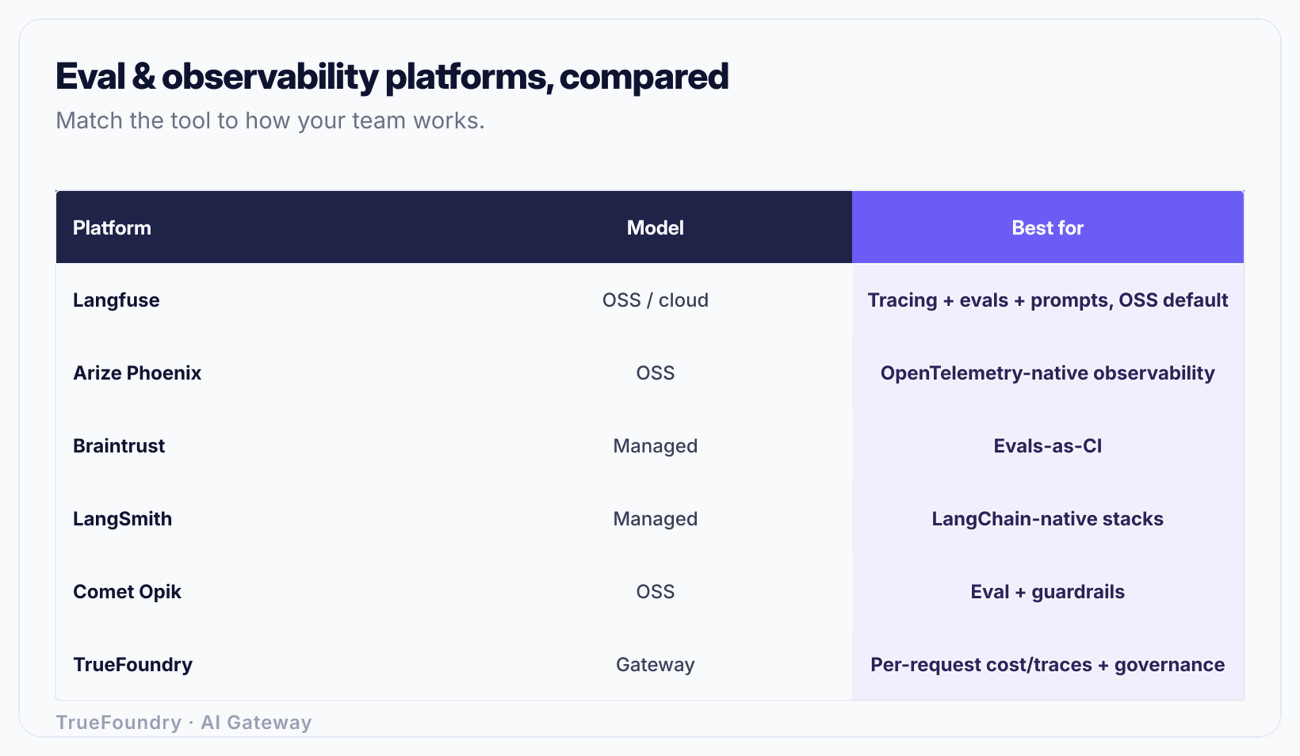
Uma forma concreta de usar a matriz: se a sua restrição rígida é "os dados do cliente não podem sair da nossa VPC", você reduziu imediatamente para as opções OSS auto-hospedáveis (Langfuse, Phoenix, Opik) ou um plano corporativo com implantação na VPC, descartando as ferramentas exclusivamente gerenciadas, independentemente de quão boa seja sua UX. Comece pelas suas exigências inegociáveis e depois otimize dentro do que restar.
Uma plataforma de avaliação precisa de dados para avaliar: traces, prompts, conclusões, contagem de tokens, latências e custo por chamada. De onde vem isso? Para uma única aplicação, você a instrumenta diretamente. Em uma organização que executa dezenas de aplicações e agentes em vários provedores de modelos, a fonte mais limpa é a camada pela qual todas as chamadas já passam: o gateway de IA.
Um gateway como o TrueFoundry fica na frente de todo o tráfego de modelos e provedores por trás de uma API unificada compatível com OpenAI. Como todas as requisições passam por ele, ele emite observabilidade por requisição: tokens de entrada e saída, latência, o modelo e provedor utilizados e o custo, tudo etiquetado por usuário, equipe e aplicação. Esse é exatamente o fluxo que uma plataforma de avaliação quer ingerir, e ele chega sem a necessidade de instrumentação por aplicação, porque o gateway o produz centralmente.
O gateway também executa guardrails em linha no momento da chamada: detecção de PII, verificações de injecção de prompt, varredura de segredos — o que é uma tarefa diferente da avaliação offline. Os guardrails bloqueiam ou sinalizam uma requisição ou resposta ruim no momento em que ela acontece; as evals pontuam a qualidade após o fato em relação a datasets e amostras de produção. Você precisa de ambos. O guardrail impede o dano óbvio no caminho da requisição; a plataforma de avaliação diz se a qualidade da resposta está tendendo a subir ou descer ao longo das semanas.
A divisão de trabalho é limpa: o gateway controla o caminho da requisição (roteamento, fallback, cache, orçamentos, guardrails em linha e emissão de traces); a plataforma de avaliação controla o loop de medição (datasets, pontuação offline e online, LLM-as-judge, comparação de experimentos). A TrueFoundry fornece o lado do gateway e o feed de observabilidade; uma plataforma de avaliação dedicada da lista acima o consome. Para equipes que padronizam custos e governança em muitos modelos, combinar os dois é muito melhor do que tentar forçar qualquer uma das ferramentas a fazer o trabalho da outra. Nosso guia sobre as melhores plataformas de observabilidade de IA para LLMs em 2026 aprofunda-se especificamente na metade referente à observabilidade.
Tratar o LLM-as-judge como verdade absoluta. O juiz é um modelo com seus próprios vícios e modos de falha. Equipes que lançam um juiz sem calibrá-lo em relação a rótulos humanos acabam otimizando sua aplicação para agradar a um avaliador descalibrado, o que é pior do que não ter avaliação, pois passa uma falsa sensação de rigor. Sempre meça a concordância entre o juiz e os humanos primeiro.
Avaliar apenas a resposta final de um agente. Uma resposta correta vinda de uma trajetória quebrada é um bug latente. Se você nunca pontuar as etapas intermediárias, não notará que seu agente chega à resposta certa por meio de três chamadas de ferramentas desnecessárias e uma recuperação que ele ignorou, até que uma pequena mudança o leve ao erro e você não tenha ideia do motivo.
Congelar o dataset no lançamento. Um conjunto estático de avaliação mede a dificuldade do dia do lançamento para sempre, enquanto a produção muda com o tempo. Sem um loop que traga continuamente traces de produção com falhas de volta para o dataset, seu painel de avaliação verde deixará gradualmente de significar qualquer coisa.
Comprar uma ferramenta de eval para um problema que um guardrail deveria resolver. Se a sua necessidade real é "bloquear PII e injeção de prompt no caminho da requisição", isso é função para guardrails em linha no gateway, não para uma suíte de avaliação offline. Por outro lado, executar datasets offline para capturar ataques em tempo real é muito lento. Adeque a ferramenta dependendo se a verificação acontece no caminho da requisição ou após o fato.
Ignorar a residência de dados até a fase de compras. As equipes escolhem uma ferramenta de eval gerenciada com base na UX e depois descobrem na revisão de segurança que os prompts de produção contendo dados de clientes não podem sair da VPC. Decida a questão entre OSS vs gerenciado e de implantação primeiro; isso elimina opções mais rápido do que qualquer recurso funcional.
A avaliação é a disciplina que transforma "a IA parece melhor agora" em um número que você pode defender. As plataformas diferem menos em fazer ou não avaliações — todas fazem — do que em como lidam com o ciclo de vida completo: curadoria de datasets, bloqueios offline, monitoramento online, tracing de trajetória de agentes e LLM-as-judge calibrado. Comece pelas suas restrições rígidas (residência de dados, framework existente, OSS vs gerenciado), pontue as opções da lista em relação à matriz de seleção e exija o loop completo em vez de um ambiente de testes isolado.
E lembre-se de que a avaliação não vive isolada. O gateway na frente dos seus modelos já produz os traces e dados de custo que sua plataforma de avaliação precisa, além de aplicar guardrails no caminho da requisição que as avaliações offline não conseguem. Combine uma plataforma de avaliação forte com um gateway que forneça observabilidade limpa por requisição e controles em linha, obtendo assim tanto a rede de segurança em tempo real quanto o sinal de qualidade a longo prazo que mantêm um produto de LLM confiável.
Combine suas avaliações com um gateway governado. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


