


novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Para muitas equipes de engenharia, o Amazon SageMaker é o ponto de partida padrão para aprendizado de máquina na AWS. Ele oferece uma experiência abrangente de 'laboratório pronto para uso' que elimina a necessidade de gerenciar servidores subjacentes.
No entanto, à medida que as equipes passam de notebooks experimentais para a implantação de modelos em larga escala, a fatura mensal não está em sintonia com a realidade. A conveniência do 'ML gerenciado' vem com um custo adicional que pode corroer silenciosamente as margens.
Este guia discute componentes específicos da precificação do SageMaker, expõe a margem de lucro sobre as instâncias de computação e explica por que empresas preocupadas com custos estão procurando alternativas.
O SageMaker não agrupa a precificação em um único plano. Em vez disso, você paga separadamente por cada etapa do ciclo de vida do ML. Em seguida, explicaremos o detalhamento dos custos:
Os notebooks do SageMaker Studio são frequentemente confundidos com editores de texto leves. Na realidade, eles são cobrados como instâncias de computação em execução.
Os custos de treinamento são calculados com base no tipo de instância específica utilizada e na duração em que os recursos permanecem ativos.
Para a maioria das equipes de produção, a inferência é o "iceberg" de preços do Amazon SageMaker—representando 70–80% do custo total.
Um dos maiores impulsionadores do alto custo do AWS SageMaker é a margem de serviço gerenciado. Embora você esteja tecnicamente usando instâncias Amazon EC2 por baixo dos panos, o SageMaker as envolve em uma camada de gerenciamento e cobra um prêmio por isso.
O custo adicional não é arbitrário; a AWS cobra essa taxa porque eles cuidam do trabalho pesado:
Para equipes pequenas sem engenheiros de plataforma, isso é uma troca justa. No entanto, em escala, esse custo adicional pela conveniência se transforma em um imposto recorrente sobre o uso da infraestrutura que oferece retornos decrescentes.
Além das taxas de computação principais, várias ineficiências operacionais inflacionam a conta final do SageMaker. Esses custos são frequentemente descobertos apenas depois que o departamento financeiro sinaliza um estouro de orçamento.
Cada notebook e trabalho de treinamento anexa um volume Elastic Block Store (EBS) por padrão para armazenar dados e código.
Endpoints Multimodelo (MMEs) prometem economia de custos ao permitir hospedar múltiplos modelos em um único contêiner.
As Instâncias Spot da AWS oferecem descontos de até 90%, mas são arriscadas para inferência no SageMaker.
À medida que sua adoção de IA cresce, o preço do SageMaker torna-se cada vez mais difícil prever e otimizar.
Os custos são distribuídos entre notebooks, trabalhos de treinamento, endpoints, armazenamento e monitoramento (CloudWatch). Como os controles de orçamento operam no nível da conta AWS, é difícil atribuir custos específicos a um modelo ou equipe de pesquisa específica. Essa falta de visibilidade leva a recursos ociosos e endpoints superprovisionados que inflacionam os gastos mensais indefinidamente.
Equipes que utilizam recursos avançados como SageMaker Ground Truth, SageMaker Clarify ou SageMaker Debugger para desenvolvimento de modelos frequentemente descobrem que estes adicionam camadas de complexidade ao custo total.
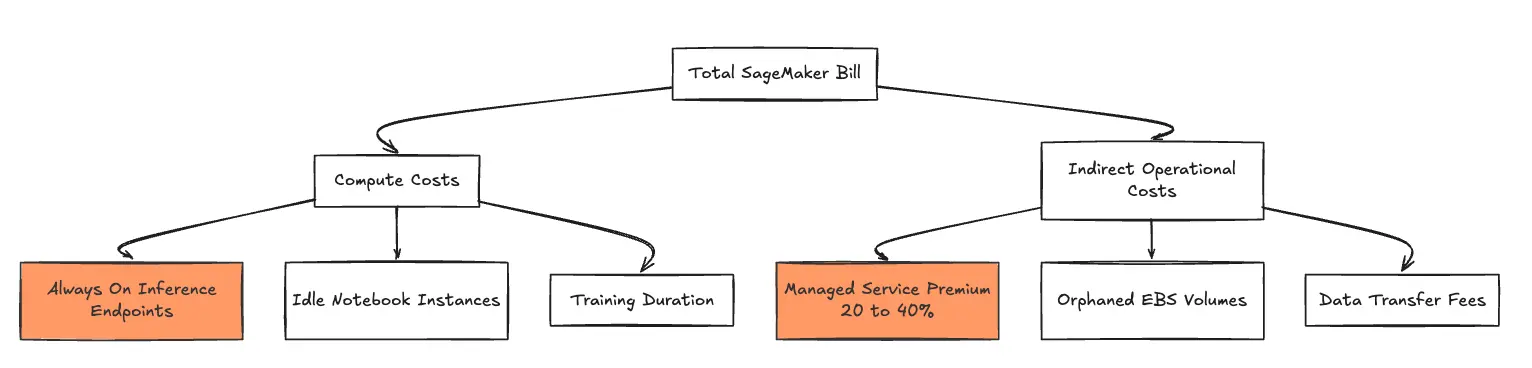
Muitas vezes, há um ponto de inflexão claro onde o custo adicional do serviço gerenciado do SageMaker se torna insustentável.
Quando o gasto mensal com IA ultrapassa o limite de US$ 10 mil a US$ 20 mil, a margem de lucro torna-se impossível de ignorar. Nesta fase, os líderes de engenharia geralmente procuram preços de infraestrutura bruta sem os custos indiretos de gerenciamento. Equipes avançadas desejam controle granular sobre tipos de GPU, instâncias reservadas e planos de poupança — otimizações que são frequentemente restritas ou mais complexas dentro do ecossistema SageMaker.
O AI Gateway da TrueFoundry oferece uma abordagem fundamentalmente diferente ao separar orquestração da propriedade da infraestrutura.
Em vez de revender computação com uma margem de lucro, a TrueFoundry orquestra cargas de trabalho diretamente nos seus próprios clusters EKS (Kubernetes) e EC2.
Para uma avaliação técnica lado a lado de como nossa camada de orquestração se compara ao ecossistema gerenciado da AWS, veja nossa análise completa de SageMaker vs TrueFoundry.
Esta comparação concentra-se na economia unitária, e não na paridade de funcionalidades.
Se você quiser ver uma análise detalhada das economias reais e da economia unitária em diferentes escalas de gastos, confira nosso comparativo de custos com o SageMaker.
As decisões de infraestrutura de IA devem estar alinhadas com as metas de custo e operacionais de longo prazo.
Amazon SageMaker é ideal para:
TrueFoundry é ideal para:
No entanto, se você ainda está decidindo entre diferentes serviços nativos da AWS para o seu caso de uso específico, nosso guia sobre AWS Bedrock vs. AWS SageMaker explora as principais diferenças em flexibilidade e gerenciamento que você deve considerar.
O SageMaker é excelente para experimentação inicial, mas o sucesso a longo prazo em IA exige disciplina de custos. Se sua fatura da nuvem está crescendo mais rápido do que o desempenho do seu modelo, é hora de repensar sua estratégia de infraestrutura.
Se você está pronto para ir além das altas margens de lucro dos serviços gerenciados e quer ver exatamente o quanto sua organização pode economizar em infraestrutura, agende uma demonstração com a TrueFoundry hoje para calcular suas economias potenciais.
O preço do SageMaker varia por região e uso. Você paga separadamente por instâncias de computação (por hora), armazenamento (GB/mês) e transferência de dados. Os preços das instâncias variam de alguns centavos por hora para CPUs básicas a mais de US$ 28/hora para instâncias de GPU avançadas.
Para reduzir os custos do AWS SageMaker, certifique-se de desligar as instâncias de notebook ociosas, use instâncias Spot para trabalhos de treinamento, dimensione corretamente seus endpoints de inferência e exclua volumes EBS não anexados. Alternativamente, mudar para uma plataforma de orquestração como a TrueFoundry pode eliminar completamente a margem de lucro do serviço gerenciado.
O SageMaker oferece um Nível Gratuito pelos primeiros dois meses, que inclui horas limitadas de uso de notebooks, treinamento e inferência em tipos de instâncias pequenas. Uma vez excedidos esses limites, o preço padrão é aplicado.
A TrueFoundry é mais econômica porque permite que você execute cargas de trabalho em sua própria conta na nuvem usando instâncias EC2 padrão, evitando a margem de lucro de 20-40% que o SageMaker cobra. Ela também oferece recursos automatizados para desligar recursos ociosos e usar de forma confiável instâncias Spot para inferência.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



