



novembro 20, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: novembro 20, 2026

Blazingly fast way to build, track and deploy your models!
A maioria das equipes que avaliam um AI gateway parte do mesmo receio: "Se eu colocar um proxy na frente de cada chamada de modelo, estou adicionando um salto (hop), e esse salto custa latência." É um instinto razoável, mas uma péssima razão para ignorar o gateway. Esse instinto está errado quanto à magnitude. Uma chamada de modelo para um LLM de ponta leva de 300 milissegundos para uma conclusão curta a 20 segundos ou mais para uma resposta de raciocínio longa. Um gateway construído de forma competente adiciona apenas alguns milissegundos — da casa de um dígito até dezenas baixas — de processamento próprio além disso. A questão nunca é "o gateway adiciona latência" (ele adiciona, de forma trivial), mas sim "consigo medir o overhead com precisão, e ele se mantém baixo na cauda e sob carga?"
O problema é que quase ninguém faz o benchmark disso corretamente. As equipes executam um loop de 100 requisições pelo gateway, olham para o tempo médio total (wall-clock time), comparam com 100 chamadas diretas e concluem algo sobre "desempenho" que é dominado pela variação do provedor e jitter de rede. O sinal com o qual se importam — a contribuição do próprio gateway — fica sepultado dentro de segundos de tempo do modelo e nunca é isolado.
Este post apresenta um método neutro em relação a fornecedores para avaliar um AI gateway adequadamente: quais métricas importam, como isolar o overhead do gateway da latência do provedor, como testar na cauda e sob carga, como lidar com streaming e caching, e qual é o padrão do que é considerado "bom". Cada exemplo numérico aqui é um template ilustrativo, não um resultado medido. Você deve preencher as tabelas com os números das suas próprias execuções.
Quer medir o overhead real do gateway contra o seu próprio tráfego? Agende uma demonstração.
Um AI gateway fica no caminho da requisição entre a sua aplicação e um ou mais provedores de modelos. No caso da TrueFoundry, ele é uma API unificada e compatível com OpenAI que gerencia roteamento, fallback e tentativas (retries), caching exato e semântico, orçamentos e limites de taxa (rate limits), guardrails e observabilidade por requisição. Cada um desses recursos realiza um trabalho, e esse trabalho leva tempo. Fazer o benchmark é a disciplina de atribuir o tempo ao lugar correto.
Uma única requisição sem streaming tem um orçamento de latência semelhante a isto:
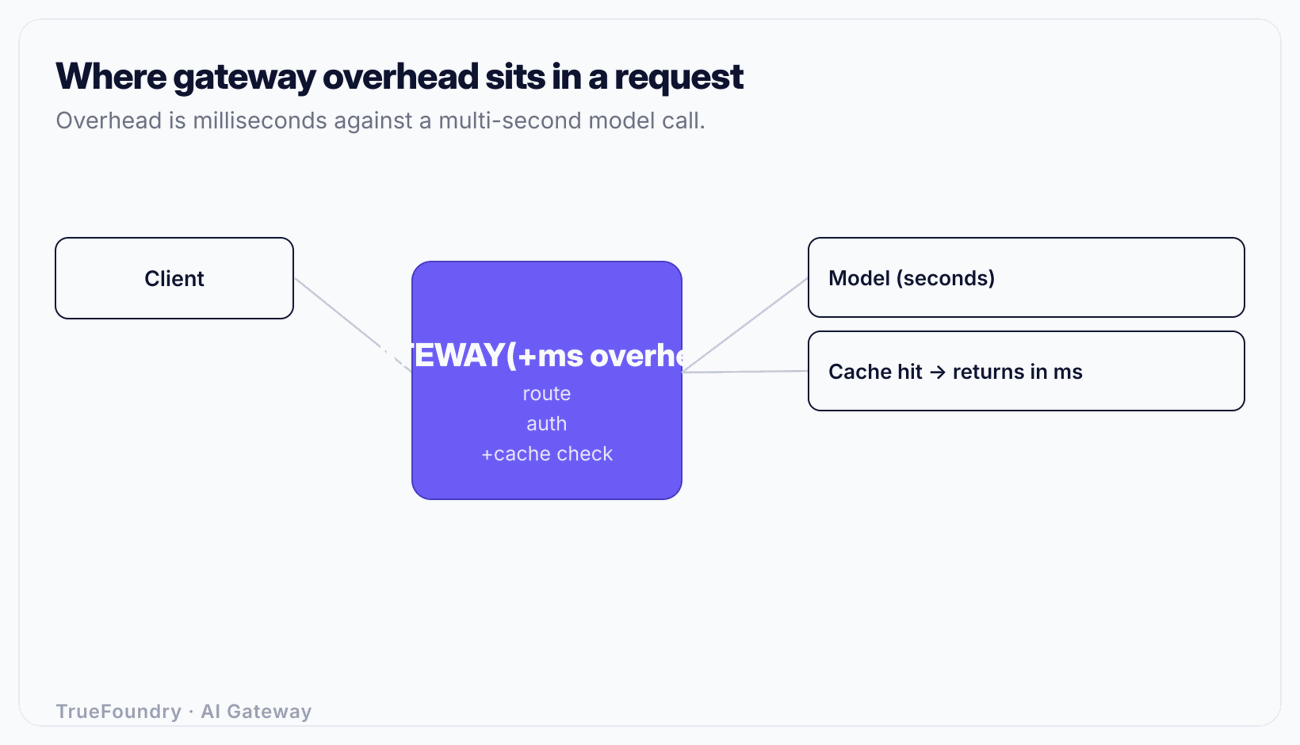
Divida o tempo total (wall-clock) de uma requisição em quatro partes:
A principal métrica do benchmark é a latência adicionada: (2) mais (4), isolada de (1) e (3). Se a sua ferramenta só relata o tempo ponta a ponta, você está medindo o provedor, não o gateway.
Seis números descrevem o desempenho de um gateway. Registre todos os seis; uma única média não é um benchmark.
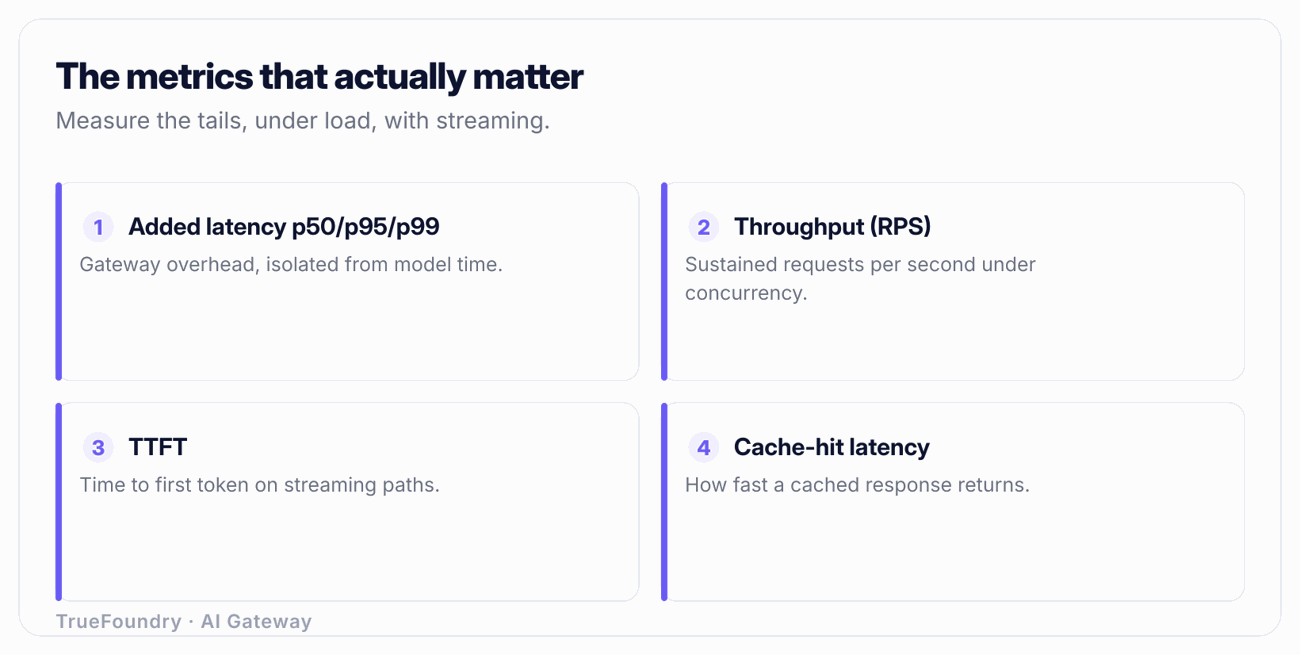
As duas métricas de cauda merecem ênfase. Em uma carga de trabalho baseada em agentes, uma única ação do usuário pode se desdobrar em 10 a 50 chamadas de modelo ao longo de um loop de raciocínio. Se cada chamada tem 1 chance em 100 de atingir um caminho lento no p99, um loop de 30 chamadas atinge esse caminho lento aproximadamente uma vez a cada três ou quatro ações do usuário. A cauda não é um caso isolado na escala de agentes; ela é o caso comum.
O movimento metodológico central é a subtração, e a armadilha é que a latência do provedor é ruidosa; portanto, uma subtração ingênua gera um overhead ruidoso.
Opção A: requisições pareadas. Para cada iteração do teste, envie a mesma requisição diretamente ao provedor e através do gateway, o mais próximo possível no tempo, de preferência de forma intercalada. Subtraia o tempo direto do tempo do gateway por par. O pareamento controla a oscilação de carga do provedor durante o teste, porque ambas as metades do par veem aproximadamente as mesmas condições do provedor. Colete milhares de pares e depois tire os percentis da diferença. Isso mede a latência adicionada real, incluindo a chamada do gateway para o provedor, mas é sensível ao jitter do provedor entre as duas metades do par.
Opção B: cronometragem interna do gateway. Um bom gateway registra seu próprio tempo de processamento por requisição — o intervalo entre aceitar a requisição e despachar a chamada para o provedor, além do trabalho no lado da resposta. A observabilidade por requisição da TrueFoundry expõe a latência detalhada dessa forma, marcada por usuário, equipe e modelo. Isso fornece o overhead diretamente, sem subtração e sem ruído do provedor, e é o número em que se deve confiar quando disponível. Valide-o uma vez contra as medições de requisições pareadas e, depois, confie na métrica interna para o monitoramento contínuo.
Opção C: simular o provedor (mock). Aponte o gateway para um stub local que retorna uma resposta pronta com um atraso fixo e conhecido (digamos, 200 ms). Agora, o tempo do provedor é uma constante escolhida por você, e tudo o que estiver acima disso é overhead do gateway mais rede. Esta é a maneira mais limpa de estressar os caminhos do próprio código do gateway em alto RPS sem pagar por ou ser limitado por taxa (rate-limited) por um provedor real, sendo a ferramenta certa para encontrar o ponto de inflexão do throughput. Isso não captura o comportamento do provedor real, portanto, use para overhead e throughput, não para realismo ponta a ponta.
Use as três. A Opção C encontra o teto do throughput, a Opção A valida a latência adicionada no mundo real, e a Opção B fornece o número que você acompanhará em produção. Para saber mais sobre onde o gateway se posiciona em relação à sua aplicação e por que esse posicionamento rege a latência, veja control plane vs data plane e o contexto mais amplo em como escolher um AI gateway.
Um benchmark executado com concorrência 1 indica o piso, mas nada sobre a produção. Gateways reais atendem a centenas ou milhares de requisições simultâneas em andamento, e o comportamento interessante é como o overhead se degrada à medida que a concorrência aumenta.
Projete o teste de carga como uma rampa. Comece com baixa concorrência, mantenha, suba um degrau, mantenha, e continue subindo até que a latência adicionada no p95 cruze o seu limite. Em cada degrau, registre a latência adicionada no p50, p95, p99 e o RPS atingido. O resultado é uma curva, não um ponto. Três formatos são comuns:
Dois detalhes da geração de carga alteram os números mais do que as pessoas esperam. Primeiro, use um modelo de carga de malha aberta (open-loop), onde as requisições chegam em um cronograma independentemente de as anteriores terem terminado, e não um modelo de malha fechada (closed-loop), onde um pool fixo de workers espera por cada resposta. O teste em malha fechada esconde o acúmulo de filas porque respostas lentas desaceleram a carga oferecida, mascarando os seus números de cauda. Segundo, gere carga a partir de conexões de clientes suficientes para que o cliente não seja o gargalo; um único processo cliente com um pool de conexões pequeno relatará uma latência do "gateway" que na verdade é o enfileiramento no próprio cliente.
Para cargas de trabalho de chat e agentes, a maioria das respostas é transmitida via streaming. O streaming inverte qual métrica importa: o usuário percebe o tempo até o primeiro token, e o tempo total é quase irrelevante para a velocidade percebida.
Um gateway corretamente construído encaminha os chunks em streaming conforme eles chegam, adicionando apenas um overhead pequeno e constante por chunk. Um gateway mal construído acumula toda a resposta do provedor em buffer, aplica o processamento e só então começa a transmitir para o cliente, o que transforma uma resposta em streaming de 3 segundos em uma espera de 3 segundos seguida por um descarregamento instantâneo. O benchmark de TTFT pega isso imediatamente: meça o intervalo desde o envio da requisição até o recebimento do primeiro byte do primeiro chunk de conteúdo, tanto via gateway quanto direto. O overhead de TTFT do gateway deve ser próximo ao seu overhead sem streaming — alguns milissegundos, não centenas.
Os guardrails de resposta complicam isso de forma honesta. Se você executa um guardrail de saída que precisa inspecionar a resposta completa (certas checagens de PII ou políticas), você não pode fazer o streaming e escanear o texto completo ao mesmo tempo sem uma escolha de design: transmitir otimisticamente e retratar, ou fazer buffer e atrasar. Avalie ambos os modos se você usa guardrails de saída, e relate o custo de TTFT de cada um. Não permita que um fornecedor lhe cite um TTFT em streaming medido com guardrails desligados para depois você ativá-los em produção.
Veja como a TrueFoundry mantém a latência adicionada na casa dos milissegundos de um único dígito. Agende uma demonstração.
Você não precisa escolher um gateway pela sua linguagem de implementação, mas deve entender por que a linguagem e a arquitetura moldam a curva de throughput, pois isso indica o que deve ser estressado.
Um gateway escrito em um event loop de thread única lida com uma enorme concorrência para trabalho limitado por I/O (esperar pelo provedor), mas serializa qualquer trabalho limitado por CPU no caminho crítico. Se o parse da requisição, a contagem de tokens ou as regex de guardrails forem executados de forma inline, essas etapas competirão por essa única thread e aparecerão como um p99 crescente sob carga. Um runtime com uma trava global do interpretador (GIL) possui uma restrição relacionada: mesmo com um pool de threads, as seções limitadas por CPU não são executadas verdadeiramente em paralelo dentro de um processo, então você escala executando mais processos, e seu benchmark deve levar em conta a duplicação de memória e de pools de conexões por processo. Runtimes compilados e multithreaded (Go, Rust) paralelizam o trabalho de CPU entre os núcleos dentro de um processo, o que geralmente empurra o ponto de inflexão de throughput para um nível mais alto por instância, ao custo de um perfil operacional diferente.
A lição prática não é "Go ganha do Python". É: identifique o que é executado no caminho crítico e faça o benchmark disso sob concorrência. Contar tokens em um contexto de 100.000 tokens, executar um classificador de injeção de prompt ou calcular um embedding para cache semântico são todos trabalhos de CPU. Se eles rodarem inline, vão entortar sua curva de cauda. Se rodarem fora do caminho crítico ou atrás de um caminho rápido, não vão. Teste com tamanhos de prompt representativos, não com exemplos simples de 10 tokens, porque o comprimento do contexto impulsiona o custo de CPU justamente dessas etapas. O papel do gateway como um LLM proxy é manter esse trabalho por requisição pequeno e previsível.
O único cenário que inverte toda a narrativa de que "gateways adicionam latência" é o caching, e é o cenário que as equipes esquecem de testar.
A TrueFoundry suporta tanto o caching exato (requisição idêntica retorna a resposta armazenada) quanto o caching semântico (uma requisição cujo embedding está dentro de um limite de similaridade de cosseno de uma requisição anterior retorna essa resposta). Em um hit, a chamada ao modelo nunca acontece. A latência da requisição despenca dos centenas de milissegundos ou segundos do modelo para o próprio tempo de busca do gateway: o cálculo do embedding (para o semântico) mais uma busca de vetor ou chave, tipicamente na casa de um único dígito até dezenas baixas de milissegundos.
Avalie isso como um cenário próprio:
Um exemplo prático, apenas ilustrativo: suponha que uma chamada direta de modelo para sua carga de trabalho leve 1.200 ms no p50. Um cache hit exato pode retornar em 6 ms, e um hit semântico em 22 ms (dominado pela etapa de embedding). Com uma taxa de hits de 40 por cento, o p50 combinado é de aproximadamente 0,6 × 1.200 + 0,4 × 15 ≈ 726 ms, uma redução de 40 por cento na latência típica e uma redução de 40 por cento no gasto com tokens, ambos produzidos pelo gateway. Relatado como média ponta a ponta, o gateway parece dramaticamente mais rápido do que chamadas diretas. É por isso que "o gateway adiciona latência" é a manchete errada: no tráfego em cache, ele subtrai latência. Preencha com seus próprios números; a estrutura se mantém independentemente dos detalhes.
Execute esta lista antes de confiar em qualquer alegação de latência de gateway, incluindo a sua própria.
A tabela abaixo é um template para você preencher com suas próprias execuções. Os números são marcadores de posição que mostram a forma e a ordem de grandeza esperadas, não resultados medidos de nenhum produto. Substitua cada célula por valores que você mediu nos seus modelos, regiões e tráfego.
Tratar qualquer linha isoladamente não tem significado. O valor está na comparação: cache hit versus miss, streaming versus sem streaming, carga baixa versus o ponto de inflexão.
Relatam a latência ponta a ponta e chamam isso de desempenho do gateway. O modelo domina o tempo total, então o "benchmark" mede principalmente o provedor e a rede. Isole o overhead ou você não terá medido nada sobre o gateway.
Fazem benchmark da média e lançam o código com base nela. O p50 parece ótimo, mas o p99 estoura o tempo limite dos loops dos seus agentes em produção. Na distribuição de chamadas de agentes, a cauda é a experiência real. Sempre relate o p95 e o p99.
Testam com concorrência 1. O overhead em uma única requisição em andamento não diz nada sobre o comportamento a 500. A curva de degradação, e o ponto de inflexão nela, é o ponto principal. Aumente a carga.
Esquecem de avaliar o cache. O caching é o único recurso que torna o gateway mais rápido do que chamadas diretas, e é o cenário mais frequentemente ignorado. Meça a latência do hit e a latência combinada na sua taxa de hits real, ou você subestimará o valor do gateway por todo o benefício do caching.
Confiam no número de um fornecedor sem reproduzi-lo. Um valor de latência em uma apresentação foi medido no modelo, região, tamanho de prompt e configuração de guardrails de outra pessoa. Até que você o reproduza no seu tráfego, ele é apenas marketing. Execute o checklist você mesmo.
O receio de que um AI gateway adicione uma latência inaceitável sobrevive porque as equipes medem a coisa errada. O tempo total ponta a ponta é dominado pelo modelo, portanto não diz quase nada sobre o gateway. Isole o overhead, relate-o na cauda e o cenário se inverte: um gateway competente adiciona alguns milissegundos a uma requisição que já leva segundos e, no tráfego em cache, torna a requisição significativamente mais rápida enquanto reduz os custos com tokens.
Faça o benchmark você mesmo. Use o checklist, preencha o template com suas próprias execuções, suba a concorrência para encontrar o ponto de inflexão e meça a latência no p99 e do cache hit como métricas de primeira classe, e não como ideias secundárias. Um gateway que passa por esse teste garante roteamento, fallback, caching, orçamentos, guardrails e observabilidade por requisição por um custo de latência que se aproxima de zero em comparação ao modelo, e a única maneira de provar isso é medindo no seu tráfego.
Faça o benchmark de um gateway que fica mais rápido com o cache ativado. Agende uma demonstração.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada


