November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
A TypeSafe AI é um laboratório de AI fundado por Diogo Almeida — anteriormente na OpenAI, onde trabalhou na pesquisa de instruction-following que deu origem ao ChatGPT — ao lado de Erik Gafni e Sasha Sheng. Após cerca de dois anos em modo stealth, a empresa publicou seu post de lançamento em 15 de setembro de 2026, acompanhado por uma rodada seed de US$ 40 milhões liderada pela DCVC. O DataCamp e diversos veículos especializados cobriram o anúncio nos dias seguintes.
A abordagem no post de lançamento é uma pergunta em vez de um benchmark: os modelos têm sido sobre-humanos em chat há anos, então onde está toda a automação? A resposta da TypeSafe é que o gargalo nunca foi a inteligência bruta — é que um modelo que responde em prosa é um componente incômodo sobre o qual construir software. O manifesto da empresa diz isso de forma mais direta: a AI de hoje foi treinada sob a premissa de que há um ser humano do outro lado.
O Jev é o primeiro modelo construído sob essa premissa. O nome vem de William Stanley Jevons, cujo paradoxo sustenta que a queda nos custos impulsiona o aumento do consumo; System One é uma referência ao pensamento rápido e intuitivo do Sistema 1 de Daniel Kahneman, em contraste com o raciocínio lento e deliberado do Sistema 2.
Entre os types of AI models dos quais você recorreria em produção, este é definido pelo que ele abre mão. Um modelo de chat retorna uma string, e uma string pode ser qualquer coisa — uma resposta, uma recusa, um parágrafo de raciocínio ou algo malformado que faz seu parser falhar. O Jev não retorna strings de maneira alguma.
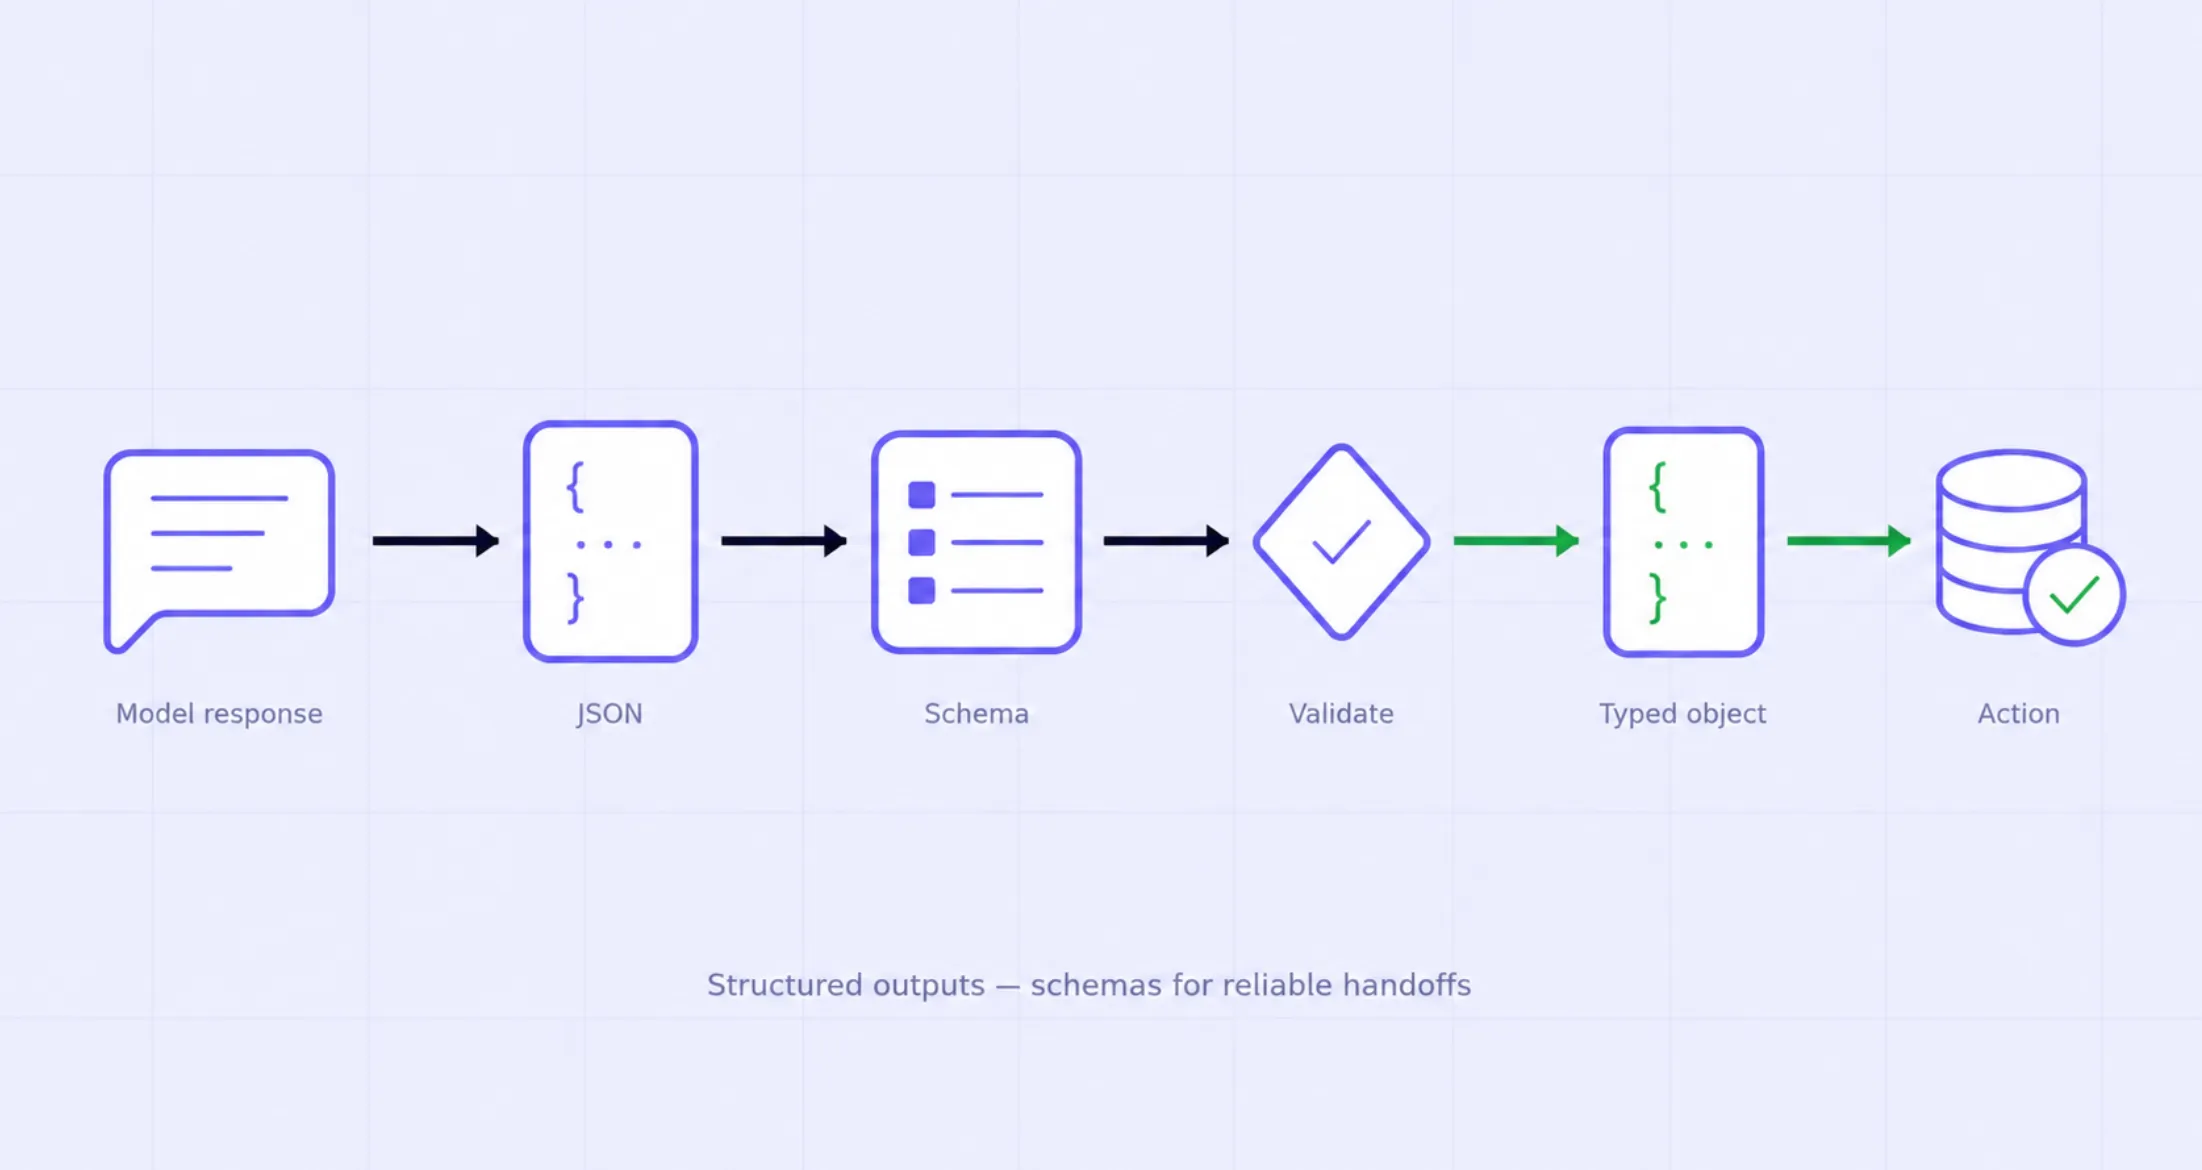
Em vez disso, você declara o formato da resposta antecipadamente: quais campos você quer e quais valores cada campo tem permissão para assumir. O modelo retorna esses campos preenchidos, cada um acompanhado de uma probabilidade. A TypeSafe descreve o resultado como uma chamada de função de inteligência de fronteira — estado não estruturado entra, decisões probabilísticas tipadas saem. Na prática, ele se comporta menos como um chatbot e mais como um ai decision engine que você pode chamar a partir de uma linha de código.
Três propriedades decorrem desse design:
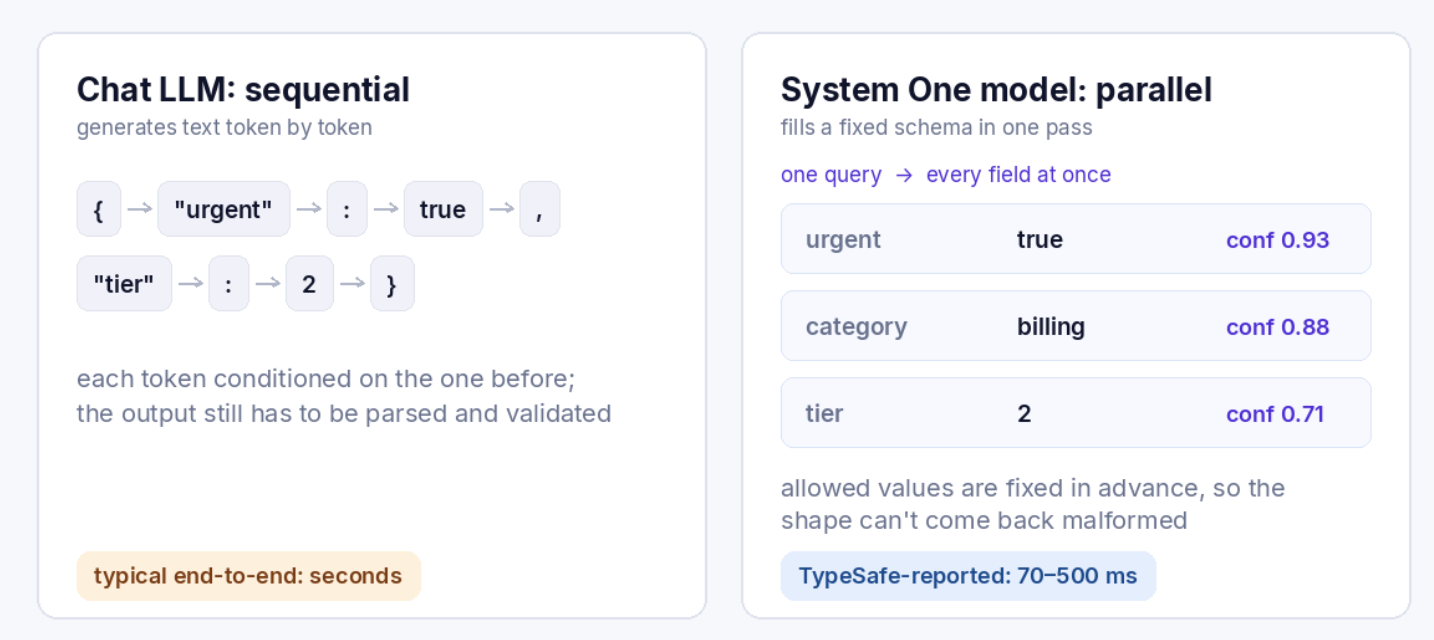
Um LLM de chat constrói sua resposta token por token; um modelo System One preenche cada campo de um schema fixo em uma única passagem, cada um com uma pontuação de confiança.
Essa terceira propriedade é a mais propensa a ser subestimada. Um modelo que está certo 95% do tempo, mas não consegue dizer quais chamadas estão nos outros 5%, não permite automação ao seu redor. Um que relata incerteza honesta permite — você cria ramificações com base na pontuação de confiança e direciona os casos de baixa confiança para um humano ou para um modelo maior.
Um limite prático importante de conhecer: o Jev suporta uma cardinalidade de até 255 opções por escolha. Acima disso, a TypeSafe usa uma abordagem em duas etapas — pontuar candidatos independentemente e, em seguida, fazer uma escolha explícita —, o que ela reconhece ser mais lento.
Esta é a parte que vale a pena analisar com calma, porque os números de lançamento são incomumente altos e as evidências por trás deles são incomumente autocontidas. Para o crédito da TypeSafe, seu post inclui suas próprias notas de "nuances" sob cada resultado, de onde vem a maior parte do conteúdo a seguir.
Verificável de forma independente hoje:
Relatado pela própria empresa e ainda não reproduzido independentemente:
Ainda desconhecido: desempenho em benchmarks públicos, comportamento em tarefas que não são claramente em formato de decisão, precisão em trabalhos de domínio específico nas mãos de terceiros e qualquer detalhe sobre confiabilidade em produção em escala. O acesso antecipado foi aberto apenas esta semana.
Há também uma questão de redação sobre a qual vale a pena ser preciso, porque será simplificada em resumos. A TypeSafe diz que o Jev não pode alucinar, e no sentido estrito isso é justo: um modelo que nunca emite texto livre não pode inventar uma citação ou o nome de uma ferramenta. Mas llm hallucination e exatidão não são o mesmo problema. Um modelo restrito a três categorias permitidas ainda pode escolher com confiança a categoria errada — o que foi eliminado foi a resposta malformada, não o julgamento equivocado. A calibração é a resposta da TypeSafe para isso, e a calibração é exatamente a alegação que precisa de testes independentes. Equipes que já usam structured outputs with JSON schema reconhecerão a distinção: restringir a estrutura de uma resposta nunca garantiu o conteúdo dela.
Deixe o lançamento específico de lado por um momento, porque o formato dele é mais interessante do que os números. O que a TypeSafe está defendendo — e o que um número crescente de equipes está concluindo de forma independente — é que usar um único modelo de uso geral respondendo a cada chamada é um padrão de prototipagem, não de produção.
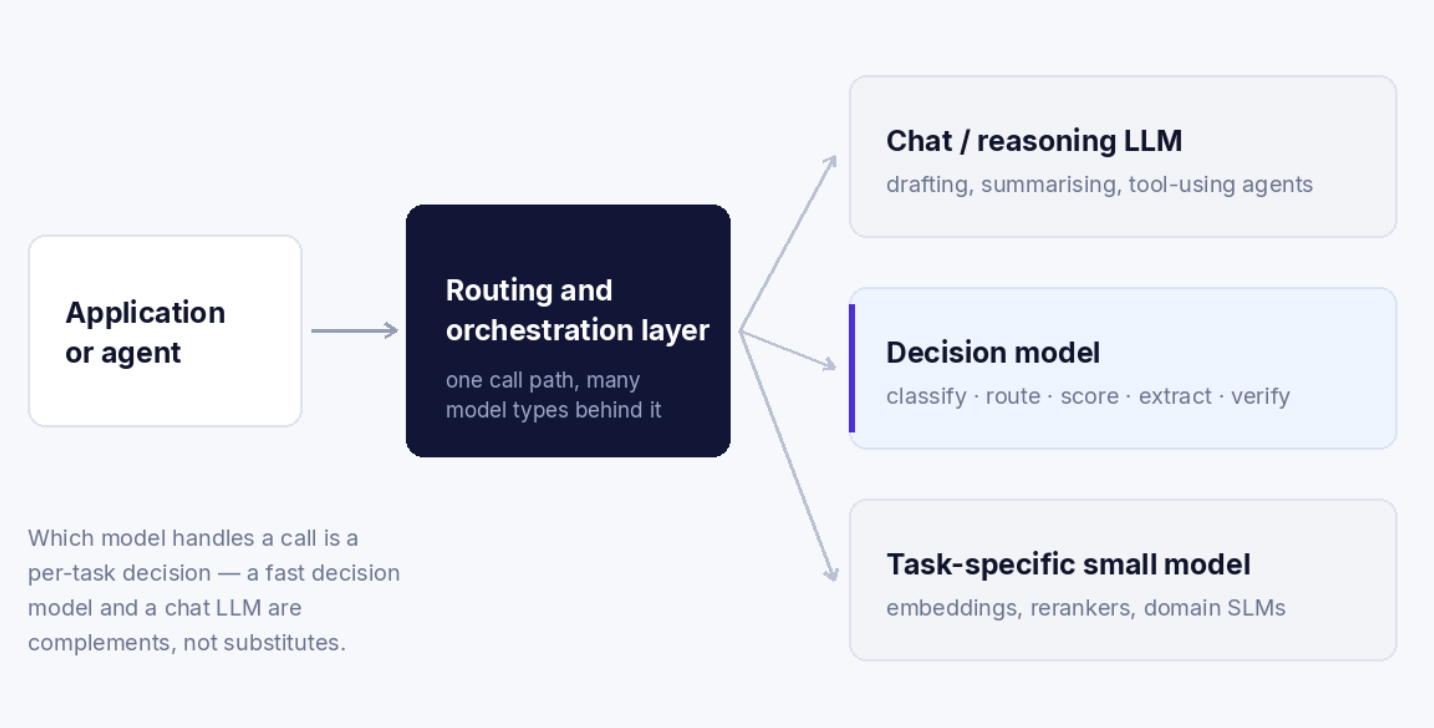
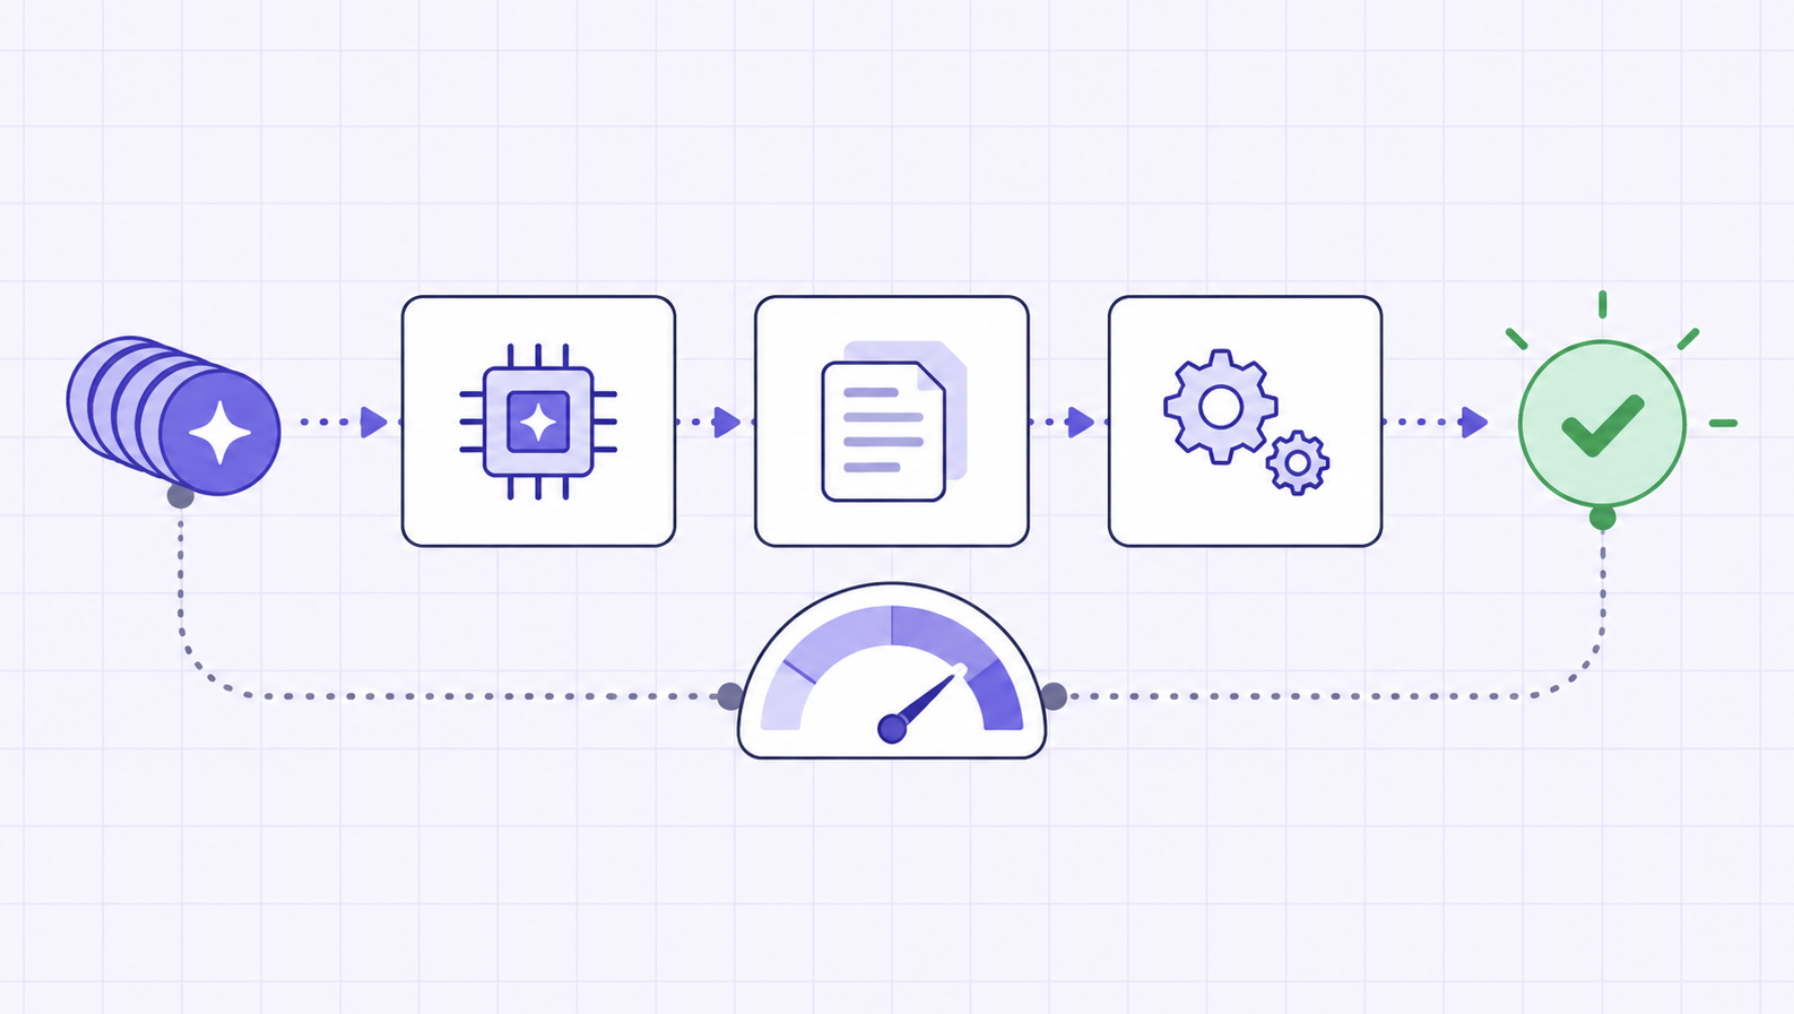
Uma stack de produção acaba contendo vários tipos de modelos ao mesmo tempo, com a camada de roteamento decidindo qual deles atende a uma determinada chamada.
As decisões dentro de um sistema em execução são em sua maioria pequenas e repetitivas: este chamado é urgente, a qual fila ele pertence, esta resposta viola a política, qual destes campos é o número da fatura. Enviar cada uma dessas tarefas para um modelo de chat de fronteira funciona, e as equipes fazem isso, mas significa pagar preços de geração e latência de geração por algo mais próximo de uma busca. Essa é a mesma lógica por trás de choosing when to specialise a small model instead of prompting a large one, e é por isso que trabalhos do tipo verificação — pontuação, julgamento, detecção de jailbreak, agent guardrails — são o caso de uso com o qual a TypeSafe se destaca. Guardrails precisam ser executados em todas as chamadas, o que torna o custo e a latência a restrição principal, em vez da capacidade bruta.
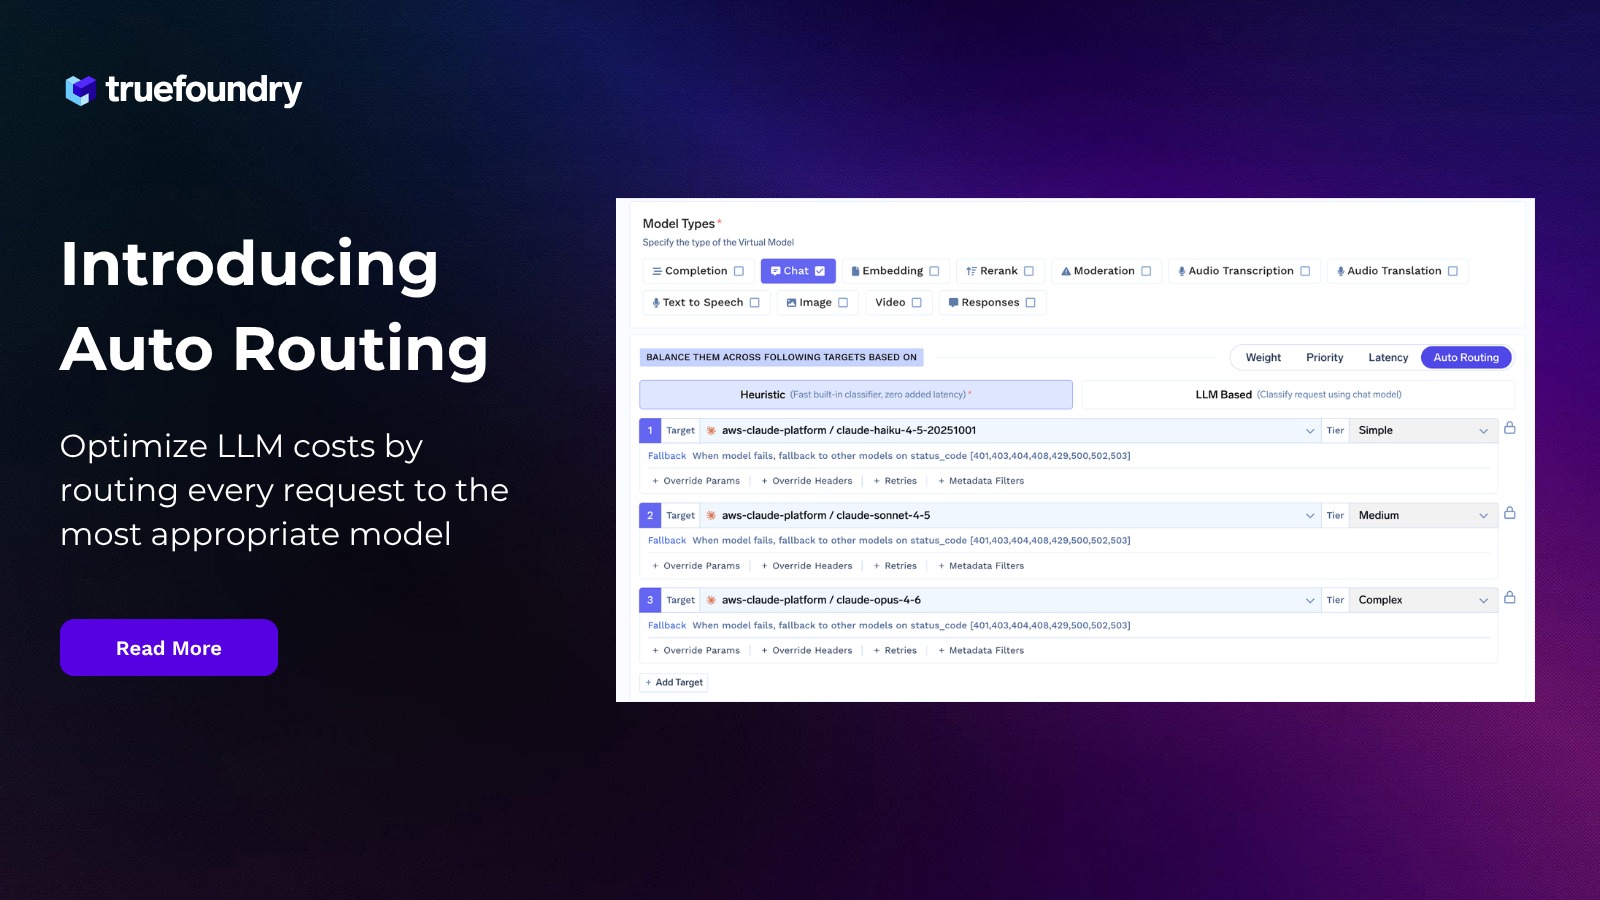
A consequência para qualquer pessoa executando AI em produção é um problema de ai orchestration, em vez de uma seleção de modelos. Se a resposta certa é um LLM de chat para algumas chamadas, um modelo de decisão rápido para outras e um modelo pequeno ajustado para um terceiro conjunto, então o que precisa ser estável é a camada à frente deles — um único caminho de chamada, autenticação e logs consistentes, e a liberdade de alterar qual modelo atende a uma determinada tarefa sem reescrever a aplicação. Essa é a premissa por trás do auto-routing on the TrueFoundry AI Gateway, e é a razão pela qual um lançamento como este é mais interessante como um sinal arquitetônico do que como um benchmark.
Por enquanto, o Jev é uma API hospedada e fechada em acesso antecipado, portanto não há nada para implantar e nenhuma integração para avaliar. Isso pode mudar. O padrão que ele representa quase certamente não mudará.
O Jev da TypeSafe AI é uma aposta genuinamente diferente: a de que o próximo passo útil não é um modelo de chat mais inteligente, mas sim um modelo confiável que o software possa chamar como qualquer outra função. O design é coerente, o histórico dos fundadores é real, e as metas de preço e latência são agressivas o suficiente para mudar o que vale a pena automatizar. No entanto, os múltiplos de benchmark foram autoavaliados em um formato inventado pela própria empresa, e a alegação mais forte do post — a calibração — é aquela que nenhuma parte externa testou ainda. Ambas as coisas podem ser verdadeiras.
O que o lançamento confirma é uma direção: as stacks de produção estão caminhando para uma mistura de tipos de modelos escolhidos por tarefa, não um único modelo escolhido por empresa. Se esse é o formato do seu sistema, a camada que vale a pena estruturar corretamente é aquela que fica à frente dos modelos.
Veja como o TrueFoundry AI Gateway faz o roteamento entre tipos de modelos →
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada