November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Vraag een platformlead voor hoeveel verschillende LLM's hun bedrijf op dit moment betaalt, en je krijgt meestal een stilte, gevolgd door een gok. Het eerlijke antwoord is vaak "meer dan we denken", omdat elke engineer met een creditcard en een API-key in een middag een nieuw model aan een service kan koppelen. Elk van die integraties betekent een afzonderlijke rekening, een afzonderlijke set credentials en een afzonderlijke route waarlangs gevoelige data het pand kan verlaten — en niets daarvan is vanaf één centrale plek zichtbaar.
Een model catalog is de beheersmaatregel die dat gat dicht. Het is het centrale, beheerde antwoord op de vraag "welke modellen mogen onze teams aanroepen, en onder welke regels?" Geen spreadsheet met goedgekeurde leveranciers, maar een gehandhaafde lijst waarbij elke vermelding het beleid bevat dat erop van toepassing is.
Dit artikel definieert de model catalog precies, trekt een scherpe grens tussen een catalog en een model registry (ze worden voortdurend met elkaar verward), legt uit waarom wildgroei gevaarlijk en duur is, en laat zien hoe een catalog geïmplementeerd in een gateway echt beleid koppelt aan een logische modelnaam.
Wil je een beheerde catalog van goedgekeurde modellen met budgetten en beleid per model? Boek een demo.
Een model catalog is een gecureerde set van logische modelvermeldingen. Elke vermelding bestaat uit twee helften.
De eerste helft is de binding: een logische naam (bijvoorbeeld summarizer-prod) gekoppeld aan één of meer werkelijke targets (een specifieke provider, modelversie en endpoint). Dit is dezelfde indirectie die een logische/virtuele modelnaam je biedt: applicaties roepen de naam aan, niet de ruwe provider.
De tweede helft is het beleid dat aan die vermelding is gekoppeld:
Een vermelding staat pas "in de catalog" als beide helften bestaan. Dat is het verschil tussen een catalog en een lijst met modelnamen op een wiki: de catalog handhaaft, omdat het beleid meereist met de vermelding en bij elke aanroep wordt toegepast.
Omdat het beleid is gekoppeld aan de logische naam in plaats van aan applicatiecode, is het wijzigen ervan een handeling op één enkele plek. Verlaag het budget van een team, vervang de onderliggende modelversie, voeg een PII-guardrail toe, en elke service die die logische naam aanroept, neemt de wijziging over bij de eerstvolgende request. Geen hernieuwde deployments, geen zoektochten door repositories naar hardcoded modelstrings.
Dit is de belangrijkste verduidelijking in dit artikel, omdat de termen door elkaar worden gebruikt terwijl ze naar compleet verschillende systemen verwijzen.
Een model registry (denk aan de artifact registries in MLOps-tooling) beheert getrainde model-artefacten. De eenheid hiervan is een model dat je zelf hebt geproduceerd: een set weights, met versies, lineage terug naar de trainingsrun en dataset, metrics en een levenscyclus (staging, productie, gearchiveerd). Je gebruikt een registry wanneer je data scientists modellen trainen en je die artefacten eerlijk, traceerbaar en reproduceerbaar moet beheren, promoten en deployen.
Een model catalog beheert de toegang tot modellen die je teams gebruiken, waarvan je de meeste niet zelf hebt getraind, zoals LLM-API's van derden en open-weight modellen die je zelf host. De eenheid hiervan is een goedgekeurde, aan beleid gebonden vermelding. Je gebruikt een catalog om te controleren wie welk model mag aanroepen, tegen welke kosten, in welke regio en onder welke guardrails.
De verwarring is begrijpelijk omdat beide over "modellen" gaan, maar ze beantwoorden verschillende vragen. De ene vraagt "welke versie van het fraudemodel hebben we gedeployed, en uit welke trainingsrun kwam die?" De andere vraagt "mag het supportteam klantgegevens naar deze LLM sturen, en overschrijden we deze maand ons budget?" Een volwassen platform heeft vaak beide, en ze bevinden zich op verschillende lagen.
Als je één ding meeneemt uit dit onderdeel: een registry gaat over het aanbod van modellen die je bouwt; een catalog gaat over de beheerde vraag naar modellen die je teams gebruiken. Als je de verkeerde kiest voor een governanceprobleem, eindig je met een prachtig geversioneerde artifact store en nul controle over de OpenAI-rekening.
Zonder catalog groeit het modelgebruik organisch, wat gezond klinkt maar in feite het probleem is. Er ontstaan drie typen problemen die elkaar versterken.
Schaduwmodellen. Een engineer voegt een nieuwe provider toe om een feature op te leveren. Het werkt, dus het blijft staan. Niemand heeft het goedgekeurd, security heeft het nooit beoordeeld en het staat in geen enkele inventaris. Vermenigvuldig dit met elk team over een heel jaar en je hebt een verzameling onbekende integraties — elk een potentieel datalek — die niemand in zijn geheel kan opnoemen. Je kunt niet beheren wat je niet ziet.
Onverwachte rekeningen. Wanneer elke service zijn eigen API-key heeft, zijn de uitgaven verspreid over facturen van verschillende providers zonder gemeenschappelijke tags. De maandelijkse rekening komt binnen als één groot bedrag, en niemand kan zonder forensisch onderzoek antwoorden op de vraag "welk team heeft de stijging van 40% veroorzaakt?" Kosten die niet kunnen worden toegewezen, kunnen niet worden beheerst, wat het hele uitgangspunt is van FinOps voor AI.
Compliance-fouten. Dit is het type fout dat carrières kan beëindigen. Een onbeheerde integratie stuurt klantgegevens uit de EU naar een model dat in een Amerikaanse regio draait, wat een afspraak over dataresidentie schendt. Of ruwe prompts met PII bereiken een provider zonder dat er onderweg PII is geanonimiseerd. Of een applicatie lekt een secret in een prompt en dit wordt gelogd aan de kant van de provider. Elk van deze fouten ontstaat doordat er geen handhavingspunt was tussen de applicatie en het model.
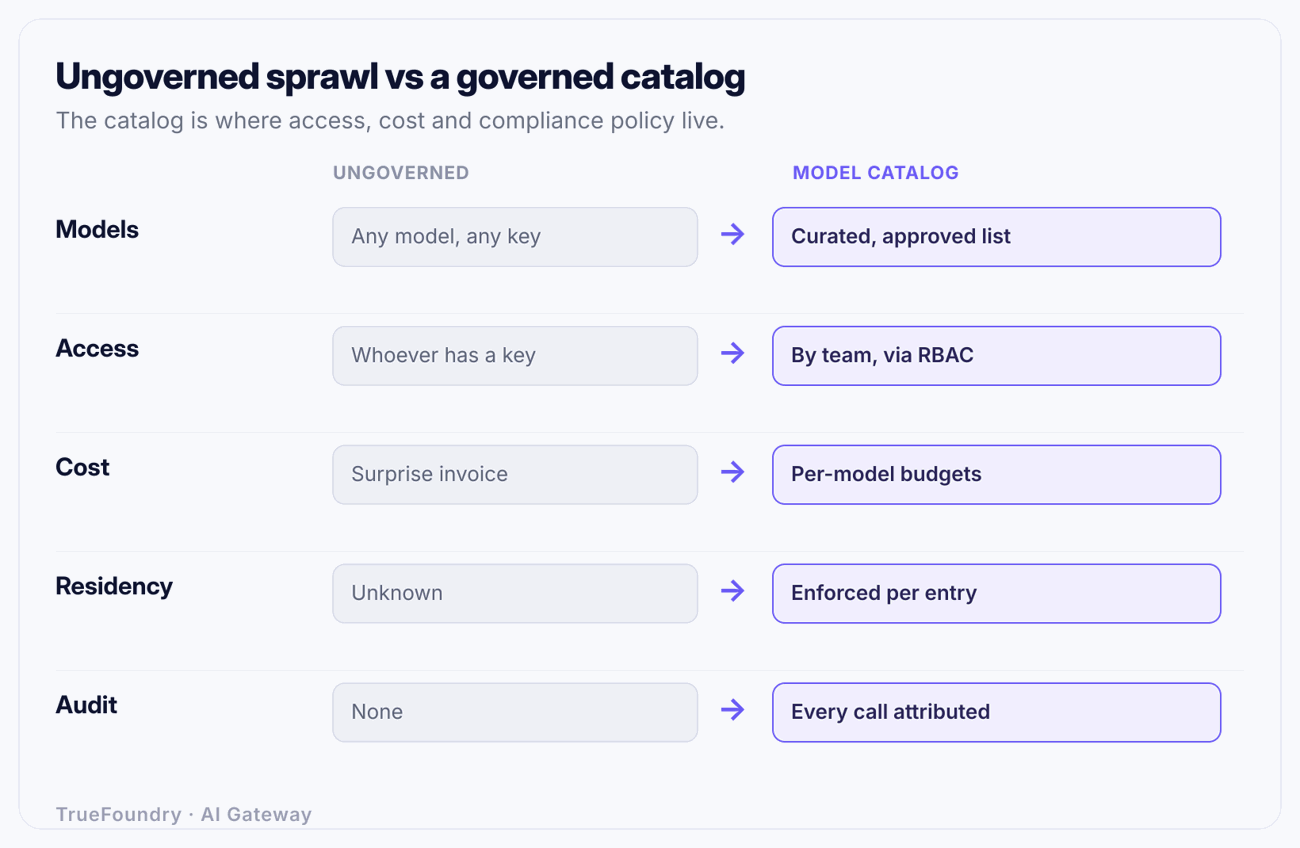
De gemeenschappelijke oorzaak is het ontbreken van een centraal controlepunt. Directe koppelingen tussen apps en providers betekenen dat er geen enkele plek is om het gebruik in te zien, kosten toe te wijzen of beleid te handhaven. Een catalog, geïmplementeerd bij een gateway, herintroduceert dat controlepunt zonder dat teams de keuzevrijheid voor modellen kwijtraken: ze maken nog steeds gebruik van self-service, maar dan uit een goedgekeurde, beheerde set.
Bekijk hoe TrueFoundry toegangs-, kosten- en residentiebeleid koppelt aan elk model. Boek een demo.
De catalog is alleen zo nuttig als de handhaving ervan, en die handhaving is de reden waarom deze in de AI gateway thuishoort en niet in een document. Structureel is dit hetzelfde controlepunt dat een LLM-proxy biedt: elke request passeert één centrale plek, zodat het beleid bij elke aanroep kan worden toegepast.
Dit is wat er gebeurt bij een enkele request wanneer de catalog zich in de gateway bevindt. Een service roept de logische modelnaam support-assistant aan. De gateway:
support-assistant staat. Niet toegestaan? Dan wordt de request geweigerd.Elk van deze stappen verwijst naar het beleid van de vermelding, niet naar code in de aanroepende service. Dat is het hele punt. De applicatie stuurt een naam; de gateway handhaaft alles wat aan die naam is gekoppeld. Pas de binding aan (nieuwe modelversie) of het beleid (lager budget, extra guardrail) in de catalog, en de volgende request voldoet er direct aan, zonder dat er een applicatiewijziging nodig is.
Dit maakt de catalog ook de logische plek voor de beheersmaatregelen die in governance-tooling worden beschreven. Rate limits en budgetten worden gedetailleerd beschreven in LLM token rate limiting en budgetten; de toewijzing die budgetten waardevol maakt staat in LLM-kostentoewijzing en teambudgetten; de veiligheidscontroles staan in AI guardrails; en de handhaving van dataresidentie staat in dataresidentie. De catalog is de plek waar dat beleid aan specifieke modellen wordt gekoppeld, en het past naadloos in het bredere pakket aan AI-governancetools.
TrueFoundry implementeert precies dit: een model catalog waarin elke logische modelnaam zijn eigen toegangsbeheer, budget, rate limits, residentie en guardrails heeft. Dit wordt bij elke request gehandhaafd op het niveau van de gateway, met observability per request, getagd op gebruiker, team en model. Omdat het dataplane in je eigen VPC, on-premise of air-gapped kan draaien, is residentie geen belofte op een dashboard, maar een fysieke eigenschap van de locatie waar het netwerkverkeer verwerkt wordt.
Concreet kan de vermelding voor support-assistant het volgende inhouden: logische naam support-assistant, ondersteund door een specifieke modelversie van een provider; toegang beperkt tot de teams Support en CX; budget 2.000 USD/maand; rate limit 50.000 tokens/minuut per team; residentie vastgezet op de EU; guardrails PII-anonimisering en prompt-injectiondetectie, ingeschakeld voor zowel in- als uitvoer. Een developer van het Support-team roept support-assistant aan en krijgt een beheerd model zonder kennis te hoeven hebben van de provider, de regio of de limieten. Een developer uit een ander team die dezelfde naam aanroept, wordt geweigerd. Dat is self-service en governance tegelijkertijd.
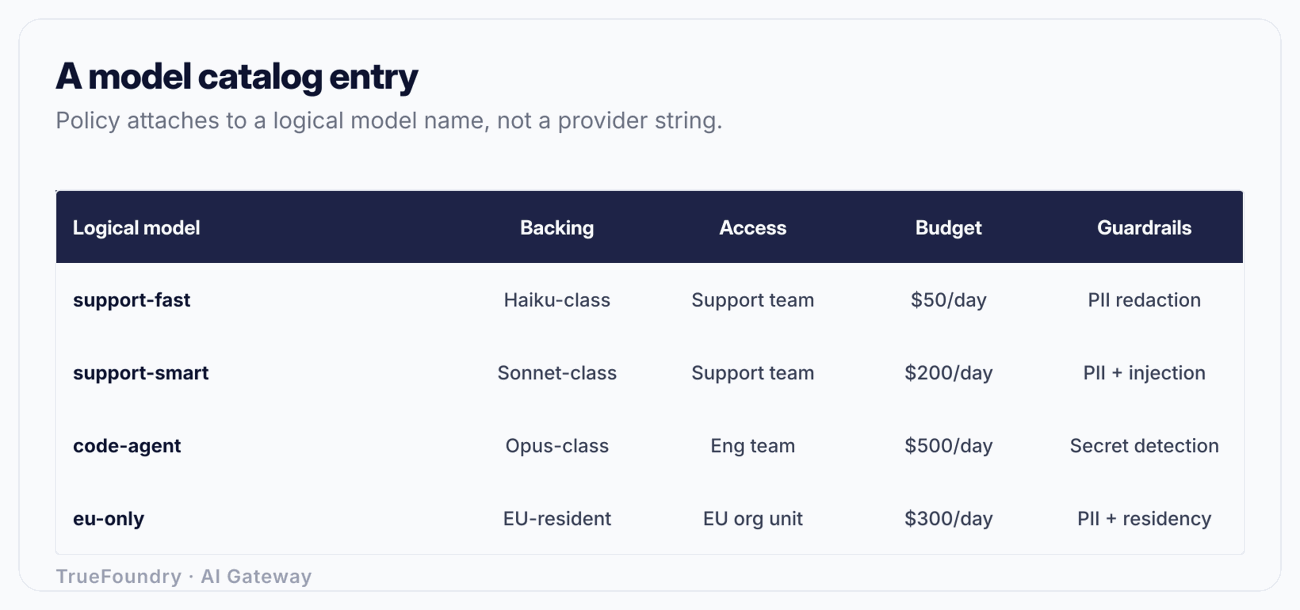
Hier is een voorbeeld van hoe een kleine, maar realistische catalog eruitziet. Elke rij is één logische vermelding; de kolommen tonen het gekoppelde beleid. De cijfers dienen ter illustratie.
Lees een willekeurige rij van links naar rechts en je kunt voor dat specifieke model elke governancevraag beantwoorden: wie, hoeveel, hoe snel, waar en hoe veilig. Lees een kolom van boven naar beneden en je kunt één specifieke dimensie over alle modellen heen auditen, bijvoorbeeld: "welke modellen zijn vastgezet op de EU?" Die helderheid in twee richtingen is wat een catalog je oplevert, en wat een verzameling losse API-keys nooit kan bieden.
Een catalog verwarren met een registry. Teams richten een model registry in, beheren alle versies keurig, maar kunnen nog steeds niet controleren wie de OpenAI-API aanroept of wat het kost. Een registry beheert immers de artefacten die je traint, niet de toegang tot modellen die je gebruikt. Bepaal welk probleem je hebt voordat je een tool kiest.
De catalog behandelen als een statische lijst. Een pagina met goedgekeurde modellen op een wiki is geen catalog; het is documentatie die door niemand wordt gehandhaafd. De waarde zit in de handhaving bij elke request. Als de lijst een geautomatiseerde aanroep zonder autorisatie of een prompt die de residentie schendt niet blokkeert, is het een advies, geen beheersmaatregel.
Beleid koppelen aan applicatiecode in plaats van aan de modelnaam. Als je budgetcontroles of een regio hardcodeert in elke service, ontstaat er versnipperd, inconsequent en niet-auditeerbaar beleid dat verandert zodra iemand vergeet het toe te voegen. Koppel het beleid aan het logische model in de catalog, zodat elke aanroepende app dit overneemt en wijzigingen vanaf één centrale plek doorwerken.
Wel kosten beheren, maar geen data. Budgetten en rate limits vormen de makkelijke helft. De echt kostbare fouten betreffen compliance: data die de regio verlaat, PII die niet-geanonymiseerd bij een provider terechtkomt. Een catalog die wel de uitgaven beheert, maar niet de residentie en guardrails, laat risico's openstaan die grote gevolgen kunnen hebben.
Het ontbreken van toewijzing per request. Als gebruik op het moment van de aanroep niet wordt getagd per gebruiker, team en model, zijn budgetten niet te handhaven en blijft de maandelijkse rekening een raadsel. Toewijzing moet plaatsvinden waar het netwerkverkeer stroomt — bij de gateway — en niet achteraf worden gereconstrueerd uit facturen van providers.
Een model catalog verandert de vraag "welke modellen mogen we gebruiken, en onder welke regels?" van een onbeantwoordbaar vraagstuk in een beheerde, gehandhaafde lijst. Elke vermelding is een logische modelnaam met een eigen toegangsbeheer, budget, rate limits, residentie en guardrails. Omdat het beleid aan de naam gekoppeld is, wijzig je het op één plek en houdt elke aanroepende app zich eraan. Cruciaal is dat een catalog geen model registry is: de ene beheert de toegang tot modellen die je gebruikt, de andere beheert de versies van artefacten die je zelf traint.
De reden om dit in een gateway te implementeren is handhaving. Een lijst op een wiki legt een intentie vast; een catalog bij het centrale controlepunt waar elke request langs komt, weigert daadwerkelijk een ongeautoriseerde aanroep, beperkt een team dat over het budget gaat, houdt EU-data binnen de EU en anonimiseert PII voordat het de organisatie verlaat. Dat is hoe je teams self-service toegang geeft tot modellen, terwijl je de kosten, toegang, residentie en veiligheid onder controle houdt — in plaats van de gaten achteraf te ontdekken op de factuur of tijdens een audit.
Beheer welke modellen je teams kunnen gebruiken vanuit één catalog. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.




Een modelcatalogus is de samengestelde, gereguleerde lijst van modellen die uw teams mogen aanroepen, waarbij elk item een logische modelnaam is met gekoppeld beleid: toegangscontrole, budget, rate limits, dataresidentieregio, en guardrails. Dit wordt bij elk verzoek gehandhaafd, niet alleen gedocumenteerd.
Een modelregister slaat artefacten op van getrainde modellen die u produceert - gewichten, versies, lineage, staging - voor reproduceerbaarheid en implementatie. Een modelcatalogus reguleert de toegang tot de modellen die uw teams gebruiken, inclusief API's van derden, door beleid aan goedgekeurde items te koppelen. Het ene beheert aanbod dat u bouwt; het andere reguleert vraag die u gebruikt.
Spend tracking vertelt achteraf wat er is gebeurd. Een catalogus voorkomt problemen voordat ze gebeuren: het weigert ongeautoriseerde aanroepen, retourneert 429 wanneer een team zijn budget of rate limit overschrijdt, dwingt dataresidentie af, en past guardrails toe, bij elk verzoek. Het sluit ook de hiaten rond schaduwmodellen en compliance die uitgavenrapporten nooit aan het licht brengen.
In de AI Gateway of het control plane, de ene plek waar elk verzoek doorheen gaat. Dat zorgt ervoor dat beleid gekoppeld is aan de logische modelnaam en bij elke aanroep wordt gehandhaafd, in plaats van verspreid te raken over applicatiecode waar het afdrijft en niet kan worden geauditeerd.
Ja, als deze wordt geïmplementeerd op een gateway waarvan het dataverkeer draait waar uw data moet blijven. Elk item in de catalogus kan een residentieregio vastleggen, en de gateway routeert alleen naar doelen binnen die regio. Bij een in-VPC-, on-prem- of air-gapped implementatie is residentie een eigenschap van waar verkeer fysiek doorheen stroomt, niet slechts een instelling.



Het laatste nieuws, artikelen en bronnen in je inbox