



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Klassieke API rate limiting gaat ervan uit dat verzoeken uitwisselbaar zijn: een GET /users/42 kost ongeveer hetzelfde als het volgende verzoek, dus het tellen van verzoeken is een goede benadering voor de belasting. Elke rate limiter die je hebt geconfigureerd, is daarop gebouwd.
LLM-verkeer doorbreekt dit patroon. Hetzelfde eindpunt, dezelfde minuut, dezelfde gebruiker: “samenvatten in één regel” is misschien 50 tokens heen en terug; een contract van 150 pagina's dat naar een reasoning-model wordt gestuurd, zit dicht bij de 200.000. Beide zijn één verzoek, en een limiet van 1.000 verzoeken per minuut staat beide toe.
Die variatie is de normale vorm van productie-verkeer zodra agents erbij betrokken zijn, omdat een agent-stap de hele conversatie plus tool-resultaten plus opgehaalde context bij elke stap opnieuw meeneemt in de prompt. Het aantal verzoeken blijft gelijk terwijl het aantal tokens een orde van grootte stijgt — het mechanisme achter de agentic token explosie in CI/CD.
Verander dus de eenheid. Tel tokens, want tokens zijn wat je koopt. Het aantal verzoeken blijft nog steeds van belang — ze beschermen de gateway en de verbinding met de provider — dus voer beide uit.
De meeste verwarring hier is een kwestie van terminologie. Vier problemen, vier mechanismen, en teams stellen routinematig de ene in terwijl ze denken dat ze de andere hebben geïnstalleerd:
Rate limits zijn een beschikbaarheidsmaatregel; budgetten zijn een financiële maatregel. Ze falen op verschillende manier en hebben verschillende eigenaren — het platform beheert de eerste, finance de tweede.
De veelgemaakte fout is het instellen van een token rate limit en dit kostenbeheersing noemen. 20.000 tokens per minuut op een goedkoop model is een paar dollar per dag; op een geavanceerd reasoning-model is het een heel ander bedrag, en het verandert wanneer een provider zijn prijzen aanpast. Token doorvoer is geen geld.
Providerlimieten verdienen een waarschuwing, omdat teams er onbedoeld te veel op vertrouwen. De limiet van jouw OpenAI- of Anthropic-organisatie is één gedeelde pool: wanneer een batchjob deze verzadigt, wordt jouw klantgerichte product vertraagd door een systeem dat niet kan uitdrukken dat "de assistent altijd voorrang heeft". Daarom heb je een gateway die je zelf beheert nodig.
Het algoritme bepaalt hoeveel piekverkeer (burst) erdoorheen komt — een belangrijk detail voor agents.
Voor menselijk chatverkeer is een vast venster prima — mensen stemmen hun acties niet op elkaar af. Agents doen dat wel, per ongeluk. Ze proberen het opnieuw bij fouten, werken parallel en draaien volgens schema's, waardoor veel aanroepers op exact hetzelfde moment de limiet raken, en het verdubbelingsscenario niet langer theoretisch is. Sliding windows lossen dat op omdat er geen vast resetmoment is. Token bucket beantwoordt een andere vraag — het is geschikt voor verkeer waar je korte pieken wilt toestaan — ten koste van nog een parameter om in te stellen.
Downgraden wordt het meest onderbenut: als een limiet op modelniveau wordt bereikt, kan een fallback-keten vanuit een tweede provider leveren in plaats van een menselijke gebruiker een 429 te tonen — het failover-mechanisme in ons artikel over LLM routers, waar 429 een activerende statuscode is. Een overschrijding van het budget is anders: als het geld op is, is het op, en het stilzwijgend uitgeven op een goedkopere plek is niet wat finance heeft gevraagd.
De generieke regel boven de specifieke regel plaatsen. Bij handhaving op basis van "eerste overeenkomst wint" (first-match-wins) zal een brede regel bovenaan verkeer opslokken dat had moeten matchen met een specifiekere regel eronder. De specifieke regel wordt nooit geactiveerd.
Eén gedeelde teller behandelen als een limiet per gebruiker. "20.000 tokens per minuut" zonder verdere specificatie is één teller voor iedereen. De eerste aanroeper verbruikt alles.
Maken van de aanname dat mislukte verzoeken gratis zijn. Voor limieten op basis van verzoeken zijn ze dat niet — en voor tokenlimieten is het antwoord anders.
Twee beleidsobjecten, bewust gescheiden: rate limiting regelt de doorvoer, budgetten regelen het geld.
Rate limit regels accepteren zes eenheden — de volledige set:
requests_per_minute · requests_per_hour · requests_per_day · tokens_per_minute · tokens_per_hour · tokens_per_day
Er is geen eenheid per seconde; een enkel LLM-verzoek kan tientallen seconden duren, dus limieten per seconde zouden ruis meten. De configuratie bevindt zich in het tabblad Config:
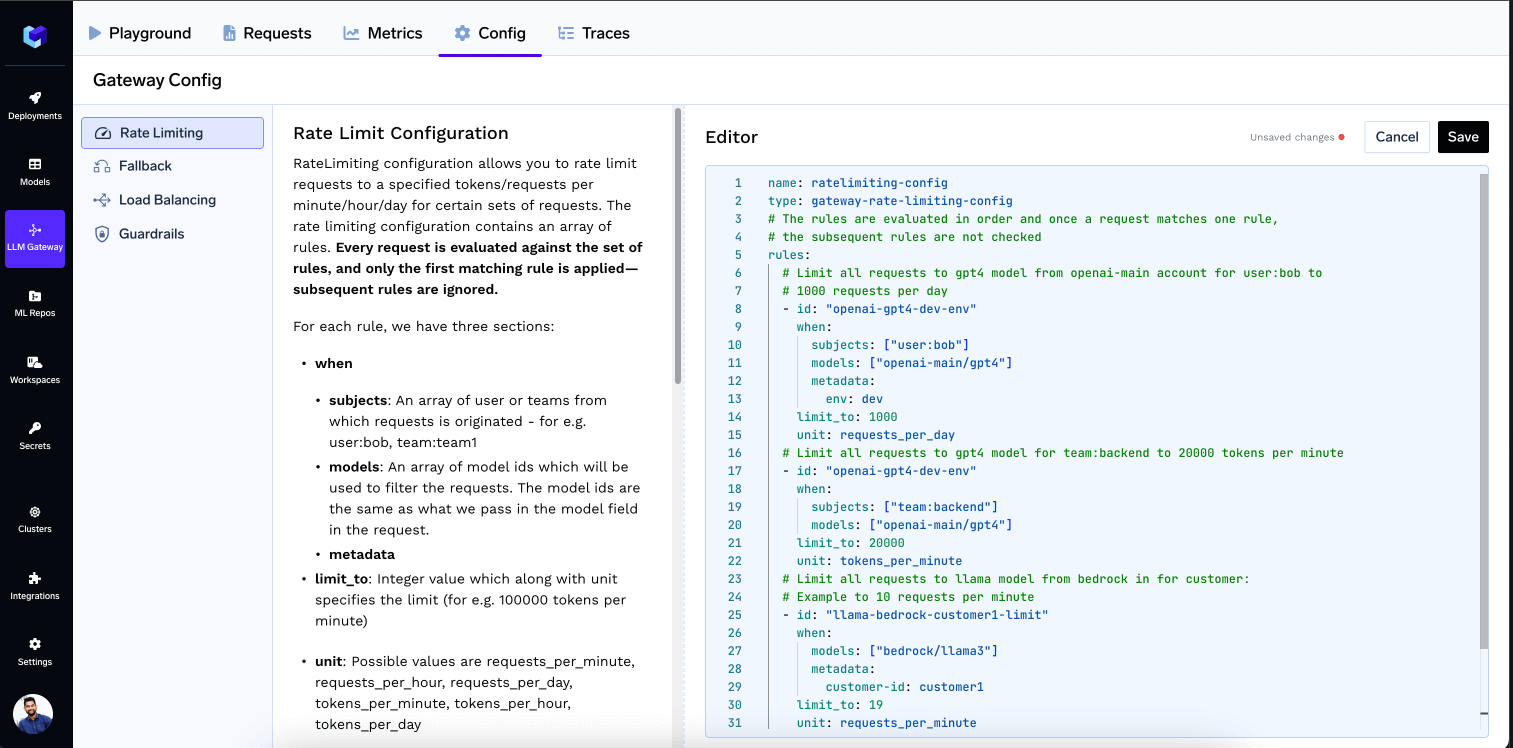
Een regelset is van het type: gateway-rate-limiting-config met een lijst met regels. Elke regel heeft een statische id, een when-blok waarvan de onderwerpen, modellen en metadata-voorwaarden worden gecombineerd met AND, een gehele getalwaarde limit_to, een unit, en optioneel rate_limit_applies_per. Onderwerpen hebben een voorvoegsel — user:, team:, virtualaccount: — en metadata leest de header X-TFY-METADATA.
Omdat de kleinste eenheid per minuut is, onderhoudt de gateway een venster van 60 seconden, houdt tijdsgebaseerde buckets bij van elke 10 seconden voor elke gebruiker, model, team of aangepast segment, en telt de laatste 6 buckets op om de teller te evalueren. Oudere buckets vervallen. Een resolutie van tien seconden is het belangrijkste om te onthouden: een piek wordt uitgevlakt over zes sub-intervallen in plaats van twee keer te worden toegestaan op één resetgrens.
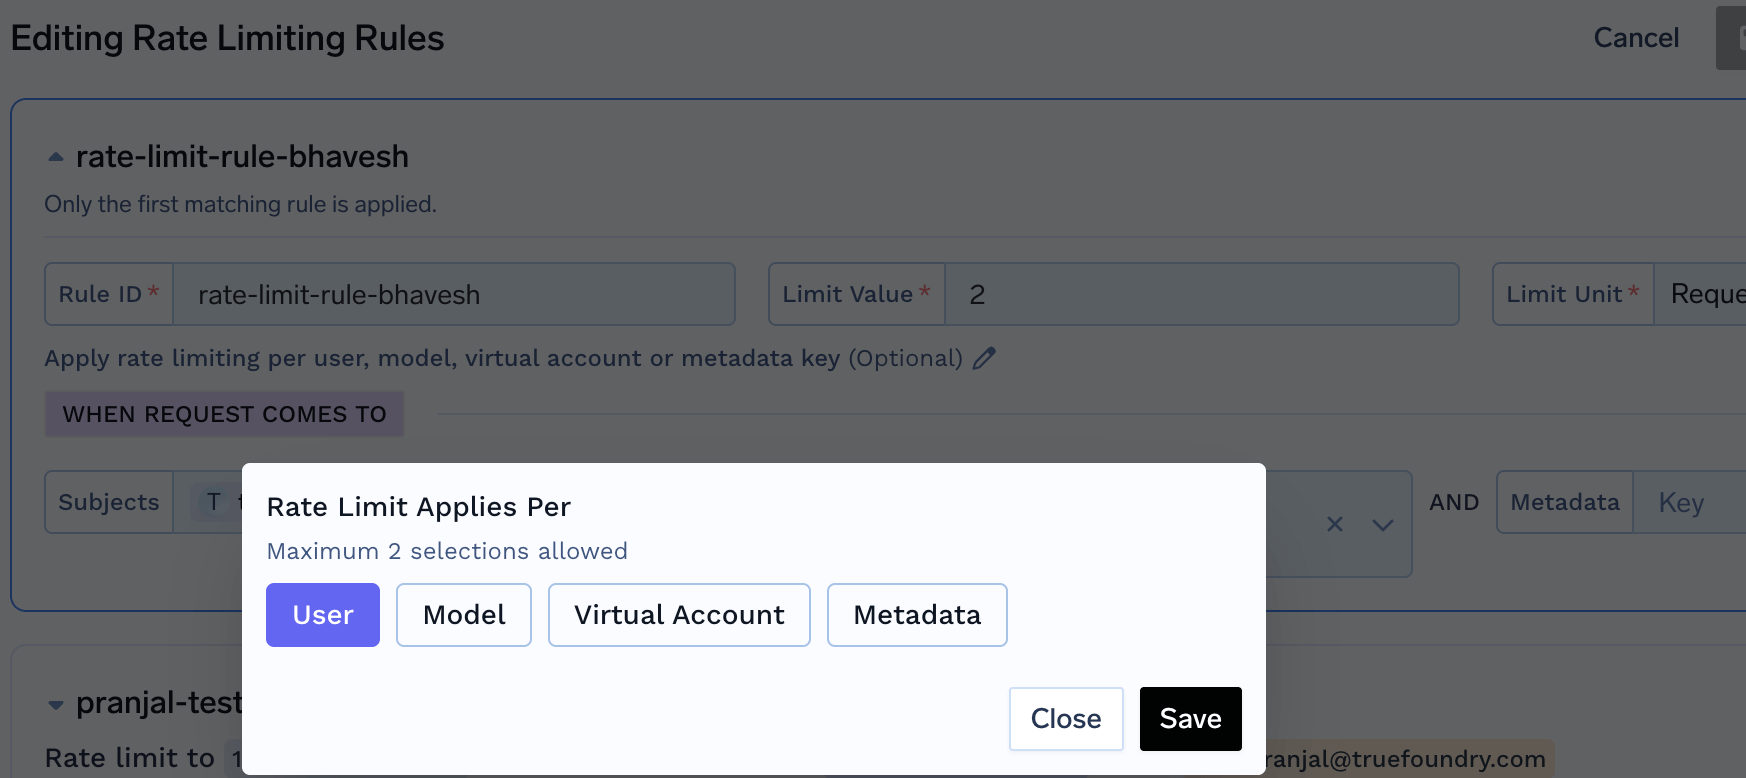
Zonder deze instelling is een regel één gedeelde teller voor alles wat ermee matcht. Mét deze instelling wordt de teller gesplitst per entiteit. Toegestane waarden zijn user, virtualaccount, model, en metadata.* met je eigen sleutel. Maximaal twee waarden per regel.
['user'] geeft elke gebruiker een eigen tegoed en ['model'] elk model het zijne. De laatste regel is het patroon dat de meeste teams uiteindelijk willen: een plafond per project op basis van metadata die de applicatie toch al meestuurt, zonder dat de regel aangepast hoeft te worden als er een nieuw project bij komt.
Dit heeft een dynamisch regel-ID formaat vervangen. Migratie is eenvoudig — {user}-daily-limit wordt id: 'user-daily-limit' plus ['user'], en project-{metadata.project_id}-limit wordt id: 'project-limit' plus ['metadata.project_id']:
Elk verzoek wordt geëvalueerd tegen elke regel, maar alleen de eerste matchende regel wordt gehandhaafd. Latere matches blokkeren het verzoek nooit. Het verbruik wordt echter berekend tegen elke regel waarmee het verzoek matcht.
Plaats gespecialiseerde regels daarom bovenaan. De gedocumenteerde fout: plaats app-a-limit (10.000 rpm, virtualaccount:app-a) boven tenant-wide-limit (5.000 rpm, when: {}), en het verkeer van app A — dat tegen beide wordt geteld — verzadigt alleen al de tenant-teller. Iedereen van wie de eerste match de tenant-regel is, krijgt dan een 429 ver onder de 5.000 rpm. De oplossing is niet het herordenen, maar het specificeren van het bereik: rate_limit_applies_per: ['user', 'virtualaccount'].
Elk verzoek dat door de gateway wordt geweigerd, of dat bij de provider mislukt met een 4XX/5XX, telt als één verzoek tegen elke requests_per_*-regel waarmee het matchte. Eén uitzondering: een verzoek dat al is geweigerd met een 429 door rate limiting zelf, zodat een golf van herhaalde pogingen de situatie niet nog erger maakt.
Tokenlimieten gedragen zich anders. Mislukte verzoeken verbruiken geen tokenquota, omdat een mislukt verzoek geen tokens rapporteert. Er valt niets te tellen. Dat is de reden waarom een retry-loop je verzoekenbudget kan uitputten terwijl het token-dashboard er gezond uitziet.
Een overschrijding geeft een HTTP 429 met error.type: "RateLimitError" en error_origin_level: "rate_limit_budget", plus een x-tfy-applied-rules header die de regel noemt die is geactiveerd.
Budgetten zijn de financiële beheersmaatregel, en ze betreffen uitsluitend kosten, cost_per_* in USD. Er is geen budget op basis van tokens — als je een tokenplafond wilt, is dat een rate limit.
Budget V2 is uitgebracht in v0.158.0 en draait de handhavingslogica om: elke matchende regel wordt gecontroleerd en ze moeten allemaal het verzoek toestaan, een AND-combinatie over budgetten heen. Rate limiting werkt volgens "eerste overeenkomst wint"; budgetten werken volgens "alle regels moeten goedkeuren". V1 gebruikte "eerste overeenkomst wint", dus de migratie is een inhoudelijke verandering, geen syntactische.
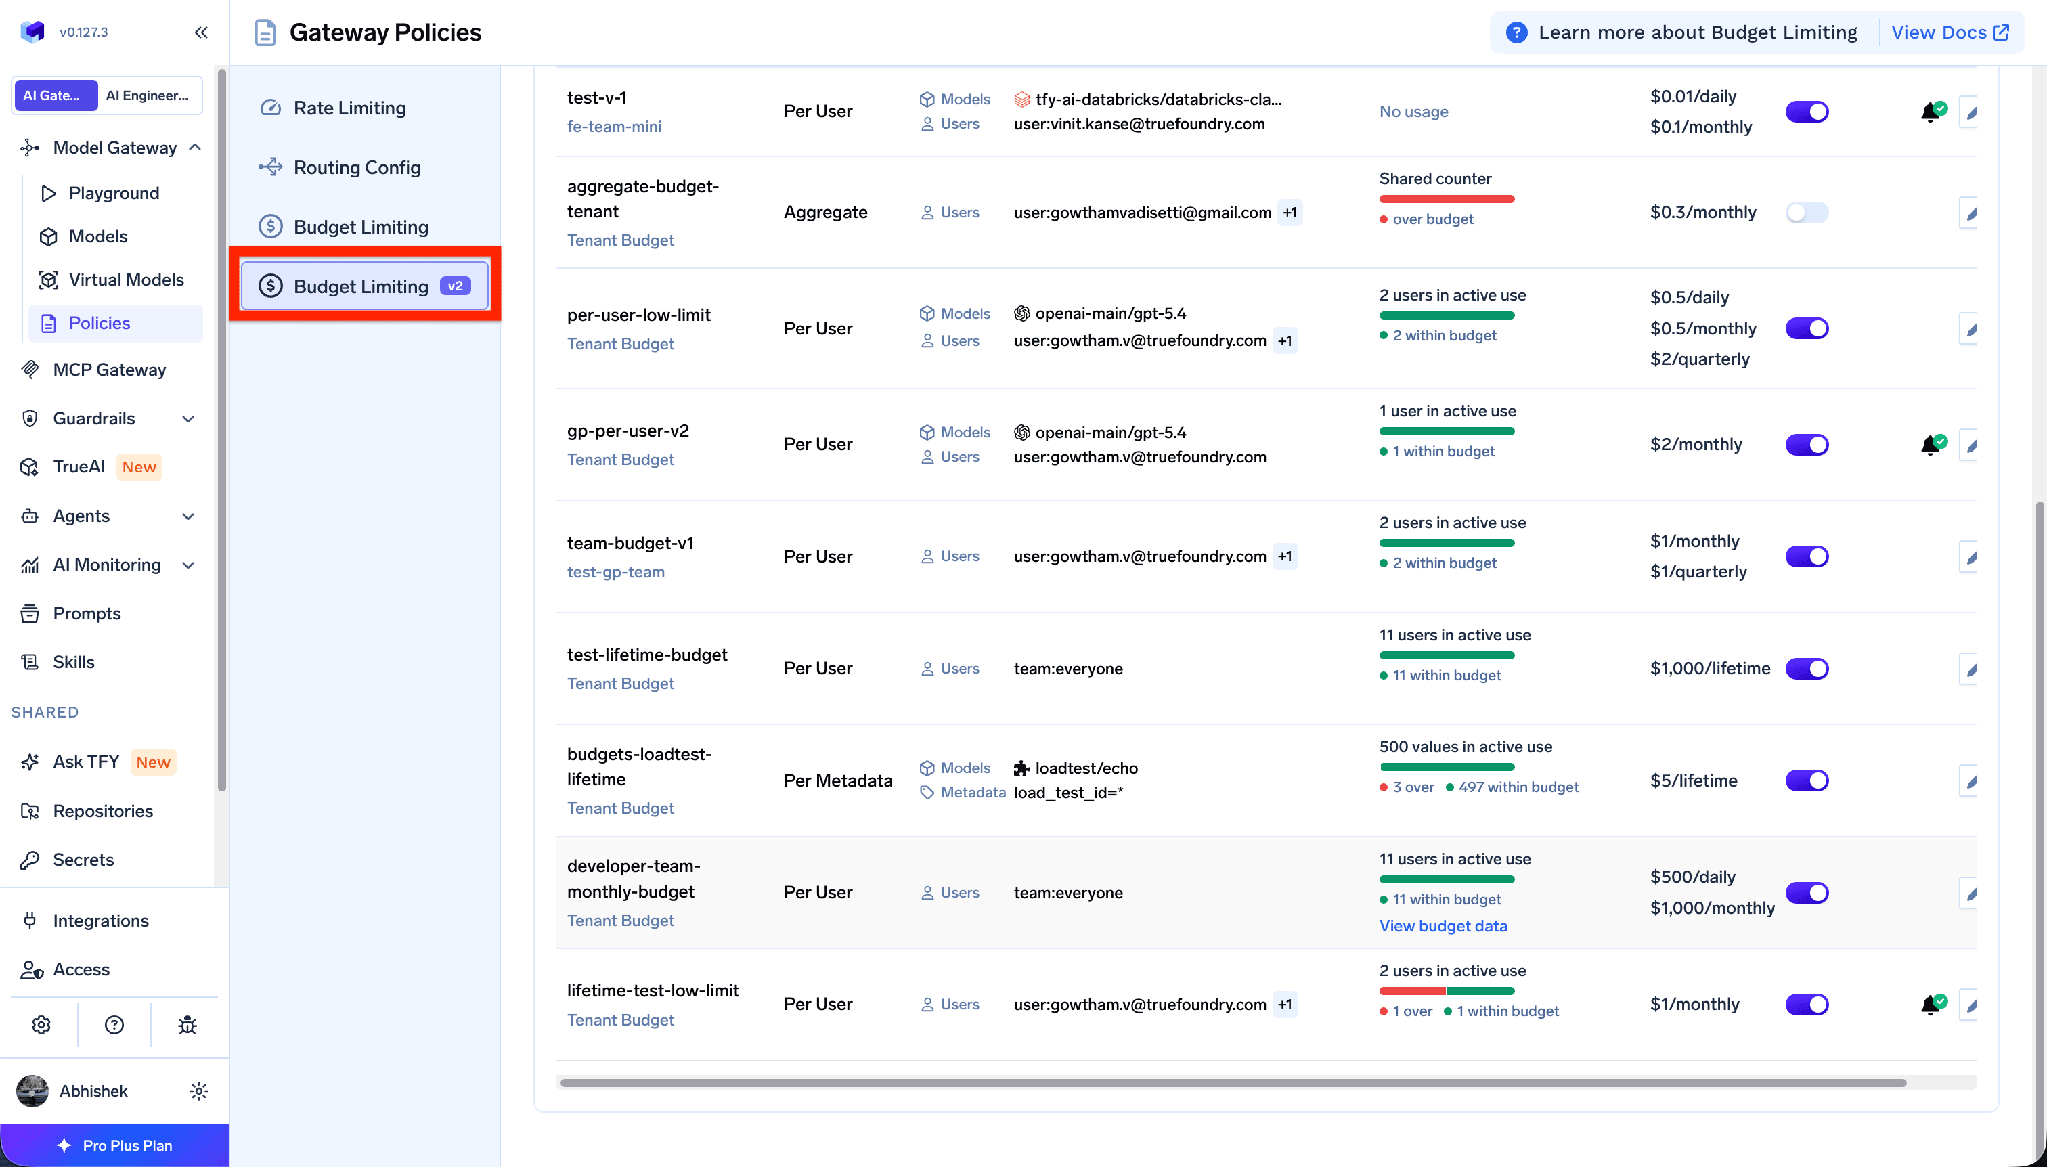
Regels bevinden zich onder AI Gateway → Policies → Budget Limiting → Add Rule, in twee niveaus: tenant (tenant-budget-config) of team (team-budget-config, met een door RBAC afgedwongen team_name).
Vijf resetperiodes, allemaal in UTC: Daily (00:00), Weekly (maandag 00:00), Monthly (1e van de maand), Quarterly (1 jan, 1 apr, 1 jul, 1 okt), en Lifetime, wat nooit reset — de uitgavenlimiet uit de tabel hierboven:
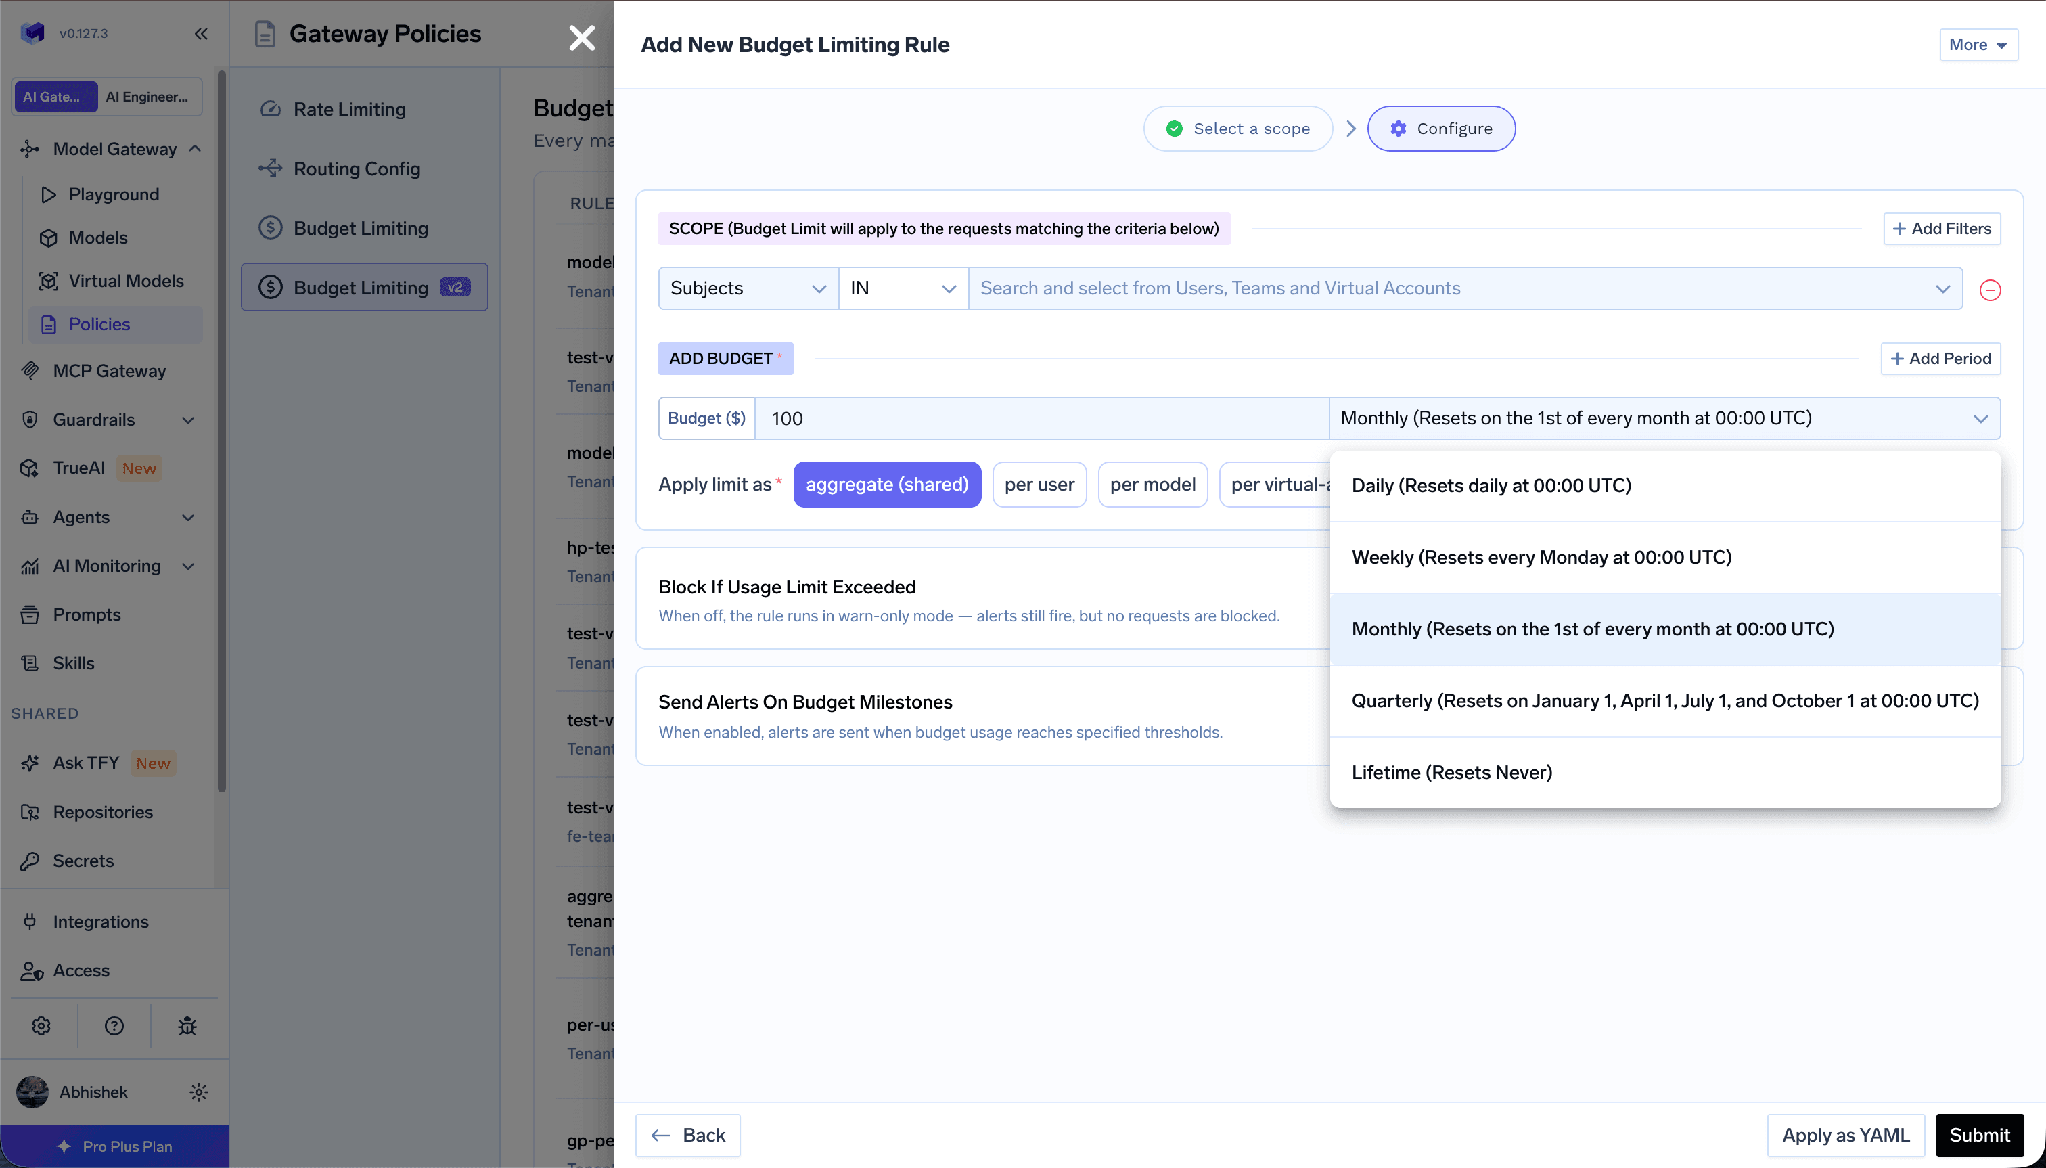
Eén enkele regel kan meerdere periodes tegelijk handhaven en blokkeert als er één wordt overschreden — het voorbeeld uit de documentatie met meerdere periodes stelt cost_per_day: 0.5, cost_per_month: 0.5 en cost_per_quarter: 2 samen in. Filters voor het bereik — Subjects, Models, Provider accounts, Metadata — accepteren IN/NOT IN en worden gecombineerd met AND:
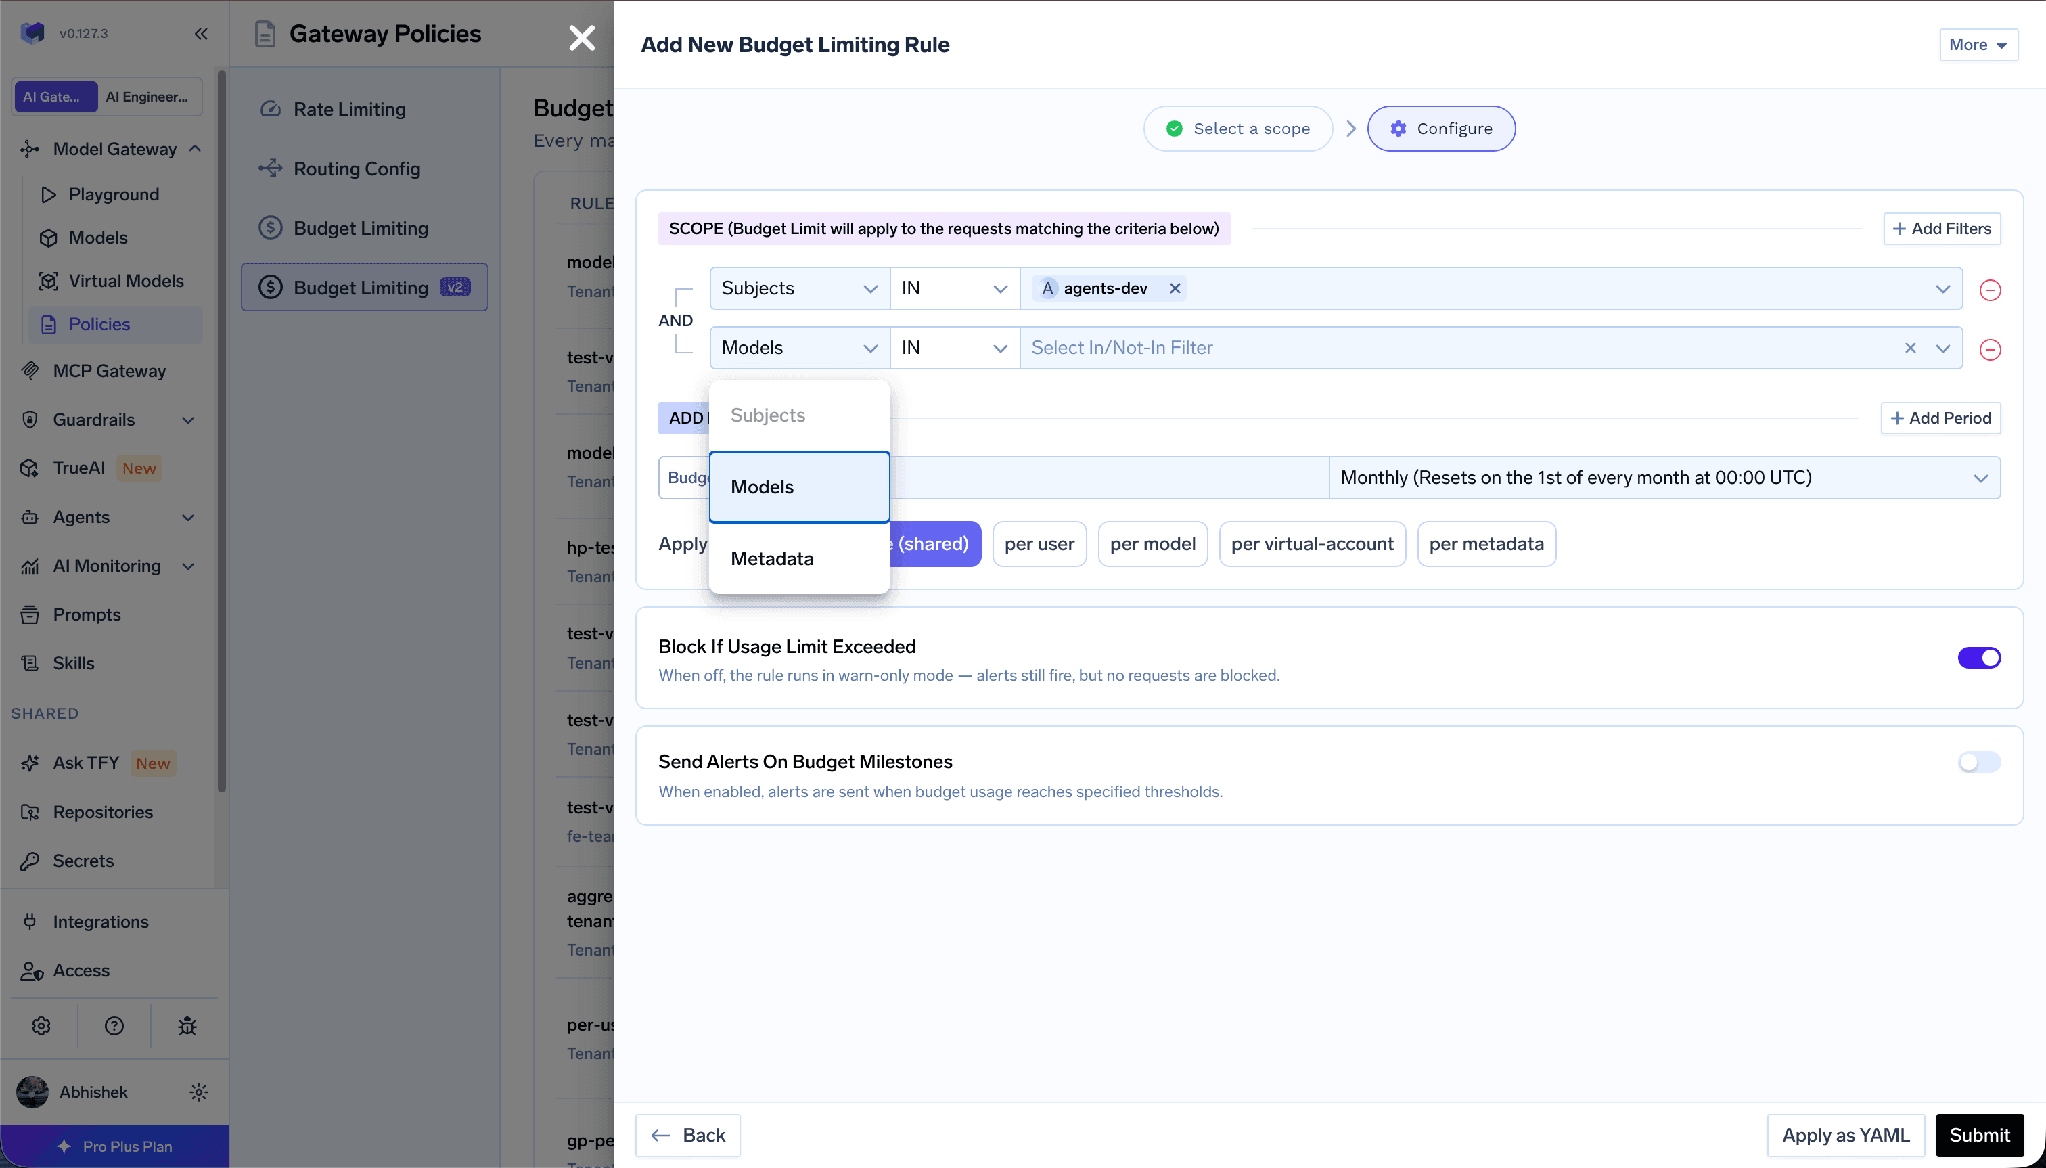
Apply limit as (applies_to.type) accepteert aggregate, per-user, per-model, per-virtual-account, of metadata met een sleutel, en kan na aanmaak niet meer worden gewijzigd. Regels per entiteit ondersteunen uitzonderingen (overrides) voor specifieke gebruikers, modellen, virtuele accounts of metadatawaarden:
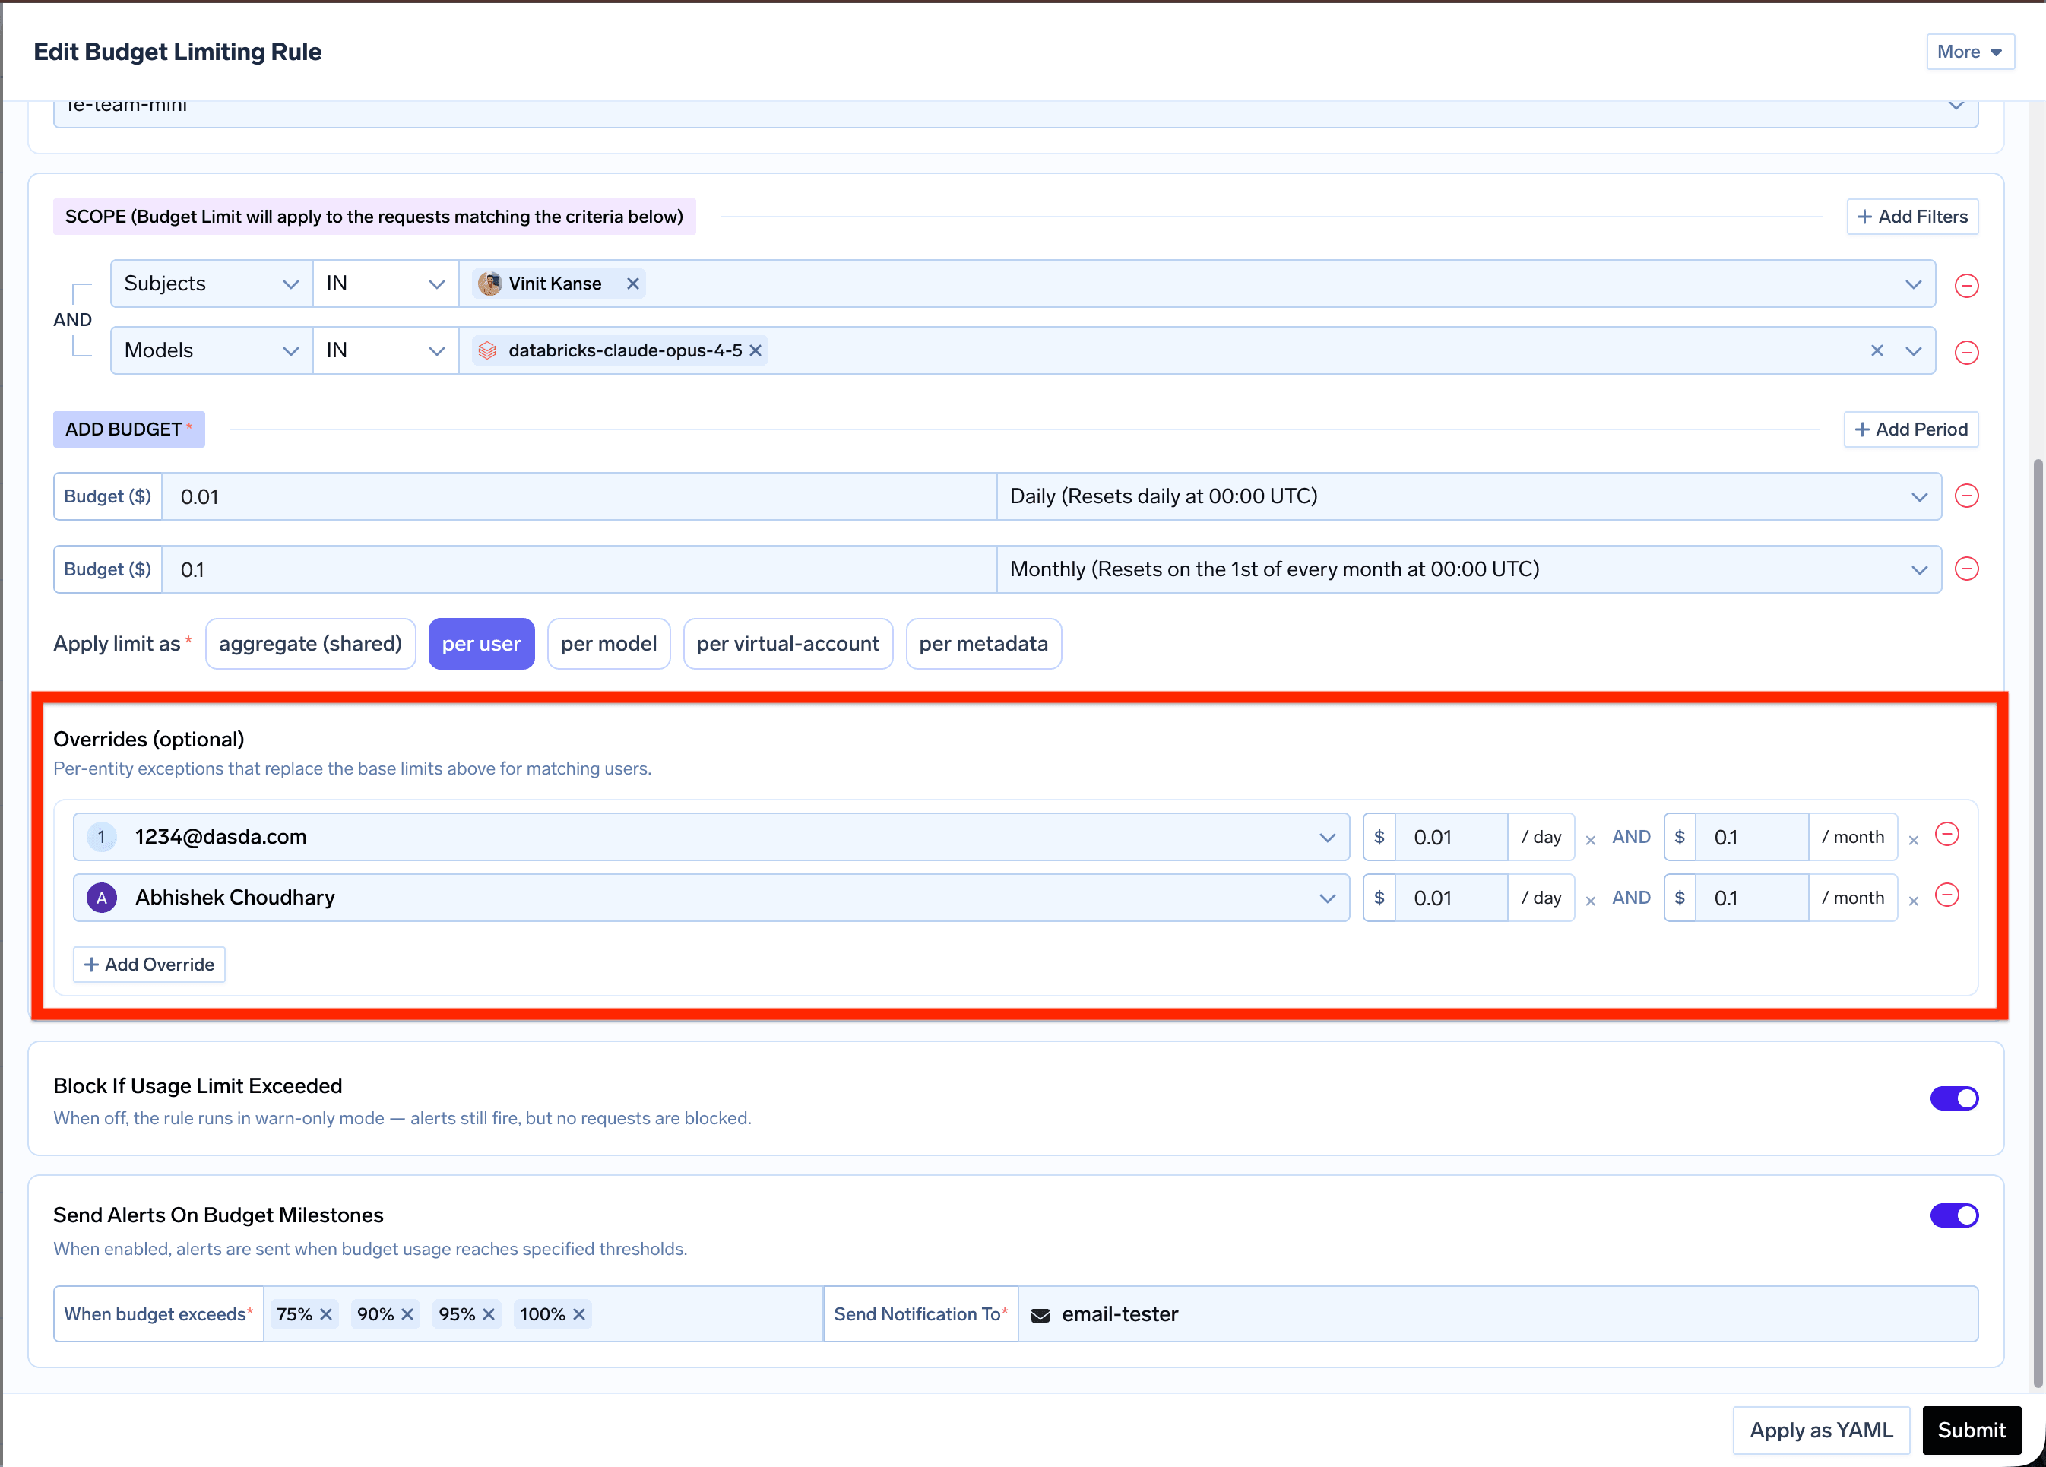
Een uitzondering vervangt alle periodes voor die entiteit. Als de basisregel dagelijkse en kwartaalplafonds instelt en de uitzondering stelt alleen een dagelijks plafond in, heeft die entiteit helemaal geen kwartaalplafond. Neem elke periode op die je wilt toepassen.
Drie modi: enforce (standaard, weigeren), audit (doorlaten, wel bijhouden, wel waarschuwen), en soft_enforce — alleen geblokkeerd wanneer geen enkel ander matchend budget het nog kan toestaan; als een ander budget nog ruimte heeft, wordt het verzoek doorgelaten en wordt de overschrijding gelogd zoals bij een audit. Eén harde enforce-overschrijding ergens heeft altijd de overhand.
Waarschuwingen worden geactiveerd op 75, 90, 95 en 100 procent, elk één keer per budgetperiode, afzonderlijk voor elke entiteit bij een budget per entiteit; Lifetime-budgetten waarschuwen eenmalig per drempelwaarde. Doelen: email, slack-webhook, slack-bot, pagerduty, ms-teams-webhook, met {{user.email}} voor levering per gebruiker.
Eén kanttekening: budgettellers starten bij het aanmaken van de regel, niet aan het begin van de periode. Eerdere uitgaven worden niet met terugwerkende kracht meegeteld, dus een regel die halverwege de maand is aangemaakt, komt die periode niet overeen met je factuur.
Budgetten zijn zo nauwkeurig als de prijsstelling erachter, dus die prijsstelling is openbaar. De catalogus op github.com/truefoundry/models is de prijsdatabank die wordt gebruikt voor de openbare kostenbijhouding, te bekijken op truefoundry.com/models. Controleer het tarief dat bij jou in rekening wordt gebracht; dien een PR in als het niet klopt.
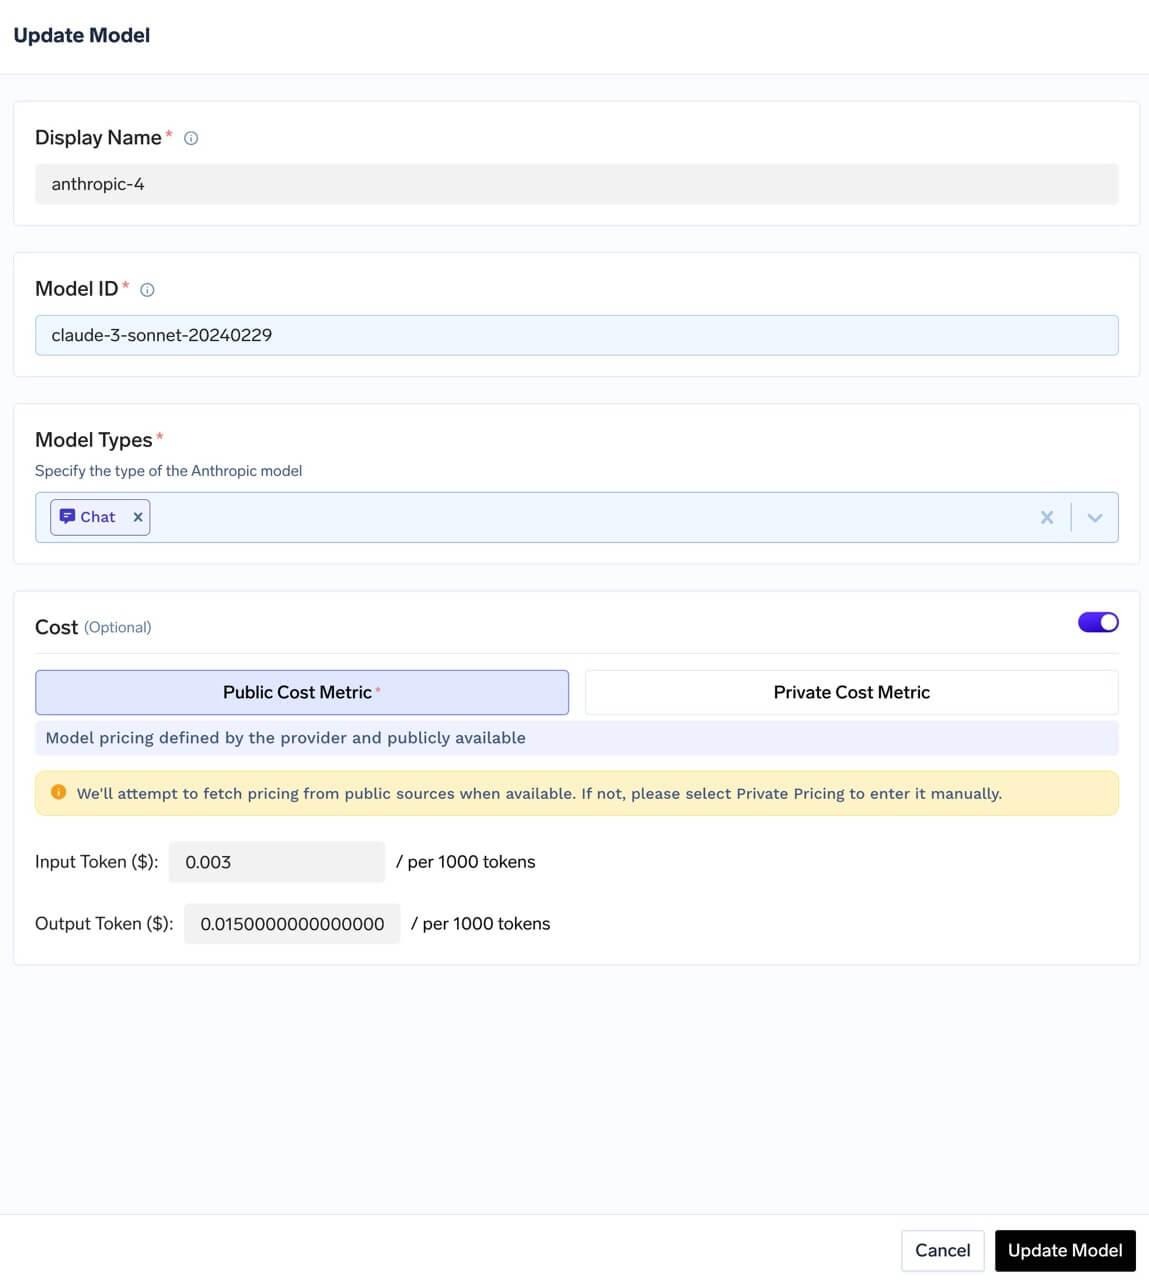
Twee details zijn belangrijk. Prijzen per regio: providers/aws-bedrock/us.amazon.nova-lite-v1:0.yaml bevat verschillende invoer- en uitvoertarieven voor us-west-2, us-west-1, eu-central-1 en eu-west-1, zodat verkeer over meerdere regio's niet verkeerd wordt geprijsd door een vast tarief. Gestaffelde prijzen (tiered pricing): providers/google-gemini/gemini-2.5-pro.yaml heeft basistarieven plus hogere tarieven vanaf 200K tokens, en gemini-1.5-flash.yaml staffelt vanaf 128K tokens. Lange context wordt niet lineair geprijsd. Modellen zonder openbare prijsstelling gebruiken een Private Cost invoer.
Een budget per gebruiker werkt alleen als verzoeken betrouwbaar worden toegewezen. Drie mechanismen maken dat automatisch in plaats van afhankelijk van de discipline van ontwikkelaars:
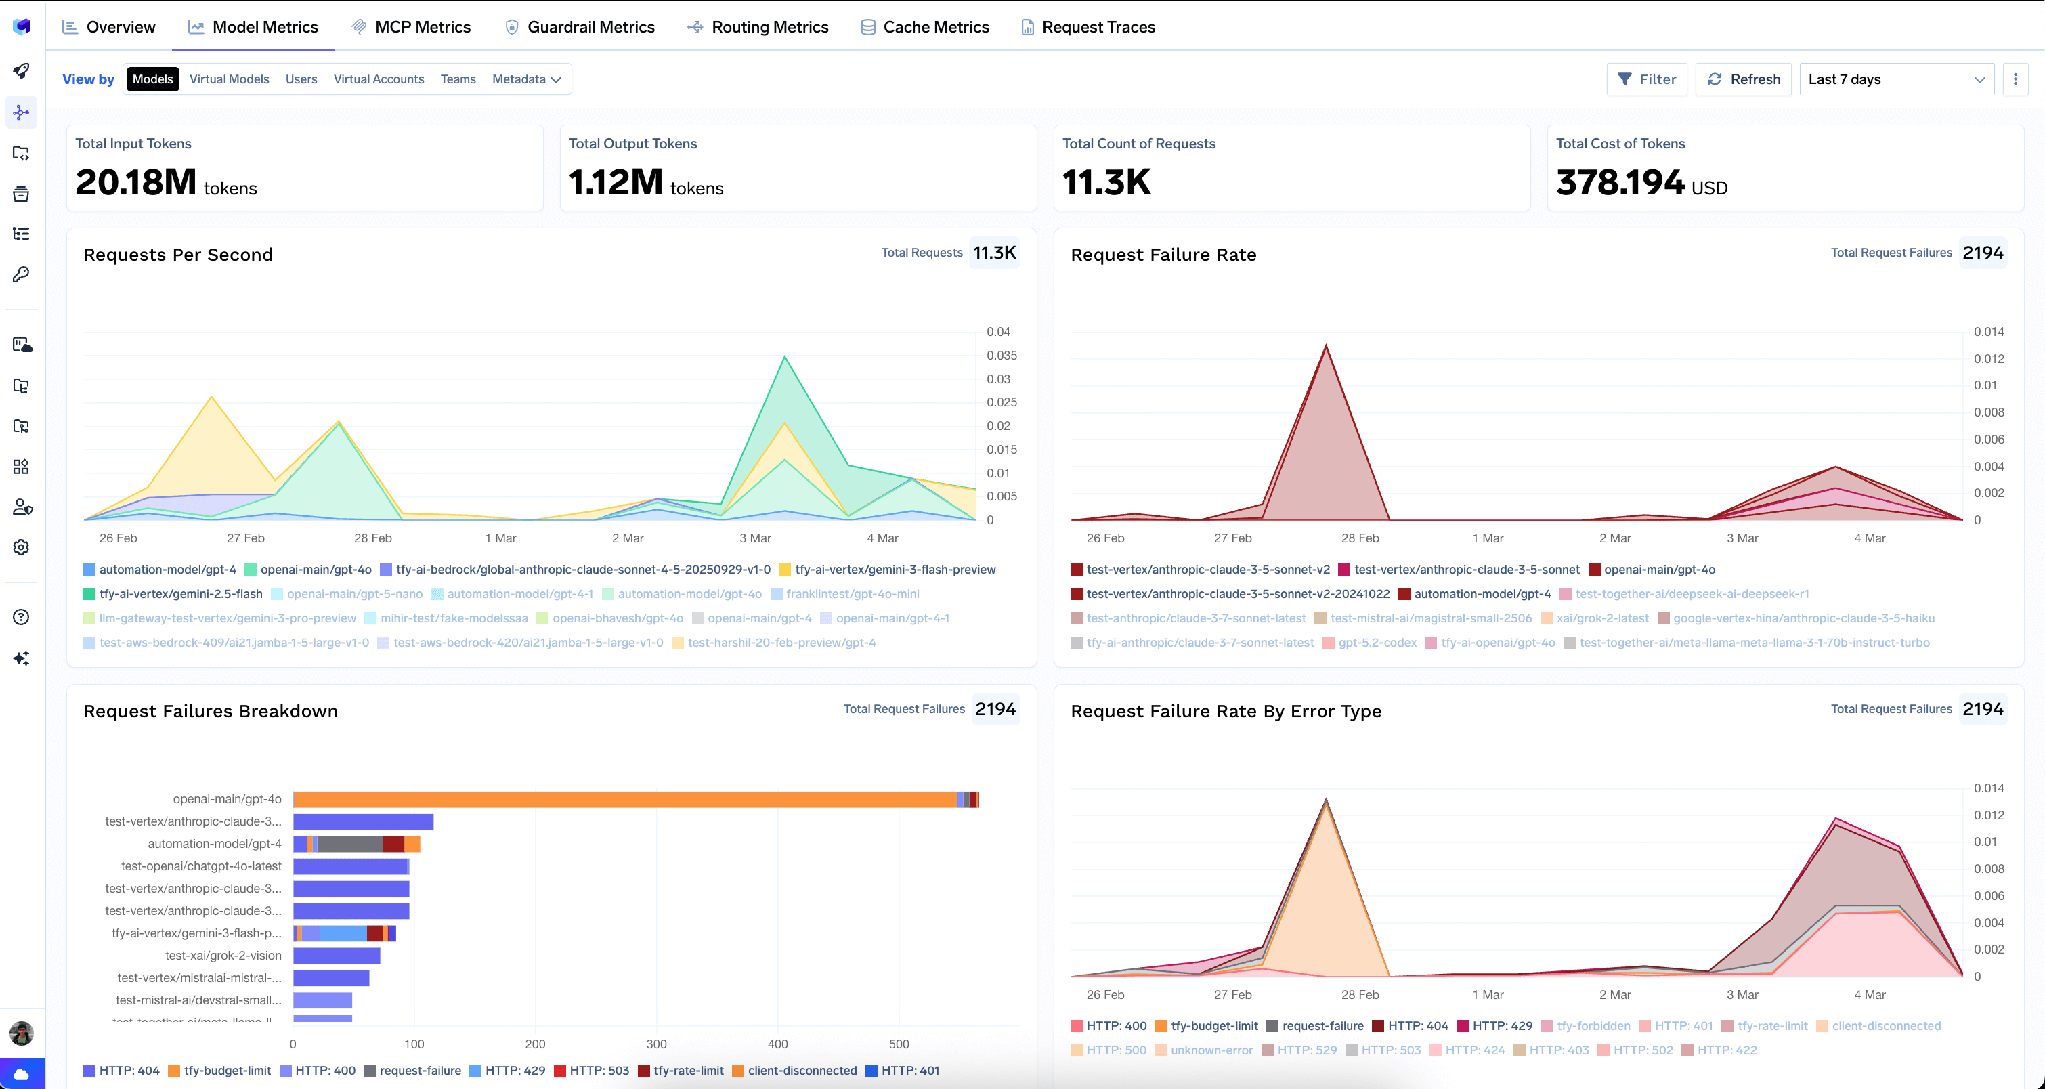
Model Metrics houdt Total Input Tokens, Total Output Tokens en Total Cost of Tokens in USD bij, te exporteren via Metrics → 3 puntjes → Download Raw Data gegroepeerd op gebruikersnaam, modelnaam of teams:
Eén gateway, drie groepen: een klantgerichte assistent, een interne codeer-agent, en een datateam dat bulk-extracties uitvoert, allemaal op één provider-account. De codeer-agent had vorige maand een slechte middag waarna al het andere verkeer een 429 kreeg.
Voorkom uitputtingsstoringen. Het probleem was een gedeelde teller, niet een ontbrekende limiet. Plaats een coding-agent-tpm regel (200.000 tokens_per_minute, subjects: ["virtualaccount:coding-agent"]) boven een generieke tenant-brede regel (500.000 tokens_per_minute, when: {}), en geef de generieke regel rate_limit_applies_per: ['virtualaccount'] zodat de agent niet de ruimte van iedereen leegtrekt door op beide te matchen. Voeg ook een requests_per_minute regel toe op dezelfde onderwerpen: mislukte verzoeken tellen wel mee voor die regel, maar niet voor de tokenregel.
Voeg het financiële plafond toe. Een maandelijks budget per gebruiker voor de codeer-agent met één uitzondering voor een ontwikkelaar, plus een Lifetime-plafond voor het extractieproject:
Beide worden gecontroleerd bij elk matchend verzoek en beide moeten goedkeuren. De uitzondering verruimt het plafond van één ontwikkelaar zonder dat van anderen te verruimen, en omdat het alle periodes vervangt, herhaalt het de periodes van de basisregel.
Start in audit-modus, ken daarna toe. Zet de modus gedurende een week op audit: het verbruik wordt bijgehouden en er worden waarschuwingen verzonden, maar er wordt niets geblokkeerd. Bekijk de 75%-waarschuwingen, pas aan op basis van het werkelijke verkeer, en dwing het daarna af. Label elk virtueel account en verplicht teamselectie op PAT's, en het doorbelastingsrapport ontstaat vanzelf — het doel van kostentoewijzing per team.
De twee systemen handhaven in tegengestelde richting. Rate limiting werkt volgens "eerste overeenkomst wint"; precies één regel blokkeert. Budget V2 werkt volgens "alle regels moeten goedkeuren"; elke matchende regel kan blokkeren. Als je het ene denkmodel op het andere toepast, zal je beleid je verrassen.
Budgetten kunnen niet worden ingesteld in tokens, en rate limits kunnen niet worden ingesteld in dollars. Je hebt beide nodig. En de documentatie-URL is /ai-gateway/ratelimiting, als één woord — met een koppelteken krijg je een 404.
Kostenbijhouding voor audio is beperkter dan voor tokens. Het omvat ElevenLabs en Google Vertex text-to-speech en speech-to-text; andere audioproviders registreren het gebruik maar geen kosten per teken of per seconde, en aangepaste audioprijzen zijn alleen beschikbaar voor Google Vertex. Speech-to-text zonder door de provider gerapporteerde duur wordt gekost op nul — een budget zal onbeperkt verkeer toelaten dat het als gratis beschouwt.
De overstap van verzoeken naar tokens is klein qua configuratie maar groot qua impact. Een verzoeken-teller vertelt je hoe druk je het hebt; een token-teller vertelt je wat je koopt; een budget vertelt je wanneer je moet stoppen.
Zorg voor de juiste gelaagdheid en de rest volgt vanzelf: tokenlimieten vlakken de minuut uit, verzoekenlimieten beschermen de verbinding, budgetten sturen de maand, en een Lifetime-plafond vangt de rest op. Het hier beschreven gedrag is gebaseerd op de documentatie van TrueFoundry van september 2026.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Same idea — cap what a caller may consume in a window — but the unit changes. Classic API rate limiting counts requests, which works when requests cost roughly the same. LLM requests vary by orders of magnitude in tokens, so a token limit tracks real consumption far better. Run both: tokens govern spend rate, requests protect the connection from retry storms.
Both. A token limit is a throughput control on a rolling window: it stops one caller monopolising capacity right now. A budget is a financial control on a calendar period: it stops a team overspending this month. A token limit cannot express dollars, since the same token count costs different amounts on different models — and a budget says nothing about the current minute.
A failed request — rejected by the gateway, or failed by the provider with a 4XX or 5XX — counts as one request against every requests_per_* rule it matched. The one exception is a request already rejected with a 429 by rate limiting itself. Token limits are unaffected: a failed request reports no tokens.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Roughly 3-4 ms of overhead, handling 350+ RPS on a single vCPU, across 1,000+ supported LLMs. The exception is the optional LLM classifier, which adds a real model call before the request is forwarded.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog of Prometheus. Elke LLM-classifieraanroep produceert zijn eigen span, zodat de latentie van de classifier apart zichtbaar is van die van het geserveerde model.



Het laatste nieuws, artikelen en bronnen in je inbox



















