



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In de huidige AI-gedreven ondernemingen zijn robuuste maatregelen voor AI safety en LLM compliance van cruciaal belang. Naarmate bedrijven krachtige large language models (LLMs) integreren in hun bedrijfsprocessen, hebben ze mechanismen nodig om deze modellen "op koers" te houden met de organisatieregels. AI guardrails vervullen deze rol – vergelijkbaar met vangrails langs de weg – door ervoor te zorgen dat elke AI-interactie de normen, het beleid en de waarden van het bedrijf weerspiegelt. Guardrails werken door automatisch LLM-prompts en -antwoorden te controleren of te transformeren om beveiligings-, privacy- en inhoudsbeleid af te dwingen. TrueFoundry’s AI Gateway sluit dergelijke guardrails in het hart van de AI-pipeline in, waarbij verzoeken en antwoorden worden gevalideerd om veiligheid, kwaliteit en compliance te garanderen. Dit artikel biedt een technisch overzicht van AI guardrails in de context van een AI Gateway. We definiëren wat guardrails zijn, leggen uit hoe ze werken, belichten hun essentiële onderdelen en beschrijven hoe organisaties ze kunnen implementeren.
AI guardrails zijn op regels gebaseerde controles en filters die rond generatieve AI-systemen worden geplaatst om het bedrijfsbeleid af te dwingen. Guardrails helpen ervoor te zorgen dat een AI-tool "werkt in overeenstemming met de normen, het beleid en de waarden van de organisatie". In de praktijk betekent dit dat guardrails gevoelige gegevens kunnen maskeren of verwijderen (voor gegevensprivacy), niet-toegestane onderwerpen kunnen blokkeren (voor contentcompliance) of uitvoerformaten kunnen valideren (voor kwaliteitsborging).
In een AI Gateway (zoals die van TrueFoundry) worden guardrails op twee punten toegepast: voordat een verzoek naar een LLM wordt gestuurd (input guardrails) en nadat een antwoord is geretourneerd (output guardrails). Door beide uiteinden van de LLM-interactie te onderscheppen, zorgen guardrails ervoor dat elke prompt en elk antwoord voldoet aan de bedrijfsregels.
Voorbeelden van AI Guardrails in de praktijk:
Kortom, AI guardrails zijn de technische handhaving van AI governance-beleid, die ervoor zorgen dat "elk verzoek en elk antwoord voldoet aan de normen van de organisatie voor beveiliging, kwaliteit en compliance".
Belangrijkste metrieken voor het evalueren van een Gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latency | Voegt <10ms p95 overhead toe voor time-to-first-token? | Must Have | ✅ Ondersteund |
| Data Residency | Bewaart logs binnen uw regio (EU/US)? | Afhankelijk van use case | ✅ Ondersteund |
| Latency-Based Routing | Routet automatisch om op basis van realtime latency/storingen? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |
| Key Rotation & Revocation | Sleutels roteren of intrekken zonder downtime? | Must Have | ✅ Ondersteund |

TrueFoundry’s AI Gateway dwingt guardrails af op zowel de invoer als de uitvoer van elke LLM-call. Input guardrails worden uitgevoerd voordat een prompt het model bereikt en voeren taken uit zoals het maskeren van persoonlijke gegevens of het filteren van verboden inhoud. Output guardrails worden uitgevoerd nadat het model reageert en controleren op onveilige of niet-toegestane inhoud (en corrigeren deze optioneel).
Elke guardrail-regel kan in twee modi werken: validate (blokkeren) of mutate (wijzigen). In de validate-modus zorgt elke gedetecteerde schending ervoor dat het verzoek of het antwoord wordt geblokkeerd met een foutmelding, waardoor compliance strikt wordt gehandhaafd. In de mutate-modus past de guardrail de inhoud automatisch aan om het probleem te verwijderen of te transformeren (bijvoorbeeld door een telefoonnummer te redigeren of een verboden woord te vervangen). Deze tweefasen- (invoer/uitvoer) en tweemodi-aanpak (validate/mutate) zorgt ervoor dat er geen gevoelige of niet-compliant gegevens door het systeem glippen.
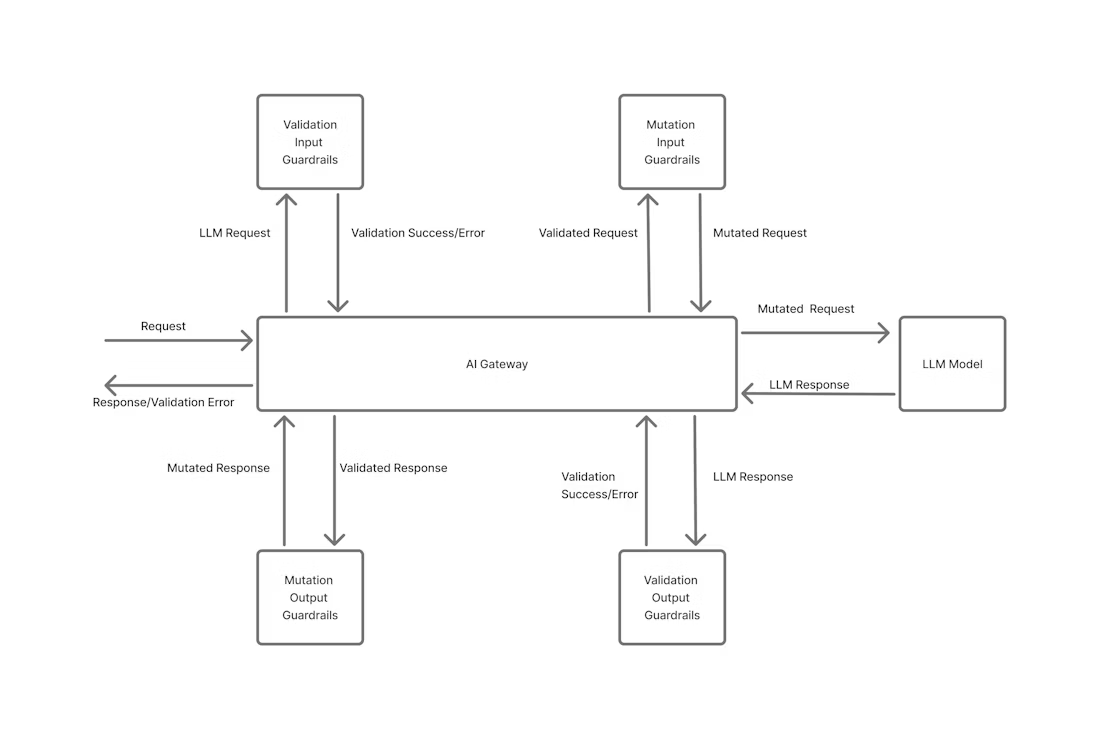
Het bovenstaande diagram illustreert hoe elk bericht door de invoerfilters gaat voordat het het model bereikt, en door uitvoerfilters nadat het antwoord is gegenereerd, wat een veiligheidsnet biedt aan beide zijden van de AI-interactie.
TrueFoundry’s AI Gateway biedt een uniforme beheerslaag waarin ondernemingen guardrails kunnen definiëren, integreren en beheren over alle LLM-interacties heen—zonder de applicatielogica te wijzigen. Guardrails kunnen declaratief worden geconfigureerd via YAML, API's of de TrueFoundry Console, waardoor teams een consistent beleid kunnen toepassen op meerdere AI-providers (zoals OpenAI, Anthropic of Azure OpenAI).
Op een hoog niveau worden guardrails geïntegreerd op de Gateway-laag, waar ze het verkeer tussen applicaties en de onderliggende LLMs onderscheppen.
Deze architectuur waarborgt AI safety en compliance met behoud van een lage latency door geparalleliseerde uitvoering en caching van guardrail-resultaten.
Ontwikkelaars en platformteams kunnen guardrails op verschillende niveaus configureren:
Global Guardrails: Organisatiebreed beleid dat van toepassing is op alle modellen en endpoints (bijv. PII-redactie of niet-toegestane onderwerpen).
Model-Level Guardrails: Specifieke configuraties per LLM-provider (bijvoorbeeld het gebruik van Azure PII-detectie met GPT-4 maar OpenAI Moderation voor Claude).
Route-Level Guardrails: Fijnmazige controle op API-routes—waardoor verschillende endpoints verschillende validatie- of complianceregels kunnen afdwingen.
Een eenvoudig configuratievoorbeeld ziet er als volgt uit:
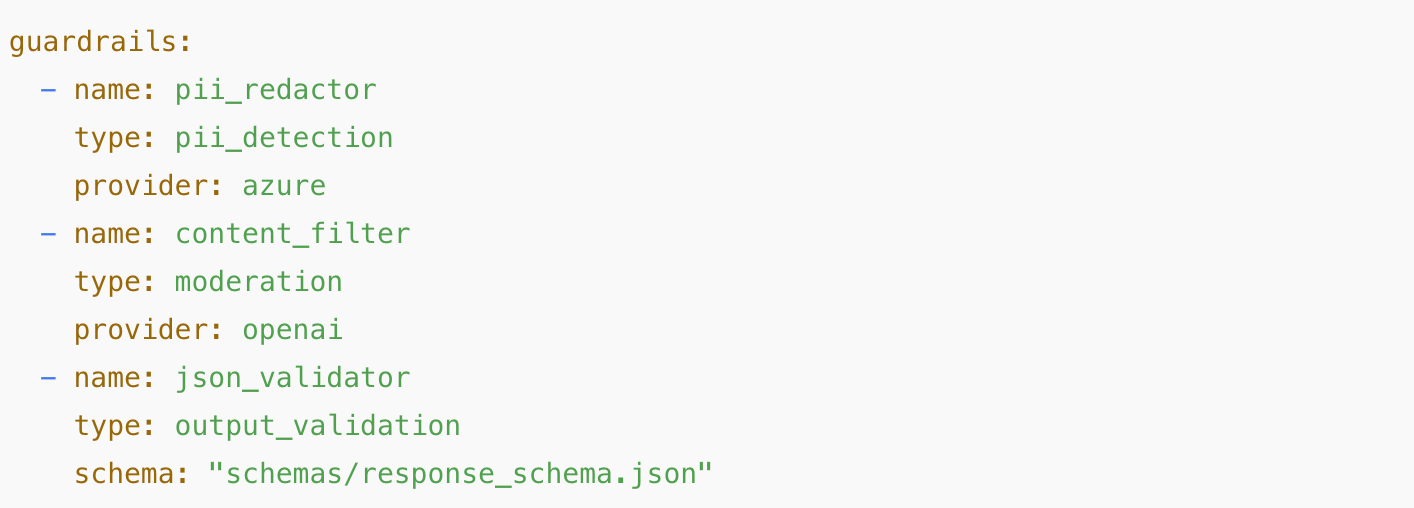
Met TrueFoundry’s AI Gateway kunnen organisaties guardrails integreren als een inheems onderdeel van hun AI-infrastructuur, wat zorgt voor robuuste AI safety, databescherming en afstemming op regelgeving—dit alles met behoud van hoge prestaties en flexibiliteit.
Zonder guardrails worden enterprise LLM-implementaties geconfronteerd met ernstige risico's. Generatieve AI-modellen kunnen onvoorspelbare of onveilige uitvoer produceren die organisaties blootstelt aan juridische, reputatie- en operationele schade. Een ongefilterde AI-chatbot kan bijvoorbeeld onbedoeld persoonlijke gebruikersinformatie onthullen of grof taalgebruik of bevooroordeelde taal gebruiken, wat het vertrouwen van de klant aantast en mogelijk regelgeving zoals GDPR of HIPAA schendt. In gevoelige domeinen (bijv. gezondheidszorg of financiën) kan zelfs een enkel gehallucineerd antwoord desastreuze gevolgen hebben. Het ontbreken van realtime controles betekent ook dat problemen pas na implementatie worden opgemerkt – bijvoorbeeld door ontevreden gebruikers of auditbeoordelingen – wat veel kostbaarder is dan ze vroegtijdig opvangen.
In de praktijk leidt de afwezigheid van guardrails tot beveiligingslekken (datalekken), schendingen van de compliance (illegaal advies of desinformatie), merkschade (aanstootgevende of inconsequente antwoorden) en onvoorspelbaar gedrag van de applicatie. Kortom, zonder guardrails om AI safety en compliance af te dwingen, lopen ondernemingen het risico op kostbare fouten en verlies van controle over hun AI-systemen.
Effectieve AI guardrails combineren verschillende technische elementen om verschillende risicogebieden te dekken. Een robuust systeem omvat doorgaans:
(1) Rule Engine – een geordende set beleidsregels die matchen op gebruiker, model of context, waarbij ervoor wordt gezorgd dat alleen de eerste toepasbare regel wordt geactiveerd
(2) PII & Datafilters – ingebouwde of externe detectoren die persoonlijke en gevoelige informatie (e-mails, BSN's, creditcards, enz.) herkennen en redigeren in zowel invoer als uitvoer
(3) Content Classifiers – semantische filters die controleren op niet-toegestane onderwerpen (medisch advies, haatzaaiende taal, grof taalgebruik, enz.) of hallucinaties vergelijken met een risicotaxonomie
(4) Aangepaste Keyword Filters – bedrijfsspecifieke blokkeerlijsten van woorden of zinsdelen die specifieke termen in realtime kunnen transformeren of blokkeren, en
(5) Transformatie-acties – de mogelijkheid om inhoud af te keuren (validate) of automatisch te saneren (mutate) op basis van het beleid.
In TrueFoundry’s platform zijn deze onderdelen geïmplementeerd als “guardrail-integraties” (bijvoorbeeld een koppeling met de moderatie-API van OpenAI) die de Gateway indien nodig aanroept. Elke keer dat een regel wordt toegepast, logt het systeem de gebeurtenis (wat is gecontroleerd en hoe het is afgehandeld) voor auditing en analyse. Gecombineerd vormen deze functies een uitgebreid veiligheidskader: invoer wordt vooraf opgeschoond voordat deze de LLM bereikt, en uitvoer wordt gecontroleerd voordat deze de gebruiker bereikt. In de termen van McKinsey bevat een effectief guardrail-systeem "checkers" om problemen te signaleren en "correctors" om ze op te lossen – precies de rol die wordt gespeeld door TrueFoundry’s invoer-/uitvoerfilters en transformatielogica.
Het is belangrijk om onderscheid te maken tussen guardrails en governance. AI governance verwijst naar de kaders, het beleid, de rollen en de toezichtsprocedures op hoog niveau die definiëren wat acceptabel is en waarom – bijvoorbeeld het privacybeleid of de AI-ethiekrichtlijnen van een onderneming. Governance zorgt ervoor dat AI-initiatieven duidelijke verantwoordelijkheid hebben en in lijn zijn met juridische en ethische normen. Guardrails daarentegen zijn de technische handhavingsmechanismen die dat beleid in realtime toepassen op elk AI-verzoek. Met andere woorden, governance bepaalt de verkeersregels, en guardrails zijn de vangrails en sensoren die voorkomen dat het AI-voertuig van de weg raakt. Governance hebben zonder guardrails betekent dat het beleid alleen op papier bestaat; guardrails hebben zonder governance betekent dat er geen duidelijke richtlijnen zijn over wat er gehandhaafd moet worden. In de praktijk maakt effectief AI-risicobeheer gebruik van beide: strategische governance definieert de doelen (bijv. "onthul nooit PII", "geen medisch advies"), en guardrails (in de AI Gateway) dwingen die regels automatisch af bij elke LLM-interactie. Zoals een analist opmerkt, hebben organisaties zowel AI governance als technische guardrails nodig die samenwerken om AI veilig te schalen.
TrueFoundry’s AI Gateway maakt het praktisch om guardrails binnen een organisatie uit te rollen. Doorgaans beginnen beheerders met het maken van een Guardrails Group in de Gateway UI – een container met gedefinieerde beheerders en gebruikers – om beleidsintegraties te bevatten. Binnen die groep voegen ze specifieke guardrail-integraties toe (bijvoorbeeld OpenAI’s Moderation API voor contentfiltering) door het configuratieformulier van de provider in te vullen.
Zodra de integraties zijn gedefinieerd, kunnen teams ze onmiddellijk testen met TrueFoundry’s Playground. Men kan bijvoorbeeld een input guardrail toepassen en een onveilige prompt indienen; de Playground laat zien dat de guardrail de inhoud blokkeert of saneert zoals verwacht.
In productiecode kunnen ontwikkelaars guardrails per verzoek afdwingen door de X-TFY-GUARDRAILS header toe te voegen met de gekozen regelset. Hiermee kunnen applicaties dynamisch opstellen welke filters per aanroep moeten worden toegepast.

Voor organisatiebreed beleid ondersteunt TrueFoundry guardrail-configuraties op gateway-niveau: een beheerder maakt een YAML-configuratie in het tabblad Config van de AI Gateway, waarin regels worden gespecificeerd met when-voorwaarden en de toe te passen input_guardrails en output_guardrails worden vermeld. Per verzoek wordt alleen de eerste matchende regel gebruikt.
Het definiëren van guardrails op gateway-niveau is het beste voor organisatiebrede handhaving, zodat elk AI-verzoek automatisch wordt gecontroleerd volgens de compliancenormen van het bedrijf. Op deze manier centraliseert de AI Gateway het guardrail-beheer en de auditing, waardoor het niet meer nodig is om elke applicatie afzonderlijk te instrumenteren.
Het landschap van guardrails ontwikkelt zich snel, hand in hand met AI-mogelijkheden en -regelgeving. Onderzoekers pleiten voor guardrail-architecturen met meerdere lagen: zo zou een primaire invoer/uitvoer-"poortwachterslaag" aangevuld kunnen worden met een kennis-onderbouwingslaag die retrieval-augmented controles gebruikt om de feitelijke nauwkeurigheid te verifiëren. Organisaties experimenteren ook met intelligente guardrails – waarbij AI-agents worden ingezet om modeluitvoer continu in realtime te monitoren en te corrigeren. Op het gebied van tooling ontstaat een groeiend ecosysteem van opensource-frameworks. NVIDIA’s NeMo Guardrails toolkit, LangChain’s Guardrails bibliotheek en andere bieden programmeerbare rule engines voor LLMs. Cloudproviders bieden eveneens ingebouwde moderatie- en veiligheidsfilters voor hun AI-diensten. Strenge regelgeving (zoals de voorgestelde EU AI Act) zal ondertussen de vraag stimuleren naar turnkey guardrail-oplossingen die realtime LLM compliance kunnen aantonen. Over het algemeen kunnen we verwachten dat guardrails nog meer geïntegreerd raken in de AI-ontwikkelingslevenscyclus – met geavanceerde NLP-detectoren, contextbewust beleid en verifieerbare auditlogs – om enterprise AI-implementaties zowel krachtig als veilig te houden.
AI guardrails zijn essentieel om geavanceerde LLMs te veranderen van onvoorspelbare experimenten in betrouwbare, compliant enterprise-tools. Door elk AI-verzoek in te sluiten tussen invoer- en uitvoercontroles, stelt TrueFoundry’s AI Gateway organisaties in staat om gegevensprivacy, contentnormen en regelgeving automatisch af te dwingen. De sleutel is het combineren van flexibele, beleidsgestuurde filters (voor PII-maskering, onderwerpsmoderatie, enz.) met realtime handhaving (validate- of mutate-acties) en grondige logging. Voor CTO's en AI-architecten betekent het inbouwen van guardrails dat het potentieel van generatieve AI kan worden benut zonder dat dit ten koste gaat van vertrouwen of veiligheid. In een enterprise-context vormen robuuste guardrails op gateway-niveau de ruggengraat van verantwoorde AI – ze stellen bedrijven in staat met vertrouwen te innoveren met LLMs, wetende dat elk antwoord is getoetst aan hun regels voor beveiliging, kwaliteit en compliance.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















