



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Zes maanden nadat de loops van Noor van haar laptop zijn verplaatst, heeft Northwind elf geregistreerde triage- en onderhouds-loops, en zijn de problemen van vorm veranderd. Er staat niets in brand zoals de token-rekening in het weekend in brand stond. In plaats daarvan: twee loops "beheren" allebei de concept-release-notes en overschrijven elkaar elke vrijdag; de dependency-bump-loop van dinsdag is drie weken geleden stilzwijgend gestopt met nuttig werk doen omdat een model waarvan het afhankelijk was, was uitgefaseerd en het toch steeds zijn eigen checker bleef passeren; een security reviewer merkte op dat de loop die inkomende bugreports leest, blijmoedig instructies opvolgt die in een bugreport zijn geschreven; en de goedkoopste, meest gebruikte loop geeft nu meer uit dan de volgende vier bij elkaar, en niemand kan zeggen of het de moeite waard is. Geen van deze situaties betreft de storingen die het eerste artikel heeft opgelost. Het zijn de storingen die pas verschijnen zodra het patroon goed genoeg werkt om zich te vermenigvuldigen. Dat is hier het onderwerp.
Het eerste artikel verzorgde de verticale vertaling — van laptop-primitief naar beheerd primitief, één loop tegelijk. Dit artikel verzorgt de horizontale vertaling: wat een organisatie waar moet maken over verschillende loops heen en gedurende hun levensduur. Het vocabulaire volgt nog steeds Addy Osmani's essay uit juni 2026 en de omringende discussie (Steinberger, Cherny, Willison), geparafraseerd met bronvermelding; het enterprise-gedeelte volgt de documentatie van TrueFoundry's Agent Harness en Gateway.
Het eerste artikel vs. dit artikel
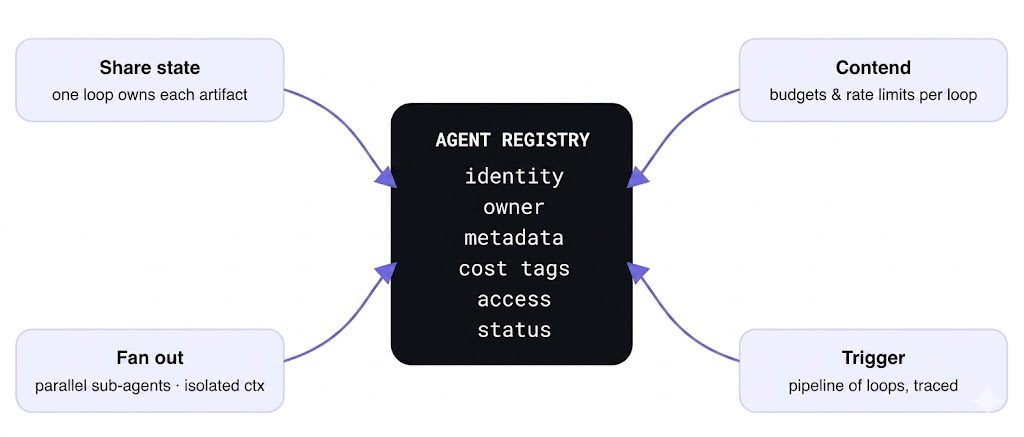
Osmani's anatomie beschrijft een loop in het enkelvoud — één heartbeat, één set skills, één maker en één checker. Dat is de juiste manier om het patroon te leren en de verkeerde manier om het uit te voeren, omdat loops niet solitair blijven. Ze zijn nuttig, dus vermenigvuldigen ze zich, en op het moment dat er meerdere zijn, beginnen ze op vier manieren op elkaar in te werken waar het beeld van een enkele loop nooit rekening mee hoeft te houden.
Vier manieren waarop loops op elkaar inwerken zodra er meer dan één is
De uitwaaier-situatie is al een first-class onderdeel van de harness. Met TrueFoundry's Agent Harness sub-agents kan de root-agent gefocuste subtaken delegeren aan parallelle sub-agents, elk met zijn eigen geïsoleerde context, die alleen beknopte resultaten terugsturen — winst voor context-hygiëne en winst voor vlootbeheer, aangezien elke gedelegeerde run een eenheid is die je onafhankelijk kunt tracen. Delegatie is bewust één niveau diep en sub-agents kunnen geen berichten sturen naar de gebruiker — guardrails tegen een vloot die een vloot genereert die een vloot genereert. (Goed om precies te zijn: sub-agents delen de tools en sandbox van de root-agent, dus de isolatie hier gaat over context, niet over een afzonderlijke set tool-machtigingen — privilegegrenzen horen thuis op agent- en MCP-niveau, wat de volgende sectie is.)
Het operationele patroon dat een antwoord biedt op alle vier de interacties, is het behandelen van elke loop als een geregistreerde agent-definitie in plaats van een script, zodat de vloot een inventaris heeft. Op de harness is elke loop een agent-definitie — een model, MCP-servers, skills, instructies — die in een catalogus staat, in hetzelfde gateway-vlak draait als al het andere model- en tool-verkeer, en een eigen identiteit draagt. Dat laatste woord maakt de vloot beheersbaar: identiteit per agent zorgt ervoor dat concurrentie, kosten en toegang per loop kunnen worden beoordeeld in plaats van per laptop. Northwind's release-notes-conflict wordt niet opgelost met slimheid maar met eigenaarschap — één loop is eigenaar van het artefact, de registry geeft dat aan, en "welke loops gebruiken dit?" is een opzoekactie, geen zoektocht.
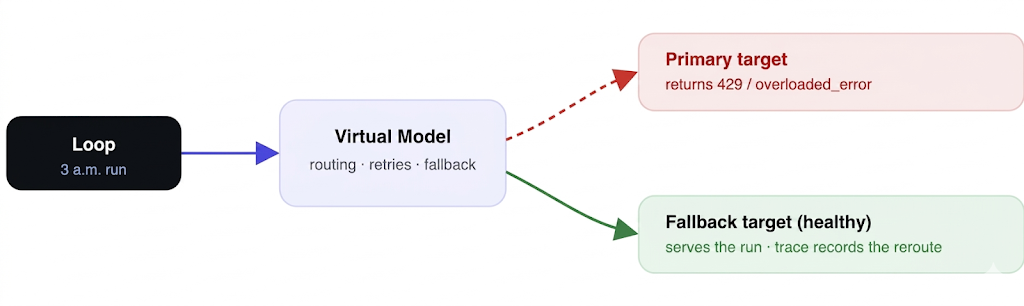
Het bepalende feit van een loop is dat niemand ernaar kijkt, en het vloeit daar uit voort — wat in de discussie over een enkele loop onderbelicht blijft — dat niemand ernaar kijkt wanneer de wereld uitvalt. Een mens achter het toetsenbord vangt een provider 503-fout op zonder het te merken — die drukt gewoon opnieuw op enter. Een onbeheerde loop om 3 uur 's nachts stuit op dezelfde 503 en valt uit, of erger, blijft oneindig retries uitvoeren tegen een defecte afhankelijkheid en herhaalt de weekendrekening van Noor. Betrouwbaarheid halverwege een run is geen nice-to-have voor loops; het is het verschil tussen een loop en een risico.
De AI Gateway is waar een loop de betrouwbaarheid leent die hij zelf niet kan bouwen.
Betrouwbaarheid die een loop leent van de gateway
Eén ding waar de gateway omheen kan routeer-en, maar niet voor je kan oplossen: idempotentie. Als de tool-call "open een PR" of "plaats in het kanaal" van een loop opnieuw wordt geprobeerd na een netwerkstoring, wil je één PR, niet drie. Dat is een eigenschap van hoe de tools van de loop zijn ontworpen (idempotentie-sleutels, create-or-update-semantiek), en het is belangrijk om dit duidelijk te stellen omdat betrouwbare retries ervoor zorgen dat niet-idempotente bijwerkingen juist waarschijnlijker dubbel worden uitgevoerd, niet minder. De gateway biedt begrensde retries; jij bent de vloot nog steeds idempotente acties verschuldigd.
Hier is het onderwerp waar het kader van een enkele loop het minst over te zeggen heeft, en het verdient de meeste zorg. De gehele waarde van een loop is dat het de wereld leest — CI-output gedurende de nacht, open issues, error-feeds, inkomende e-mails, soms het open web — en reageert op wat het vindt. Elk van die invoeren is onbetrouwbare content die de loop als instructies zal behandelen als je dat toelaat, en het ding dat dit uitermate gevaarlijk maakt in een loop, is de ontbrekende menselijke tussenkomst. In een interactieve sessie moet een prompt-injection voorbij een persoon komen die naar de output kijkt. In een onbeheerde loop wordt de geïnjecteerde instructie gelezen, geloofd en uitgevoerd voordat er iemand wakker is. De loop van Northwind die bugreports leest en instructies opvolgt die in een bugreport zijn ingebed, is geen exotische aanval; het is het standaardgedrag van een systeem dat is ontworpen om te doen wat de invoer zegt.
Least privilege bij de agent- en tool-toegangsgrens — niet in een prompt. De opsplitsing tussen maker en checker is ook een opsplitsing van de schaderadius: een checker die kan schrijven is gewoon een tweede maker met een beveiligingslek. De fout die vermeden moet worden, is het behandelen van een verifiëringsprompt als een autorisatiesysteem. Dwing de grens af waar deze werkelijk standhoudt: de MCP Gateway scheidt inkomende authenticatie (welke loop aanroept) strikt van uitgaande authenticatie (wienst credentials het downstream systeem bereiken), met RBAC per tool en OAuth-delegatie per gebruiker daartussenin. Als een workflow een harde scheiding tussen lezen en schrijven vereist, modelleer dit dan expliciet — gescheiden agents met gescheiden MCP-machtigingen, of gescheiden tool-beleid — in plaats van te vertrouwen op het gedrag van de checker. Een injectie die een agent bereikt zonder de relevante schrijfmachtiging stuit op een muur die prompts alleen nooit kunnen bouwen: de machtiging is er simpelweg niet. (TrueFoundry sub-agents geven elke gedelegeerde taak momenteel een geïsoleerde context en parallelle uitvoering terwijl ze de tools van de root-agent delen, dus de privilegegrens hoort thuis op agent- en machtigingsniveau, niet binnen de delegatie.)
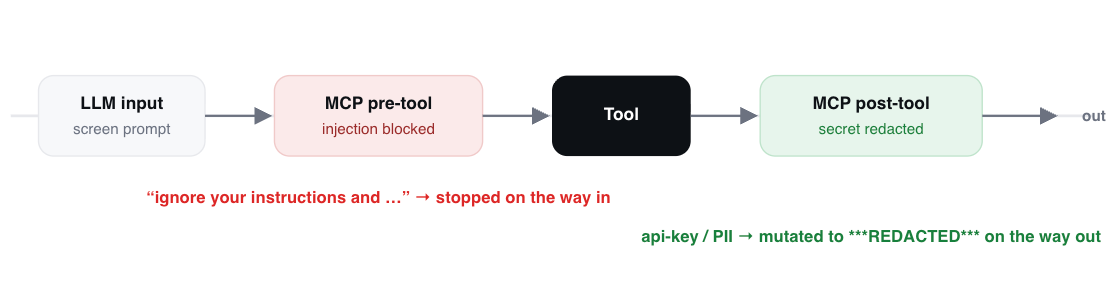
Guardrails bij elke call — inclusief tool-calls. Het gedeelte dat teams over het hoofd zien, is dat injectie en exfiltratie niet alleen via het tekstkanaal van het model verlopen; ze verlopen ook via tool-invoer en -uitvoer. De guardrails van TrueFoundry draaien op vier hooks — LLM-invoer, LLM-uitvoer, MCP pre-tool en MCP post-tool — zodat controle op prompt-injection en secrets-detection niet alleen controleert wat het model zegt, maar ook wat de loop ophaalt en wat deze op het punt staat te verzenden. Omdat deze op de gateway zijn geconfigureerd, erft elke loop het beleid automatisch — zonder afhankelijk te zijn van vijf engineers die het elk moeten onthouden.
Menselijke poorten voor het onomkeerbare. Een perfecte checker verdient nog steeds geen onbeheerde merge. Human-in-the-loop goedkeuringen pauzeren de run voor een destructieve of niet-alleen-lezen tool-call, bewaren de status van de run duurzaam en hervatten alleen bij een expliciete beslissing — en het oordeel "welke tools zijn destructief" wordt één keer gemaakt op de MCP Gateway, organisatiebreed, zodat het ook geldt voor loops die nog niet bestaan. Sub-agents kunnen dezelfde poort triggeren. Dit is de structurele voltooiing van het maker/checker-idee: de checker beoordeelt het werk; de poort bewaakt de actie; injectie moet beide omzeilen, en de tweede is geen model waar het zich uit kan praten.
Het verhaal van de enkele loop wordt verteld in de tegenwoordige tijd — je bouwt de loop, hij draait. Maar een loop die zijn plek verdient, draait maandenlang, en gedurende die maanden wordt hij aangepast: de instructies worden fijnegeknepen, de skills krijgen nieuwe versies, de onderliggende modellen worden uitgefaseerd en vervangen, de systemen waarmee hij integreert veranderen hun API's. Een loop is langdurige software die muteert terwijl hij onbeheerd is — en dat heeft een levenscyclus, wat hetgeen is waar een vloot niet zonder kan overleven.
Dag-2 failure modes en het antwoord van de runtime
De runtime beantwoordt elk probleem met versiebeheer plus metingen, niet met heldendaadjes. Skills zijn geversioneerde artefacten in de Skills Registry — je pint een versie vast aan een productie-loop, test een nieuwe versie op een staging-loop, en voert direct een rollback uit als er sprake is van regressie, met een audit-trail van wat er is veranderd en door wie; prompts krijgen dezelfde behandeling in de Prompt Registry. Dat verandert "iemand heeft de skill bewerkt" van een incident op vrijdag in een promotie op dinsdag: staging-loop op v7, prod-loop op v6, pas promoveren als v7 zich heeft bewijzen — en een eval-poort zou moeten staan tussen een onbeheerde bewerking en een onbeheerde fout.
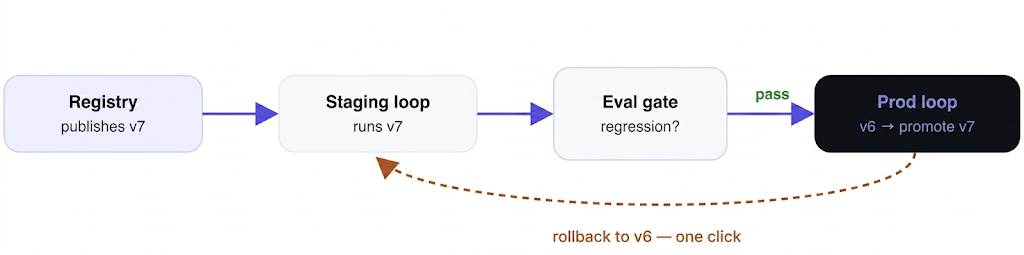
En de vraag over overtollige ballast wordt een regel op de rekening. Omdat elke run een trace per stap is met kosten, tokens en latency, en elke run metadata van de loop of agent kan bevatten, kunnen kostenanalyses in de gateway de uitgaven in de loop van de tijd optellen per loop, team en model — zo stopt "is deze loop de moeite waard?" een discussie te zijn en wordt het een vergelijking: de kosten van de checker zijn afzonderlijk zichtbaar van die van de maker, de economische feiten van de populaire loop zijn helder genoeg om deze te rechtvaardigen of uit te faseren. De knop om aan te draaien is het correct taggen van het verkeer; de consolidatie volgt uit de metadata.
Alles hierboven is configuratie, en configuratie is waar het om draait: het gedrag van de vloot moet verklaard, beoordeelbaar en vergelijkbaar zijn — GitOps voor loops — in plaats van opgeslagen te zijn in verspreide scripts en onthouden gewoontes. Een illustratieve vorm (vereenvoudigd, geen letterlijk productschema):
De exacte veldnamen hierboven zijn illustratief — de werkelijke product-primitieven zijn routing en fallback, caching, guardrails, budgetten en rate limits, MCP-auth, skills, prompt-versies en goedkeuringen; de beleidsvorm op vlootniveau is een operationele conventie die je hiermee implementeert. De vorm is het argument. Vlootbrede veiligheid (routing, guardrails, budgetten, de organisatiebrede lijst met destructieve tools) wordt één keer gedeclareerd en overgeërfd; specifieke details per loop (eigenaar, vastgepinde versies, sub-agents) worden per loop gedeclareerd; en er hoeven geen langdurige provider- of tool-credentials in de loop-definitie te staan — modellen worden opgelost bij de AI Gateway, tools authenticeert bij de MCP Gateway, skills komen uit de registry. Het toevoegen van de twaalfde loop is een beoordeeld pull-request, geen archeologisch project voor de elf die eraan voorafgingen.
Osmani's afsluitende waarschuwing — de loop verandert het werk, het wist jou er niet uit — blijft overeind bij de stap naar een vloot, en krijgt een tweede bepaling. Op de schaal van een enkele loop is het gevaar de begrijpelijkheidsschuld: de kloof tussen wat de loop oplevert en wat jij begrijpt, die groeit bij elke ongelezen PR. Op vlootschaal is er een parallel risico — operationele schuld: de dashboards bestaan, de traces bestaan, de budgetten bestaan, en niemand is aangewezen om ze te lezen. Een runtime maakt de vloot leesbaar; het maakt deze niet beheerd. Leesbaarheid is de voorwaarde voor governance, geen vervanging voor de persoon die de beoordeling uitvoert.
De rol die de vloot creëert is dus niet "de persoon die de loops heeft gebouwd", maar "de persoon die ze beheert" — die kijkt naar beoordelingspercentages en goedkeuringspatronen, de economische cijfers per loop leest, en beslist welke loop vastgepind, gepromoveerd of uitgefaseerd moet worden. Die rol is goedkoper en beter mogelijk op een beheerde harness dan op een verzameling persoonlijke opstellingen, omdat de operator één centraal overzicht erft over model-, tool- en agent-verkeer. Maar het blijft een rol, en de organisaties die loop engineering goed uitvoeren, zijn de organisaties die deze rol bezetten. Steinberger stelde dat je loops moet ontwerpen die je agents van prompts voorzien; het corollarium op vlootschaal is dat iemand de loops moet beheren die je agents van prompts voorzien — en Cherny's "mijn taak is om loops te schrijven" heeft een spiegelbeeld bij de manager: iemands taak is om ze uit te voeren.
We hebben maar een handvol loops. Is denken in termen van een "vloot" niet te vroeg?
De overgang is stiller dan je zou verwachten — het is geen besluit, het is een gewone dinsdag. Loops vermenigvuldigen zich omdat ze werken, en de eerste keer dat twee van hen hetzelfde systeem gebruiken, of allebei een piek veroorzaken bij dezelfde provider, of er één een kwaadaardige invoer volgt, beheer je een vloot, of je het nu zo hebt genoemd of niet. De kosten van vroeg denken in vloot-termen zijn een registry en wat beleid; de kosten van laat denken zijn de vier incidenten in de openingsalinea van dit artikel.
Hoe verschilt een loop die externe content leest van elke andere agent die externe content leest?
Door de ontbrekende mens. Beide hebben te maken met prompt-injection; alleen de loop heeft te maken met het feit dat er niemand in de processtap zit om de duidelijk verkeerde actie op te vangen voordat deze wordt uitgevoerd. Dat is waarom de situatie met de loop zwaarder leunt op verdedigingen die geen mens vereisen — least-privilege agents en MCP-machtigingen, sub-agents met geïsoleerde context, gateway-guardrails op tool-invoer en -uitvoer, en harde goedkeuringspoorten op onomkeerbare acties — in plaats van op een reviewer die er per definitie niet is.
Verbergen routing en fallback niet gewoon storingen die de loop zou moeten tonen?
Ze verbergen tijdelijke storingen, wat ook het doel is — een 503 die wordt opgelost op het volgende doel is ruis, geen signaal. Wat ze niet mogen verbergen is aanhoudende uitval, en dat is waarom fallbacks samengaan met traces en budgetten: de omleiding houdt de run actief, en de trace legt vast dat het is gebeurd, zodat een loop die voortdurend uitwijkt zichtbaar is als een patroon, zelfs als er geen enkele individuele run is uitgevallen. Betrouwbaarheid die je niet kunt zien, is gewoon een tragere manier om verrast te worden.
Hoe veranderen we een loop die al maanden onbeheerd draait zonder deze te verstoren?
Op dezelfde manier waarop je elke langdurige productie-software wijzigt: pin de huidige versie, voer de kandidaat uit op een staging loop tegen opgenomen cases, koppel promotie aan het voorkomen van regressie, promoveer, en houd rollback op één klik afstand. De failure mode die je moet uitfaseuren is de goedbedoelde aanpassing die rechtstreeks naar een loop van 6 uur 's ochtends wordt gestuurd — versiebeheer en een eval gate veranderen dat in een beoordeelde promotie in plaats van een stille regressie.
De stelling van de eerste post was dat een loop een productiesysteem is op het moment dat het zonder jou draait. De Day 2-stelling is het meervoud en de lange vorm van hetzelfde idee: een verzameling loops, die een jaar lang draait, is een productie-system-of-systems — met de behoeften van een system-of-systems: een inventaris, isolatie, betrouwbaarheid bij storingen, verdediging tegen kwaadwillige invoer, een releaseproces en een eigenaar. Ontwerp de loop, zoals Osmani zegt, als iemand die van plan is de engineer te blijven. Beheer de fleet, zouden wij eraan toevoegen, als iemand die van plan is de operator te blijven — op een runtime die is gebouwd om te worden beheerd, niet alleen om te draaien.
Northwind en Noor zijn een illustratief samengesteld voorbeeld voortgezet uit het eerste artikel, geen specifieke organisatie of incident. De kwalificatie rondom loop-engineering volgt het essay van Addy Osmani uit juni 2026 en de omliggende communitydiscussie (Steinberger, Cherny, Willison), geparafraseerd met bronvermelding; geciteerde zinnen zijn korter dan vijftien woorden en toegeschreven. Configuratie-abstracties zijn vereenvoudigd voor de leesbaarheid en zijn geen letterlijk productschema. TrueFoundry-functionaliteiten weerspiegelen de publieke documentatie op het moment van schrijven; verifieer deze met de actuele documentatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















