November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Directe modelvergelijkingen stellen meestal de verkeerde vraag. "Terra of Flash?" suggereert dat je er met één moet trouwen. Maar GPT-6.1 Terra en Gemini 3.6 Flash bevinden zich op dezelfde trede van de ladder: mid-tier, grote context, sterke (maar geen flagship) codingmodellen waarvan de prijzen dicht bij elkaar liggen. Wanneer twee modellen zo dicht bij elkaar liggen en zo uitwisselbaar zijn, is het een dure fout om er één te kiezen en die hard te coderen. De goedkope, veerkrachtige aanpak is om tussen beide te routen, elk model te gebruiken waar het beter of goedkoper is, en terug te vallen op de ander wanneer een provider een storing heeft.
Dit artikel vergelijkt de twee op de dimensies die er toe doen (prijs, context, coding, snelheid) — allemaal gerapporteerd en onder voorbehoud — en maakt vervolgens het echte argument: behandel ze als uitwisselbare doelen in een routingpolicy, met een flagship-model boven hen voor het zware werk.
Nauwkeurigheidsopmerking: afgezien van de Claude-cijfers die ter referentie zijn gebruikt, is elke onderstaande specificatie afkomstig uit rapporten van derden van november 2026, en sommige bronnen spreken elkaar tegen. Controleer dit met de officiële pagina's van OpenAI en Google voordat je op deze cijfers bouwt.
Wil je routen tussen mid-tier modellen op basis van taak en prijs, met automatische fallback? Boek een demo.
GPT-6.1 Terra is naar verluidt rond 26 oktober 2026 uitgebracht als het mid-tier model van OpenAI's GPT-6.1-lijn. Gerapporteerd profiel: $1 per 1M input-tokens, $5 per 1M output-tokens, een context window van ongeveer 1,05M en een Coding Index rond de 48. Het opvallendste kenmerk is de prijs: met een gerapporteerde $1 / $5 komt het uit op ongeveer de helft van de kosten per token van GPT-6.1 Sol (gerapporteerd $2 / $10), terwijl het naar verluidt een groot deel van Sol's codingcapaciteiten behoudt.
Gemini 3.6 Flash is naar verluidt rond juli 2026 uitgebracht als Google's op snelheid geoptimaliseerde mid-tier model. Gerapporteerd profiel: $1.50 per 1M input-tokens, $7.50 per 1M output-tokens, een context window van 1M, een throughput van bijna 280 tokens per seconde, een Intelligence Index rond de 50 en SWE-Bench Pro rond de 58,7%. Het opvallendste kenmerk is de combinatie van coding en snelheid voor een mid-tier prijs.

Prijzen/benchmarks zoals gerapporteerd in november 2026; controleer dit met de officiële prijzen van elke provider voordat je er op vertrouwt — modelspecificaties wijzigen regelmatig. Claude-cijfers, waar elders vermeld, zijn de enige door de leverancier bevestigde getallen.
Een paar eerlijke kanttekeningen bij het lezen van deze tabel:
De conclusie waar de tabel naar toewerkt is niet "Terra wint" of "Flash wint". Het is dat deze twee dicht genoeg bij elkaar liggen om elkaars vervangers te zijn, en vervangers zijn precies waartussen je wilt routen.
Wanneer twee modellen uitwisselbaar zijn, levert vastleggen op één model je niets op en kost het je twee dingen: je verliest de mogelijkheid om het best passende model per taak te gebruiken, en je neemt het risico op een outage van één enkele provider. Routing tussen de twee lost beide problemen op.
Terra's lagere gerapporteerde prijs maakt het de standaard voor output-intensief, kostengevoelig verkeer: bulkgeneratie, lange chat, dagelijkse coding in hoge volumes. Flash's gerapporteerde voorsprong in coding en snelheid maakt het het voeurskeurstarget voor coding-intensieve requests of latentiegevoelige paden waar ~280 tokens/sec van belang is. Je hoeft niet globaal te kiezen; je kiest per taakklasse. Dit is kosten- en kwaliteitsbewuste modelselectie, en het mechanisme erachter is een LLM router.
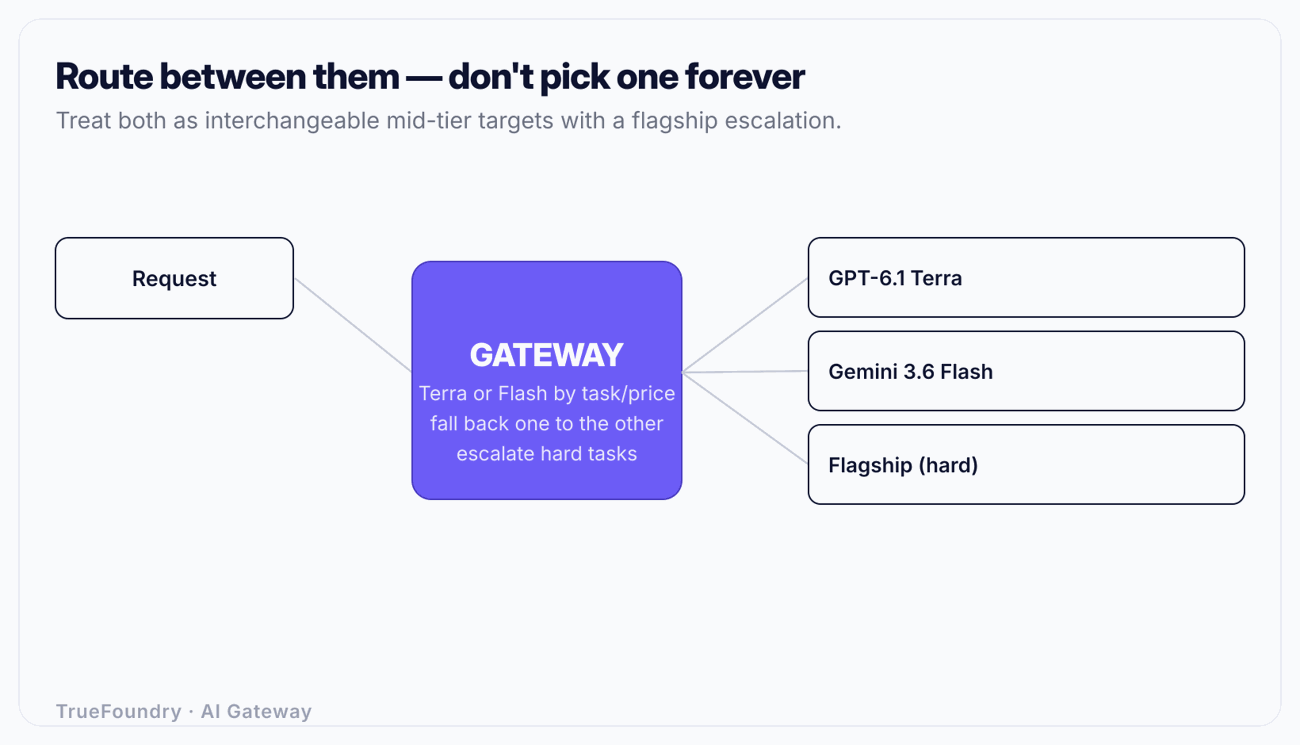
Omdat ze uitwisselbaar zijn, is elk model een natuurlijke fallback voor de ander. Configureer Terra als primair met Flash als fallback (of andersom) en een providerfout, timeout of rate-limit op de een wordt opgevangen door de ander. De gebruiker ziet een iets tragere respons, geen foutmelding. Dit is de kernwaarde van LLM fallback: twee uitwisselbare mid-tier modellen geven je provider-redundantie vrijwel gratis, omdat je toch al van plan was een van beide te draaien.
Geen van beide is een flagship. Voor langdurige agentic coding of diepgaande redeneringen moeten beide escaleren naar een flagship-tier (Claude Opus 5.5 is een bevestigde sterke standaard; GPT-6.1 Sol en Gemini 3.1 Pro zijn gerapporteerde gelijken). Het mid-tier duo verwerkt de massa; het flagship vangt de complexe gevallen op. De poortwachter is een routingregel.
Ontdek hoe TrueFoundry uitwisselbare modellen behandelt als één routingpolicy. Boek een demo.
Prijzen/benchmarks zoals gerapporteerd in november 2026; controleer dit met de officiële prijzen van elke provider voordat je er op vertrouwt — modelspecificaties wijzigen regelmatig.
Merk op dat de meeste rijen de twee modellen koppelen als primair en fallback, in plaats van er exclusief één te kiezen. Dat is het ontwerpdoel: je kiest geen winnaar, je wijst rollen toe die kunnen wisselen.
De bovenstaande policy is alleen nuttig als het goedkoop is om uit te drukken en goedkoop om te wijzigen. Een AI gateway met een universele, OpenAI-compatibele API biedt dat. Je applicatie aanroept een stabiele alias; de gateway beslist of de request op Terra, op Flash of op een flagship belandt, en wat er moet gebeuren bij een fout.
Omdat beide modellen gealiaseerd zijn, is de komst van GPT-6.2 of Gemini 3.7, of een prijsverlaging op een van beide, een simpele configuratiewijziging. Je routingpolicy past zich aan; je applicatie verandert niet.
Neem een developer-toolingproduct dat maandelijks 4M mid-tier coding requests verwerkt, output-intensief met ongeveer 600 input- en 1.500 output-tokens per request (codegeneratie produceert veel tokens).
Output domineert hier, dus de outputprijs is de bepalende factor. Bij Terra's gerapporteerde $5 / 1M output kosten 1.500 output-tokens per request ongeveer $0,0075 per request aan output. Bij Flash's gerapporteerde $7.50 / 1M kost dezelfde request ongeveer $0,01125 aan output, ruwweg 50% meer. over 4M requests is dat verschil aanzienlijk.
Maar Flash codeert naar verluidt iets beter en draait sneller. De policy is dus niet "alles naar Terra". Het is: routeer het grootste deel van de routinegeneraties naar Terra voor het prijsvoordeel op output, routeer de moeilijkere of latentiegevoelige coding requests naar Flash, en val bij fouten op elkaar terug. Vervolgens monitor je de kosten per model en de kwaliteit per model in je observability-tooling en pas je de verdeling aan. Als Terra's kwaliteit standhoudt op jouw verkeer, gebruik je dat model meer; als Flash's coding-voorsprong blijkt uit minder retries, verandert de berekening. De enige manier om hierachter te komen is door te meten, daarom zijn routing en observability één systeem, niet twee.
Retries veranderen deze berekening op een manier die ruwe prijstabellen verbergen. Als Terra's output 33% goedkoper is, maar een verkeerd antwoord produceert dat 5% vaker een tweede aanroep vereist dan Flash, dan slokt dat retry-percentage een deel van het prijsvoordeel op, omdat een herhaalde request twee keer betaalt. Dit is waarom een platte prijsvergelijking misleidend is en waarom je de effectieve kosten per succesvolle respons moet meten, niet de kosten per aanroep. Een model dat nominaal goedkoper is maar meer retries nodig heeft, kan op echt verkeer duurder uitvallen. De enige manier om dit te zien is via observability per model die zowel kosten als foutpercentages op je eigen requests bijhoudt.
Om te voorkomen dat een escalatiepad ongemerkt te veel uitgeeft, begrens je de flagship-tier met token rate limiting en budgetten, zodat een doorgeslagen escalatie een HTTP 429 retourneert in plaats van een verrassingsfactuur.
GPT-6.1 Terra en Gemini 3.6 Flash vormen geen duel met een duidelijke winnaar. Het zijn twee uitwisselbare mid-tier werkpaarden, geprijsd binnen een derde van elkaar, beide met ~1M context, en elk met een klein gerapporteerd voordeel dat de ander mist: Terra op prijs, Flash op coding en snelheid. Wanneer modellen zo dicht bij elkaar liggen, is de vraag niet welke je moet kronen, maar hoe je ze beide gebruikt.
Routeer tussen beide op basis van taak en kosten, val op elkaar terug voor vrijwel gratis provider-redundantie, en escaleer alleen naar een flagship voor de echt complexe taken. Druk dit alles uit als policy bij een gateway achter één enkele OpenAI-compatibele API, en de volgende release of prijsverlaging van een van beide providers wordt een configuratiewijziging in plaats van een migratie. Dat is hoe je het beste van beide krijgt zonder je architectuur op één kaart in te zetten.
Routeer tussen Terra en Flash in plaats van er één te kiezen. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.




Volgens rapportages van november 2026 wel: Terra op $1/$5 tegenover Flash op $1,50/$7,50 per 1 miljoen tokens, ongeveer 33% goedkoper op zowel input als output. Of dit zich vertaalt naar een lagere factuur hangt af van uw tokenmix en van hoe vaak de kwaliteit van elk model een retry afdwingt. Verifieer beide prijzen bij de officiele pagina's van de providers en meet op uw eigen verkeer.
Gerapporteerde signalen geven Flash een licht voordeel (SWE-Bench Pro ~58,7%) en plaatsen de Coding Index van Terra rond 48, maar dit zijn verschillende benchmarks die niet direct vergelijkbaar zijn. Route in de praktijk codeerintensieve of complexe verzoeken naar Flash en hoogvolume routinematige generatie naar Terra, met elk als fallback voor de ander, en laat uw eigen evaluaties en retry-percentages de verdeling bepalen.
Nee, en dat zou u waarschijnlijk ook niet moeten doen. Het zijn onderling verwisselbare modellen uit het middensegment, dus de veerkrachtige opzet draait beide achter één gateway-API, routeert elk verzoek naar wat beter past of minder kost, en valt bij een fout op elkaar terug. 'Voor altijd één kiezen' is de dure optie.
Beide worden gerapporteerd rond 1 miljoen tokens (Terra ~1,05 miljoen, Flash 1 miljoen), dus context is in feite gelijk en zou voor de meeste workloads niet doorslaggevend moeten zijn voor uw keuze. Beslis in plaats daarvan op basis van prijs, geschiktheid voor coderen en latentie.
Escaleer voor agentic coding op lange termijn en diepgaand redeneren naar een vlaggenschipmodel: Claude Opus 5.5 is een bevestigde sterke standaardkeuze, met GPT-6.1 Sol en Gemini 3.1 Pro als gerapporteerde gelijken. Houd het middensegment-paar aan voor het grootste deel van het verkeer en poort het vlaggenschip zo af dat alleen lastige verzoeken het bereiken, zodat uw budget begrensd blijft.



Het laatste nieuws, artikelen en bronnen in je inbox