November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De meeste teams hebben geen vlaggenschip-probleem. Ze hebben een default-probleem. Het model dat de mediane request beantwoordt, degene die de long tail van chat, samenvatting, alledaagse coding en retrieval-augmented antwoorden afhandelt, is waar de rekening zich daadwerkelijk opstapelt, omdat daar het volume zit. Gemini 3.6 Flash is juist interessant omdat het gebouwd is voor die default-positie: capabel genoeg dat gebruikers geen downgrade merken ten opzichte van een vlaggenschip, goedkoop genoeg om er de volle laag op af te sturen.
Dit artikel behandelt wat Gemini 3.6 Flash is (zoals gerapporteerd in november 2026), waar het past tussen extreem goedkope kleine modellen en de vlaggenschepen, wanneer u hiervoor kiest en wanneer niet, en het gateway-patroon waarmee u dit uw default kunt maken terwijl u requests die daadwerkelijk meer nodig hebben nog steeds escaleert.
Vooraf één kanttekening over nauwkeurigheid: afgezien van de Claude-cijfers zijn de onderstaande specificaties afkomstig van rapportages door derden en bronnen die soms tegenstrijdig zijn. Beschouw ze als een uitgangspunt en controleer ze op de officiële model- en prijzenpagina's van Google voordat u erop bouwt. Modelspecificaties veranderen vaak.
Wilt u het meeste verkeer naar een Flash-klasse model routen en alleen de lastige requests escaleren? Boek een demo.
Gemini 3.6 Flash is naar verluidt rond juli 2026 uitgebracht als het op snelheid geoptimaliseerde middenklassemodel in de Gemini 3.x-lijn van Google. Het gerapporteerde profiel:
De samenvatting in één regel: een model dat u het grootste deel van het alledaagse nut van een vlaggenschip biedt, tegen een middenklasseprijs, met een context van vlaggenschipklasse en sterke doorvoer. Die combinatie is precies wat een default-model moet zijn.
Prijzen/benchmarks zoals gerapporteerd per november 2026; verifieer dit op de officiële prijzenpagina van elke provider voordat u erop vertrouwt — modelspecificaties veranderen vaak.
Als uw account of regio 3.6 Flash nog niet toont, is Gemini 3.5 Flash de veilige, algemeen beschikbare fallback. Beschouw 3.6 als het doel en 3.5 GA als de achtervanger totdat u 3.6 rechtstreeks hebt bevestigd.
De nuttige manier om over Flash te denken is als de middelste sport van een ladder met drie sporten. Daaronder bevindt zich het bodemprijsniveau. Daarboven staan de vlaggenschepen. Elke sport heeft een eigen taak.
Bodemprijsniveau (ongeveer $ 0,10–$ 0,25 input). Claude Haiku 5.5 is bevestigd vanaf $ 0,10 / $ 0,50. De gerapporteerde GPT-6 Luna staat op $ 0,10 / $ 0,50 en Gemini 3.1 Flash-Lite rond $ 0,25 / $ 1,50. Deze zijn voor classificatie, extractie, routing en andere korte, eenduidige taken. Op inputprijs zijn ze ruimschoots 15x goedkoper dan Flash. Ze zijn niet zo capabel, en dat is ook niet de bedoeling.
Flash-klasse werkpaard (ongeveer $ 1–$ 2 input). Gemini 3.6 Flash tegen een gerapporteerde $ 1,50 / $ 7,50, naast gelijken zoals Claude Sonnet 5.5 (bevestigd $ 2 / $ 10) en de gerapporteerde GPT-6.1 Terra ($ 1 / $ 5). Dit is het default-niveau: chat, samenvatting, RAG-antwoorden, alledaagse coding, alles wat echte competentie nodig heeft maar niet de diepste reasoning.
Vlaggenschipniveau (ongeveer $ 2–$ 10 input, hoge output). Gemini 3.1 Pro (gerapporteerd $ 2 / $ 12), Claude Opus 5.5 (bevestigd $ 4 / $ 20), de gerapporteerde GPT-6 Astra ($ 10 / $ 50). Deze verdienen hun prijs alleen terug op het lastige deel: langdurige agentic coding, diepe reasoning, moeilijke analyses.

Het punt van de ladder is dat elke sport ongeveer een orde van grootte verschilt in prijs of capaciteit, dus een request naar de verkeerde sport verplaatsen is in de ene richting duur en in de andere richting van lage kwaliteit. Flash is de sport waar het meeste van uw verkeer thuishoort.
Flash is de juiste default, niet het juiste antwoord voor alles. Hier is de beslissing.
Prijzen/benchmarks zoals gerapporteerd per november 2026; verifieer dit op de officiële prijzenpagina van elke provider voordat u erop vertrouwt — modelspecificaties veranderen vaak. Claude-cijfers zijn door de maker bevestigd.
Bekijk hoe TrueFoundry standaard voor goedkope modellen kiest en automatisch terugvalt. Boek een demo.
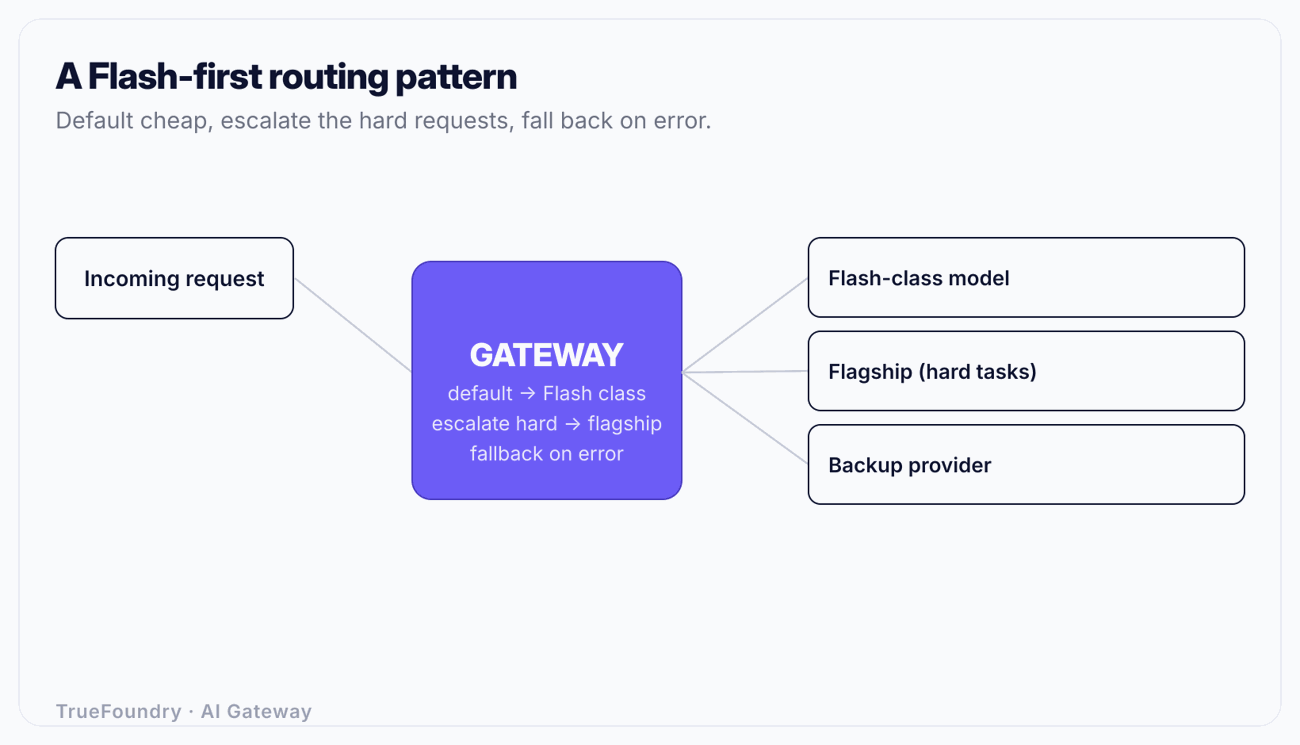
Weten dat Flash uw default moet zijn, is niet genoeg. U hebt een mechanisme nodig dat het meeste verkeer naar Flash stuurt, de requests herkent die meer nodig hebben, alleen die requests escaleert en niet faalt wanneer Google een slechte vijf minuten heeft. Dat mechanisme is een AI gateway met een universele, OpenAI-compatibele API.
Hier is het patroon in vier stappen.
1. Maak van Flash de default-route. Koppel een model-alias (bijv. default-chat) aan Gemini 3.6 Flash in de gateway-configuratie. Uw applicatie roept default-chat aan; deze hardcodeert nooit "gemini-3.6-flash." Wanneer u in plaats daarvan Sonnet 5.5 of Terra als default wilt testen, wijzigt u één regel in de configuratie en verschuift u een percentage van het verkeer, zonder de applicatie te deployen. Dit is kosten- en kwaliteitsbewuste modelselectie in de praktijk, en de achterliggende gedachte is wat een LLM router doet.
2. Escaleer lastige requests. Tag requests die meer nodig hebben (een complexiteitssignaal uit uw app, een specifiek endpoint, een retry na een antwoord met lage betrouwbaarheid), zodat de gateway deze in plaats daarvan naar een vlaggenschip-alias routeert. Het meeste verkeer blijft op Flash; alleen het kleine, lastige deel betaalt vlaggenschiptarieven. De drempel is een routing-regel, geen code-branch die verspreid staat over uw services.
3. Val terug bij fouten. Configureer Flash om terug te vallen op een tweede provider wanneer Google een foutmelding geeft of een timeout veroorzaakt. Een Flash-klasse request kan terugvallen op Claude Sonnet 5.5 of GPT-6.1 Terra. Retries binnen de request en provider-fallback zorgen ervoor dat een incident bij een provider een kleine vertraging wordt in plaats van een storing. Zie wat is LLM fallback.
4. Cache en meet. Exacte en semantische caching voorkomen dat u Flash betaalt om twee keer dezelfde vraag te beantwoorden; zie semantische caching. En elke call wordt geregistreerd met tokens, latency en kosten, getagd per gebruiker, team en model, zodat u kunt bewijzen dat Flash het volume draagt en het vlaggenschip alleen het lastige deel raakt. Zie LLM observability tools.
Neem een product dat 5M requests per maand verwerkt, voornamelijk chat en RAG, met een lastige tail van complexe reasoning. Stel dat de verdeling 75% alledaags (geschikt voor Flash), 20% triviaal (geschikt voor bodemprijs), 5% lastig (geschikt voor vlaggenschip) is, met een gemiddelde van 800 input- en 400 outputtokens.
Als alles op een vlaggenschip draait tegen $ 2 / $ 12, betaalt u het vlaggenschip-outputtarief op alle 5M requests, inclusief de 3,75M die Flash op dezelfde manier zou hebben beantwoord en de 1M die een $ 0,10-model identiek zou hebben afgehandeld.
Routeer in plaats daarvan per niveau:
Het triviale deel van 20% daalt ongeveer 15x in inputkosten door Flash te verruilen voor het bodemprijsniveau. Het alledaagse deel van 75% daalt van vlaggenschip-output ($ 12) naar Flash-output ($ 7,50), wat bijna 40% scheelt op de grootste kostencomponent. Het lastige deel van 5% behoudt het vlaggenschip. Het netto-effect bij de meeste echte token-mixen is een kostenverlaging van ruim meer dan een derde, zonder kwaliteitsverlies op welk niveau dan ook, omdat elke request nog steeds op een daarvoor geschikt model belandt. U kunt het getal alleen bevestigen door de kosten per niveau te meten, wat de reden is waarom observability en kostentoewijzing even belangrijk zijn als de routing.
Om te voorkomen dat het lastige niveau ongemerkt het budget overschrijdt, stelt u een plafond in met token rate limiting en budgetten: de gateway retourneert HTTP 429 wanneer een team of model zijn limiet overschrijdt, zodat een escalatiepad niet met uw uitgaven aan de haal gaat.
Gemini 3.6 Flash is gebouwd voor de plek waar het grootste deel van uw uitgaven zich daadwerkelijk bevindt: de mediane request. Met een gerapporteerd tarief van $ 1,50 / $ 7,50, een context window van 1M en een sterke doorvoer, biedt het u het grootste deel van het alledaagse nut van een vlaggenschip zonder de vlaggenschipprijs, en het is duidelijk een stap hoger dan het bodemprijsniveau dat nog steeds uw triviale taken moet afhandelen. Het juiste mentale model is een ladder, en Flash is de sport waar het meeste verkeer thuishoort.
Maak het uw default bij een gateway, escaleer alleen de lastige requests naar een vlaggenschip, val terug op een tweede provider wanneer Google haperingen vertoont en meet de kosten per model zodat u kunt bewijzen dat de verdeling werkt. Als u dat doet, is "gebruik Gemini 3.6 Flash" geen eenmalige beslissing meer, maar een routing-policy die u kunt bijsturen zodra het volgende model of de volgende prijsverlaging beschikbaar is.
Routeer naar het goedkoopste model dat goed genoeg is. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.




Het wordt gerapporteerd op $1,50 per 1 miljoen inputtokens en $7,50 per 1 miljoen outputtokens, per november 2026. Dat is een prijs uit het middensegment: ruim boven de goedkoopste modellen rond $0,10 input, ruim onder vlaggenschepen. Deze cijfers komen van rapportages door derden; verifieer ze bij de officiele prijspagina van Google voordat u erop vertrouwt, omdat modelprijzen regelmatig veranderen.
Gerapporteerde benchmarks plaatsen het rond 58,7% op SWE-Bench Pro, wat sterk is voor een model uit het middensegment en het een redelijk alledaags werkpaard voor coderen maakt. Voor agentic coding op lange termijn is een vlaggenschip zoals Claude Opus 5.5 (bevestigd) een veiligere standaardkeuze. Evalueer Flash op uw eigen codebase voordat u zich vastlegt, aangezien benchmarkscores niet zuiver overdraagbaar zijn.
Gebruik Flash als uw standaard voor chat, RAG en alledaags coderen, en Pro voor het lastige redeneerdeel. Pro wordt gerapporteerd op $2/$12 tegenover $1,50/$7,50 voor Flash, dus Pro kost meer en verdient dat alleen terug bij echt moeilijke verzoeken. De beste opzet routeert het grootste deel naar Flash en escaleert lastige verzoeken op gatewayniveau naar Pro.
Gebruik de algemeen beschikbare Gemini 3.5 Flash als fallback-doel totdat u 3.6 rechtstreeks bij Google bevestigt. Omdat dit is geconfigureerd als een gateway-alias, is het later verwisselen van 3.5 voor 3.6 een configuratiewijziging, geen codewijziging.
Wijs in een AI Gateway een model-alias toe aan Flash en laat uw applicatie de alias aanroepen, niet de modelnaam. U krijgt een uniforme, OpenAI-compatibele API, automatische fallback naar een tweede provider bij een fout, caching en kostentracking per model, en u kunt de standaard later naar een ander model verschuiven door alleen de configuratie aan te passen.



Het laatste nieuws, artikelen en bronnen in je inbox