



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
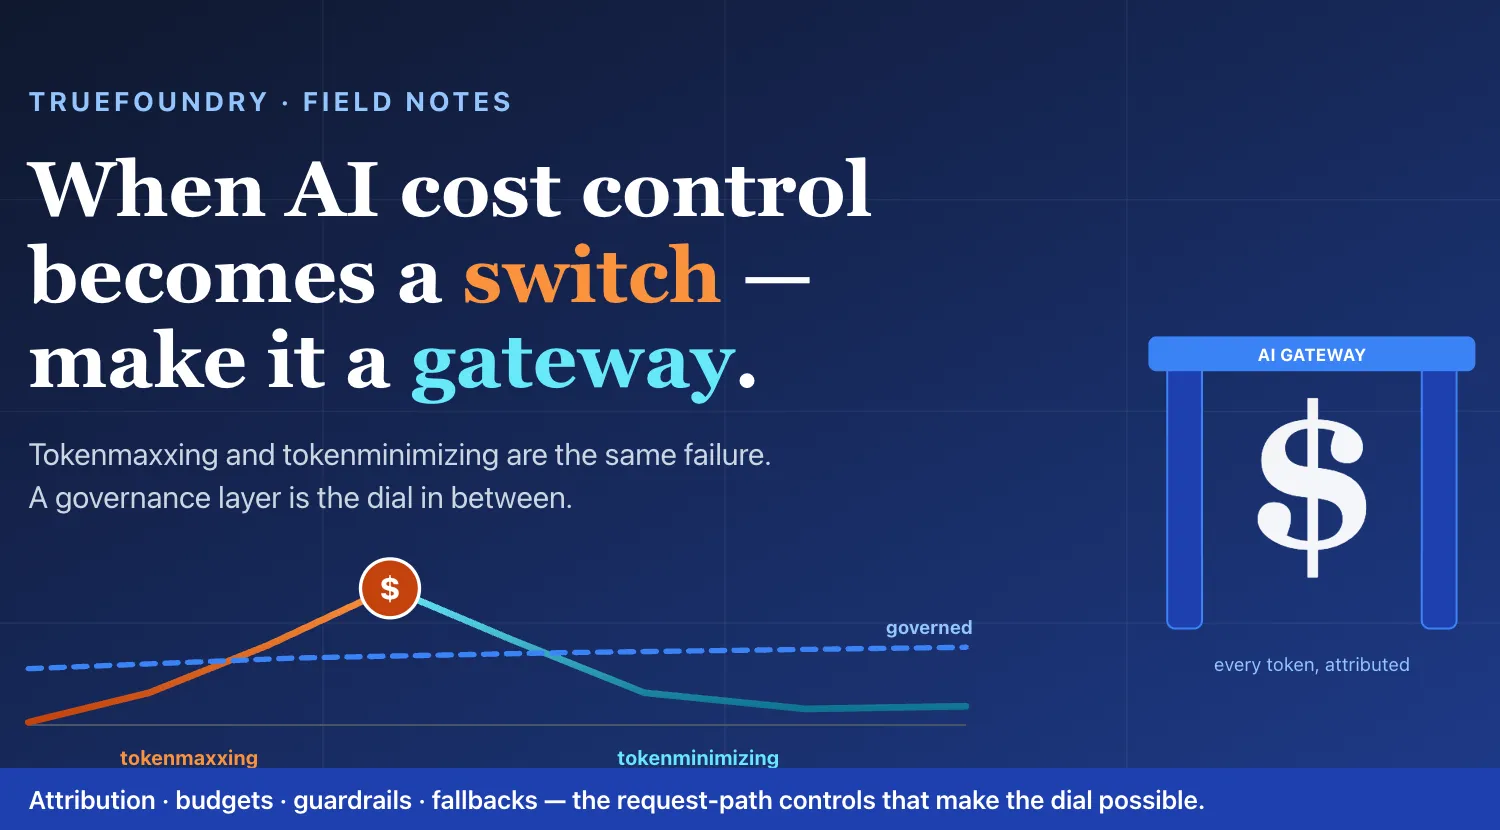
In juni 2026 raporteerde Yahoo Finance dat Meta in een interne memo aan ongeveer 6.000 werknemers had laten weten het toezicht op hun AI-tokengebruik aan te scherpen en uitgavencontroles in te voeren — weken nadat diezelfde werknemers werden aangespoord om AI juist meer te gebruiken. Volgens die berichtgeving ligt het interne AI-gebruik van Meta alleen al op koers om het bedrijf in 2026 miljarden dollars te kosten. Binnen enkele weken werd gemeld dat Amazon zijn eigen interne klassement voor AI-gebruik had stopgezet, en dat Uber naar verluidt zijn gehele geplande budget voor AI-coding voor 2026 in de eerste vier maanden van het jaar erdoorheen had gejaagd. De pers bedacht een naam voor deze ommekeer: tokenminimizing.
Dit is het appendix dat de tokenmaxxing-trilogie altijd al nodig zou hebben. De trilogie betoogde — voordat de reactie begon — dat het vieren van tokenconsumptie het verkeerde meet, en dat een organisatie zonder governance-laag uiteindelijk slechts twee standen overhoudt: wijd open, of dichtgeknepen. De tokenminimizing-reactie is de tweede stand. Het punt van deze blogpost is niet dat de voorspelling juist was; het is dat beide standen dezelfde fout zijn, dat recente berichtgeving over drie grote technologiebedrijven dit binnen een enkel kwartaal illustreert, en dat er een derde optie is die deze jojo-beweging overbodig maakt.
De feiten hier zijn volledig ontleend aan gepubliceerde berichtgeving, en we schrijven elke bewering toe aan de bron in plaats van deze onafhankelijk te beweren. We noemen deze bedrijven alleen omdat hun interne stappen via die berichtgeving openbaar zijn geworden; we doen geen onafhankelijke uitspraken over de interne bedrijfsvoering van enig bedrijf buiten wat deze media hebben gepubliceerd.
Meta. Zoals Yahoo Finance meldde, onder verwijzing naar een interne memo van Meta die voor het eerst werd gemeld door The Information, heeft Meta aan ongeveer 6.000 medewerkers laten weten uitgavencontroles, budgetten en gebruikslimieten in te voeren, met verwijzing naar interne AI-kosten die op koers liggen om in 2026 in de miljarden dollars te lopen. Volgens die berichtgeving hadden werknemers en teams beperkt zicht op hun eigen consumptie, en verwacht het bedrijf tegen 2027 over te stappen op een gestructureerd raamwerk van budgetten en toewijzingsbeslissingen. Om daar te komen, zo meldt de berichtgeving, heeft Meta een gecentraliseerd dashboard gebouwd dat het een "AI Gateway" noemt om gebruik en uitgaven op één plek te volgen, met geautomatiseerde waarschuwingen voor ongebruikelijke pieken. Bij dat detail staat u best even stil: van een bedrijf van Meta's omvang, dat het maxxing-experiment heeft uitgevoerd, wordt gemeld dat het exact de categorie systeem bouwt — real-time attributie, uitgavenregistratie, piekwaarschuwingen, gestructureerde budgetten — waarvan deze serie heeft betoogd dat het vanaf het begin in het request-pad thuishoort.
Amazon. Weken eerder, zoals TheStreet en andere media meldden (onder verwijzing naar de Financial Times, die het nieuws bracht), wztn Amazon een intern klassement genaamd "KiroRank" stop dat werknemers scoorde op AI-activiteit op het Kiro-ontwikkelaarsplatform. Volgens die berichtgeving hadden medewerkers hun scores kunstmatig verhoogd door taken met lage waarde via AI-agents uit te voeren om te stijgen in de ranglijst — het gedrag dat in de sector nu tokenmaxxing wordt genoemd — wat de compute-kosten opdreef. De berichtgeving merkt op dat Amazon het klassement heeft vervangen door een metriek die het "normalized deployments" noemt, wat betekent: met AI ondersteunde code die daadwerkelijk in productie wordt genomen. Een senior executive zou het personeel hebben opgedragen AI niet te gebruiken omwille van het gebruik van AI. Die vervanging is de correctie van input naar output die door Amazon zelf concreet is gemaakt: stop met het tellen van geconsumeerde tokens, begin met het tellen van opgeleverd werk.
Uber. En zoals opgemerkt in hetzelfde Yahoo Finance-rapport en eerder verslagen door Business Insider, werd gemeld dat Uber zijn gehele geplande budget voor AI-coding voor 2026 in de eerste vier maanden van het jaar had opgebruikt; dezelfde berichtgeving merkt op dat de COO van Uber zei dat het bedrijf geen duidelijke link had gevonden tussen hogere AI-uitgaven en opgeleverde resultaten. Drie bedrijven, drie verschillende mechanismen, één kwartaal, dezelfde vorm.
De labels "tokenmaxxing" en "tokenminimizing" doen dit klinken als twee trends. Het is nuttiger om het te lezen als één patroon met twee fasen, dat nu zichtbaar is bij drie afzonderlijke bedrijven: adoptie wordt aangemoedigd zonder dat er een governance-laag onder zit, gebruik wordt de zichtbare metriek, kosten verrassen de leiding, en de enige beschikbare hendel is een botte instrument.
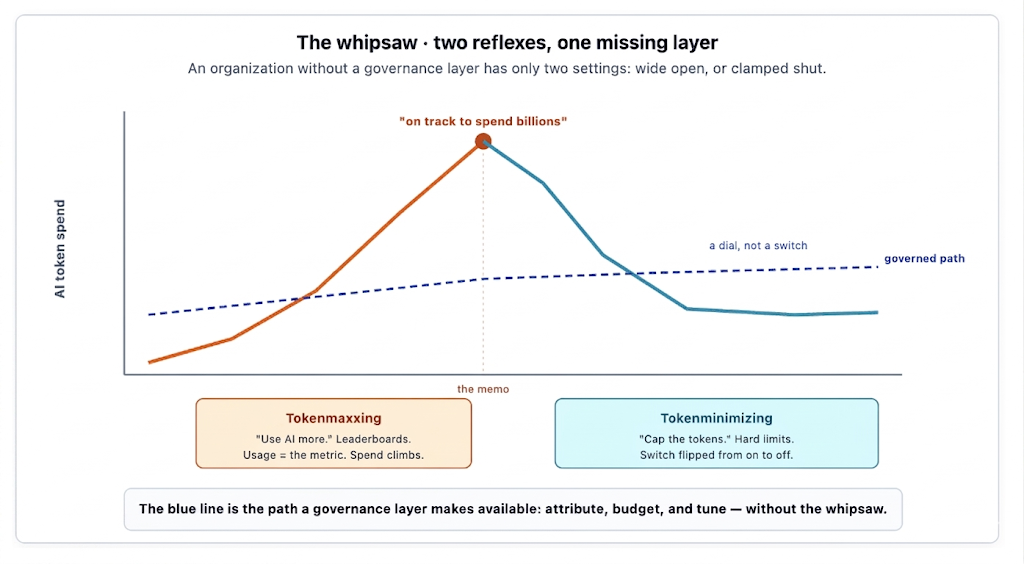
De tokenmaxxing-trilogie (alle links staan in de Referenties) was geen verheerlijking van tokenconsumptie. Het was een kritiek erop. Het centrale argument, gemaakt over alle drie de delen, is het onderscheid tussen een input en een output: tokens zijn iets dat u uitgeeft, en het werk dat de tokens opleveren is hetgeen dat er echt toe doet. Een klassement dat werknemers rangschikt op basis van verbruikte tokens meet de input en beloont het maximaliseren ervan — en op het moment dat een meting een doel wordt, houdt het volgens de wet van Goodhart op een goede meting te zijn. De trilogie zei dit klaar helder terwijl de maxxing-fase nog op volle toeren draaide, toen de heersende stemming stijgende tokengrafieken zag als onomstotelijk bewijs van productiviteit.
Dat is het gedeelte waar we precies over moeten zijn, want het is gemakkelijk om deze post te lezen als een overwinningsronde. Dat is het niet. De trilogie voorspelde niet dat een specifiek bedrijf in juni 2026 een memo zou sturen. Het maakte een structureel argument — dat het meten van de input uiteindelijk een pijnlijke correctie zou afdwingen — en het structurele argument is wat de berichtgeving nu illustreert, bij meer dan één bedrijf. De opmerking die is toegeschreven aan Meta CTO Andrew Bosworth in de verslaggeving van MLQ — dat tokengebruik alleen geen maatstaf voor impact is — leest als de stelling van de trilogie in de woorden van een CTO, naar verluidt onafhankelijk tot stand gekomen onder de druk van een prognose van miljarden dollars. En de casus van Amazon is in sectorberichtgeving beschreven als een schoolvoorbeeld van de wet van Goodhart: op het moment dat tokenconsumptie een doel op een klassement werd, zo stelt de berichtgeving, stopte het met het meten van productiviteit en begon het met het meten van competitieve angst. Dat is het argument van de trilogie vrijwel letterlijk, onafhankelijk bereikt door waarnemers die hetzelfde falen zagen plaatsvinden.
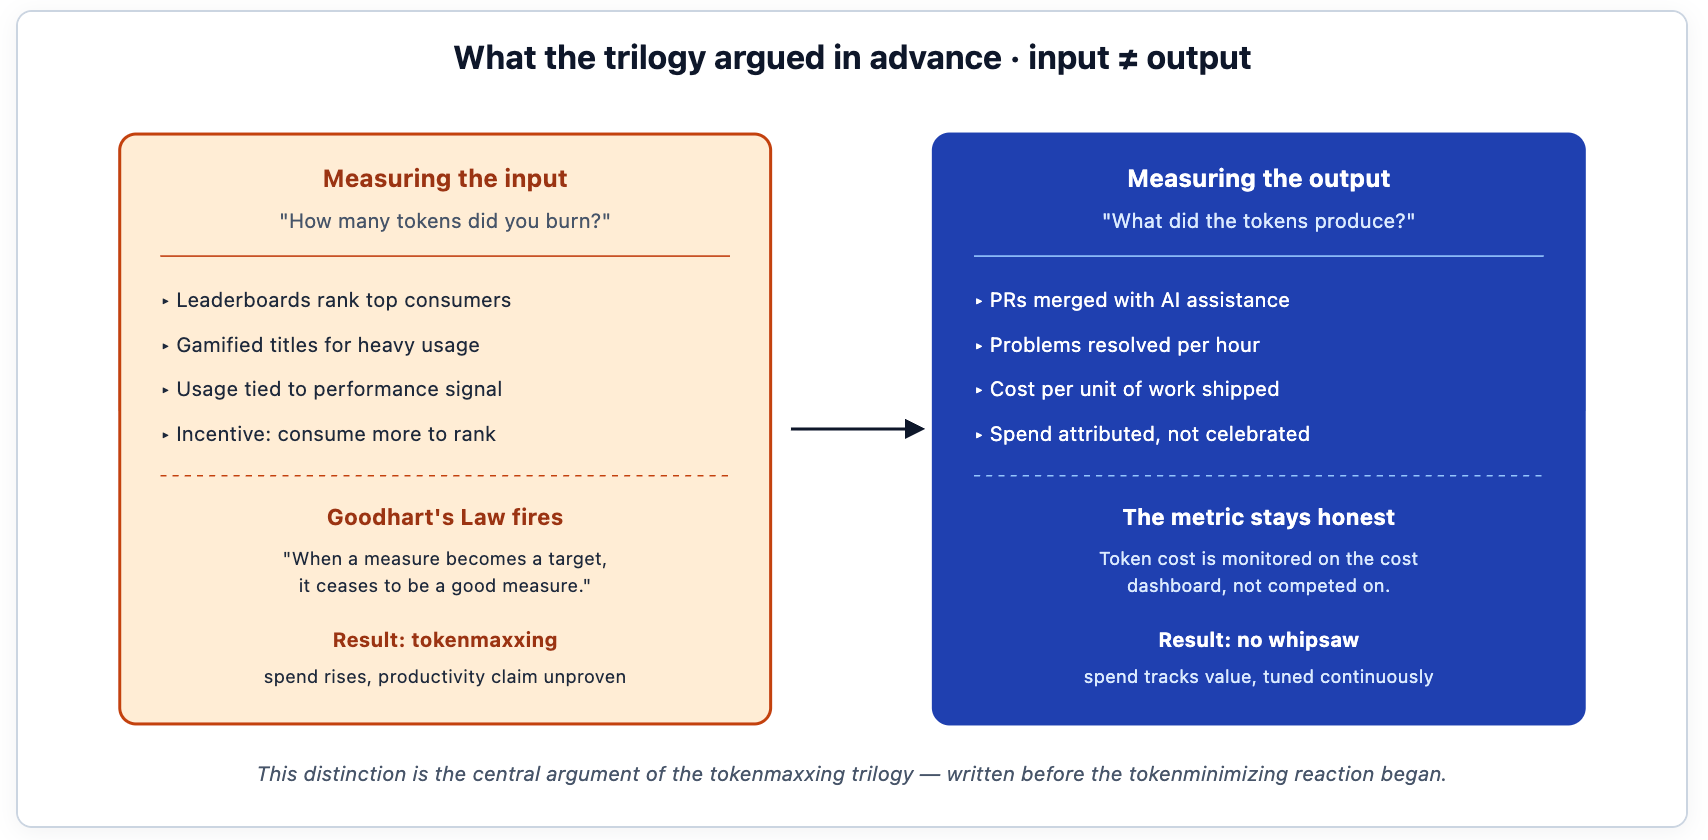
De aanbeveling van de trilogie vloeide voort uit het onderscheid: meet de output (opgeleverd werk, opgeloste problemen, kosten per eenheid waarde), en houd tokenkosten op het kostendashboard van het platformteam in plaats van op een klassement waar werknemers om strijden. Een organisatie die dit doet, bouwt nooit de prikkel op die de maxxing-piek veroorzaakt, en krijgt daarom nooit te maken met de rekening die dwingt tot de minimizingsklem. De jojo-beweging is te vermijden, maar alleen door te weigeren de eerste zwaai te maken.
Het is verleidelijk om de tokenminimizing-reactie te lezen als de verantwoordelijke correctie — de volwassenen die arriveren om het feestje te beëindigen. Die lezing is onjuist, of ten minste onvolledig. Een algemene tokenlimiet is geen governance; het is de afwezigheid van governance gekleed in een verantwoord ogend kostuum. Het knijpt de security-review-pipeline af die echte kwetsbaarheden opspoorde op dezelfde manier af als de engineer die het klassement aan het bespelen was, omdat een botte limiet die twee niet uit elkaar kan houden. De organisatie ruilt het ene ongedifferentieerde beleid ("gebruik AI vrijuit") in voor het andere ("gebruik AI minder"), en geen van beide beleidsregels kan waardevolle uitgaven onderscheiden van verspillende uitgaven, wat überhaupt het hele probleem was.
Dit is de redelijke kern van de bedrijven die geld verbrandden aan tokens en nu terugkrabbelen: de uitgaven waren reëel, de productiviteitsvragen waren terecht, en gas terugnemen is een verdedigbare reactie op een miljardenprognose waar geen attributie achter zit. We zijn niet kritisch over het besluit om kosten te beheersen. We zijn kritisch over het feit dat, bij het ontbreken van een governance-laag, het enige beschikbare instrument een voorhamer is. Een bedrijf dat doorslaat naar minimizing maakt de beste zet die het ter beschikking heeft — gegeven dat het de zet heeft overgeslagen die een betere mogelijk zou hebben gemaakt.
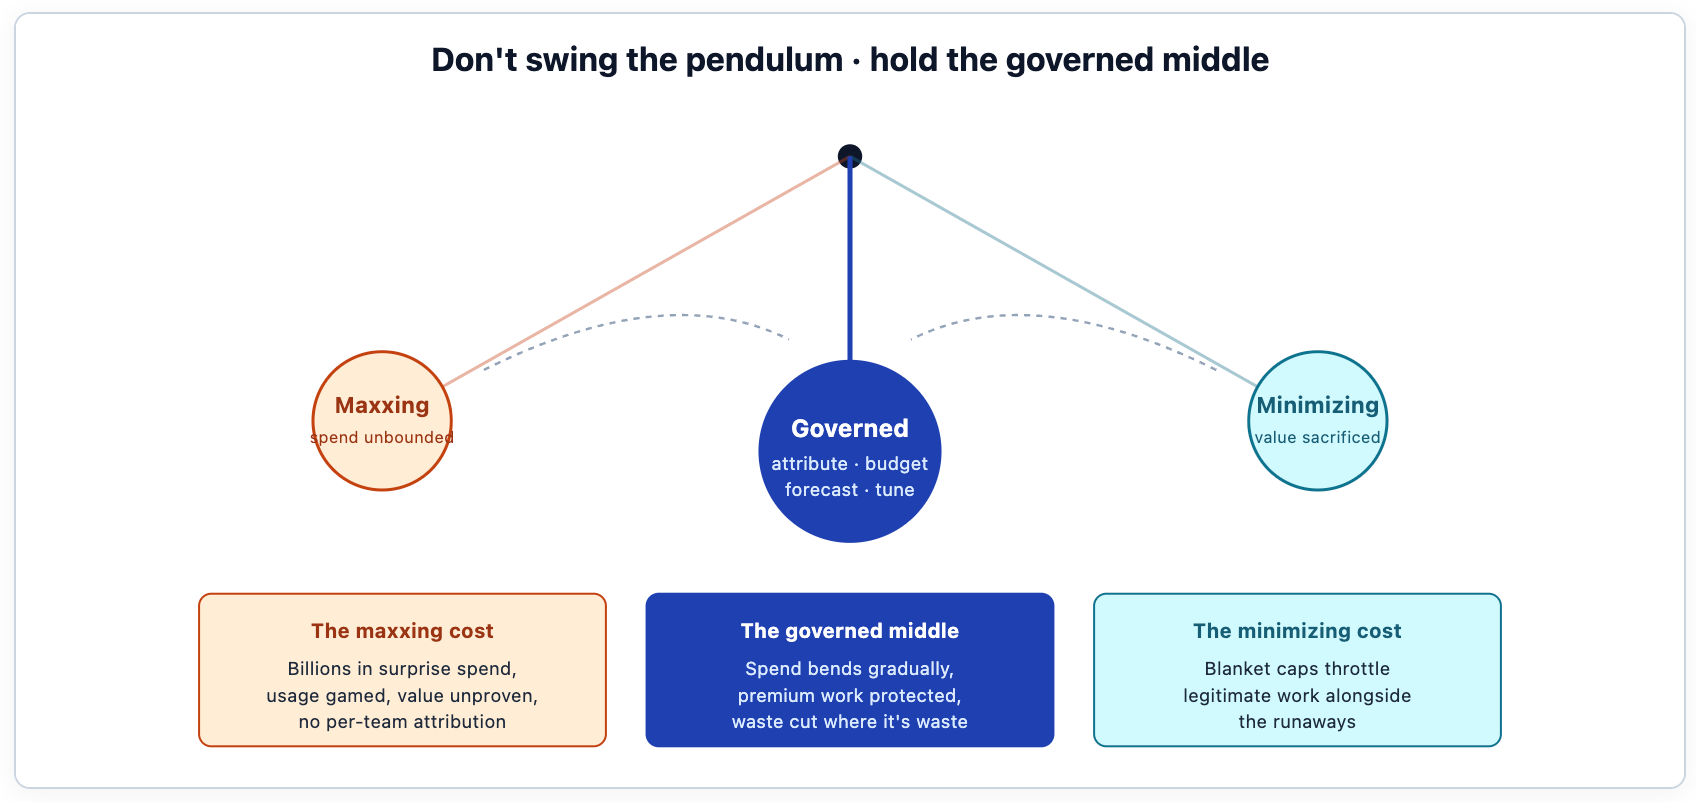
Het gestuurde midden is geen gematigd compromis tussen maxxing en minimizing. Het is een geheel andere as. De maxxing-minimizing-as loopt van "alles uitgeven" tot "niets uitgeven". De gestuurde as loopt van "blind uitgeven" naar "uitgeven met attributie, budgetten en een prognose". Een team dat op de gestuurde as werkt, kan agressief uitgeven aan de workloads die waarde opleveren, inclusief die met meta prompting, en tegelijkertijd de workloads uithongeren die dat niet doen, omdat het ze uit elkaar kan houden.
Concreet heeft de laag die de trilogie bepleitte, en die TrueFoundry's AI Gateway levert, drie onderdelen. Ten eerste, attributie: elk request draagt identiteit met zich mee — team, repo, pipeline, kostenplaats — zodat "wie geeft er uit" een query is, geen opsporingsonderzoek. Ten tweede, hiërarchische budgetten met gestapte reacties: een soft alert bij 75% van het plafond van een kostenplaats, een beperkte modus bij 90% die verkeer naar premium-modellen transparant omleidt naar goedkopere fallbacks zodat pipelines blijven werken, en een harde limiet bij 100% die netjes faalt met een duidelijke foutmelding. Ten derde, een rollende prognose die de uitgaven aan het einde van de maand projecteert met voldoende doorlooptijd om te handelen voordat de limiet wordt bereikt. Deze zijn gedocumenteerd in TrueFoundry's Budget Limiting en Rate Limiting schema's, en ze vormen samen één eigenschap: de uitgavencurve buigt geleidelijk onder controle in plaats van te pieken en vervolgens in te storten.
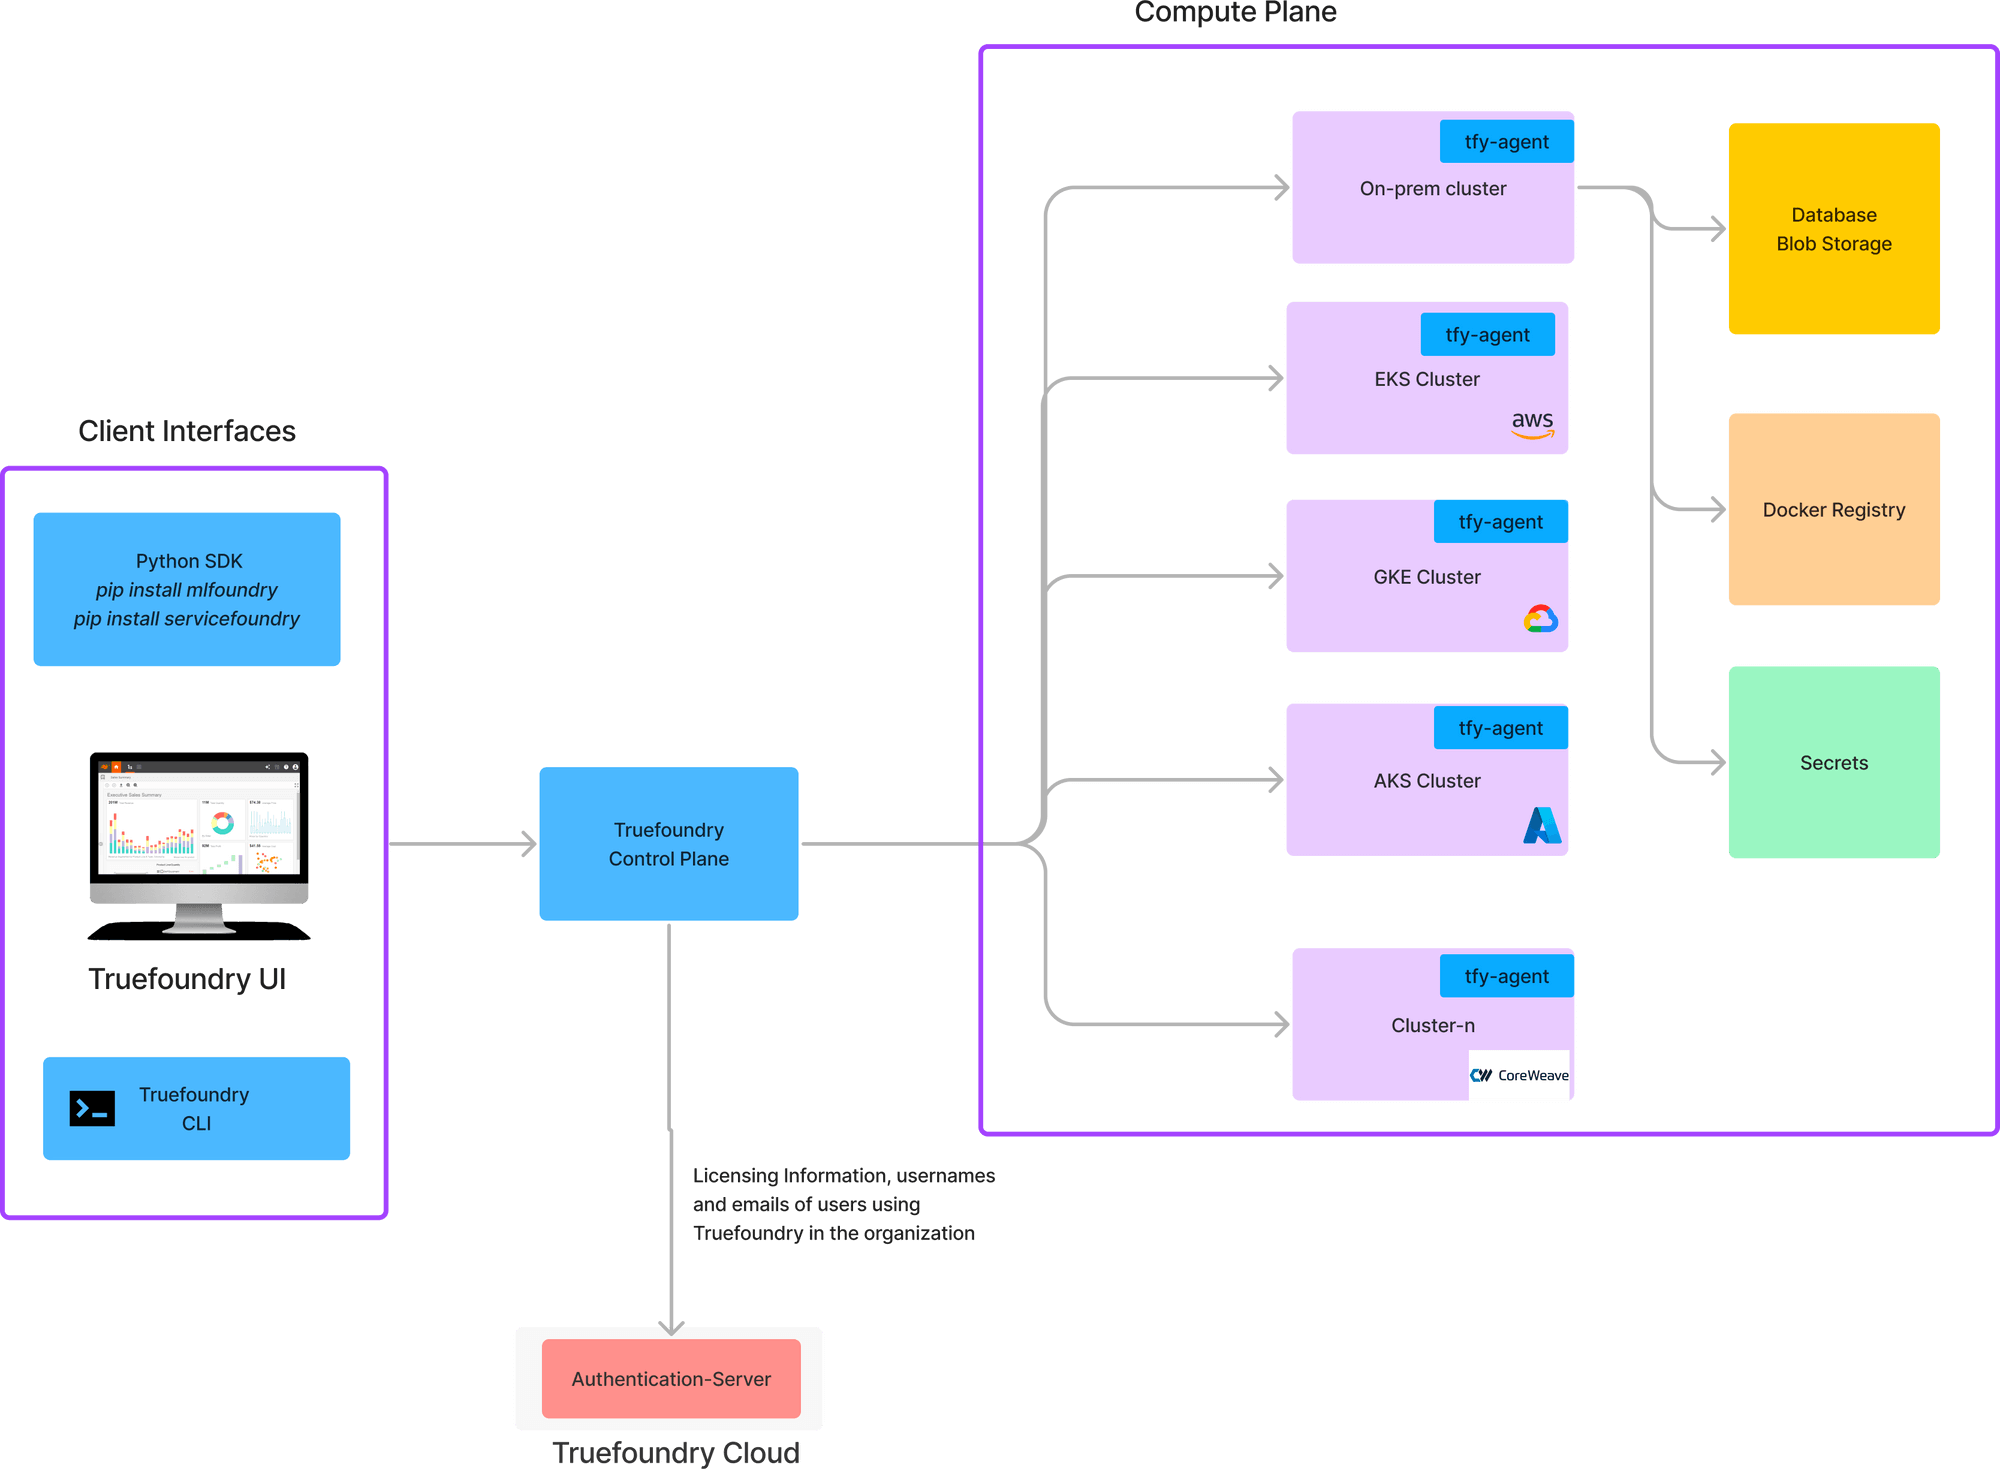
Een team dat deze laag tijdens de maxxing-fase paraat had, zou geen reactieve memo nodig hebben gehad. De 75%-alerts zouden de zware kostenplaatsen in real-time aan het licht hebben gebracht; de prognose zou het miljardentraject maanden voordat het een krantenkop werd hebben geprojecteerd; de beperkte modus zou de curve op de verspillende workloads hebben afgevlakt zonder de productieve aan te raken. Er zit een stille bevestiging in het huidige nieuws hierover, en het is de moeite waard om dit duidelijk maar zorgvuldig te stellen: wanneer wordt gemeld dat Meta op zijn kostencrisis reageert door een intern dashboard te bouwen dat het een "AI Gateway" noemt, en Amazon naar verluidt zijn gebruiksklassement vervangt door een metriek voor opgeleverde code, dan wijzen die berichten op dezelfde architecturale categorie die TrueFoundry tot product heeft gemaakt — attributie, budgetten, routing controls en observability in het request-pad. TrueFoundry's AI Gateway is een implementatie op enterprise-niveau van diezelfde categorie: één OpenAI-compatibel eindpunt voor de ondersteunde modelcatalogus, attributie en budgetten in het request-pad, en de opsplitsing tussen control-plane en compute-plane die hierboven is getoond en die ervoor zorgt dat het implementeerbaar blijft in de eigen cloud van een gereguleerd bedrijf. TrueFoundry documenteert dit split-plane-model — het control plane beheert de configuratie en policy terwijl het compute plane in de VPC, on-prem of air-gapped omgeving van de klant draait, met "geen data verlaat uw domein" als de gestelde grens; teams in gereguleerde omgevingen moeten de exacte garanties voor gegevensverwerking nog steeds controleren aan de hand van de deployment-documentatie en hun contract. We zullen niet beweren dat een van deze bedrijven specifiek TrueFoundry had moeten gebruiken, of erdoor gered zou zijn — dat is onbekend en niet het punt. Het punt is structureel: de teams die deze laag vroeg opbouwen, hebben een regelknop in handen wanneer de rekening binnenkomt. De reden om het zorgvuldig te zeggen is dezelfde reden als waarom de trilogie het zei: de laag geeft u de knop; het draait de knop niet voor u om.
De reden waarom dit van belang is voor kopers, is dat een governance-laag slechts zo goed is als de mate van controle die het u geeft in het request-pad. Een dunne routing-proxy kan uitgaven toewijzen en daar stappen; een gateway op enterprise-niveau verandert attributie in een volledig operationeel oppervlak — kosten, betrouwbaarheid, veiligheid, toegang en agents, beheerd op één plek. TrueFoundry's AI Gateway is gebouwd als dat oppervlak, en de onderstaande functionaliteiten zijn het verschil tussen "we kunnen de uitgaven zien" en "we kunnen de strategie uitvoeren". Elk onderdeel is gedocumenteerd op de product- en documentatiepagina's van TrueFoundry; TrueFoundry's observability-overzicht en de AI Gateway-productpagina dienen als referenties.
Één eindpunt, 1600+ modellen, interne latency onder 3 ms. Elk model — OpenAI, Anthropic, Gemini, Bedrock, Mistral, self-hosted — bevindt zich achter een enkele OpenAI-compatibele API; TrueFoundry's productpagina beschrijft één eindpunt voor 1600+ modellen en 250+ LLM's. De auth-, rate-limit- en load-balancing-checks worden in-memory uitgevoerd, zodat de gateway minimale latency toevoegt in het kritieke pad; TrueFoundry documenteert een interne gateway-latency van minder dan 3 ms en, in het observability-overzicht, 350+ RPS op een enkele vCPU. Het beheeroppervlak kost u vrijwel niets in het request-pad, wat de voorwaarde is om al het andere erop te plaatsen.
Guardrails op elk request, in en uit. De gateway past input- en output-guardrails toe — PII-detectie en -redactie, toxiciteits- en bias-checks, contentmoderatie en custom policies — en kan verbinding maken met externe diensten zoals OpenAI Moderation, AWS Guardrails en Azure Content Safety. Dit is de laag die fouten in de stijl van NYC-MyCity opvangt: een antwoord dat iets adviseert wat niet zou moeten, wordt geblokkeerd of omgeleid naar menselijke beoordeling voordat het de gebruiker bereikt. Guardrail-activiteit is een first-class metriek (llm_gateway_guardrails_requests_total), zodat u precies kunt zien hoe vaak elk policy wordt getriggerd en op welke routes.
Token-bewuste rate limiting, niet alleen RPS. Één enkele lange prompt kan meer kosten dan duizend korte, dus limits op basis van requests-per-seconde zijn de verkeerde eenheid voor AI. TrueFoundry dwingt quota af op basis van tokens of requests per minuut, uur of dag, bereikbaar op gebruiker, team, model, virtueel account of een willekeurige metadata-sleutel — exact het mechanisme dat een enkele ontspoorde loop of een engineer die het klassement probeert te manipuleren stopt voor hij een gedeeld budget opgebruikt. Dit is het structurele antwoord op tokenmaxxing: geen bedrijfsbrede limiet, maar een plafond per identiteit dat de uitschieter afknijpt zonder de rest te raken.
Toegangsbeheer gebouwd voor enterprise. Gecentraliseerd API-key-beheer betekent dat provider-keys nooit verspreid raken over applicatiecode; de gateway geeft in plaats daarvan scoped tokens uit. RBAC met SSO, OAuth 2.0 en API-key-authenticatie bepaalt wie welk model kan aanroepen, en centraal opgeslagen, audit-ready request/response-logging legt vast wie wat heeft aangeroepen, met welke gegevens en wat er terugkwam — de compliance-ruggengraat die AVG/GDPR-, SOC 2- en HIPAA-workloads vereisen. Keys kunnen worden geroteerd of ingetrokken zonder downtime.
Fallbacks en load balancing die de continuïteit waarborgen. Declaratieve fallback-chains, routing op basis van gewicht en latency, health checks en automatische failover zorgen ervoor dat een storing bij een provider of een limiet een transparante omleiding wordt in plaats van een incident. Dit is ook een kostenhendel: de "beperkte modus" bij 90% budget uit de trilogie is exact een fallback-regel die verkeer naar premium-modellen omleidt naar een goedkopere tier wanneer een budgetdrempel wordt overschreden, zodat pipelines blijven draaien terwijl uitgaven afvlakken. Fallback-activiteit is observeerbaar per request (llm_gateway_fallback_requests_total), zodat u kunt kwantificeren wat elke failover u heeft gekost.
MCP en agents, beheerd op hetzelfde vlak. Naarmate agents verschuiven van losse modelaanroepen naar loops die tools gebruiken, moet het beheeroppervlak ze volgen. TrueFoundry's MCP Gateway voegt een centrale registry van MCP-servers toe, OAuth 2.0 op gebruikersniveau plus virtuele-accounttokens voor tool-toegang op basis van least-privilege, RBAC en goedkeuringsstappen bij gevoelige acties, en tracing per tool. De Agent Harness voert de agent-loop zelf uit: volgens de documentatie gelden budgetten, quota en rate limits voor de loop als een eigen agent-identiteit, en zijn stopvoorwaarden — staplimieten, tokenbudgetten en stall-detectie — instellingen van de harness in plaats van iets dat elk team opnieuw moet bouwen.
Observability die alles omzet in actie. Elk request zendt OpenTelemetry-traces uit met gen_ai.*-attributen en exporteert naar Prometheus, Grafana, Datadog of Elastic; kosten worden automatisch berekend op basis van de gepubliceerde tarieven van providers en toegewezen per model, team, gebruiker en metadata. Hetzelfde dashboard toont policy-activiteit — rate limits, fallbacks, guardrails, budgetten — zodat een kostenspanning, een getriggerde guardrail en een fallback-storm allemaal op één scherm, in real-time zichtbaar zijn, in plaats van achteraf ontdekt te worden op de factuur van volgende maand.
Dat laatste punt is de moeite waard om duidelijk en nauwkeurig aan de koper uit te leggen: deze primitieven zijn wat het operationele model mogelijk maakt — ze zijn niet het operationele model op zichzelf. Kostenattributie vertelt u waar het geld naartoe gaat; budgetten en rate limits bakenen het af; fallbacks beschermen de ervaring terwijl u bijstelt; guardrails en toegangsbeheer houden het veilig en compliant; de agent-harness breidt dit alles uit naar loops. Samen zorgen ze ervoor dat een platformteam het model van de regelknop (in plaats van een schakelaar) kan implementeren in één request-pad, in plaats van elke beheersmaatregel afzonderlijk te bouwen — wat het werk is dat de door de jojo-beweging getroffen bedrijven nu achteraf op zich nemen. Het enige wat de gateway niet doet, is uw beleid voor u bepalen: het geeft u de knop en de gegevens, en een kundig team moet nog steeds de drempels instellen en reageren op de alerts. Dat is geen zwakte van de tooling; het is de juiste arbeidsverdeling, en het is precies waarom het vroegtijdig aanwezig hebben van deze laag het verschil maakt tussen een strategie en een reflex.
Het helpt om een getal te plakken op de kloof tussen "blind" en "toegewezen" — geen exact getal, want geen enkel eerlijk model zou dat kunnen zijn, maar wel een indicatie van de orde van grootte. De onderstaande schatter sluit rechtstreeks aan op de bovenstaande TrueFoundry-functionaliteiten: attributie brengt de verspillende uitgaven aan het licht, en budgetten, token-bewuste rate limits en fallback routing stellen u in staat om daarnaar te handelen. De slider voor het "actiegerichte aandeel" is een weergave van hoeveel van de aan het licht gebrachte verspilling die mechanismen daadwerkelijk kunnen terugwinnen. Niets is verborgen; de formule staat onder het resultaat afgedrukt.
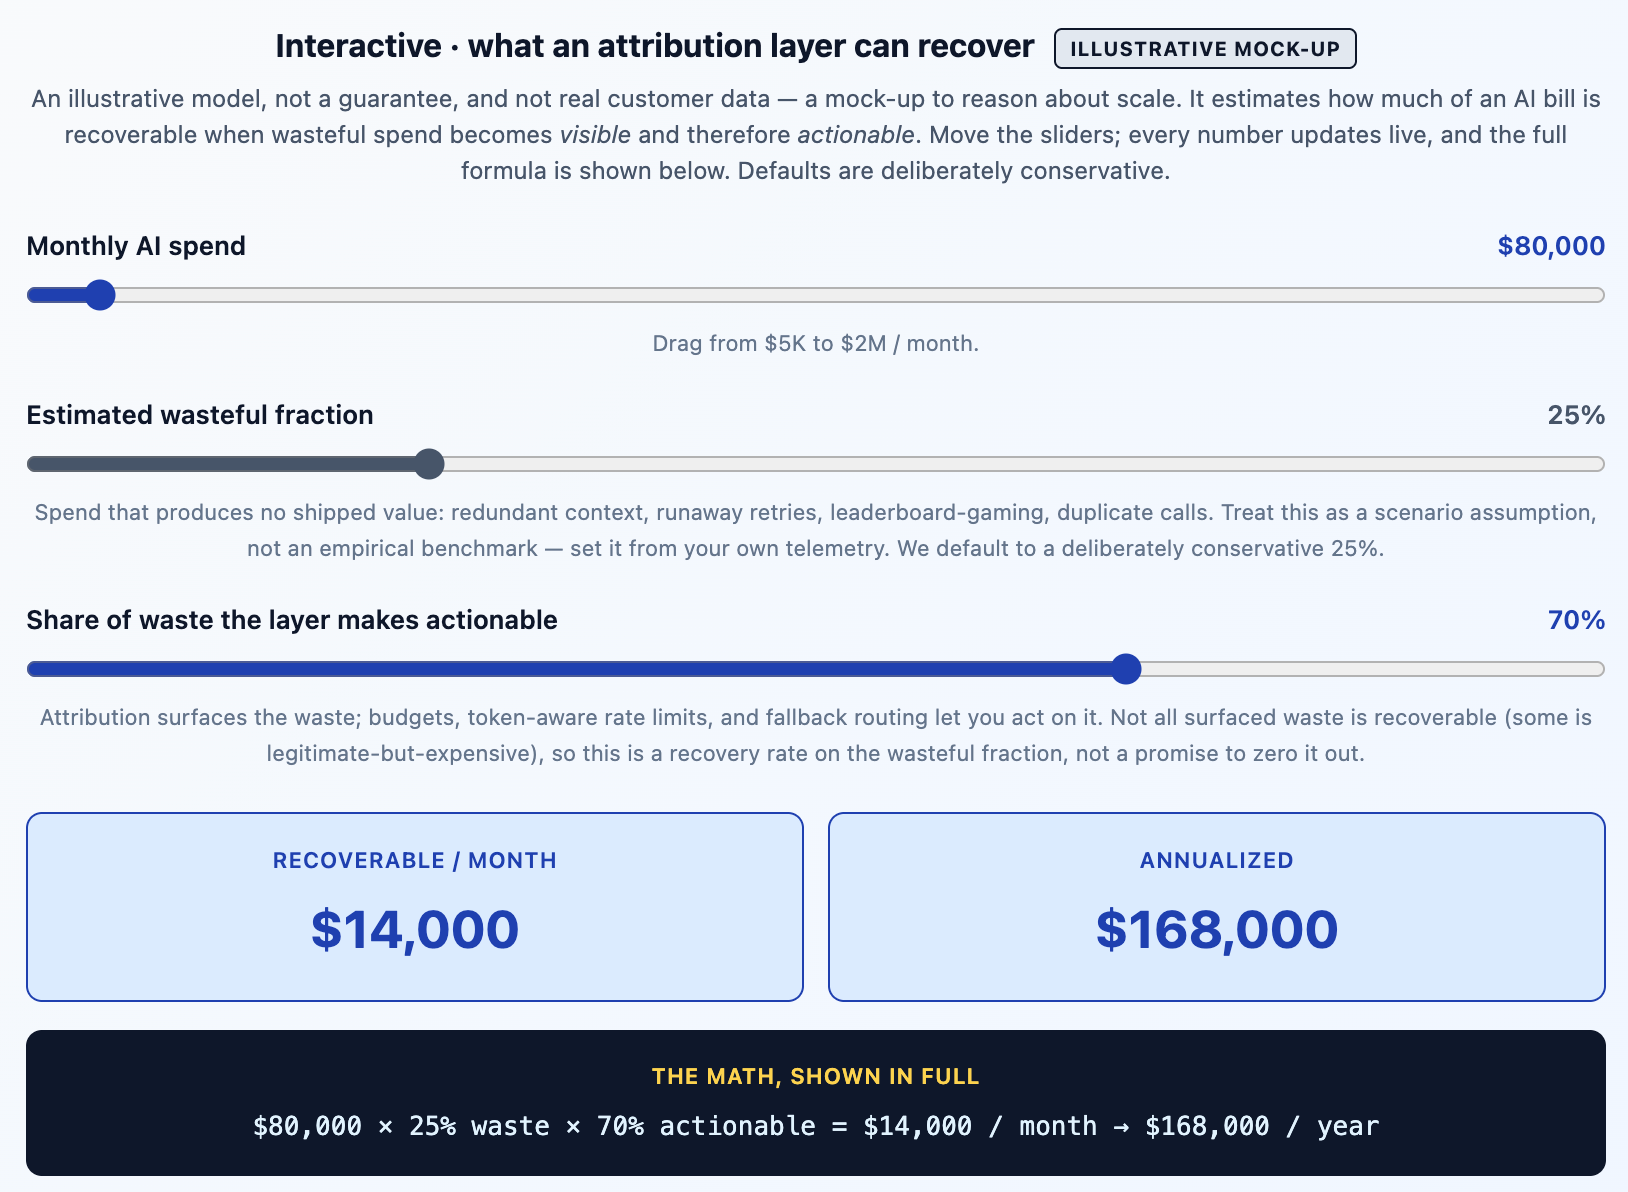
De reden dat het model is gebouwd op "verspillende fractie" in plaats van een vast percentage aan besparing, is dat dit de eerlijke vorm van het probleem is. Sommige AI-uitgaven zijn pure verspilling — een handleiding van 50.000 tokens die in elke prompt wordt ingevoegd, een loop die een kapotte afhankelijkheid opnieuw probeert, taken die louter worden uitgevoerd om op een leaderboard te klimmen. Sommige zijn legitiem en duur en moeten met rust worden gelaten. De waarde van een attributielaag is dat deze de twee van elkaar onderscheidt — en de budgetten, rate limits en fallbacks stellen u vervolgens in staat de verspilling nauwkeurig te verminderen — wat precies is wat een algemeen plafond niet kan doen. Het terugwinbare getal is elke fractie van de daadwerkelijk verspillende uitgaven die de gateway u duidelijk genoeg laat zien en nauwkeurig genoeg laat beheren om op te reageren.
Als de whipsaw iets leert, is het dat de governance-kloof niet dicht gaat — hij verplaatst zich. De volgende plek waar hij naartoe beweegt is loop engineering: de praktijk van medio 2026, genoemd in het essay van Addy Osmani en overgenomen door experts zoals Boris Cherny van Anthropic, van het ontwerpen van de systemen die uw agents prompten in plaats van ze handmatig te prompten. Een loop zoekt werk, draagt het over aan een agent, controleert het resultaat, legt de status vast en beslist wat de volgende stap is — onbeheerd, volgens een schema. Het is een echte vooruitgang in het vakgebied, en het heeft precies de eigenschap die leidde tot tokenmaxxing: er is geen mens in de kostenloop.
De tweedelige verhandeling van TrueFoundry over dit onderwerp — Loop Engineering at Enterprise Grade en het vervolg op vloot-schaal — begint met het canonieke incident: de ochtendloop van een engineer probeert gedurende een weekend twee dagen lang enthousiast opnieuw verbinding te maken met een kapotte testomgeving, en de kosten worden ontdekt op de factuur. Dat is de tokenrekening van het weekend, één niveau hoger in de stack vergeleken met het individuele leaderboard. En de voorspelbare institutionele reactie, wanneer genoeg van die rekeningen binnenkomen, zal de loop-engineeringvariant van tokenminimizing zijn: verbied onbeheerde loops. Het zal net zo bot en net zo kostbaar zijn als het tokenplafond, om dezelfde reden — een algemeen verbod kan de loop die echte fixes levert niet onderscheiden van de loop die geld verbrandt tegen een kapotte afhankelijkheid.
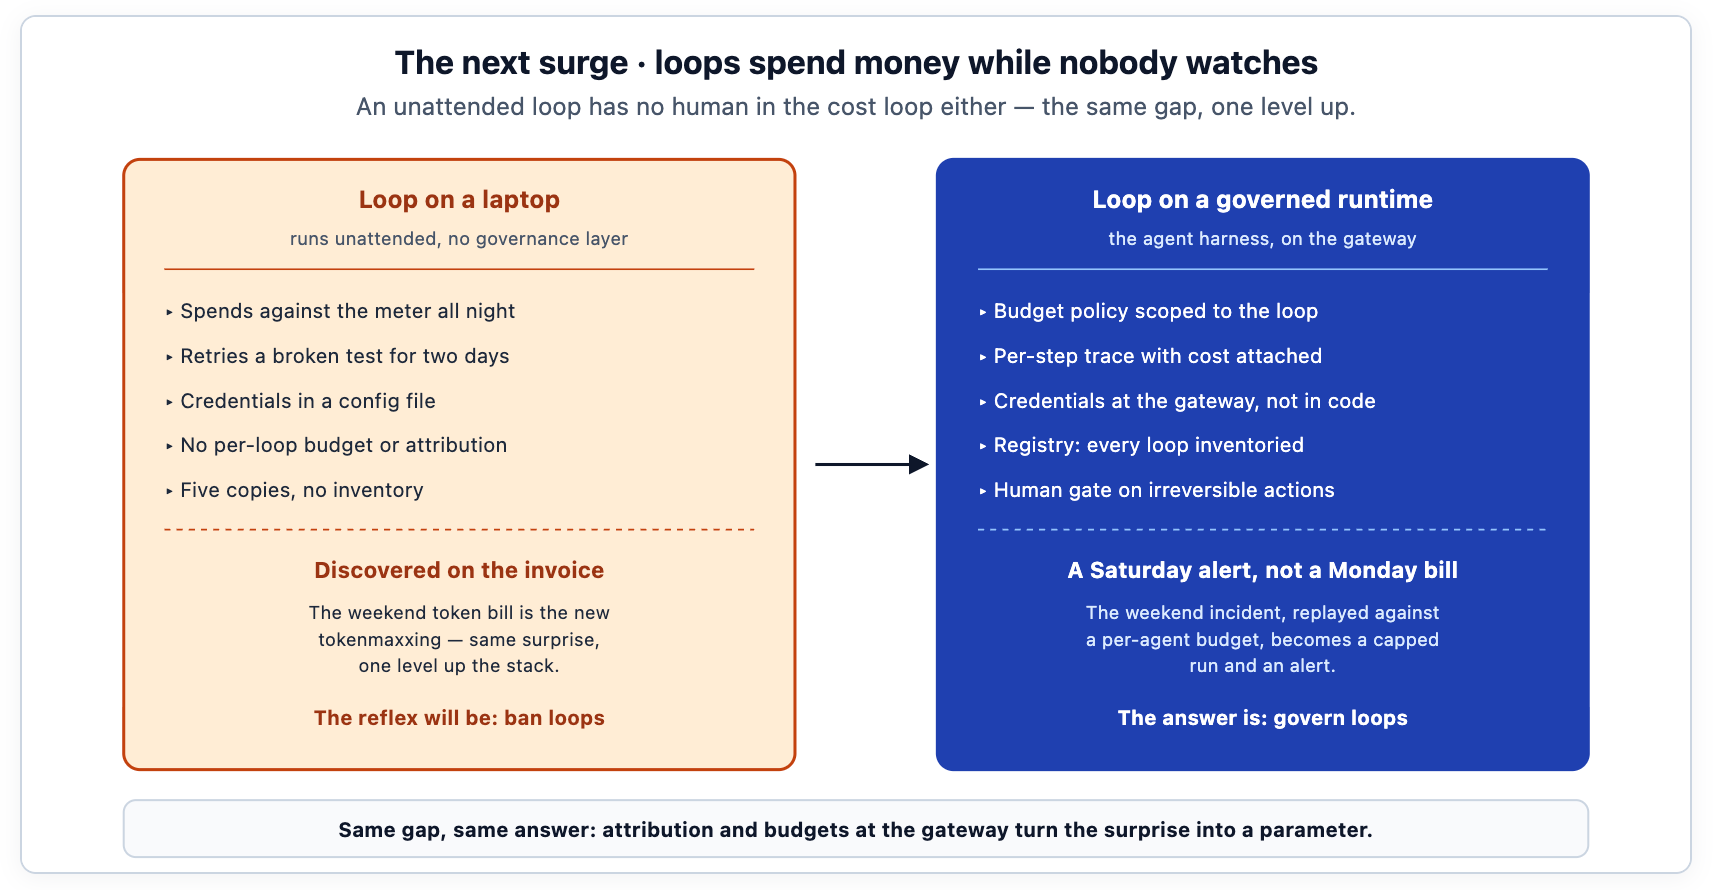
Het antwoord is hetzelfde antwoord, één niveau hoger toegepast. Plaats de loop op een beheerde runtime — TrueFoundry's Agent Harness, gebouwd op de AI Gateway en MCP Gateway — waar de loop draait als een geregistreerde agent met een eigen identiteit, een budget- en rate-limit-beleid afgestemd op die identiteit, en een trace per stap die kosten koppelt aan elke model- en tool-call. Het weekend-incident, opnieuw afgespeeld tegen een budget per agent, wordt een begrenzerun en een melding op zaterdagavond in plaats van een factuur op maandagochtend. De economische feiten van elke loop zijn een regelitem, geen restpost op de factuur van de provider, dus "is deze loop het waard?" wordt een dashboardvergelijking in plaats van een discussie. De harness voegt de besturingselementen toe die onbeheerde werking specifiek vereist: human-in-the-loop-gates bij onomkeerbare acties, guardrails bij elke model- en tool-call, en stopvoorwaarden — staplimieten en tokenbudgetten — die "draai tot voltooiing" veranderen in "draai tot voltooiing of totdat het budget zegt dat je moet stoppen."
Het structurele punt is het punt waar deze hele serie steeds op uitkomt. Loop engineering is in de eerste plaats geen kostenprobleem; het is een runtime- en governanceprobleem met een kostendimensie. Maar de kostendimensie is waar de les van tokenmaxxing het meest rechtstreeks van toepassing is: een loop zal, net als een engineer die door een leaderboard wordt gedreven, uitgeven wat hij mag uitgeven, en de enige duurzame manier om dat veilig te maken is om de uitgaven toe te wijzen en te begrenzen op de laag waar elke request doorheen gaat. Teams die dit hebben geleerd van de token-whipsaw kunnen het toepassen op loops voordat de loop-whipsaw hen overkomt.
Dit bericht is het bijvoegsel bij de trilogie; de trilogie is het argument waar het naar terugverwijst. In volgorde gelezen bouwen de drie delen de casus op die de whipsaw valideert.
Voor de toekomstgerichte lijn over loops zet de tweedelige serie over loop engineering — Loop Engineering at Enterprise Grade en het vervolg op vloot-schaal — hetzelfde argument voort naar onbeheerde agents, en de Agent Harness-documentatie is het productoppervlak eronder.
Dit is geen bewering dat tokenkosten er niet toe doen of dat bedrijven dom waren om ze te beheersen. Ze doen er enorm toe, en het beheersen ervan is juist. De kritiek is specifieker: het beheersen van kosten met een algemeen plafond, na het aanmoedigen van onbeperkt gebruik, is de tweede helft van een whipsaw die een governancelaag onnodig zou hebben gemaakt. Beide helften waren vermijdbaar.
Het is ook geen bewering dat de gateway van TrueFoundry, of welke gateway dan ook, een vervanging is voor beoordelingsvermogen. De eerlijke versie van het argument is dat de gateway verandert wat een organisatie kan zien en beheren — en dus welke goede beslissingen voor haar beschikbaar zijn — zonder die beslissingen automatisch te maken. Een team kan aan de knop draaien en deze nog steeds de verkeerde kant op draaien. De waarde zit in het überhaupt hebben van de knop, in een domein waar de meeste organisaties ontdekten dat ze alleen een schakelaar hadden.
En het is geen voorspelling dat loop engineering mis zal gaan. Het is een voorspelling dat loops onbeheerd geld zullen uitgeven, dat sommige organisaties dit op de factuur zullen ontdekken, en dat de organisaties die de les van de token-whipsaw vroeg toepassen — uitgaven toewijzen, budgetteren en begrenzen bij de gateway — de loop-engineeringvariant van dezelfde pijnlijke zwaai zullen overslaan. Het patroon is de constante. De laag is hetgeen dat het doorbreekt.
Kosten beheersen is verantwoordelijk; het beheersen met een algemeen plafond is de minst nauwkeurige manier om het te doen. Een plafond knijpt waardevolle en verspillende uitgaven in gelijke mate af, omdat er geen attributie achter zit om ze van elkaar te onderscheiden. De verantwoordelijke versie is om uitgaven per workload toe te wijzen en de curve te buigen waar de verspilling daadwerkelijk zit — wat het beheerde midden is, niet het minimaliserende uiterste. Minimaliseren is wat er overblijft als de attributielaag nooit is gebouwd.
Het centrale argument van de trilogie — dat tokengebruik een invoer is, dat een leaderboard dat mensen rangschikt op invoer het maximaliseren ervan beloont, en dat dit een correctie zou afdwingen — werd gepubliceerd tijdens de maxxing-fase, voordat de tokenminimizing-reactie begon. Het voorspelde niet de memo van een specifiek bedrijf; het maakte het structurele argument dat de verslaggeving nu illustreert. De observatie die aan Bosworth wordt toegeschreven in gepubliceerde artikelen — dat puur tokengebruik geen echte impact meet — leest als dat argument opnieuw geformuleerd door een CTO onder kostendruk. De eerlijke formulering is structureel inzicht vooraf, geen specifieke profetie.
Om dezelfde reden dat u observability koopt voordat u een oplossing koopt: u kunt niet beheren wat u niet kunt zien, en u kunt niet afstellen wat u niet kunt controleren. De gateway geeft een organisatie attributie, budgetten en een prognose — de instrumenten die goede kostenbeslissingen mogelijk maken. Het is de voorwaarde voor governance, geen vervanging voor de persoon die er eigenaar van is. Zonder de laag zijn de enige beschikbare instrumenten "aan" en "uit", en dat is hoe de whipsaw ontstaat.
Dat is de beste positie om in te verkeerden, en het goedkoopste moment om de laag te bouwen. Het argument van de trilogie is het meest waardevol als het vóór de maxxing-fase wordt gelezen, niet erna: installeer attributie en budgetten terwijl de uitgaven nog klein zijn, meet vanaf het begin output in plaats van invoer, en de whipsaw begint nooit. Een bedrijf dat het beheerde midden vroeg opbouwt, heeft simpelweg nooit de crisis die de zwaai afdwingt.
Het mechanisme is identiek: een systeem dat uitgeeft tegen de meter zonder dat er een mens meekijkt. Een door een leaderboard gedreven engineer en een onbeheerde loop zijn dezelfde kosten-governance-kloof op twee niveaus van de stack. Het geval van de loop is waarschijnlijk nog scherper, omdat een loop dagenlang een kapotte afhankelijkheid opnieuw kan proberen terwijl iedereen slaapt. De teams die loops beheren bij de gateway en de agent harness — budgetten en rate limits afgestemd op de identiteit van de loop, kostentraces per stap, stopvoorwaarden — krijgen de knop voordat ze hem nodig hebben. De teams die dat niet doen, zullen de loop-engineeringvariant van de tokenminimizing-memo tegenkomen.
Nee, en we willen hier heel precies in zijn. Volgens de verslaggeving heeft Meta zijn eigen interne dashboard gebouwd en dit "AI Gateway" genoemd — het is een afzonderlijk, intern gebouwd systeem dat toevallig dezelfde categorienaam deelt. We hebben geen informatie dat Meta TrueFoundry gebruikt, heeft geëvalueerd of ondersteunt, en we beweren dat ook niet. De reden dat we het detail opvallend vinden is convergent, niet commercieel: een bedrijf van de schaal van Meta, dat het maxxing-experiment heeft uitgevoerd, bouwt naar verluidt handmatig dezelfde categorie van systemen — realtime attributie, uitgavenregistratie, piekmeldingen, gestructureerde budgetten — die TrueFoundry als product levert. Die onafhankelijke convergentie is het bewijs dat de architectuur juist is, geen bewijs van enige relatie tussen de bedrijven.
Verslaggeving over de koerswijzigingen in het tokenbeleid (alle feitelijke beweringen over deze bedrijven in dit bericht zijn toegeschreven aan deze gepubliceerde verhalen; wij maken geen onafhankelijke beweringen daarbuiten):
Meta — Yahoo Finance / StockTwits, "Meta's AI Costs Spike — Company Reportedly Tightens Grip With New Tracking System" (vrij toegankelijk, de primaire bron die hier is gebruikt); The State of AI, "From Tokenmaxxing to Tokenminimizing"; MLQ, "Meta Caps Internal AI Token Spending." Het verhaal werd oorspronkelijk gemeld door The Information (Jyoti Mann; abonnement).
Amazon — TheStreet, "Amazon Joins Microsoft in Sending Shocking Message to Employees"; Human Resources Director, "Amazon Shuts Down AI Leaderboard After Tokenmaxxing" en "Amazon Workers Are Gaming the AI Leaderboard" (analyse van de wet van Goodhart). De sluiting van KiroRank werd oorspronkelijk gemeld door de Financial Times.
Uber — Business Insider, "The Tokenmaxxing Debate"; het detail over het opraken van het Uber-budget wordt ook vermeld in de Yahoo Finance- en TheStreet-artikelen hierboven.
De tokenmaxxing-trilogie (het argument waar dit bericht een bijvoegsel bij is):
Deel 1 — The Cost-Governance Gap. Deel 2 — The Architecture of Governed AI Usage. Deel 3 — From Token Spend to AI Leverage.
Loop engineering (de toekomstgerichte lijn): Loop Engineering at Enterprise Grade — From Laptop Loops to Governed Runtimes; Loop Engineering, Continued — From One Governed Loop to an Operable Fleet; en het oorspronkelijke community-essay, Addy Osmani, "Loop Engineering" (juni 2026).
TrueFoundry productdocumentatie (de configuraties en primitieven waarnaar in dit bericht wordt verwezen):
Platformoverzicht en architectuur — docs.truefoundry.com/introduction. AI Gateway — productpagina. Budget Limiting — configuratiereferentie. Rate Limiting — configuratiereferentie. Request Headers — het metadata- en headercontract. Cost Tracking — publieke en private prijsmodi. Agent Harness — de beheerde runtime voor onbeheerde loops.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















