October 24, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
モデルはベンチマークを通過しても、デプロイ後に損害を引き起こす可能性があります。誤った情報を提示したり、特定のグループに不利益を与えたり、承認されていない行動をとったりすることがあります。こうした結果は、必ずしも技術的な欠陥を示すものではありません。モデルは学習内容に従っているだけで、それに依存する人々を失望させている可能性があるのです。
AIセーフティは、学習された挙動と許容可能な運用成果との間のギャップを埋めるものです。システムを整合させつつ、人間による有意義な制御を維持します。この分野は、システムが自律性を高める中で有害な結果を制限する役割を担います。この実践的なAIセーフティの意義は、研究環境の枠を超えて広がっています。
現代のシステムは、すべてのステップを確認することなく、ツールの呼び出し、データベースの更新、業務の調整を行います。AIセーフティとは何かを理解するには、技術的、運用的、そして社会的な視点が必要です。企業チームには、責任ある意図を掲げるだけでなく、強制力のある制御が求められています。
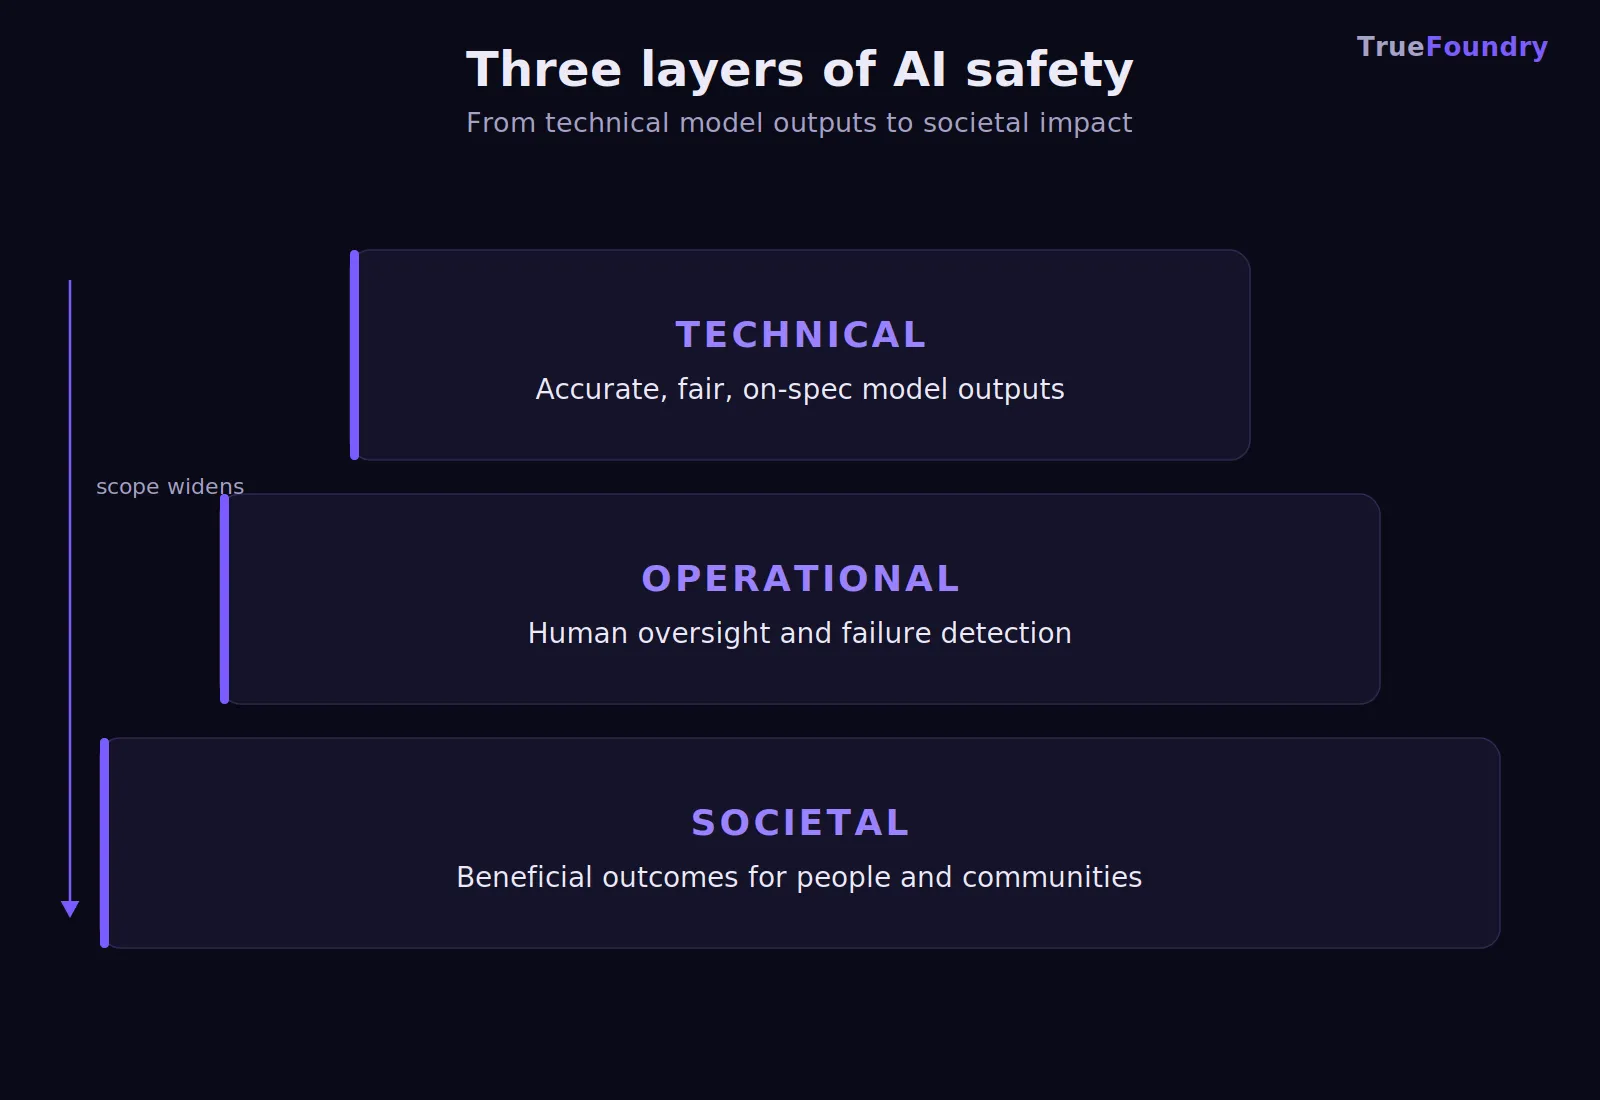
AIセーフティは、承認された目標と整合した信頼性の高いシステムの構築に焦点を当てた学際的な分野です。コンピュータサイエンス、社会科学、政策、運用ガバナンスにまたがる取り組みであり、AIの開発、デプロイ、監視、そして運用終了までの全工程に適用されます。
技術レイヤーでは、出力、公平性、正確性、耐障害性を検証します。運用レイヤーでは、チームが問題を迅速に検知できるかを問い、社会レイヤーでは人権やより広範な影響を考慮します。これらが組み合わさることで、エンタープライズAIセーフティの定義が形成されます。
AIセーフティの分野は、技術研究と政策を融合させたものです。 Future of Life Institute は、2017年のアシロマ会議においてAIガバナンスの原則を策定しました。これらの取り組みは、研究の方向性と倫理原則を形作る上で重要な役割を果たしました。
モデルが顧客、財務、インフラに影響を与えるようになると、セーフティは運用上の課題となります。AIセーフティの問題が重要視される理由は、システムが自律的に動作すること、障害が潜在化しやすいこと、そして規制により証拠が求められることの3点です。効果的なAIリスク管理には、これらすべてへの対応が不可欠です。
本番環境のエージェントは、ツールを呼び出し、データベースを読み取り、タスクを調整します。これらの人工知能システムは、人間が判断を確認する前にアクションを起こすことができます。セーフティが機能しなければ、その結果は本番環境でのインシデントとなります。オペレーターが迅速に対応する前に、顧客が被害を受ける可能性があるのです。
人工知能の役割拡大に伴い、許容される自律性の基準も変化しています。自然言語処理アプリケーションは、大規模な意思決定に影響を与える可能性があります。同様の懸念は、ビデオゲーム、コンテンツモデレーション、人物画像分類システムなどにも存在します。エラーが企業運営において重大な結果をもたらすかどうかは、そのコンテキストによって決まります。
整合性の欠如は、当初はもっともらしい回答の中に隠れていることがよくあります。モデルは一貫性のある情報を提示しながら、実質的には誤っている可能性があります。また、未知の条件下で乖離する代理指標を最適化してしまうこともあります。このAIアライメント(整合性)の問題は、多くのやり取りを通じて見過ごされる可能性があります。
継続的な監視を行うことで、インシデントが拡大する前に微弱な兆候を特定できます。単一の回答には現れない障害もあるため、集計的な評価が重要です。リスクはセッション間や、変化する本番環境のワークロード全体にわたって発生します。強力な実証研究に基づき、チーム全体で改善を導く必要があります。
欧州連合(EU)の AI法 は、リスクベースのアプローチを採用しています。高リスクなシステムには、監視、堅牢性、文書化、およびライフサイクルモニタリングに関する要件が課されます。これらの義務は、安全基準と証拠、そして説明責任を伴う所有権を結びつけるものです。また、規制対象となるアプリケーション全体において、基本的人権を保護する役割も果たします。
NISTの AIリスクマネジメントフレームワーク は、信頼性を高めるための自主的な取り組みを支援するものです。米国国立標準技術研究所(NIST)は、ガバナンス、マッピング、測定、管理といった活動を体系化しています。このリスクマネジメントフレームワークは、ポリシーと反復可能な管理策を結びつけるものです。
国際的な協力体制は、今日のAIガバナンスに影響を与えています。 国際連合 は、議論のためのグローバルな場を提供しています。米国は連邦レベルでの試験と標準化を推進しています。組織は、AIの進展を倫理ガイドラインや各セクターの義務と照らし合わせてマッピングする必要があります。
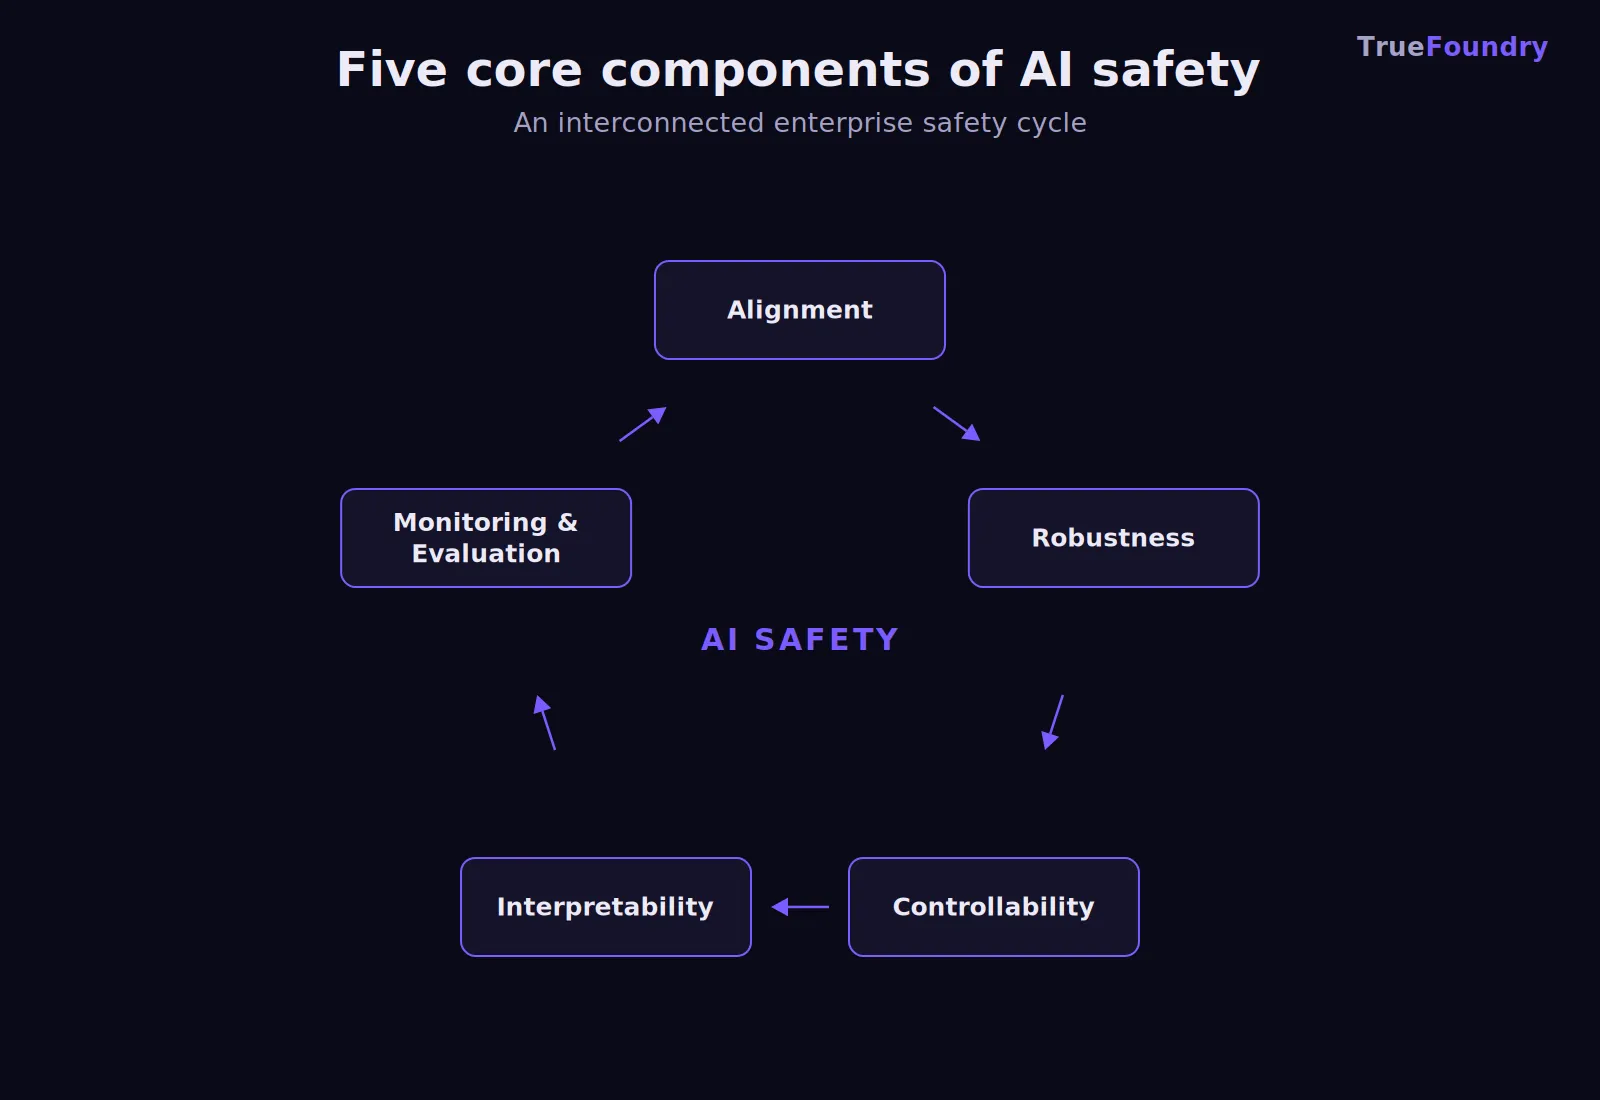
AIの安全性とは何かを理解するには、その構成要素を分解するのが近道です。エンタープライズシステムにおいて信頼性の高い動作を実現するためには、5つの規律が重要となります。アライメントは成果を定義し、堅牢性は変化する条件下でのテストを担います。制御性、解釈可能性、そしてモニタリングは、デプロイ後の可視性を維持するために不可欠です。
アライメントとは、AIモデルが人間の意図通りに最適化されているかを問うものです。アライメントの不一致は、必ずしも悪意や敵対的な意図によるものとは限りません。デプロイ中に未知の状況に直面すると、目的が本来の意図から逸脱することがあります。システムが技術的には成功していても、受け入れがたい結果をもたらす可能性があるのです。
堅牢性とは、状況が変化しても動作が安定しているかを測定するものです。実際のトラフィックは、管理された評価用データセットとは異なることがほとんどです。ユーザーは予期せぬ方法でリクエストを行い、データの分布は変化し、エッジケースも蓄積されます。効果的なAI安全対策には、デプロイ後の継続的なテストが不可欠です。
制御性とは、本番環境において人間による監視を実用的なものにするためのものです。チームは活動内容を把握し、逸脱を遮断し、有害な実行を停止できなければなりません。モデルの呼び出しには明確なログとエスカレーションルールが必要です。エージェントには、意思決定、ツール呼び出し、再試行、アクションに至るまでの追跡記録が求められます。
解釈可能性とは、どの入力が重要な出力に影響を与えたかを問うものです。多くの大規模言語モデルやディープラーニングモデルにおいて、完全な説明を得ることは依然として困難です。実用的なモデルの解釈可能性とは、調査に十分なコンテキストを明らかにすることを目指すべきです。チームは、現在の能力の限界を過大評価することなく、証拠を提示する必要があります。
モニタリングを行うことで、本番環境へのリリース後もすべてのコンポーネントの責任の所在を明確にできます。チームは、セッション全体を通じて応答と挙動を評価・集約しなければなりません。指標には、精度、バイアス、ドリフト、拒否挙動、ポリシー遵守状況を含める必要があります。このプロセスにより、安全対策が本番環境で監視可能な制御へと変わります。
2026年国際 AI安全性レポート は、AIの能力、リスク、および緩和策を検証するものです。その研究成果は、技術的なセーフガードにおける限界を明らかにしています。すべてのAI安全性レポートは、文脈に応じた評価に取って代わるものではなく、意思決定の判断材料として活用されるべきです。セーフガードは失敗する可能性があるため、多層的な制御が不可欠です。
ここで議論した内容は、本番環境にあるあらゆるAIシステムに適用されます。エージェントは、不適切な判断が現実の行動につながるため、リスクを増大させます。言語モデル向けの静的な制御では、実行チェーンを管理することはできません。AIシステムを導入する際は、自律性がエンタープライズツールにまで及ぶ場合に備えたセーフガードが必要です。
現代のエージェント型ワークロードにおいて、特に重要な3つの機能があります。
これらの制御を組み合わせることで、エージェントの安全性は単なるポリシー目標から、強制力のある本番環境のガバナンスへと変わります。TrueFoundryの Agent Gateway は、ワークフロー全体でポリシー、RBAC、トレーサビリティを強制します。当社の MCP Gateway は、ツールを管理し、スコープ設定されたIDを伝播させます。これらの制御は、将来のAIシステムが自律性を拡大させつつも、説明責任を維持する一助となります。
規制対象となる企業にとってのAI安全性とは、その文脈と影響に依存します。EU AI法は、カテゴリーごとにリスクベースの義務を課しています。システムが安全性や基本的人権に影響を与える場合、要件は厳格化されます。そのため、スパムフィルターと与信システムでは、それぞれ異なる制御が必要となります。
組織は、規制と自社の環境に適したAIリスク管理フレームワークを組み合わせるべきです。NISTは、測定可能なリスク管理慣行の基盤の一つを提供しています。社内のベストプラクティスには、オーナーシップ、テスト、モニタリング、対応を含める必要があります。管理策は、各システムの影響度と潜在的な脅威を反映したものであるべきです。
ヘルスケア、金融、雇用といった分野でのAI活用は、それぞれ異なるリスクを伴います。フェイクニュースの検出やソーシャルメディアのモデレーションにAIを使用する場合、公平性の問題が生じます。個人データを扱うシステムには、一貫してより厳格なレビュー管理が必要です。リスクの階層に応じて、評価の深さと人間による監視レベルを決定すべきです。
原則だけでは、分散システム全体で安全性を強制することはできません。 TrueFoundry は、モデル、エージェント、ツールの相互作用全体にわたって要件を管理策へと変換します。当社のエンタープライズ向け AIゲートウェイ は、ポリシー、ガードレール、アクセス権限、および可観測性を顧客のインフラストラクチャ内で一元管理します。これにより、すべてのモデルプロバイダーに対して一貫した強制が可能になります。
LLMゲートウェイは、プロバイダーやセルフホスト型モデル全体で管理策を標準化します。チームはこれを以下と組み合わせることができます。 AIガバナンスのベストプラクティスこのインフラストラクチャは、適切な監視体制を維持しながら生成AIアプリケーションをサポートします。業界のリーダーが、あらゆる環境でポリシーを運用可能にするための支援を行います。
AI安全性に関する広範な研究アジェンダでは、AIの未来が検討されています。汎用人工知能(AGI)や存在リスクを研究する専門家もいれば、展開済みシステムにおける差し迫った障害に焦点を当てる専門家もいます。企業は、こうした関連性の高い安全性研究を、測定可能な管理策へと落とし込む必要があります。
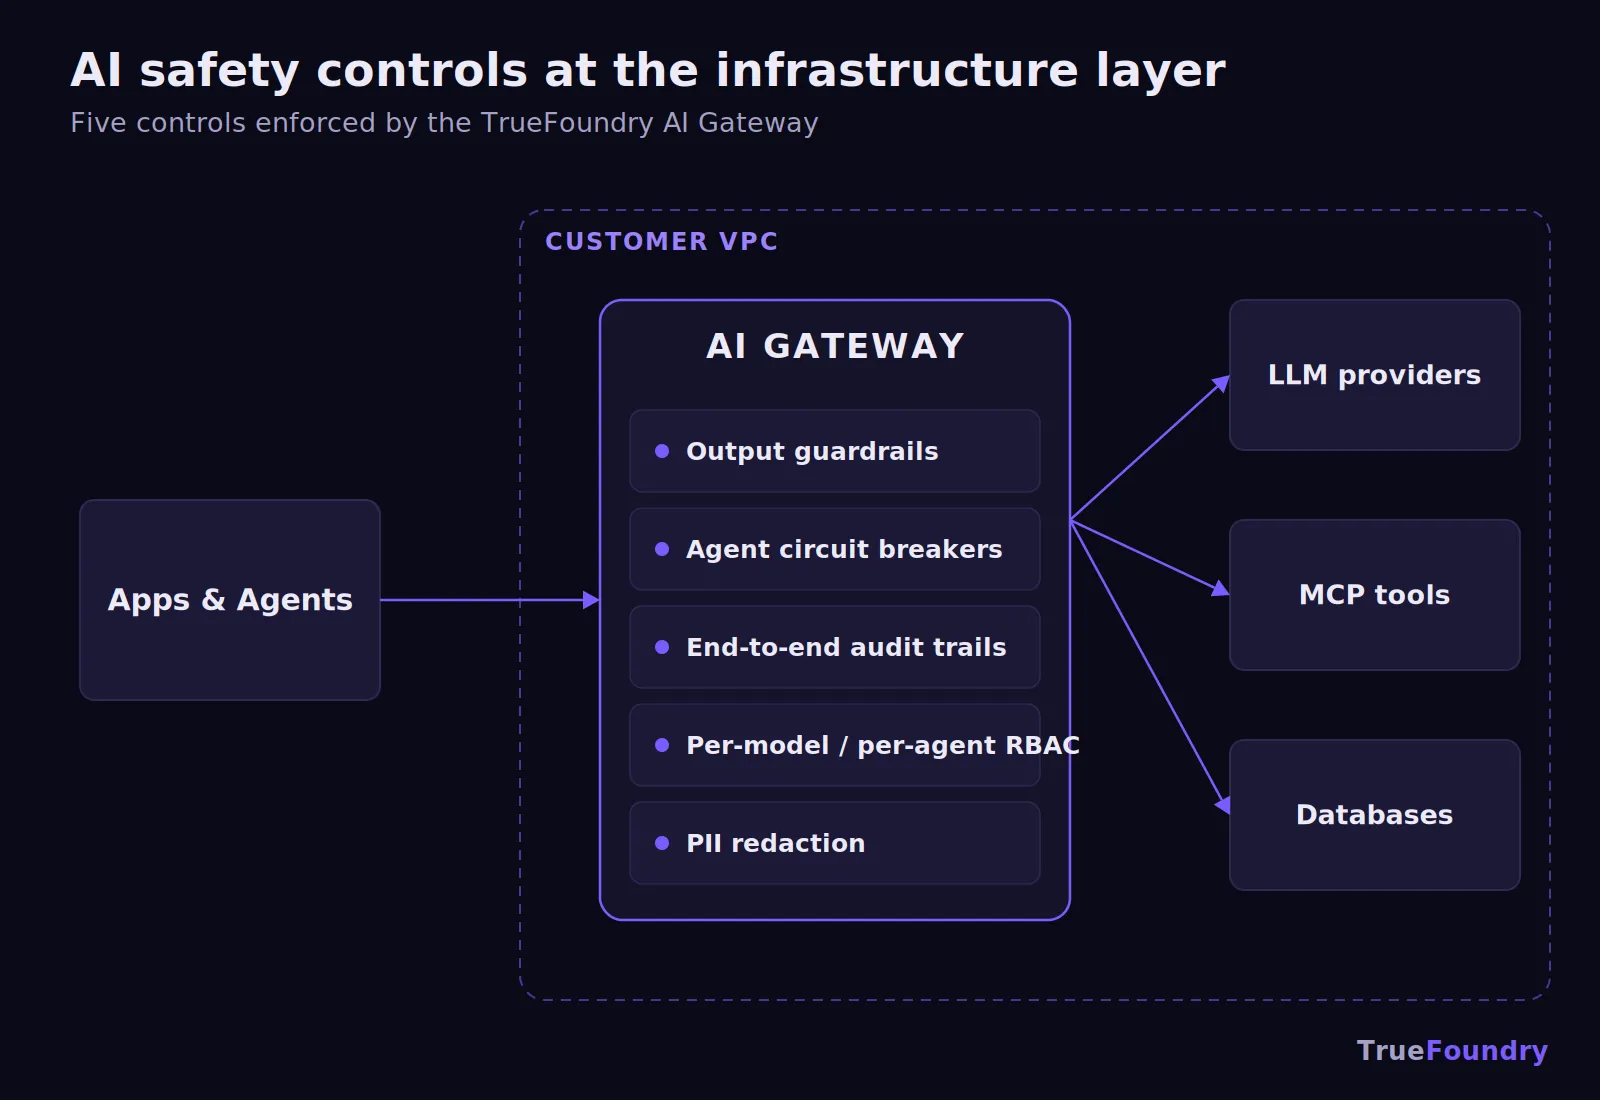
貴社のアーキテクチャでこれらの管理策を検証してみませんか? デモを予約する 本日、ガイド付きレビューをご利用いただけます。モデル、エージェント、ツール、ID、トレースに関する議論が可能です。チームは自律型ワークロードを拡大する前に、ギャップを特定することができます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.