October 24, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
NVIDIA A10(24 GB)GPU 1基を搭載した環境で、8Bパラメータモデル3種(Qwen3-8B、Llama 3.1 8B Instruct、Ministral 8B)に対し、GuideLLMを用いて同時実行数のスイープテストを行いました。このvLLMベンチマークでは、短文チャットと意図分類という2つのワークロードを用い、同時ユーザー数を4から256まで変化させました。その結果、全範囲で安定して動作したモデルは1つだけで、他の2つはそうではありませんでした。
3つのモデルすべてでvLLM上のFP16を使用し、標準の /v1/chat/completions ストリーミングエンドポイント経由で提供しました。GuideLLMは、各同時実行レベル(4、8、16、32、64、128、256)で90秒間、正確にN個のリクエストを処理し、レベル間には30秒のクールダウン時間を設けました。
2つのワークロード:
vLLMのバージョン、ゲートウェイ設定、GPUはすべて3モデル共通です。以下の結果は、これらの条件下での測定値です。
要約表では、短文チャットの比較に同時ユーザー数64を使用しています。これはLlamaがエラーなし(0%)で動作した最後の同時実行レベルであり、3モデルすべてを比較する上で最も公平な基準となるためです。
Qwen3は、標準的な待ち時間(p50で524ms)が最も短く、テールレイテンシ(p95で2,840ms)も最も安定しています。Llamaは1秒あたりのトークン生成数が11%多いものの、最初のトークンまでの待ち時間(TTFT)の中央値は2,569msで、Qwen3の524msと比較して大幅に長くなっています。データから際立っていたのは、LlamaのE2E p95(10.4秒)がQwen3(11.4秒)よりも低いという点です。TTFTは非常に遅いものの、一度生成が始まればQwen3よりも高速にデコードされます。ただし、ストリーミングUIにおいては、ユーザーが実際に体感するのは最初のトークンまでの遅延です。
各同時実行レベルでの詳細なパーセンタイル内訳、ポアソンバーストトラフィックの結果、およびダウンロード可能なCSVデータは、インタラクティブなベンチマーク レポートをご覧ください。
低負荷時には、3モデルともTTFTの中央値(p50)は約350msでほぼ同等でした。Qwen3はその数値を維持し、同時ユーザー数16の時点でもp50は388msでした。一方、Llamaはすでに794msまで上昇していました。
Qwen3は、同時実行数256までのすべてのリクエストを完了させました。リクエストのドロップはゼロです。同時実行数64におけるTTFT(最初のトークンまでの時間)のp50は524ms、スループットは851トークン/秒でした。
高負荷下でも安定している理由についての我々の仮説は以下の通りです。Qwen3はQK-LayerNormを採用しており、長いKVキャッシュ下でもアテンションスコアが安定します。また、レイヤーごとのKVフットプリントがわずかに小さいため、ゲートウェイでリクエストが滞留する前に、vLLMのスケジューリングに余裕が生まれます。LlamaはFFNがより大きく(Qwen3の12,288に対し14,336)、トークンあたりのスループットは高くなりますが、デコードパイプラインがすぐに埋まってしまい、同時実行数が増加した際に新しいプリフィル(prefill)のための余地が少なくなります。現在も調査中ですが、アーキテクチャの違いがここで影響しているようです。
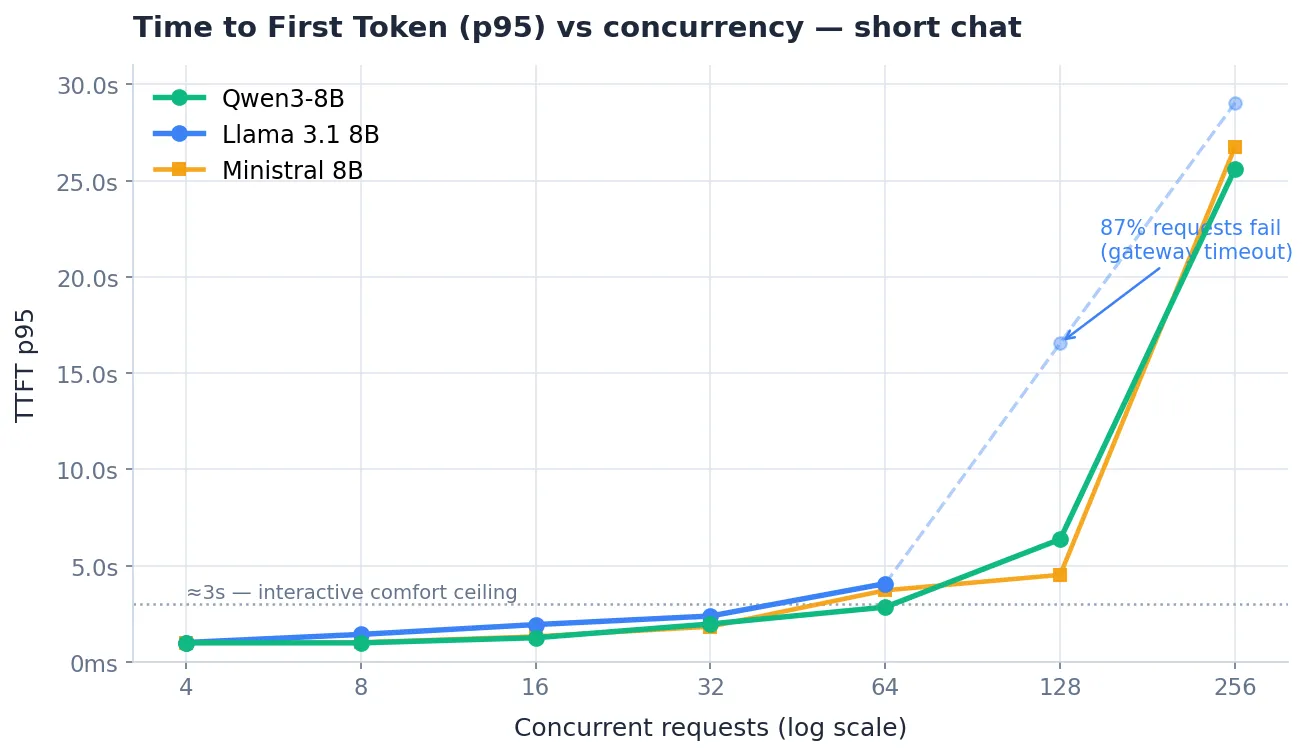
Llamaはピーク時に1,181トークン/秒という最高の生スループットを記録しました(同時実行数256)。しかし、同時実行数128では、リクエストの86.9%が408エラー(タイムアウト)となりました。1,181トークン/秒という数値は、サーバーがキューの大部分を破棄した後に、かろうじて処理された少数のリクエストによるものです。
同時実行数64(正常に動作した最後の地点)において、Llamaは947トークン/秒のスループットを記録し、TTFTのp95は4,062ms、エラー率は0%でした。これは同負荷下でのQwen3より11%高いスループットです。バッチ推論や再試行が許容される非同期パイプラインでは、このスループットの優位性は本物です。インタラクティブな用途であれば、同時実行数は32〜64に制限すべきでしょう。
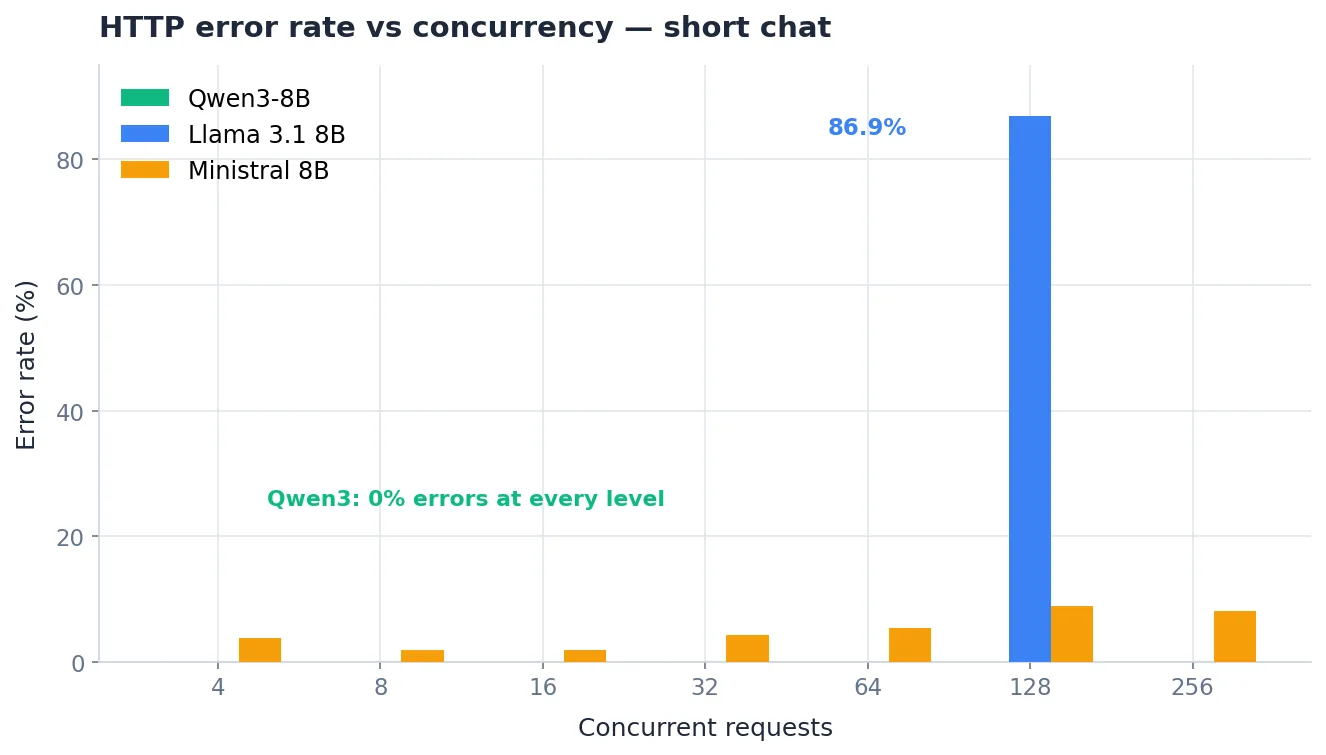
この点は正直に報告しなければなりません。Ministralは、テストした中で最も負荷の低い同時実行数4の時点で、3.8%のHTTPエラーを示しました。同時実行数64では5.3%、128では8.9%に達しました。これらはベンチマークの不具合ではなく、実際の408/503エラーです。これはモデルの根本的な制限というよりは、テスト期間中のデプロイ環境の不安定さを反映している可能性が高いですが、データはデータとして提示します。
リクエストが成功した場合、Ministralのレイテンシは競争力のあるものでした。ベースラインでのTTFT p50は350ms、同時実行数64では512msで、Qwen3の524msに近い値です。しかし、約20回に1回のリクエストが応答を返さないのであれば、レイテンシの数値に大きな意味はありません。
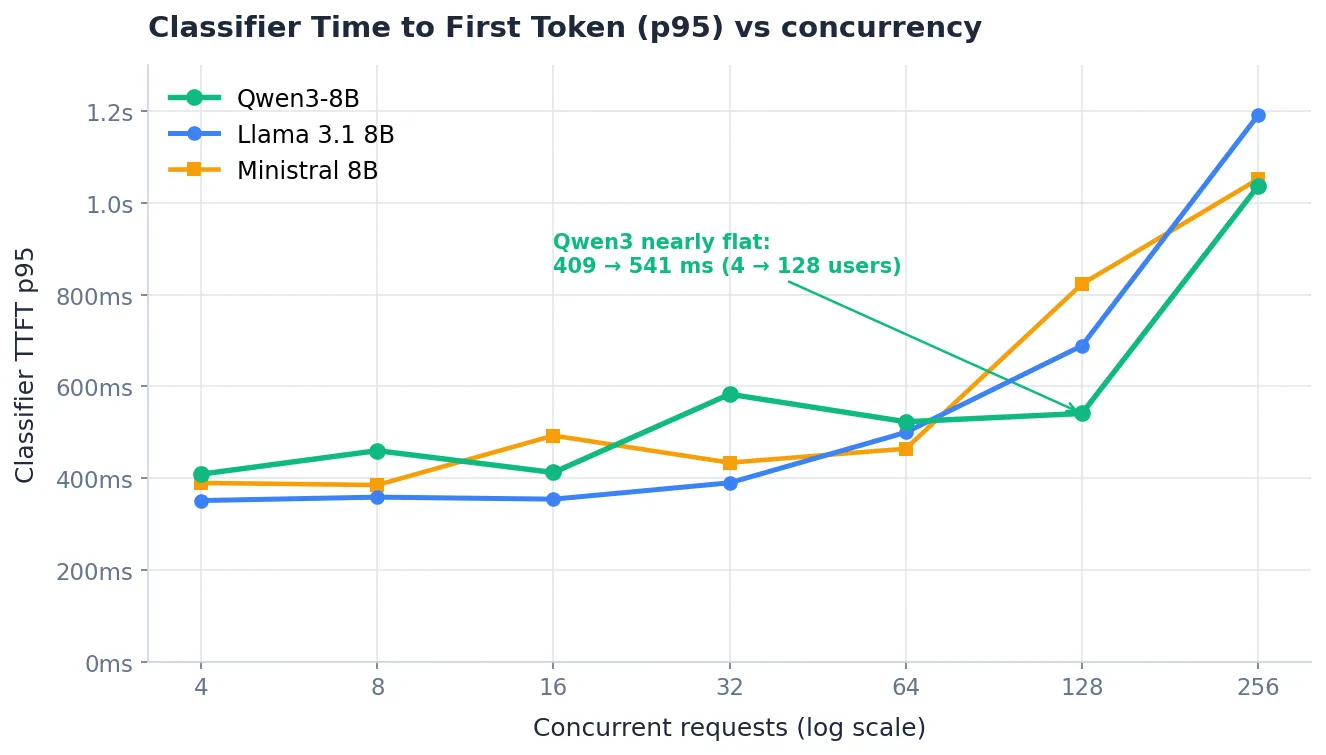
分類タスクのワークロードでは、3モデルすべてが同時実行数256までエラーゼロで正常に動作しました。秒間リクエスト数(RPS)ではLlamaが173でトップ、次いでQwen3が157、Ministralが143となりました。
より重要なのは、負荷がかかった際にレイテンシがどれだけ変動したかです。同時実行数128におけるQwen3のTTFT p95は541msで、ベースラインの409msから32%の増加に留まりました。p50は358msから467msへの変化です。一方、Llamaのp95はほぼ倍増(351msから689ms)し、Ministralは2倍以上(390msから823ms)に跳ね上がりました。
バースト的なトラフィック下でも予測可能なレイテンシを維持するインテントルーターや分類器が必要な場合、Qwen3のフラットな曲線は注目に値します。GPUが短い分類リクエストをキューイングなしで単一のバッチに吸収しており、それが数値に表れています。
3モデルとも同じ地点からスタートし、同時実行数16までは線形にスケールします。それ以降、差が開き始めます。
64を超えると、Llamaのスループットは理論上上昇し続けますが(256で1,181トークン/秒)、リクエストの大部分は拒否されています。Qwen3は830〜850トークン/秒付近でプラトー(横ばい)に達し、すべてのリクエストを処理しています。Ministralは、成功したリクエストのみを比較しても、同時実行数64でQwen3に約15%及びません。
エラー率を伴わない生のピーク数値は、キャパシティプランニングにおいてはほとんど無意味です。これら3つのvLLMベンチマークは、そのことを如実に示しています。

今回のvLLMベンチマークは、TrueFoundry経由でデプロイした単一のA10スポットインスタンスで実施しました。詳細なvLLM設定とGuideLLMコマンドは、後日公開する詳細記事で紹介します。
TrueFoundryのモデルサービング層は、コントロールプレーンから直接、あらゆるGPUティア(A10、A100、H100)上でvLLMバックエンドをデプロイします。モデルを選択し、max_model_lenとtensor_parallel_sizeを設定するだけで、TrueFoundryがコンテナ、GPU割り当て、ヘルスチェックを自動的に管理します。モデルは標準的なOpenAI互換エンドポイントで利用可能になります。
vLLMの前段に配置されるTrueFoundryの AI Gateway は、単一のvCPU上で350 RPS以上を処理しながら、わずか3〜4ミリ秒のオーバーヘッドしか追加しません。モデルごとのレート制限、コスト配分、プロバイダー間でのフォールバックルーティング、完全なリクエストトレース機能を提供します。今回のベンチマークのように複数のモデルを比較する場合、すべてを同じゲートウェイエンドポイント経由でルーティングし、リクエスト内のモデルフィールドを変更するだけで切り替えが可能です。URLや認証情報を変更する必要はありません。
TrueFoundryは単一のOpenAI互換APIを通じて1,000以上のLLMをサポートしているため、ベンチマーク済みのオープンウェイトモデルから商用プロバイダーへ移行する際も、クライアント側の変更は一切不要です。
ゲートウェイの背後でオープンウェイトモデルをセルフホストするチームにとって、このアーキテクチャはサービング層とルーティング・ガバナンス層を分離して維持できます。vLLMデプロイ後の監視については、 2026年版 LLMオブザーバビリティツール ベスト10 をご覧ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




A vLLM benchmark measures how a model served via vLLM performs under concurrent load. The key metrics are time to first token (TTFT), end-to-end latency, token throughput, and error rates at different concurrency levels. The most useful vLLM benchmarks sweep from low to high concurrency to find the point where performance degrades or requests start failing, since peak throughput numbers without error rates are misleading.
In this benchmark, Qwen3-8B was the only model to complete every request at every concurrency level through 256 concurrent users with zero errors. Llama 3.1 8B was clean through 64 concurrent but hit 87% error rates at 128. Ministral 8B had persistent errors starting at concurrency 4.
Based on this vLLM performance benchmark, 64 concurrent users is the last clean operating point for Llama 3.1 8B on a 24 GB A10. At 128 concurrent, 87% of requests fail with gateway timeouts. For interactive workloads, stay at or below 64. For batch jobs with retry logic, you can push higher.
はい。TrueFoundryは、お客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境、あるいはマルチクラウド環境で動作し、データがドメイン外に出ることはありません。これが、規制の厳しい企業がSaaS専用ゲートウェイではなくTrueFoundryを選択する最大の理由です。
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.