



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
単一エージェントシステムはモデルやツールを呼び出します。マルチエージェントシステムは、それに加えて「エージェントが他のエージェントを呼び出す」という新しい要素をもたらします。オーケストレーターがサブエージェントにタスクを委任したり、誕生して間もない Agent2Agent プロトコルを介してエージェント間で作業を引き継ぎ合ったりする、このようなイースト-ウェスト(東西)トラフィックは、コストの急増、ブラストライディウス(影響範囲)の拡大、「どのエージェントが何を実行したのか」が特定不能になる原因となります。各プロトコルは、エージェントが相互に検出して作業を交換する方法を標準化し、セキュリティフックを提供しますが、企業固有の ID モデル、ポリシーグラフ、予算モデル、あるいは可観測性(Observability)とコントロールプレーンまでは規定していません。本記事では、このガバナンス層について、そしてなぜそれがゲートウェイに属するのかを解説します。
プラットフォームエンジニアの Tomás は、出社早々コストアラートと不可解な現象に見舞われました。一晩のうちに、会社の新しいマルチエージェント調査ワークフローが前月全体の支出を超えるコストを消費していたのです。オーケストレーターエージェントがサブエージェント群にサブタスクを委任した際、あるサブエージェントが一時的なエラーに遭遇してオーケストレーターを再呼び出ししてリトライし、オーケストレーターが再び委任を行うというループが数時間にわたって発生していました。朝までに、エージェント同士の呼び出し回数は数万回に達していました。Tomás はどのエージェントがそれを開始し、どこでサイクルが形成されたかを確認しようとしましたが、不可能であることが分かりました。すべてのエージェントが同じ共有サービスキーで認証されており、エージェント間の呼び出しはグラフとして記録されておらず、トリガーとなるエージェントごとのレート制限も存在しなかったためです。システムにはモデルプロバイダーへの呼び出しに対するガバナンスはありましたが、自身のエージェント間の呼び出しに対するガバナンスはほぼ存在していませんでした。
これが、マルチエージェントシステムによって生じるギャップです。エージェントが相互に委任を開始した瞬間、新しい内部ネットワークが誕生します。このネットワークには、デフォルトで ID も、ポリシーも、トレースも存在しません。エージェントフレームワークはワークフローの構築を支援しますが、そのガバナンスまでは担いません。本記事では、マイクロサービスメッシュの運用において不可欠とされる ID、制限、可観測性と同等の機能を、この内部ネットワークに適用する方法について説明します。
これまでのゲートウェイにおけるトラフィックの大部分はノース-サウス型(アプリケーションがツールなどを経由してモデルを呼び出す形態)でした。マルチエージェントシステムは、そこにイースト-ウェスト型(エージェントが他のエージェントを呼び出す形態)のトラフィックを追加します。オーケストレーターが専門エージェントに委任し、専門エージェントが別のエージェントに相談し、その結果が上位に返却されます。発展途上にある Agent2Agent(A2A) プロトコルはこれに標準的な構造を与えます。MCP がエージェントによるツールへのアクセス方法を標準化したのと同様に、エージェントが他から検索可能な機能記述(エージェントカード)を公開し、共通インターフェース上でタスクやメッセージを交換できるようにします。
ここで念頭に置くべきアナロジーは、モノリスからマイクロサービスへの移行です。エージェント同士が会話を始めた瞬間、連鎖的なリトライ、サイクル、ファンアウトの増幅、単一で明確なコールスタックの消失といった、分散システム特有の障害モードを持つ分散システムが形成されます。そしてマイクロサービスと同様に、解決策は呼び出しを無くそうとすることではなく、すべての呼び出し元に ID を付与し、すべての呼び出しにポリシーを適用し、すべてのフローにトレースを付与するレイヤーの背後にそれらを配置することです。エージェントにとってのそのレイヤーこそが、agent gateway です。
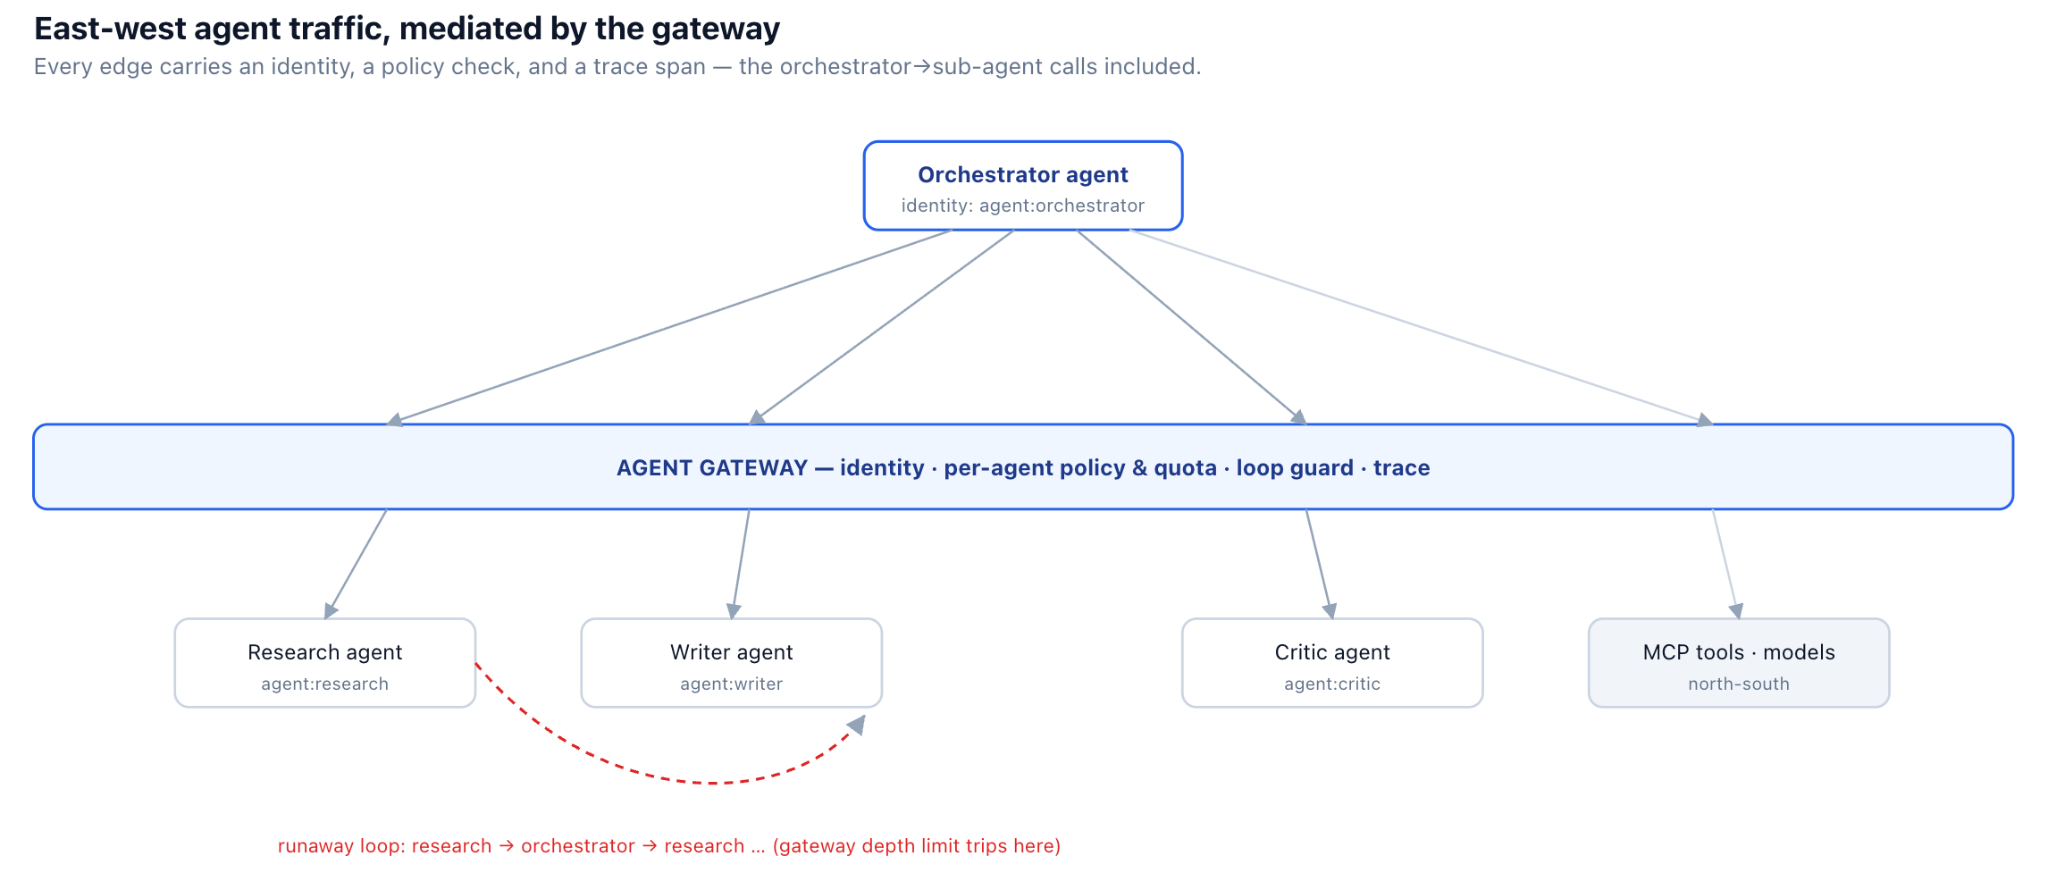
Tomás の根本的な問題は ID にありました。すべてのエージェントが 1 つの共有サービスキーで認証を行うと、システムはそれぞれのエージェントを区別できなくなります。つまり、エージェントごとに異なる認可を行ったり、コストを個別に帰属させたり、どのエージェントがどのようなアクションを起こしたかを再構築したりすることができなくなります。
解決策は、各エージェントに独自の ID を付与し、ゲートウェイで発行および検証を行って、エージェントがモデル、ツール、または別のエージェントに対して行うすべての呼び出しでそれを伝播させることです。この ID は、後続のあらゆる制御(認可の決定、レート制限、コストの帰属、トレースの帰属)の軸となる「どのエージェントか」を特定するための基礎となります。
各エージェントはすべてのホップで独自の ID を保持(概念図)
TrueFoundry の Agent Gateway で ID 管理を中央集約化(ゲートウェイレイヤーでエージェントの認証、ID、およびサービスアカウント管理を実施)することにより、各エージェントフレームワークが独自のスキームを個別に開発することなく、ID が一度確立され、ダウンストリーム全体で信頼されるようになります。エージェント ID と並行して人間であるプリンシパル(ワークフローの実行を依頼したエンドユーザー)を保持することにより、3 段階の委任が行われた後でもエンドユーザーの認可と監査可能性がそのまま維持されます。
ID は認可を可能にし、マルチエージェントシステムでは具体的な問い合わせへの回答を可能にします。リサーチエージェントはライターエージェントを呼び出せるのか、それともオーケストレーターのみが呼び出せるのか? サブエージェントは外部ツールを直接呼び出せるのか、それとも親エージェント経由でのみ呼び出せるのか? どのエージェントがどの予算に対して支出を行えるのか? ガバナンスやルーティングに関する記事と同様に、Cedar や OPA などのアプローチを用いてこれらを policy-as-code として表現することで、エージェントグラフで許可されたエッジが、コード内に隠蔽された暗黙的なものから、明示的で検証可能なものへと変わります。
イースト-ウェスト呼び出しに対するエージェントごとの認可(ポリシー概念図)
2 番目のルールに注目してください。サブエージェントによるオーケストレーターの再呼び出しを禁止するポリシーがあれば、レート制限の有無にかかわらず、Tomás のループは最初のホップで遮断されていたはずです。ここでの認可は単なるセキュリティ制御にとどまりません。エージェントグラフの形状を制約することは、制御不能な動作のカテゴリ全体を未然に防ぐ手段でもあります。すべてのイースト-ウェスト呼び出しが通過する単一の場所となることで、ゲートウェイは機能の強制適用ポイントとして機能します。
プロトコルによって決定されることと、ユーザーに委ねられることを正確に把握することが役立ちます。検索とトランスポートは標準化されていますが、ID モデル、ポリシー、予算、および強制適用ポイントは標準化されていません。
適切な認可が設定されていても、マルチエージェントシステムは単一の呼び出しとは異なる形で失敗します。被害の最小単位が「連鎖(カスケード)」だからです。再委任を行うリトライはサイクルを形成する可能性があり、多数の領域にファンアウトするエージェントは 1 つのリクエストを数千回に増幅させる可能性があり、低速なサブエージェントはワークフロー全体を停止させる可能性があります。これらは、モデルレイヤーにおけるルーティングとフェイルオーバーでおなじみの Thunder Herd(殺到)問題やサイレントエスカレーション問題のエージェント規模でのバリエーションです。
抑制機能は多層的に構成されます。委任深さの制限(delegation-depth limit)はチェーンの再帰的な深さを制限し、サイクルを構造的に破綻させます。エージェントごとのレート制限は、1 つのエージェントが他のエージェントを呼び出せる頻度の上限を設定するため、ループが発生しても一晩中実行されずに制限値に達して停止します。タイムアウトと停止検出(stall detection)により、エージェントが配下のエージェントを永久に待ち続けるのを防ぎます。また、1 実行あたりのグローバル予算は、形状に関係なく 1 つのワークフローの総支出に上限を設定します。TrueFoundry の Agent Gateway は、関連するプリミティブ(リトライポリシー、フォールバックパス、タイムアウト、無限ループや停止エージェントに対する保護柵、さらにエージェント、ワークフロー、環境ごとのトークンおよびコストベースのクォータ)をサポートしています。以下の具体的な設定例は概念を示すものであり、プリミティブ自体が製品ページに記載されている機能となります。
マルチエージェント実行におけるブラストライディウス制御(ゲートウェイ設定概念図)
考え方の転換点となるのは、マルチエージェントの実行を無制限の会話としてではなく、予算と深さが設定された限定的なトランザクションとして扱うことです。これらの境界がゲートウェイで適用されていれば、Tomás の一晩のループは、翌朝の 5 桁(数百万〜千万円規模)の請求書ではなく、午前 2 時の制限検知とアラートで済んでいたはずです。
個々の呼び出しにおけるレイテンシ、トークン数、エラーといったリクエストごとのメトリクスは必要ですが、マルチエージェントシステムには不十分です。最も重要な「実行の形状」が見えなくなってしまうためです。3 段階深くなった委任の先で何らかの異常が発生した際、どのエージェントがどの順番でどのインプット/アウトプットを用いて別のエージェントを呼び出し、どこでコストが発生したかというツリー全体が必要になります。これは、すべてのホップを伝播する実行識別子によって関連付けられた、エージェントの手順、モデル呼び出し、ツール呼び出しを網羅するエンドツーエンドのトレースとなります。
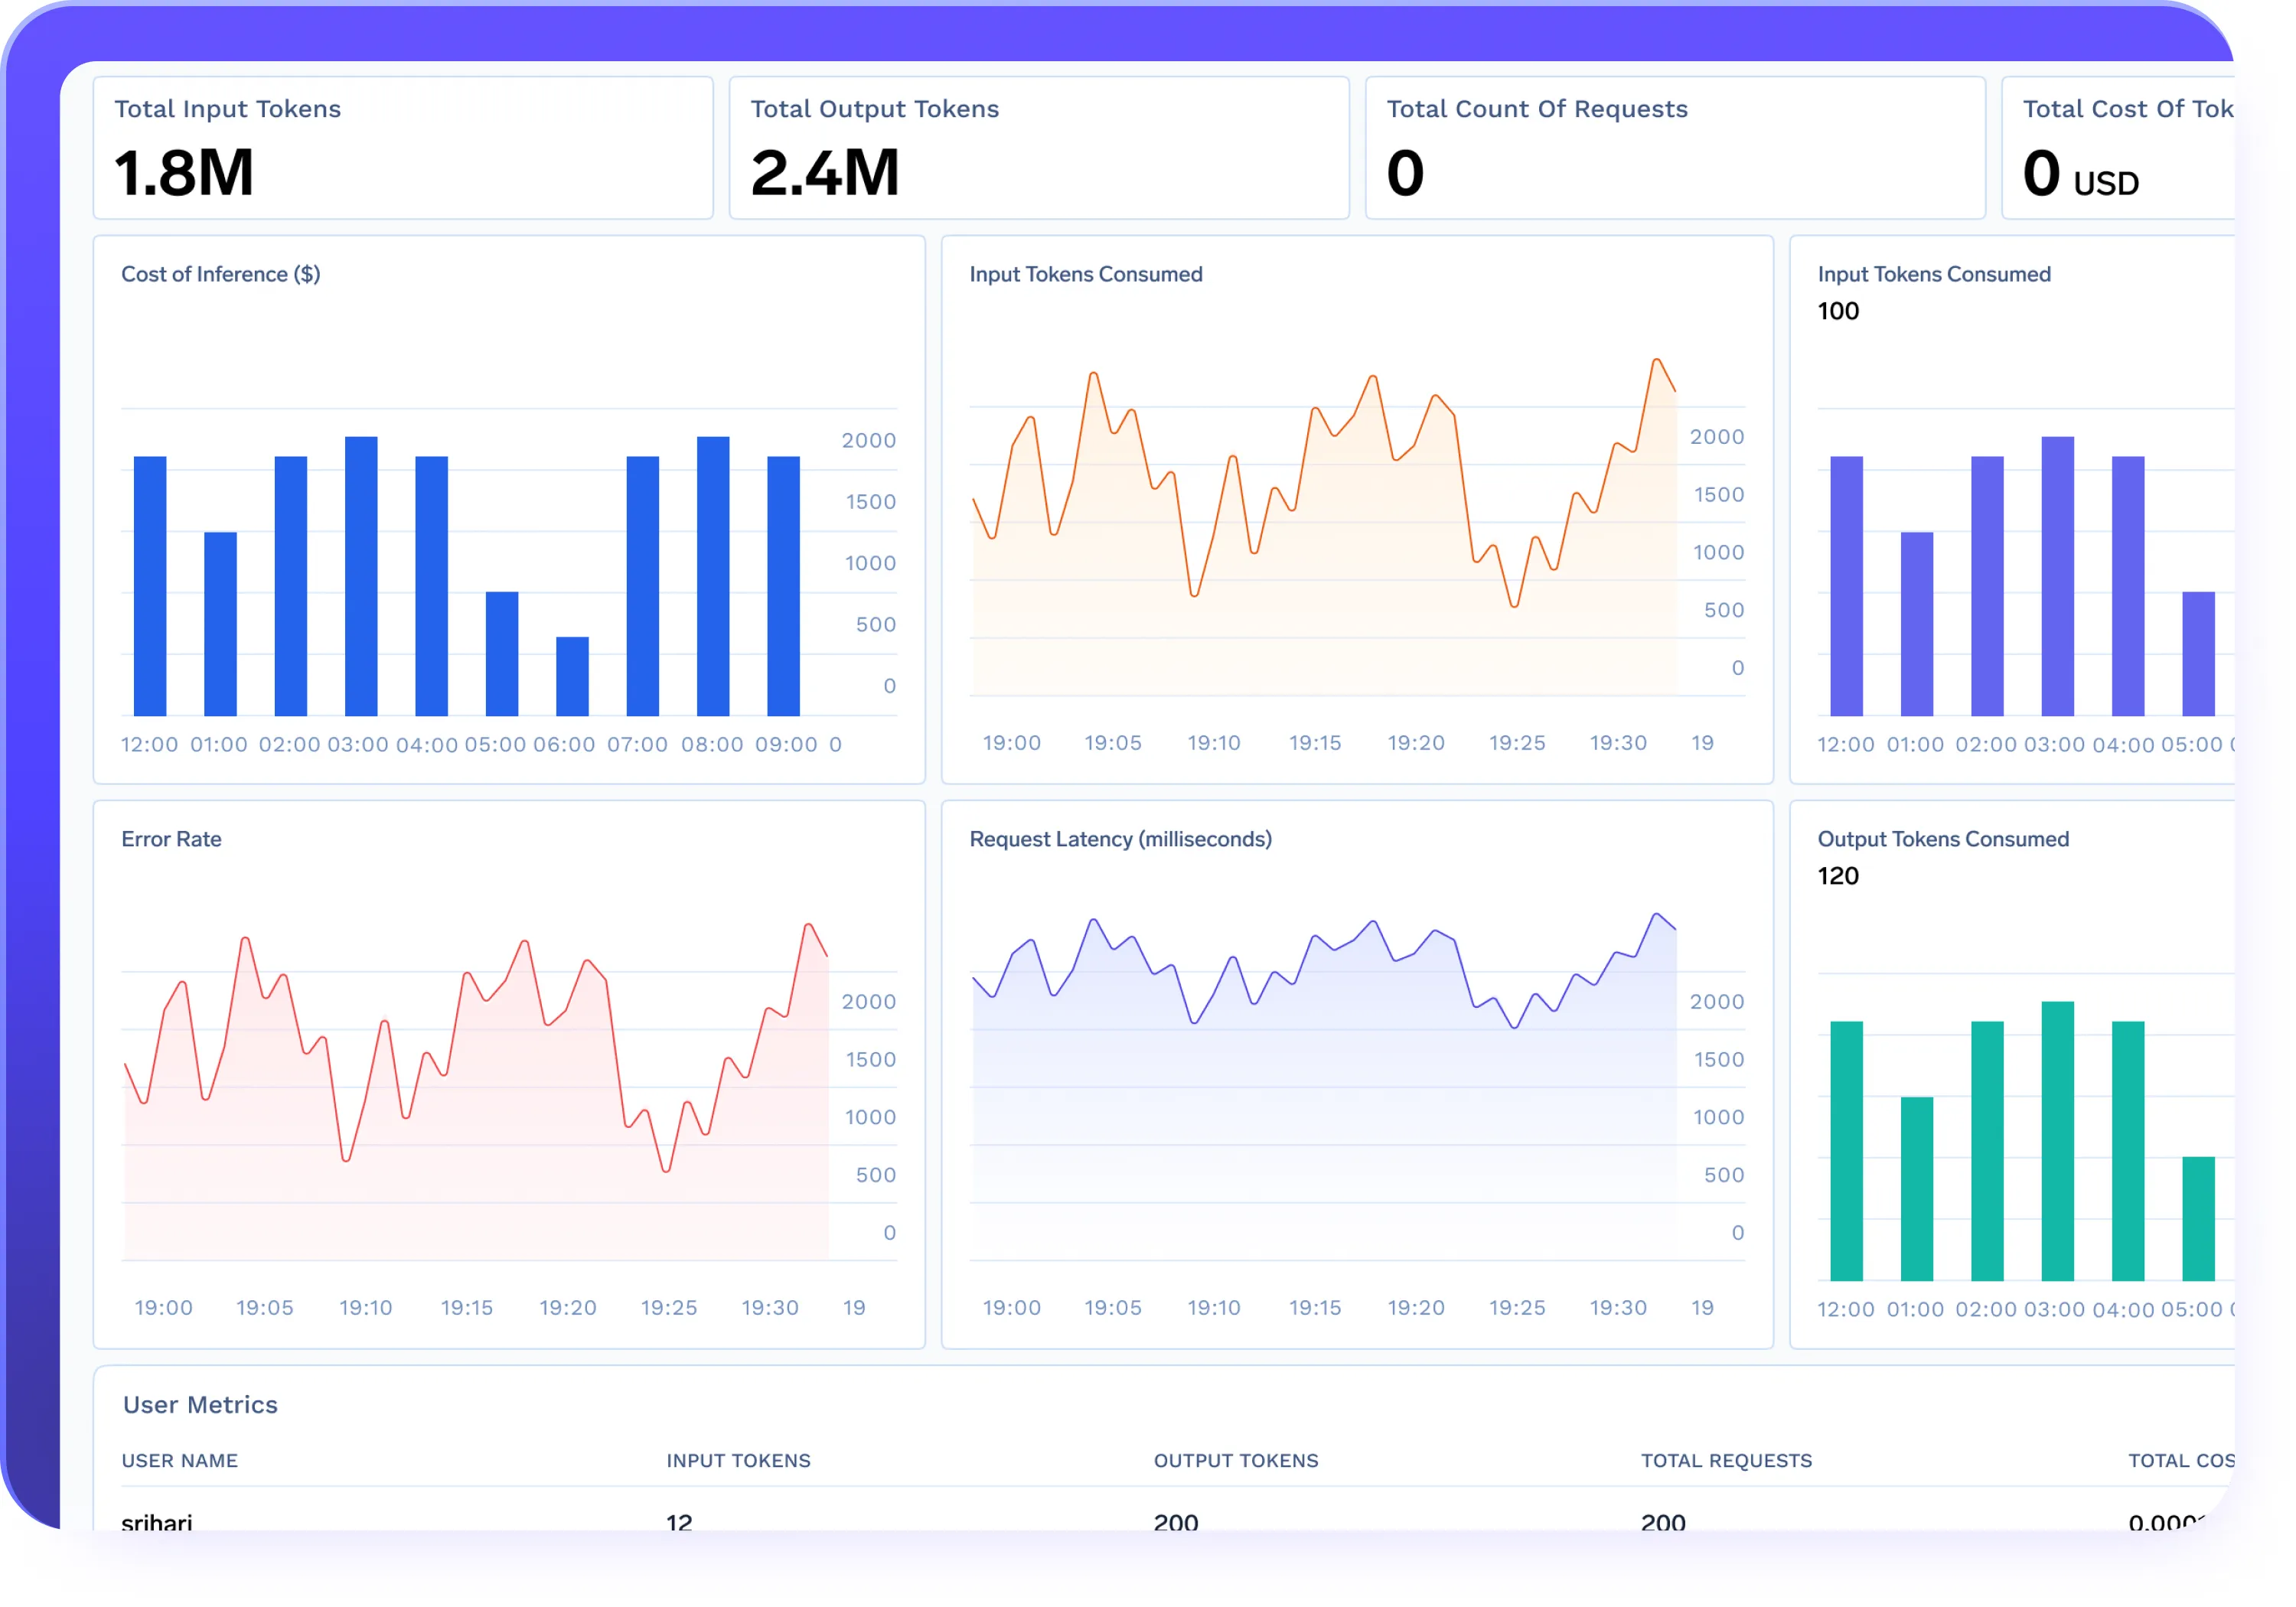
これは、OpenTelemetry に関する記事で解説したトレーシング(エージェントを主要な次元とし、実行をスパン同士を結びつけるトレースとして扱うのと同じスパンモデル)を直接拡張したものです。TrueFoundry の Agent Gateway は、これらのエンドツーエンドの実行トレースを取得し、ステップごとのログを精査して障害を診断できるようにします。「昨夜エージェントが費用を使いすぎた」という漠然とした問題を、「このエッジが深さ 4 でサイクルを形成していた」という具体的な原因特定へと変え、障害解決を可能にします。
マルチエージェントシステムにおいて、ID の伴わないコスト情報は意味をなしません。「ワークフローに X のコストがかかった」という情報だけでは、その支出がオーケストレーターの計画呼び出しによるものか、特定のサブエージェントの高価なモデル選択によるものか、あるいはループによるものかを判別できません。セクション 2 の ID をキーにして、特定のエージェント、ワークフロー、実行にトークン数とコストを帰属させることで、支出の透明性が確保され、暴走の診断が可能になります。
これは、コスト帰属に関する記事で扱ったチームごとの会計を、エージェントを最小単位として拡張したものです。Agent Gateway はトークン使用量とコストを特定のエージェント、ワークフロー、チーム、環境に帰属させます。これにより、財務上の疑問(どのエージェントが支出を増加させているか)に答えると同時に、運用上のアノマリー(単一エージェントのコスト急増は、毎月の請求書が届くはるか前に発見できるループの最初の兆候であることが多い)を表面化させるという二重の役割を果たします。セクション 4 の実行ごとの予算と組み合わせることで、コストは可視化され、かつ制限内に収められます。
マルチエージェントシステムは、プロンプトインジェクションに新しい伝播経路を与えます。プロンプトインジェクションに関する記事で説明したように、信頼できないコンテンツ(検索されたドキュメントやツールの結果など)を読み込むエージェントは、そこに埋め込まれた指示によって誘導される可能性があります。マルチエージェントシステムでは、その侵害されたエージェントが他のエージェントと会話することで、その出力が次のエージェントの入力となります。リサーチエージェントに届いたインジェクションは、ダウンストリームのライターエージェントやクリティックエージェントに伝播する可能性があります。これらのエージェントにとって、リサーチエサーチエージェントは信頼できないソースではなく、信頼できるピア(仲間)として扱われてしまうためです。
これが、インジェクション対策が単なる入力境界の問題にとどまらず、エージェント間の問題でもある理由であり、ゲートウェイでの一元管理が重要となる理由です。エージェント間のトラフィックがゲートウェイを経由してルーティングされることで、すべてのイースト-ウェストメッセージが監視され、各エージェントが相互にチェックを行うことに依存せず、統一されたガードレールを適用できます。
本記事のすべてのテーマは、1 つの結論に収束します。マルチエージェントシステムは分散システムであり、他の分散システムと同様に、すべての呼び出し元に ID を、すべての呼び出しにポリシーを、すべてのフローにトレースを、すべての実行に予算を与えるコントロールプレーンが必要です。これを エンドユーザーコンピューティング 環境全体の各エージェントフレームワーク(LangChain、CrewAI、独自構築のオーケストレーターなど)に個別に組み込もうとすると、不整合やギャップが確実に発生し、まさに Tomás のケースのようにループが見逃される原因となります。
そのコントロールプレーンこそが agent gateway です。TrueFoundry の Agent Gateway は、フレームワークに依存しないエージェントを単一のガバナンス層(エージェントごとの ID と RBAC、エージェントおよびワークフローごとのトークン/コストクォータ、リトライ、タイムアウトとループ保護柵、エンドツーエンドトレーシング、MCP 管理されたツールアクセス)を介して実行します。これにより、AI Gateway のモデルトラフィック、MCP Gateway のツールトラフィック、そしてマルチエージェントシステムの内部トラフィックを 1 か所に統合します。オーケストレーションパターン自体の詳細については、TrueFoundry のマルチエージェントオーケストレーションガイドが参考になります。本記事は、それらが稼働した後のガバナンスに焦点を当てています。
A2A はまだ初期段階ではありませんか? なぜ今ガバナンスを適用するのですか?
プロトコル自体の正式な v1.0 仕様は公開されているものの、企業の導入パターンとしての A2A はまだ初期段階であり、エコシステムの標準も進化し続けるため、詳細は暫定的なものとして扱う必要があります。しかし、ガバナンスの必要性は導入の定着を待ちません。どのようなメカニズムであれ、エージェントが相互に委任を開始した瞬間、ID や制限のないイースト-ウェストトラフィックが発生します。本記事で説明した制御(エージェントごとの ID、認可、ブラストライディウス制限、トレーシング)は、エージェントが A2A 経由で会話するか、フレームワーク固有の委任機能経由か、あるいはプレーンな HTTP 経由かを問わず適用されます。
マネージドエージェント層に関する記事とはどのように異なりますか?
以前の記事では、エージェントロジックとランタイム(エージェントコードがどこで実行され、どのようにデプロイされるか)の分離について議論しました。本記事は、エージェントが稼働した後のエージェント間通信のガバナンス(各ホップにおける ID、誰が誰を呼び出せるか、連鎖の抑制、実行のトレーシング)に関するものです。これらは関連するレイヤーですが異なる問題を扱っています。ランタイムの分離はデプロイ単位としてのエージェントに関するものであり、本記事はネットワーク参加者としてのエージェントに関するものです。
冒頭のインシデントを防ぐことができた単一の制御は何ですか?
連動して機能する 2 つの制御です。サブエージェントによるオーケストレーターの再呼び出しを禁止する認可ルールがあれば、最初のホップで構造的にループを遮断できました。また、委任深さ制限とエージェントごとのレート制限があれば、ポリシーをすり抜けたサイクルを検知して捕らえることができました。どちらもワークフローの意図を解釈する必要はなく、その形状を制限するだけで機能します。これが、各エージェントのロジックではなくゲートウェイに配置すべき理由です。
本当に各エージェントに独自の ID が必要ですか?
エージェントごとに認可、コスト帰属、監査を行う必要があるすべてのケースにおいて、答えは「はい」です。共有キーを使用するとすべてのエージェントが 1 つのプリンシパルに集約されてしまうため、Tomás はどのエージェントがループを開始したのか、それぞれのコストがいくらなのかを特定できませんでした。人間に紐づくプリンシパルを保持しつつ、エージェントごとに固有の ID を割り当てることが、本記事で説明した他のすべての制御の基礎となります。
マルチエージェントガバナンスにはゲートウェイとフレームワークのどちらを使用すべきですか?
フレームワークはワークフローを構築し、ゲートウェイはそれをガバナンスします。ID、認可、レートおよび深さ制限、トレーシング、コスト帰属は、実行するすべてのエージェントおよびフレームワークにわたって一貫している必要がある横断的な関心事です。これらは単一のコントロールプレーンが提供するものであり、フレームワークごとの個別の実装では保証できません。
Tomás のインシデントは複雑な障害ではなく、ガバナンスのない内部ネットワークが引き起こした典型的な問題でした。マルチエージェントシステムは、エージェントが自由に委任を行えるからこそ強力です。そしてその自由度があるからこそ、すべてのエッジで ID、制限、トレースが必要となります。エージェントトラフィックの前面にそのコントロールプレーンを配置することで、委任機能は深夜のインシデントの原因ではなく、強力な機能として活用し続けることができます。
Northwind および Tomás は架空の例です。明確にしておくべき点として、Agent2Agent(A2A)はオープンな通信プロトコルであり、TrueFoundry Agent Gateway はエージェントワークフローを管理するための TrueFoundry の製品およびコントロールプレーン実装です。これらは異なる概念であり、本記事ではゲートウェイが管理するトラフィックの標準的な用語として A2A を使用しています。TrueFoundry Agent Gateway の機能は 2026 年 6 月時点の公開製品ドキュメントに基づいてまとめたものであり、今後変更される可能性があります。一部の機能はプレビュー段階である場合があります。A2A は企業導入パターンとしてはまだ新しく、そのエコシステムの慣習は今後も進化していくため、本文中のプロトコルの詳細については概要として記載しており、最新の仕様を確認することをお勧めします。コードおよびポリシーのサンプルはドキュメント化されたパターンの概念を示すものであり、リファレンス実装から複製されたものではありません。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























