



October 21, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
エージェントの信頼性は、モデルそのものと、それを取り巻くシステムの両方に依存します。カーネギーメロン大学、イェール大学、Amazonなどの研究者による2026年の調査では、その周辺システム(エージェントハーネス)の分類法として、ETCLOVG(実行、ツール、コンテキスト、ライフサイクル、可観測性、検証、ガバナンス)が提案されています。
著者らは170以上のオープンソースプロジェクトをこれら7つの層にマッピングし、成熟している領域と運用上のギャップを特定しました。本稿ではこの分類法を要約し、TrueFoundryのAgent Harnessにマッピングすることで、ネイティブなランタイム機能と、それに付随するパターンや統合を切り分けて解説します。
プラットフォーム責任者のプリヤンカは、 名前を付けられない信頼性の問題に直面していました。彼女のチームは5つの本番エージェントを運用していましたが、エージェントが誤作動を起こした際、事後分析で修正すべき点について意見が一致することは一度もありませんでした。ある者はモデルのせいにし、アップグレードを主張しました。ある者はプロンプトを書き換えました。ある者は再試行処理を追加し、またある者はサンドボックスを求めました。それぞれの修正案はもっともらしく、それぞれが異なる層に対処していましたが、どの層で実際に障害が発生したのかを語る共通言語がなかったため、議論は堂々巡りでした。プリヤンカが必要としていたのは、より優れたモデルや声の大きい意見ではなく、 地図でした。つまり、「この障害はモデルではなくライフサイクル層にある」「検証層が全く存在しない」といったように、エージェントのどこに問題があるかを指し示すための手段です。ETCLOVGはその地図であり、本稿はそのガイドです。まずは著者らが構築した分類法を解説し、次に各層を本番ランタイムと照らし合わせながら、名称の有無にかかわらず、ネイティブ機能と付随するワークフローや統合を区別していきます。
この調査の核心的な主張は、モデルの価値を相対的に下げ、インフラストラクチャの重要性を高めるというものです。LLMエージェントの急速な普及により、実行の信頼性はベースモデルよりも、それを取り巻くハーネスに依存することが明らかになりました。その証拠の一部は歴史にあります。2022年から2023年にかけてのReAct時代には、単一のモデルループをwhileループ、プロンプトテンプレート、そして小さなツールディスパッチテーブルで包み込んでいました。その後、AutoGPTやBabyAGIが登場し、その薄いラッパーが抱える障害モード(実行の暴走、コンテキストの肥大化、状態の喪失、監視されていない副作用など)が露呈しました。これらは、 インフラストラクチャ の問題であり、プロンプトの問題ではありませんでした。それからの数年間、この分野では欠けていたインフラストラクチャが少しずつ構築され、つい最近になってようやくそれに名前が付けられたのです。
その命名こそが、この調査における3段階のフレームワークであり、ハーネスエンジニアリングの立ち位置を正確に定義するものです。プロンプトエンジニアリング(2022〜24年):レバーとなるのは入力テキストであり、単一の呼び出しに対して最適化されます。コンテキストエンジニアリング(2025年):焦点は「各ステップでモデルに何を見せるべきか」という問い(検索、圧縮、ツール結果のランキング、ウィンドウの飽和など)に移ります。ハーネスエンジニアリング(2026年〜):モデルが長期実行タスクをこなせるほど強力になるにつれ、焦点はインフラストラクチャ全体を包むラッパーへと拡大します。各フェーズは前段階を包含しており(ハーネスはコンテキストを含み、コンテキストはプロンプトを含む)、これらは置き換わるのではなく重なり合っています。ETCLOVGは、最初の2つのフェーズでは必要とされなかったアーキテクチャ上の境界線を、第3のフェーズに与えるものです。
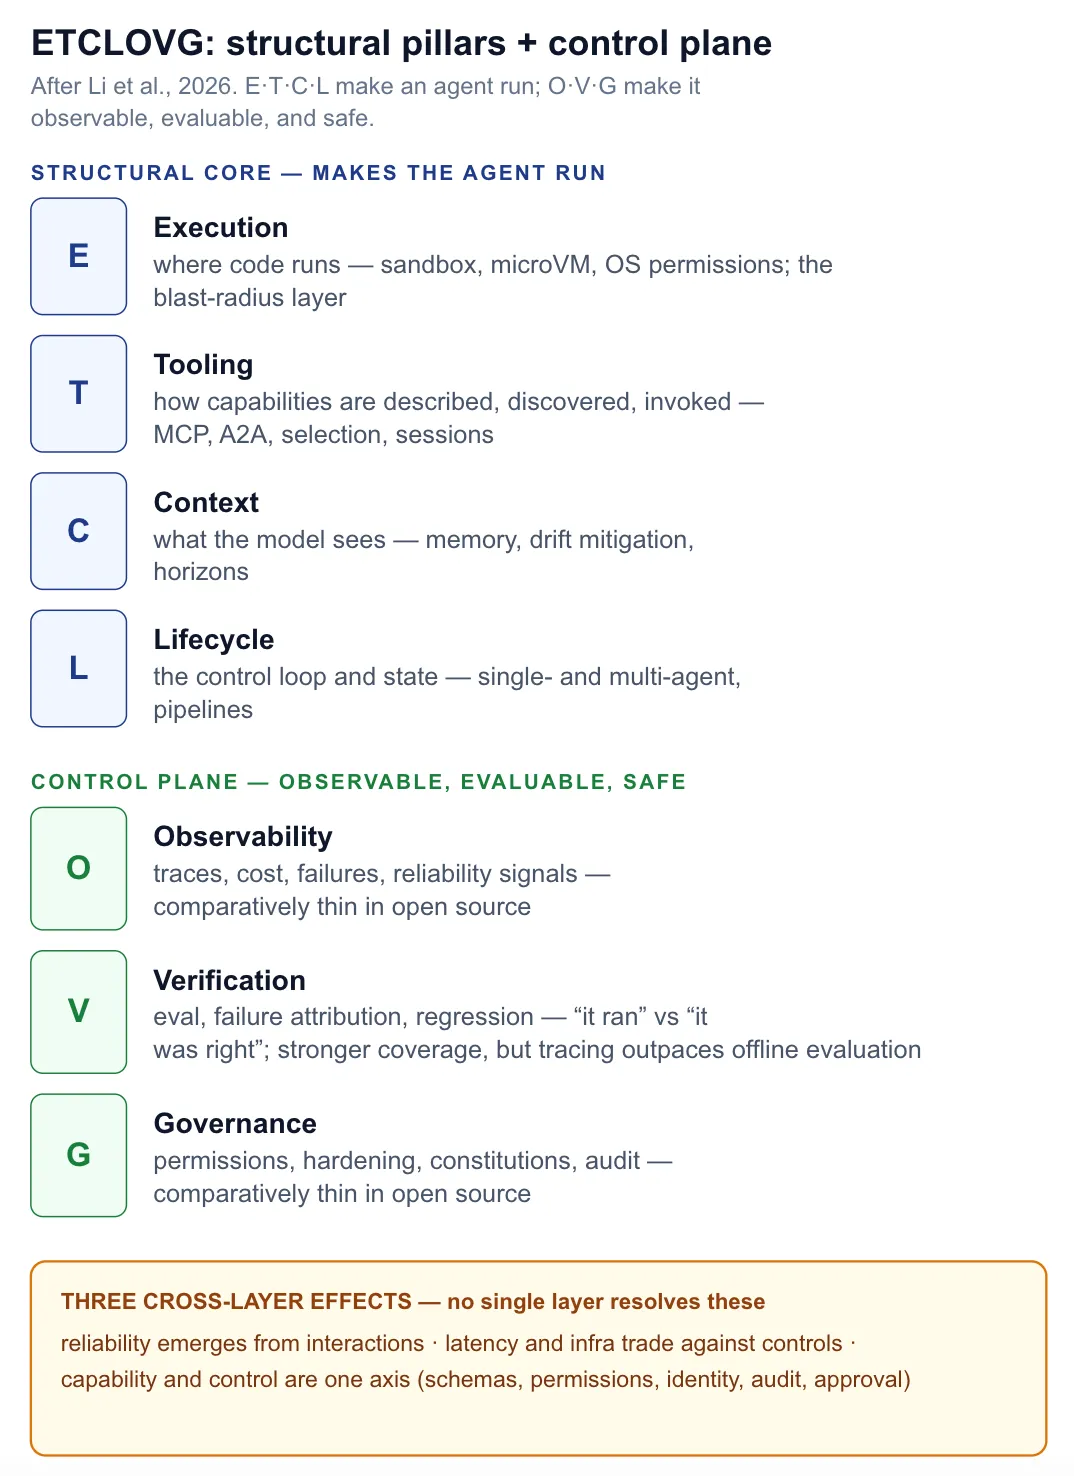
この分類法は、構造的なコアとコントロールプレーンに分かれます。E、T、C、Lは構造的な柱であり、エージェントを動作させるためのものです。O、V、Gはコントロールプレーンであり、動作中のエージェントを可観測にし、評価可能にし、安全にするためのものです。この調査の注目すべき点は、可観測性とガバナンスをライフサイクルフックに組み込むのではなく、独立した層として昇格させたことです。その理由は、本番環境においてそれぞれが独自のツールエコシステムを持ち、異なるチームによって管理されているためです。以下に、調査の定義を言い換えた7つの層を紹介します。
E — 実行環境(Execution environment) エージェントのコードやアクションが実際に実行される場所であり、それらを制限するものです。管理されたサンドボックス、マイクロVM、コード特化型ランタイム、コンピュータ操作やブラウザ環境、OSレベルの権限モデルなどが含まれます。これは「爆発半径(影響範囲)」を決定する層であり、エージェントがコマンドを実行した際に何に触れられるかを定義します。
T — ツールインターフェースとプロトコル(Tool interface and protocol) 外部機能がどのように記述、発見、呼び出しされるかを定義します。プロトコル標準(MCP、A2A)、ツールの記述と選択、ツール拡張トレーニング、セッション管理などが含まれます。モデルはこの層を通じてのみツールを認識します。
C — コンテキストとメモリ管理(Context and memory management) 短期、セッション、永続的な各期間においてモデルが認識できる範囲:長期コンテキストの技術とコンテキストドリフトへの対策。以前のエンジニアリングフェーズの主題であり、現在は4つの柱の1つとなっています。
L — ライフサイクルとオーケストレーション 状態の読み書きを行う制御フロー。シングルエージェントの内部ループからマルチエージェントパターン、そして課題からプルリクエストまでの完全なパイプラインまでを網羅します。ループそのものもここに存在します。
O — 可観測性と運用 トレース、コスト、障害、信頼性シグナル。トレーシングプラットフォーム、エージェント固有の運用ツール、コスト追跡、統合された可観測性などが含まれます。調査によると、このレイヤーは公開されているオープンソースコードの中では比較的薄いことがわかっています。
V — 検証と評価 タスクとトレースを評価、障害の帰属、回帰フィードバックへと変換するプロセス。ベンチマークの根拠付け、制御された実行、多段階の判断、デプロイ時の評価ループなどが含まれます。「実行された」ことと「正しく実行された」ことの差を定義します。
G — ガバナンスとセキュリティ モデル、システム、組織の各サブレイヤーにわたる制約。権限モデル、ライフサイクルフック、コンポーネントの強化、宣言的な憲法、監査インフラストラクチャなどが含まれます。調査では、これもオープンソースでは手薄であり、「商用プラットフォーム内に存在することが多い」と指摘されています。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


























