


November 17, 2026
|
5 min read



Blazingly fast way to build, track and deploy your models!
エンタープライズにおけるAI導入に伴い、リスクの所在は変化しました。極めて重要な決定は、もはやモデルの選定やファインチューニングだけに限定されません。本番システムにおけるリスクは、AI Gatewayレイヤーにおいて発生し、制御されるか増幅されるかのいずれかとなります。こここそが、推論がルーティングされ、モデルが選択され、エージェントがワークフローを実行し、ツールが呼び出され、可観測性(Observability)データが出力される場所だからです。
その結果、データ居住性(Data Residency)やデータ主権(Data Sovereignty)といった長年存在する概念は、もはや静的なインフラ上の懸念事項として扱うことはできません。AIシステムにおいてこれらは、Gatewayによって強制(または違反)されるランタイムのプロパティ(実行時の特性)となります。
多くの企業は、特定クラウドリージョンにモデルをデプロイしたことでデータガバナンスに対処できたと考えています。しかし、AI Gatewayが以下の機能を導入すると、その前提は崩壊します:
したがって、AI Gatewayのコンテキストにおけるデータ主権とデータ居住性の比較を理解することは、コンプライアンスを満たした運用グレードのAIを稼働させるための基盤となります。
従来のアプリケーションは、比較的予測可能なデータ経路を持っていました。リクエストはユーザーからサービス、データベースへと流れ、多くの場合単一のリージョン内に収まっていました。AI Gatewayはこのモデルを根本から変えます。
AI Gatewayは、単一のリクエストに対して以下の処理を行う可能性があります:
アプリケーション自体がローカルに見える場合であっても、これらの各アクションは暗黙的なリージョン間のデータ移動やアクセスを引き起こす可能性があります。
これこそが、AI Gatewayが事実上のデータ制御プレーン(データコントロールプレーン)となる理由です。
居住性と主権の制約がGatewayで強制されない場合、以下の問題が発生します:
言い換えれば、AIシステムにおけるデータガバナンスの失敗は、通常モデルの失敗ではなくGatewayの失敗なのです。
これが、「モデルをリージョン内にデプロイしている」という一般的な保証だけでは不十分な理由でもあります。Gatewayレベルでの強制力がなければ、企業は以下を保証することができません:
本ブログの以降では、データ居住性とデータ主権がどのように異なるのか、なぜAI Gatewayでその両方を強制しなければならないのか、そしてTrueFoundryのようなプラットフォームがGatewayをどのように設計し、これらの保証を単なる努力目標ではなく実行可能なものにしているのかについて解説します。
データ居住性(Data Residency)とは、データが物理的にどこで処理され保存されるかを定義するものです。
AIシステムにおいて、この問いに答えるのはモデル単体ではなく、ランタイム実行をオーケストレーションするAI Gatewayです。
AI Gatewayの観点から見ると、データ居住性は以下に適用されます:
極めて重要な点として、居住性はランタイム(実行時)に強制されるか、または違反されることになります。
AIシステムにおけるデータ居住性は、単一の設定によって強制されるものではありません。実行が発生し得る場所を限定する、AI Gateway内部のランタイムプリミティブ(基本構成要素)のセットを通じて強制されます。
TrueFoundryのようなプラットフォームでは、これらのプリミティブがリクエスト実行前および実行中に動作し、リトライ、障害、動的ルーティングが発生した場合でも居住性の保証を維持します。
主な強制プリミティブ:
リージョンスコープ付きモデルエンドポイント
モデルは、明示的なリージョンアフィニティ(親和性)を持ってAI Gatewayに登録および公開されます。Gatewayは、許可されたリージョンに属するモデルエンドポイントにのみリクエストをルーティングできます。これにより、同じワークロードに対して複数のモデルが構成されている場合でも、グローバルにホストされたモデルや他リージョンのモデルの偶発的な使用を防ぎます。
リージョンロックされたリトライおよびフェイルオーバープール
リトライとフォールバックは、人知れず発生する居住性違反の最も一般的な原因の1つです。居住性を認識するAI Gatewayは、以下のようにリトライロジックを制約します:
これにより、高可用性のための挙動がコンプライアンスの意図を上書きしてしまうことがなくなります。
居住性を認識するルーティングテーブル
Gatewayにおけるルーティングの決定は、実行時にリージョン制約と照らし合わせて評価されます。コスト、パフォーマンス、またはモデル選択のためにポリシー駆動でルーティングが行われる場合であっても、Gatewayは居住性を単なる推奨ではなくハードな制約(厳格な制約)として適用します。
これは、異なる地理的場所に異なるモデルが配置される可能性があるマルチモデル構成において特に重要です。
居住性制約付きの可観測性エクスポーター
推論ログ、プロンプト、レスポンス、トレースには規制対象データが含まれていることがよくあります。居住性を認識するAI Gatewayは、以下を保証します:
これにより、推論はローカルで行われているのにメタデータはそうではないという、よくあるコンプライアンスの抜け穴を塞ぐことができます。
データ居住性がデータがどこで扱われるかという問いに答えるのに対し、データ主権(Data Sovereignty)は、最終的に誰がデータを管理し、どの法的管轄権の下にあるかという問いに答えるものです。
AI Gatewayにおける主権は、以下によって決まります:
非常に重要でありながら見落とされがちな現実として、データはある国に居住していながら、主権は別の国にあるという状態が発生し得るという点が挙げられます。
AI Gatewayは、以下とやり取りすることが多くあります:
推論自体がローカルで行われていたとしても、以下のような場合には主権が損なわれる可能性があります:
したがって、規制対象の企業にとって主権とは地理の問題ではなく、アーキテクチャ上の管理権の問題です。
企業が完全に管理していないAI Gatewayは、どこで稼働していようとも主権を保証することはできません。
AI Gatewayレイヤーにおいて、データ居住性とデータ主権の違いは運用上明確になります。両者ともランタイムで強制される必要がありますが、解決するリスクの種類が異なります。
Gateway評価の主要メトリクス
| 基準 | 評価すべきポイント | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシー | 最初のトークン生成時間(Time-to-first-token)のp95オーバーヘッドが10ms未満であるか? | 必須(Must Have) | ✅ 対応済み |
| データ居住性 | ログを指定リージョン(EU/US等)内に保持できるか? | ユースケース依存 | ✅ 対応済み |
| レイテンシーベースのルーティング | リアルタイムのレイテンシーや障害に基づいて自動的に再ルーティングできるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |

以下は、主権を考慮した視点なしでAI Gatewayを評価した際に繰り返し見られる典型的な失敗パターンです。
企業はモデルをローカルのクラウドリージョンにデプロイし、それでコンプライアンスに対処できたと思い込みます。しかし実際には、AI Gatewayは依然として以下を行う可能性があります:
Gatewayは多くの場合、自動的にリトライやフェイルオーバーを行います。明示的な制約がない場合:
推論がローカルであっても、エージェントがGateway経由で呼び出すツールが以下のような状態になっている場合があります:
プロンプト、レスポンス、トレースには規制対象データが含まれていることが多々あります。
AI Gatewayが承認された境界の外にテレメトリをエクスポートした場合、主権は人知れず侵害されます。
ほとんどのAIプラットフォームは、データガバナンスをデプロイメントの課題として扱います。TrueFoundryはこれをランタイムでの強制問題として扱います。
エンタープライズスケールにおいて、データ居住性とデータ主権はインフラがどこにデプロイされているかによって保証されるものではなく、実行がどのように制御されているかによって保証されます。リクエストが複数のモデルへ動的にルーティングされ、エージェントがツールを呼び出し、可観測性パイプラインがメタデータをエクスポートする現代のAIシステムにおいて、ガバナンスを正確に強制するのに十分なコンテキストを持つ唯一のレイヤーはAI Gatewayです。
TrueFoundryはこの原則に基づいて設計されています。
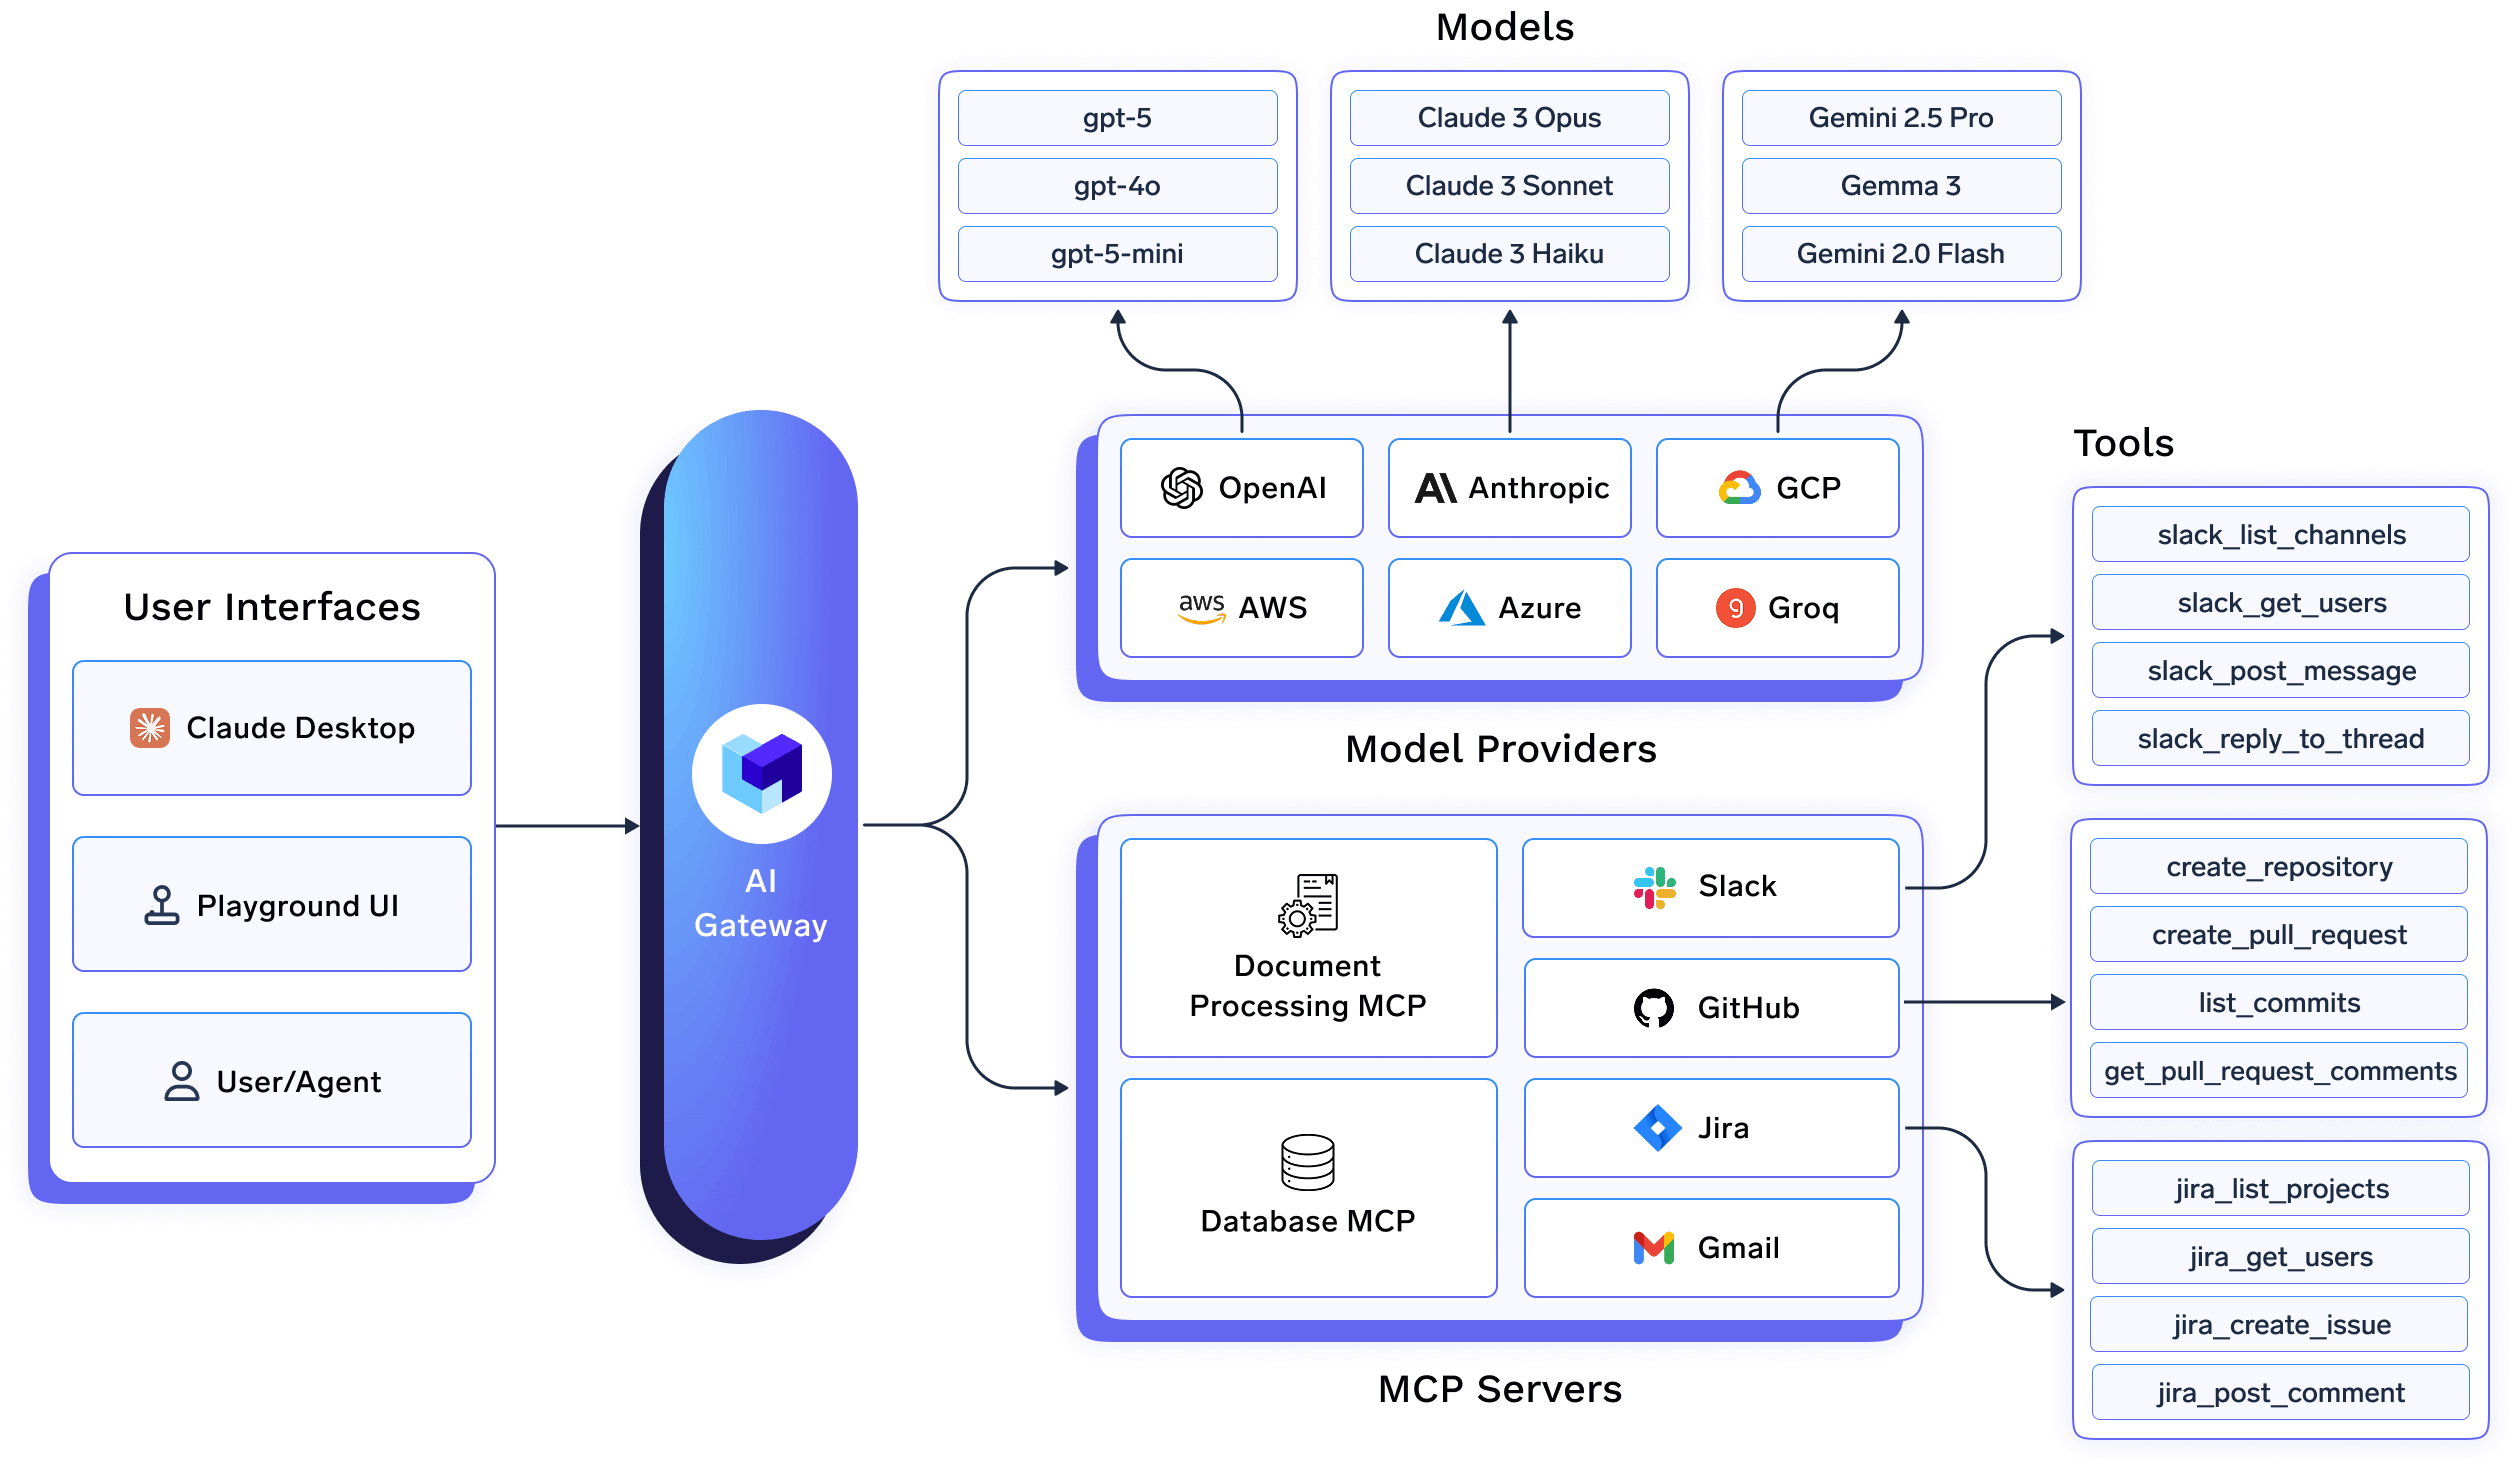
TrueFoundryにおいて、AI Gatewayはモデルの前にある単なる薄いプロキシではありません。以下の要素が交差するポイントに位置するコントロールプレーンです:
すべてのリクエストがこのレイヤーを通過するため、TrueFoundryはベストエフォート型の保証ではなく、居住性と主権の両方をファーストクラスのランタイムポリシーとして強制できます。
この違いが決定的に重要です。
TrueFoundryのAI Gatewayは、静的なリージョン選択に頼るのではなく、実行パスを制約することによって居住性を強制します。
具体的には、以下を意味します:
リクエストが居住性制約の範囲内で満たされない場合、他の場所へ暗黙的にルーティングされるのではなく、セキュアにエラーとなります(fail closed)。
これにより、AIシステムにおける最も一般的なコンプライアンス違反の1つである「例外パス処理中のリージョン間実行」を排除できます。
データ主権とは根本的に、コンピューティングがどこで実行されるかではなく、誰がアクセスを制御するかに関する問題です。
TrueFoundryは、企業が以下に対する制御権を確実に保持できるようにすることで主権を実現します:
Gatewayが企業の完全な制御下にあるため、主権は以下に依存しません:
これは、推論がローカルで行われても管理権がローカルにないホスト型AIサービスとの決定的な違いです。
TrueFoundryのアプローチの主要な強みは一貫性です。居住性および主権のポリシーは、以下にわたって一律に適用されます:
これにより、以下のようなよくある障害モードを防ぐことができます:
AI Gatewayを共通の強制ポイントとして扱うことで、TrueFoundryはガバナンスが断片的なものではなく、システム全体にわたるものであることを保証します。
現代のAIシステムにおいて、データガバナンスはもはやインフラがどこにデプロイされているかによって定義されるものではなく、ランタイムで実行がどのように制御されているかによって定義されます。モデル、エージェント、ツールが動的に相互作用する中で、意味のある状態を維持するには、データ居住性とデータ主権の両方を中央で強制する必要があります。
居住性はデータがどこで処理されるかを決定します。主権は誰がそれを管理するかを決定します。ルーティング、フェイルオーバー、エージェントのワークフロー、可観測性を処理するAI Gatewayにおいて、片方だけを解決してもう片方を放置することはギャップを生み出す原因となります。
すべての推論リクエストとツール呼び出しが通過する場所であるため、AI Gatewayこそがこれらの保証を一貫して強制できる唯一の場所です。TrueFoundryはAI Gatewayをガバナンスのコントロールプレーンとして扱い、居住性と主権を単なる前提ではなく、強制可能なシステムのプロパティ(特性)へと変革します。
その違いこそが、AIを単なる実験的機能から、コンプライアンスを満たした運用グレードのシステムへと進化させる鍵となります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























