October 24, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Nous avons exécuté des tests de charge simultanée avec GuideLLM sur trois modèles de 8 milliards de paramètres sur un seul GPU NVIDIA A10 (24 Go) : Qwen3-8B, Llama 3.1 8B Instruct et Ministral 8B. Ce benchmark vLLM a couvert une concurrence allant de 4 à 256 utilisateurs simultanés sur deux types de charges de travail : chat conversationnel court et classification d'intention. Un seul modèle a tenu la distance sur toute la plage. Les deux autres ont échoué.
Les trois modèles ont été exécutés en FP16 sur vLLM, via le point de terminaison de streaming standard /v1/chat/completions. GuideLLM a maintenu exactement N requêtes en cours pendant 90 secondes par niveau de concurrence (4, 8, 16, 32, 64, 128, 256), avec 30 secondes de pause entre chaque niveau.
Deux charges de travail :
Même version de vLLM, même configuration de passerelle, même GPU pour les trois. Les résultats ci-dessous reflètent ces conditions.
Le tableau récapitulatif utilise 64 utilisateurs simultanés pour la comparaison du chat court. Il s'agit du dernier niveau de concurrence où Llama a fonctionné sans erreur (0 %), ce qui en fait la base de comparaison la plus équitable pour les trois modèles.
Qwen3 présente le temps d'attente typique le plus faible (524 ms p50) et la queue de distribution la plus serrée (2 840 ms p95). Llama génère 11 % de jetons par seconde en plus, mais l'utilisateur médian attend 2 569 ms pour le premier jeton, contre 524 ms pour Qwen3. Un point ressort des données : le p95 E2E de Llama (10,4 s) est inférieur à celui de Qwen3 (11,4 s), bien que son TTFT soit bien moins bon. Llama démarre lentement mais décode rapidement. Une fois que les jetons commencent à circuler, ils le font plus vite que sur Qwen3. Cependant, pour les interfaces en streaming, c'est ce délai du premier jeton que les utilisateurs ressentent réellement.
Les analyses complètes par centile à chaque niveau de concurrence, les résultats pour le trafic en rafale de type Poisson et les fichiers CSV téléchargeables sont disponibles dans le benchmark interactif rapport.
À faible concurrence, les trois modèles ont démarré avec un TTFT p50 à peu près identique, autour de 350 ms. Qwen3 s'y est maintenu. À 16 utilisateurs simultanés, le p50 de Qwen3 était de 388 ms, tandis que celui de Llama était déjà monté à 794 ms.
Qwen3 a traité toutes les requêtes à chaque niveau de concurrence jusqu'à 256. Aucune requête n'a été abandonnée. Le TTFT p50 à 64 utilisateurs simultanés était de 524 ms avec un débit de 851 tok/s.
Notre hypothèse de travail sur sa résistance à la charge : Qwen3 utilise QK-LayerNorm, qui stabilise les scores d'attention avec de longs caches KV, et son empreinte KV par couche légèrement plus petite offre à vLLM une plus grande marge de manœuvre avant que les requêtes ne commencent à s'accumuler à la passerelle. Le FFN plus large de Llama (14 336 contre 12 288 pour Qwen3) génère un débit par jeton plus élevé mais sature plus rapidement le pipeline de décodage, laissant moins de place aux nouvelles pré-remplissages à mesure que la concurrence augmente. Nous poursuivons nos recherches, mais la différence d'architecture semble jouer ici un rôle clé.
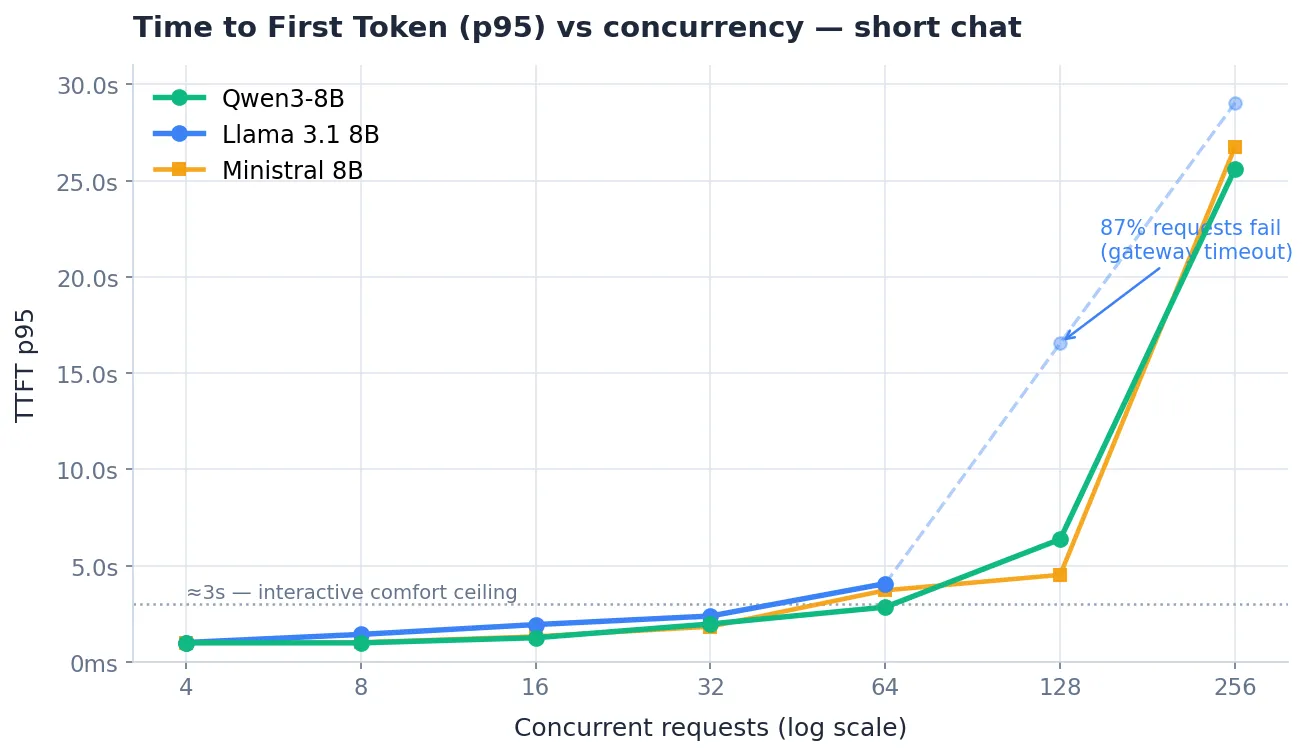
Llama a enregistré le débit brut le plus élevé au pic : 1 181 tok/s à une concurrence de 256. Cependant, à une concurrence de 128, 86,9 % des requêtes ont reçu des erreurs 408. Le chiffre de 1 181 tok/s provient des quelques requêtes ayant abouti après que le serveur a déjà éliminé la majeure partie de sa file d'attente.
À 64 utilisateurs simultanés (le dernier point de mesure propre), Llama a délivré 947 tok/s avec un TTFT p95 de 4 062 ms et 0 % d'erreurs. C'est 11 % de débit en plus que Qwen3 à la même charge. Pour l'inférence par lots ou les pipelines asynchrones où les tentatives sont acceptables, cet avantage de débit est réel. Pour un usage interactif, limitez-vous à 32-64 utilisateurs simultanés.
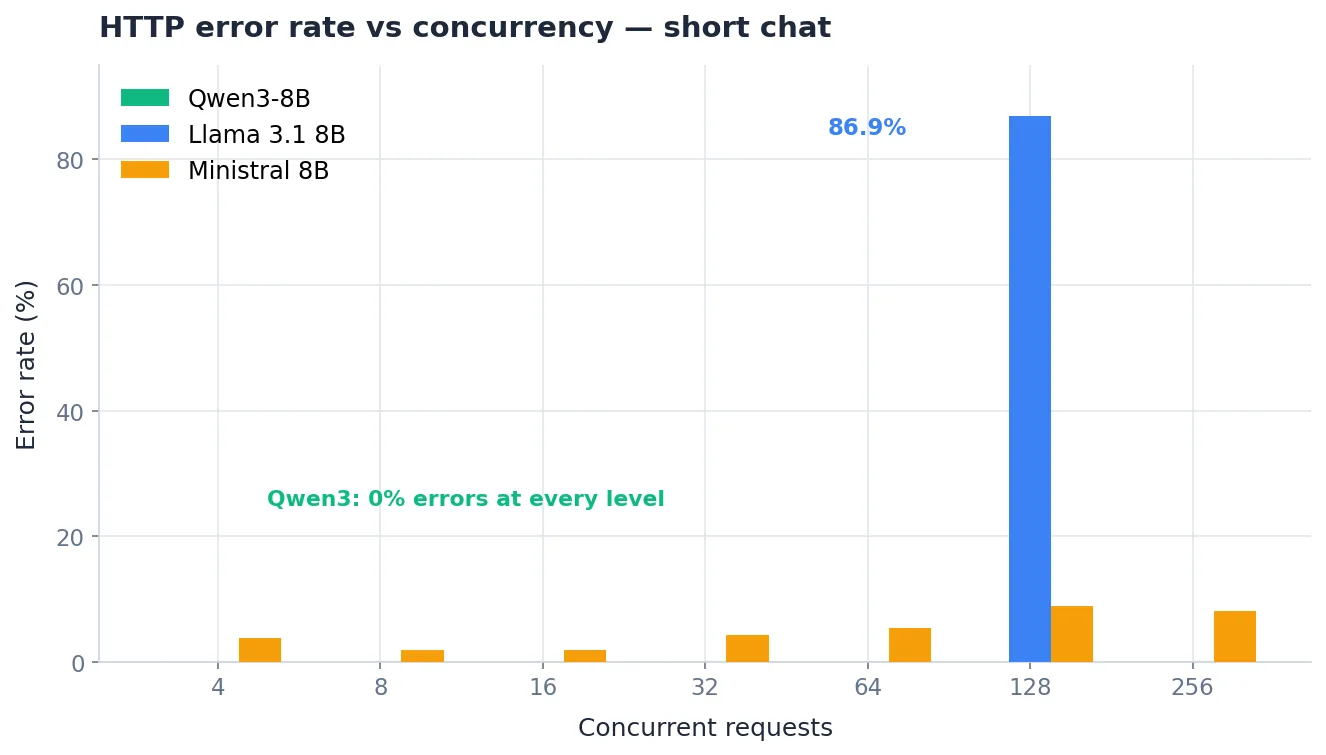
Nous devons signaler ceci en toute transparence. Ministral a montré 3,8 % d'erreurs HTTP réelles à une concurrence de 4, la charge la plus légère que nous ayons testée. À 64, ce taux était de 5,3 %. À 128, il a atteint 8,9 %. Il s'agissait de véritables échecs 408/503, et non d'artefacts de benchmark. Cela reflète probablement une instabilité de déploiement durant notre fenêtre de test plutôt qu'une limitation fondamentale du modèle, mais les données sont ce qu'elles sont.
Là où les requêtes ont réussi, la latence de Ministral était compétitive : TTFT p50 de 350 ms à la base et 512 ms à une concurrence de 64, proche des 524 ms de Qwen3. Les chiffres de latence ne signifient cependant pas grand-chose si environ 1 requête sur 20 ne reçoit jamais de réponse.
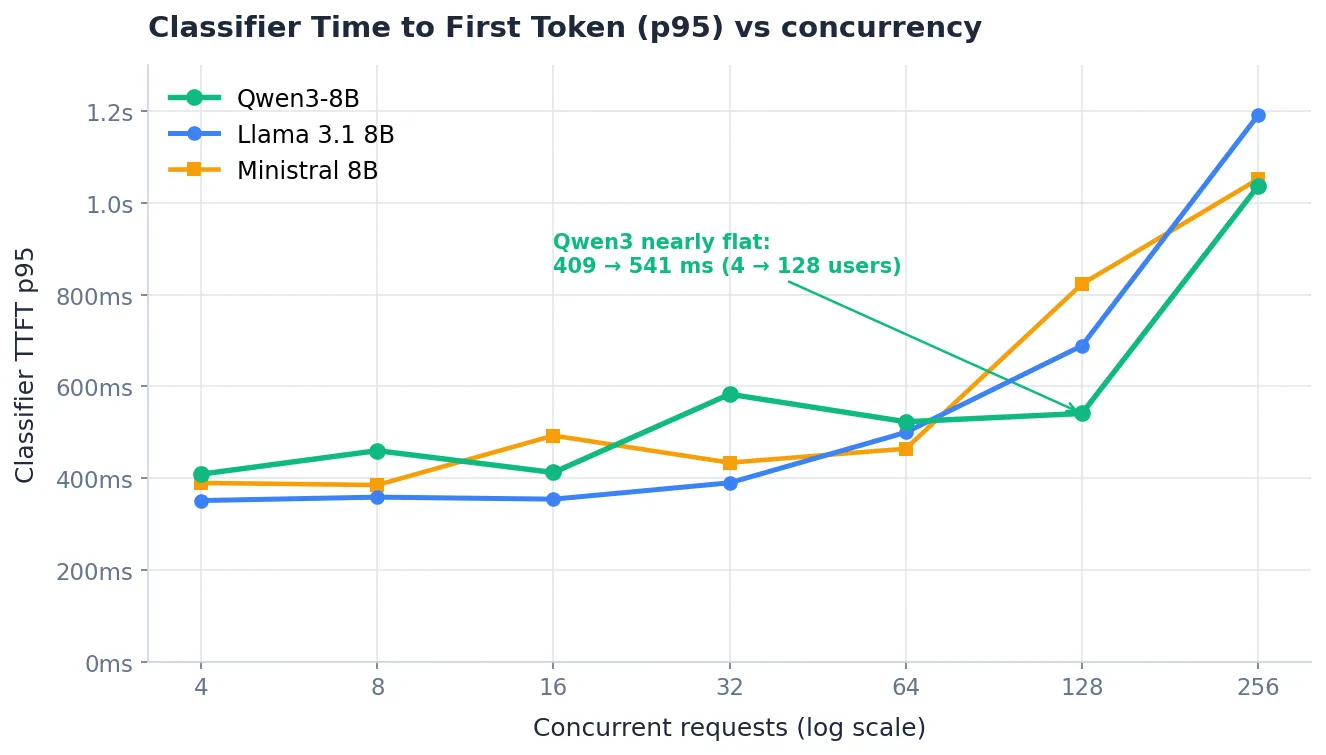
Pour la charge de travail de classification, les trois modèles ont fonctionné sans erreur jusqu'à 256 utilisateurs simultanés. Llama est arrivé en tête en nombre de requêtes brutes par seconde (173 RPS), suivi de Qwen3 (157 RPS) et Ministral (143 RPS).
Le chiffre le plus révélateur est l'évolution de la latence sous la charge. Le TTFT p95 de Qwen3 à 128 utilisateurs simultanés était de 541 ms, soit seulement 32 % au-dessus de sa base de 409 ms. Le p50 est passé de 358 ms à 467 ms. Le p95 de Llama a presque doublé (de 351 ms à 689 ms). Celui de Ministral a plus que doublé (de 390 ms à 823 ms).
Si vous avez besoin d'un routeur d'intention ou d'un classificateur avec une latence prévisible sous un trafic irrégulier, la courbe plate de Qwen3 mérite votre attention. Le GPU absorbe les courtes requêtes de classification dans un seul lot sans mise en file d'attente, et cela se voit dans les chiffres.
Les trois modèles commencent au même niveau et évoluent de manière linéaire jusqu'à 16 utilisateurs simultanés. L'écart se creuse au-delà.
Au-delà de 64, le débit de Llama continue d'augmenter sur le papier (1 181 tok/s à 256), mais la plupart des requêtes sont rejetées. Qwen3 plafonne autour de 830-850 tok/s et traite chaque requête. Ministral affiche un débit inférieur d'environ 15 % à celui de Qwen3 à 64 utilisateurs simultanés, même parmi les requêtes ayant réussi.
Le chiffre de pic brut sans taux d'erreur associé ne signifie quasiment rien pour la planification de la capacité. Ces trois benchmarks vLLM l'illustrent parfaitement.

Nous avons exécuté ce benchmark vLLM sur une instance spot A10 déployée via TrueFoundry. La configuration vLLM complète et les commandes GuideLLM seront publiées avec l'article détaillé.
La couche de service de modèles de TrueFoundry déploie des backends vLLM sur n'importe quel type de GPU (A10, A100, H100) directement depuis le plan de contrôle. Vous choisissez le modèle, définissez max_model_len et tensor_parallel_size, et TrueFoundry gère le conteneur, l'allocation GPU et les contrôles de santé. Le modèle est disponible sur un point de terminaison standard compatible avec OpenAI.
En amont de vLLM, la solution AI Gateway de TrueFoundry ajoute environ 3 à 4 ms de latence tout en gérant plus de 350 RPS sur un seul vCPU. Elle vous permet de définir des limites de débit par modèle, d'attribuer les coûts, de gérer le routage de secours entre les fournisseurs et d'obtenir un suivi complet des requêtes. Si vous comparez plusieurs modèles (comme dans ce benchmark), vous pouvez router les trois via le même point de terminaison de passerelle et basculer entre eux en modifiant le champ du modèle dans la requête. L'URL et les identifiants restent identiques.
TrueFoundry prend en charge plus de 1 000 LLM via une API unique compatible avec OpenAI ; ainsi, passer d'un modèle open-weight testé à un fournisseur commercial ne nécessite aucune modification côté client.
Pour les équipes qui auto-hébergent des modèles open-weight derrière une passerelle, cette architecture permet de séparer la couche de service du routage et de la gouvernance. Consultez Les 10 meilleurs outils d'observabilité LLM en 2026 pour surveiller votre déploiement vLLM une fois qu'il est en production.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




A vLLM benchmark measures how a model served via vLLM performs under concurrent load. The key metrics are time to first token (TTFT), end-to-end latency, token throughput, and error rates at different concurrency levels. The most useful vLLM benchmarks sweep from low to high concurrency to find the point where performance degrades or requests start failing, since peak throughput numbers without error rates are misleading.
In this benchmark, Qwen3-8B was the only model to complete every request at every concurrency level through 256 concurrent users with zero errors. Llama 3.1 8B was clean through 64 concurrent but hit 87% error rates at 128. Ministral 8B had persistent errors starting at concurrency 4.
Based on this vLLM performance benchmark, 64 concurrent users is the last clean operating point for Llama 3.1 8B on a 24 GB A10. At 128 concurrent, 87% of requests fail with gateway timeouts. For interactive workloads, stay at or below 64. For batch jobs with retry logic, you can push higher.
Any LLM, embedding, or custom model via high-performance backends like vLLM, TGI, and Triton, all deployable in the same control plane as the gateway.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception