August 26, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna sont désormais disponibles sur TrueFoundry AI Gateway
Mardi a été une journée chargée pour tous ceux qui gèrent du trafic LLM en production. Anthropic a sorti Claude Opus 5.5, et quelques minutes plus tard, OpenAI a publié GPT-6 Sol et GPT-6 Luna, deux déclinaisons plus économiques de GPT-6 Astra.
Ces trois modèles sont dès à présent intégrés au catalogue de modèles de TrueFoundry AI Gateway, avec leurs tarifs, leurs limites de contexte et leurs fonctionnalités pré-renseignés. Vous les appelez depuis le même point de terminaison compatible OpenAI que vous utilisez pour tout le reste. Aucun nouvel SDK, aucune intégration séparée, aucune attente de mise à jour de la passerelle. Changez la chaîne de caractères du modèle et vous êtes sur le nouveau modèle.
Essayez-les sur la TrueFoundry AI Gateway →
Selon Anthropic, Opus 5.5 offre des performances équivalentes à celles de Claude Fable 5.1 sur la plupart des tâches, au tarif Opus. Ce qu'il faut retenir pour un budget de production :
Sol et Luna ont été entraînés avec les mêmes méthodes que GPT-6 Astra (arrivé le 3 septembre à 10 $ / 50 $), puis optimisés pour réduire les coûts. OpenAI oriente Sol vers le code récurrent et le travail d'agent, et Luna vers les tâches de routine à fort volume comme l'extraction et la synthétisation.
En mettant côte à côte les modèles de septembre, l'écart est difficile à ignorer : Luna à 0,10 $ par million de tokens d'entrée, Sol à 2 $, Opus 5.5 à 4 $, Astra à 10 $. Un rapport de un à cent entre l'option la moins chère et la plus onéreuse, provenant de deux fournisseurs, sur deux API natives différentes.
Cet écart résume à lui seul pourquoi il ne faut pas choisir un seul modèle par défaut pour tout lui envoyer. La majeure partie du trafic en production se compose de nombreuses requêtes simples et de quelques requêtes complexes. Envoyez la majorité simple à Luna et la minorité complexe à Opus 5.5, et la facture globale ne ressemblera en rien à une facture 100 % Opus. Cela ne fonctionne que si le changement de modèle relève d'une modification de configuration plutôt que d'un changement de code, ce qui est précisément la raison d'être de l'AI Gateway.
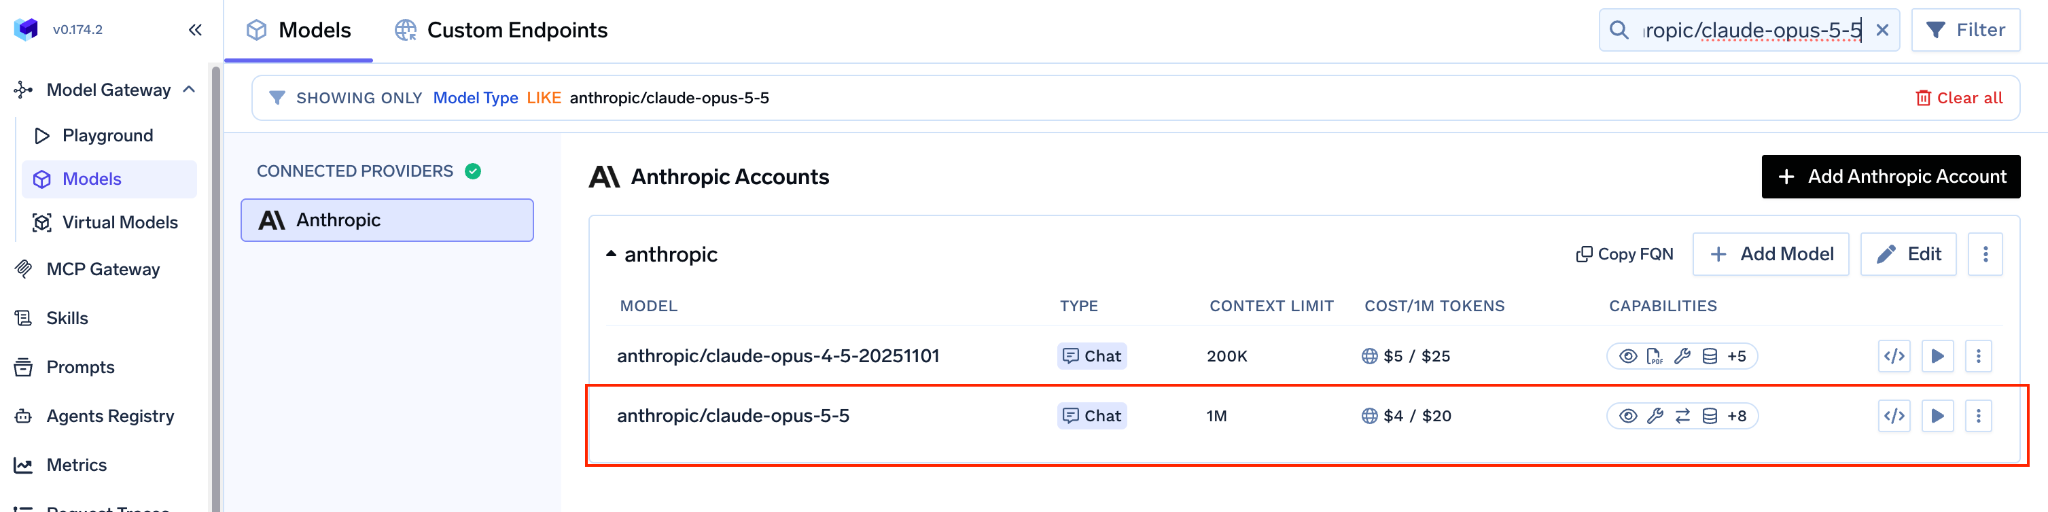
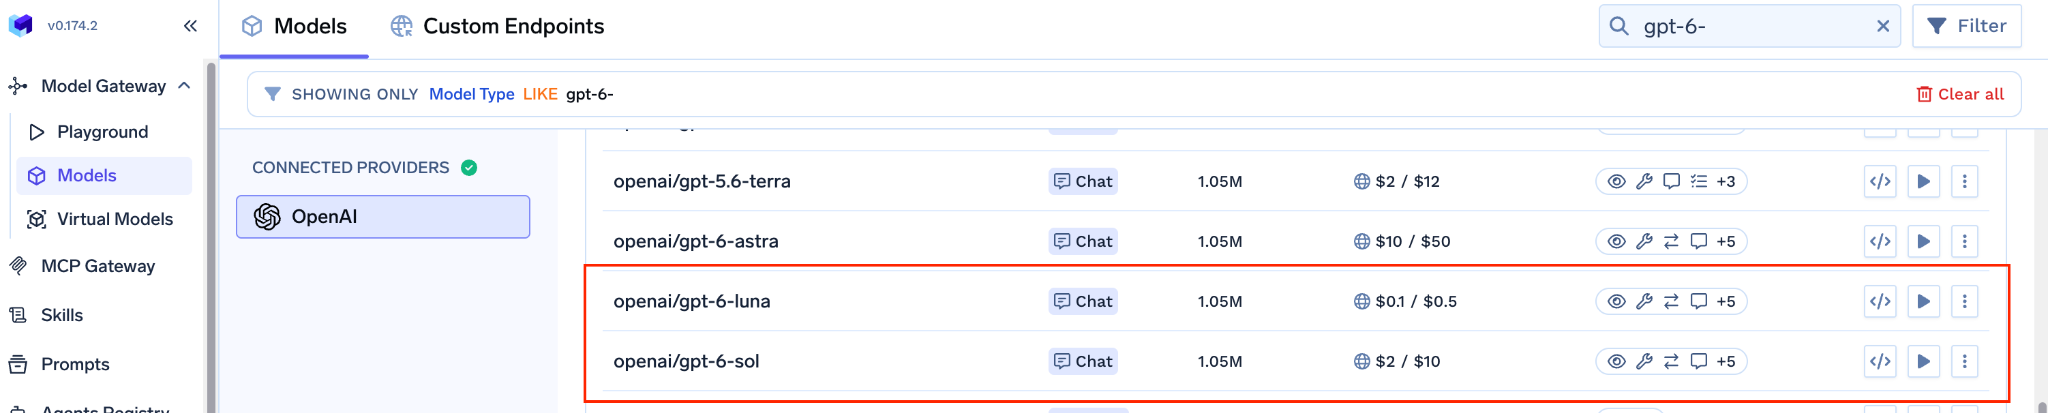
Dans la passerelle, ouvrez Models → votre compte Anthropic → Models Selection, recherchez claude-opus-5-5 et cochez-le. La tarification s’affiche directement (4 $ entrée / 20 $ sortie par million de tokens) car elle provient en direct du catalogue. Définissez ensuite l'Access Control pour qu'un modèle au tarif frontière soit restreint aux bonnes équipes et clés virtuelles dès le premier jour.
Répétez l'opération dans votre compte OpenAI pour gpt-6-sol et gpt-6-luna.
Si vous exécutez ces modèles via un fournisseur cloud, le catalogue couvre également ces accès :
Vous ne voyez pas encore un modèle dans votre liste ? Le bouton + Add Model au bas de la liste permet de l'ajouter manuellement. La passerelle prend en charge tous les modèles texte publiés par Anthropic et OpenAI.
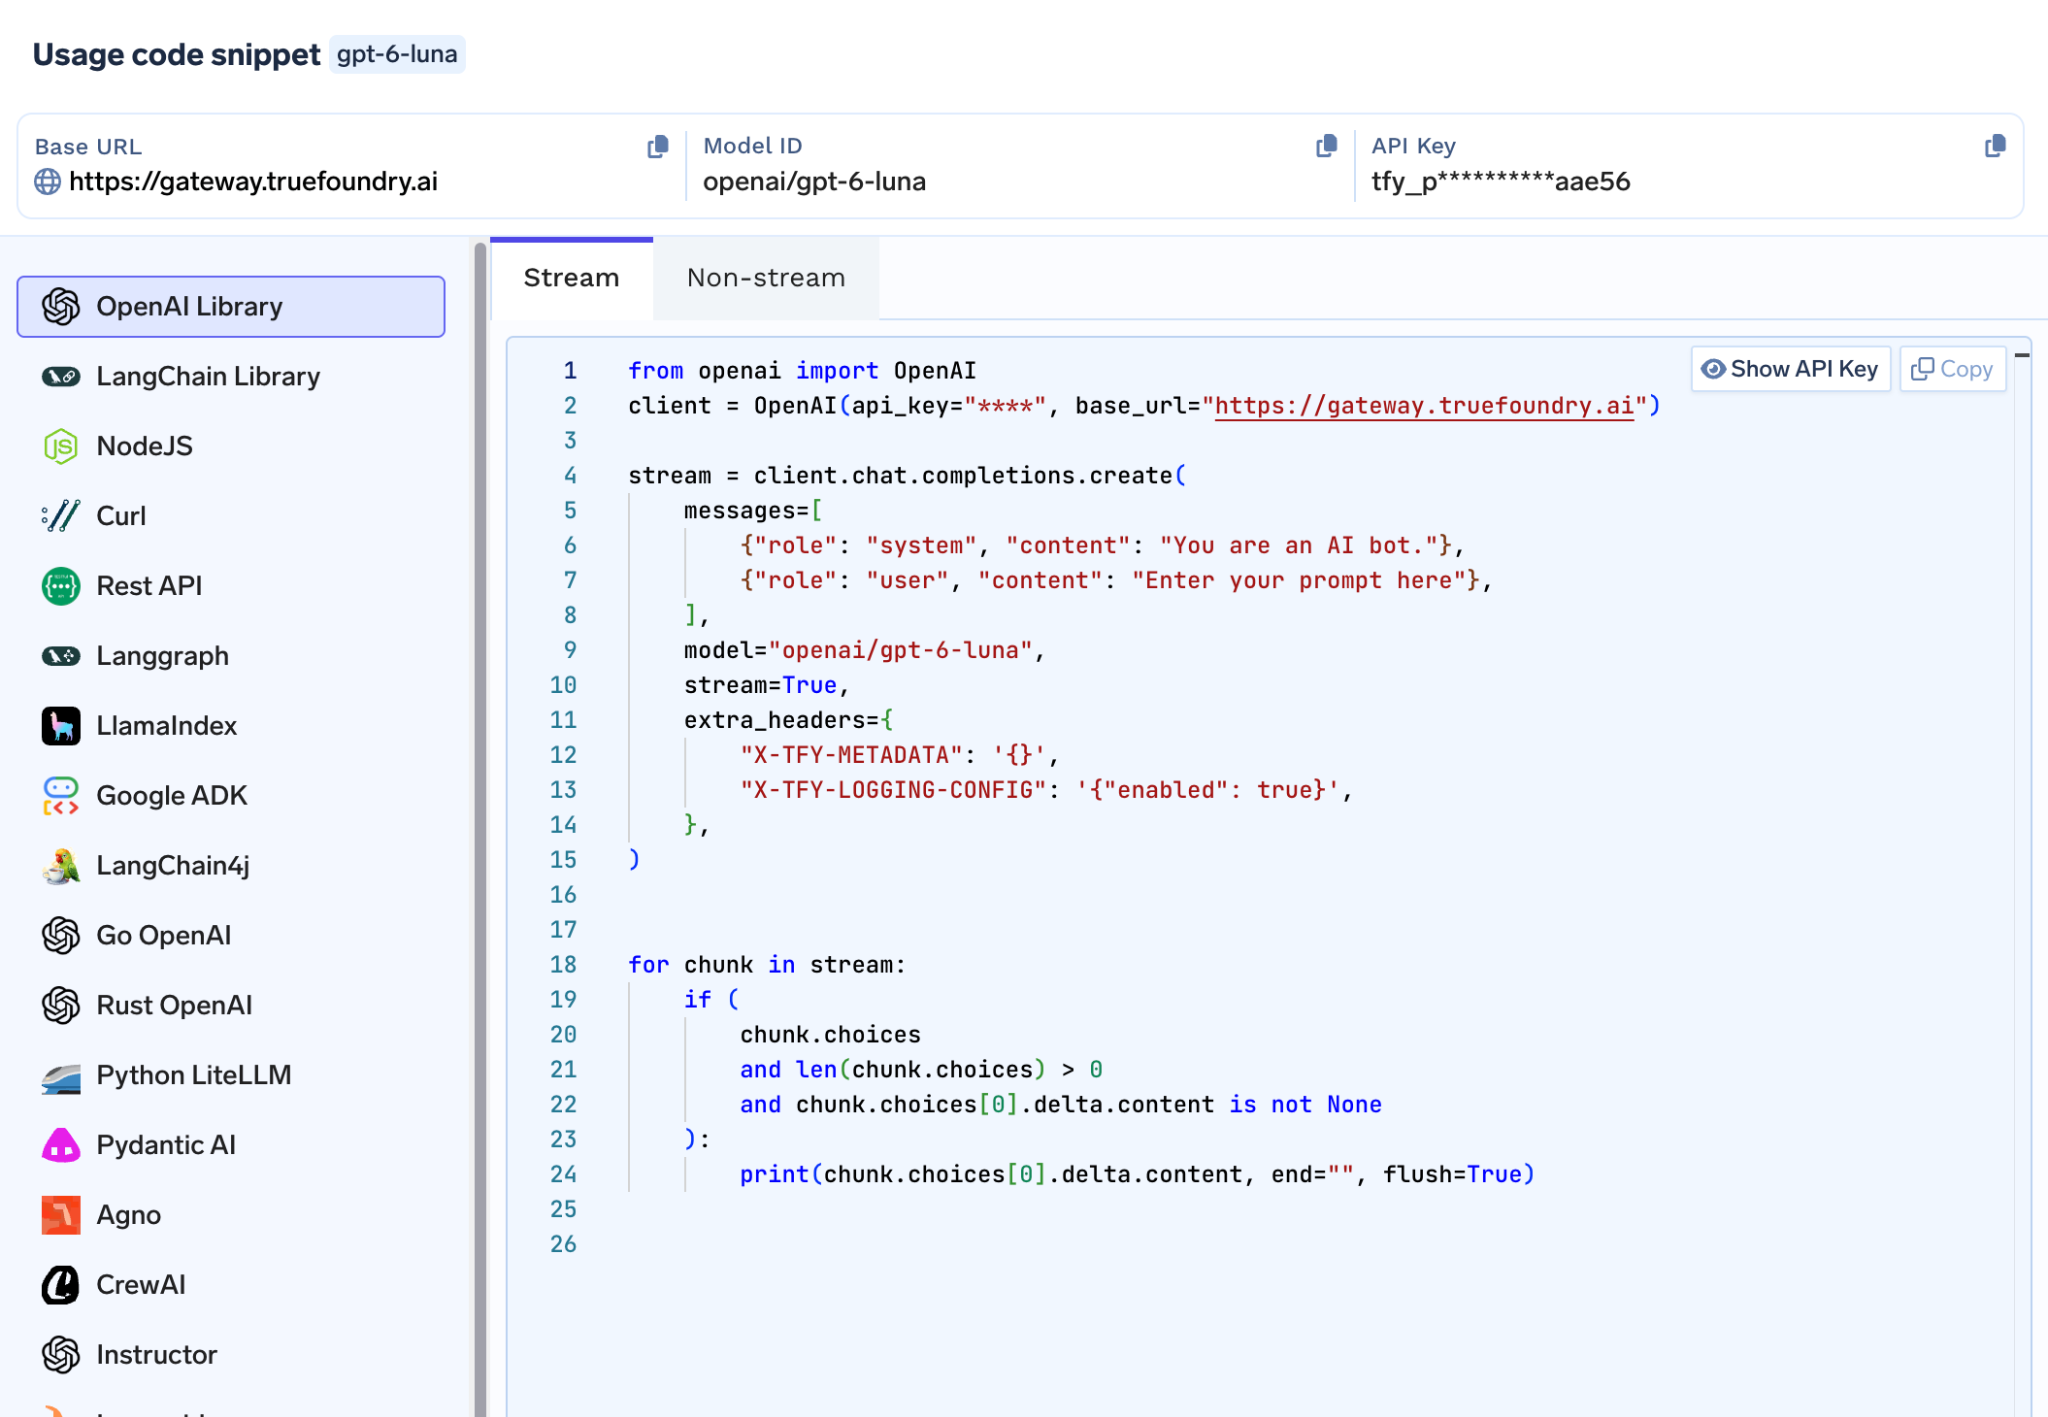
Ouvrez le Playground, choisissez un modèle et copiez le extrait de code généré dans le SDK de votre choix (OpenAI SDK, LangChain, Node.js, cURL et autres). Voici la version Python pour OpenAI :
Les identifiants de modèles utilisent un espace de noms sous la forme <votre-compte-fournisseur>/<modèle>. Ainsi, passer de anthropic-prod/claude-opus-5-5 à openai-prod/gpt-6-luna se fait en modifiant une seule ligne. L'en-tête X-TFY-METADATA étiquette chaque appel afin que les dépenses apparaissent par équipe ou par fonctionnalité dans la vue des métriques.
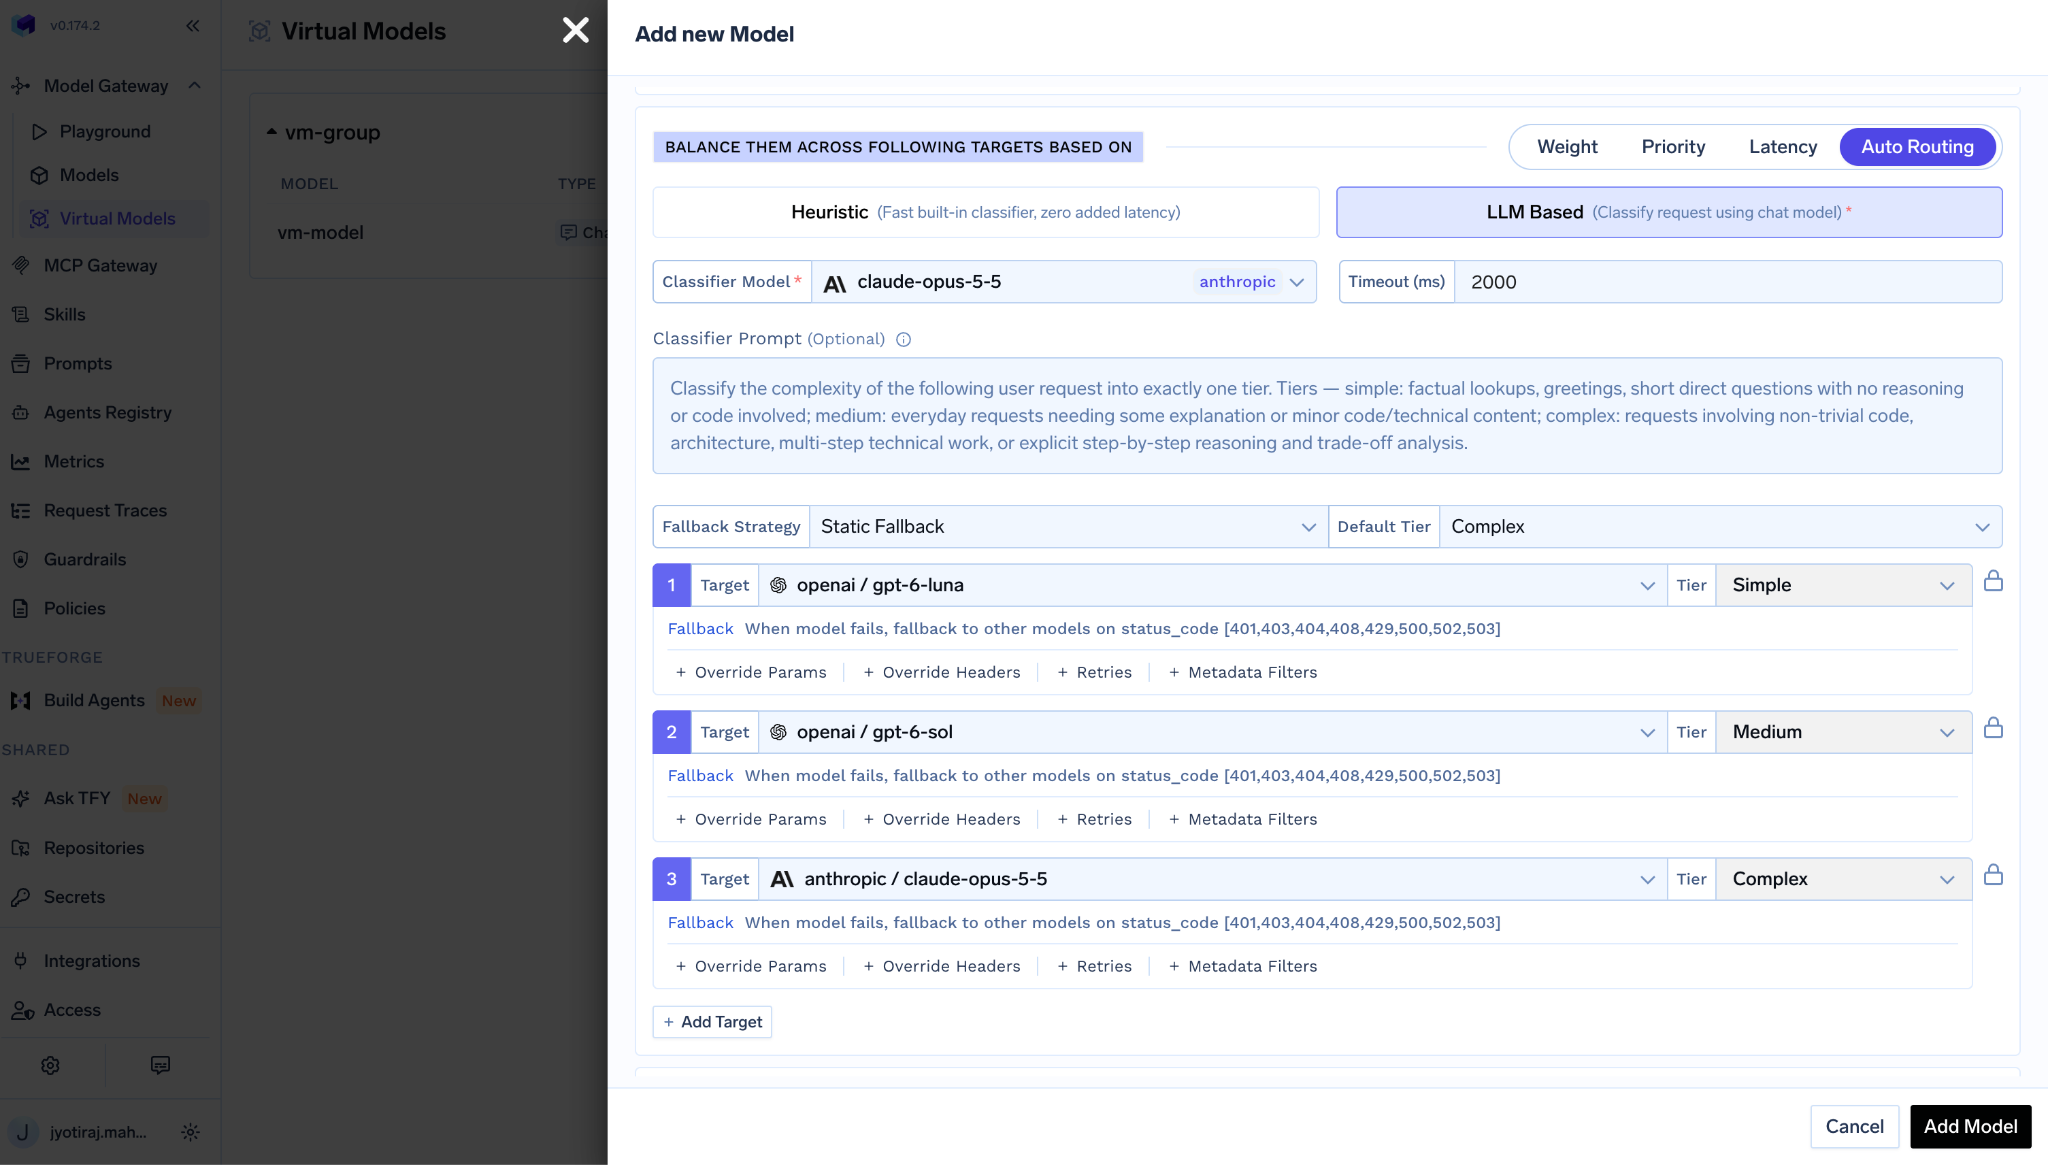
Créez un modèle virtuel et sélectionnez l'Auto Routing. La passerelle classifie chaque requête comme simple, moyenne ou complexe et la redirige vers la cible attribuée à ce niveau. Choisir Luna pour les requêtes simples, Sol pour les moyennes et Opus 5.5 pour les complexes constitue une cartographie de départ judicieuse. Dans nos tests comparatifs, ce type de routage a réduit les coûts de 50 à 70 % tout en préservant environ 98 % de la qualité. Ajoutez Opus 5 ou Astra comme cible de secours (fallback). Votre application appelle un nom de modèle unique tout au long du processus.
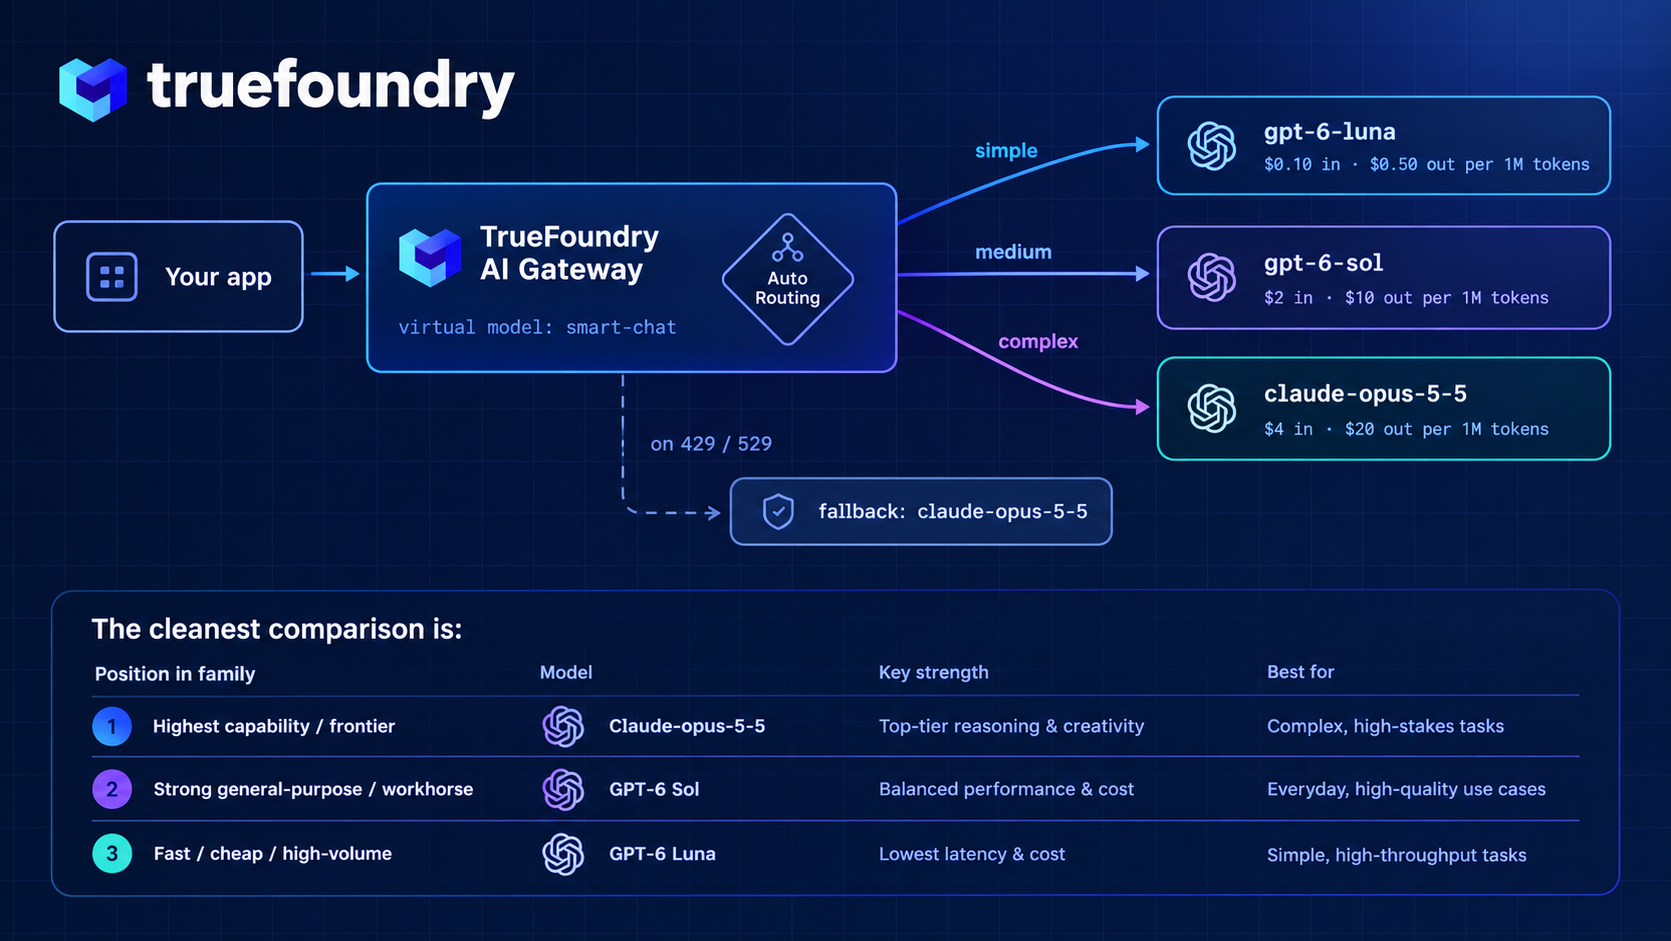
Opus 5.5 est le modèle vers lequel se tourner lorsque la tâche est complexe et que le tarif de Fable n'était pas justifié. Sol et Luna sont ceux à privilégier lorsqu'elle n'est pas complexe du tout. Les exécuter tous via TrueFoundry signifie que la décision d'attribuer l'un ou l'autre réside dans la configuration de la passerelle, où vous pouvez la modifier un mardi après-midi sans nécessiter de déploiement.
Essayez Claude Opus 5.5, GPT-6 Sol et GPT-6 Luna sur la TrueFoundry AI Gateway →
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception