



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le domaine des agents souffre d'un problème de vocabulaire. Après une période au cours de laquelle « harness », « scaffold », « skill » et « agent » avaient une signification différente dans chaque conversation, Hugging Face a publié un glossaire largement partagé qui offre au secteur un vocabulaire de travail utile. Il vaut la peine d'être lu. Mais un glossaire répond à la question « que signifie ce mot ? » — et la question suivante, celle avec laquelle les équipes plateforme vivent réellement, est « où cette chose réside-t-elle concrètement dans ma stack ? » Cet article reprend ce vocabulaire de travail et associe chaque terme à l'élément d'infrastructure de production qui l'implémente. Les mots proviennent d'un vocabulaire communautaire émergent ; le câblage est ce que les équipes de production doivent concrétiser.
Elif, responsable de l'ingénierie plateforme, a vu une réunion de pilotage consommer quarante minutes sur une question qui n'aurait pas dû en prendre cinq : « combien d'agents avons-nous ? » L'équipe d'ingénierie a compté les déploiements de harness et a répondu neuf. L'équipe data a compté les prompts avec outils et a répondu une trentaine. Une diapositive d'un fournisseur a compté chaque workflow avec un appel LLM et a répondu deux cents. Personne ne se trompait selon sa propre définition ; personne ne partageait la même définition. La même réunion a achoppé sur la question de savoir si un « skill » était un outil, si le nouveau « sous-agent » était un agent à des fins d'inventaire, et ce que l'équipe achetait exactement lorsqu'un produit indiquait « harness inclus ». La conclusion d'Elif n'était pas que ses collègues manquaient de rigueur. C'était que les mots du secteur avaient évolué plus vite que sa compréhension partagée — et que tant que les mots ne seraient pas rattachés à des éléments de la stack, chaque conversation sur l'architecture serait secrètement une querelle de vocabulaire.
La communauté s'est efforcée de clarifier ces définitions — de manière très visible dans le glossaire des agents de Hugging Face, né précisément de cette confusion lors d'ICLR 2026 et sur lequel nous nous appuyons (en lui rendant crédit) tout au long de cet article. Ce que cet article apporte, c'est la deuxième colonne dont Elif avait besoin : pour chaque terme, le composant de production qui l'implémente, et la gouvernance qui s'y rattache une fois qu'il s'agit d'une infrastructure réelle plutôt que d'une étiquette sur un schéma. Il ne s'agit pas de remplacer le glossaire de Hugging Face ; c'est la colonne infrastructure à côté de celui-ci. Nous allons parcourir la stack de l'intérieur vers l'extérieur — modèle, scaffold, harness, agent — puis le vocabulaire de travail qui l'entoure : l'ingénierie de contexte, le spectre outil/skill/sous-agent, la politique, et les termes d'entraînement qui s'avèrent également importants en production. Quatre analyses approfondies suivent cet article ; ceci en est la carte.
Commençons là où le glossaire commence. Le modèle est le LLM lui-même : du texte en entrée, du texte en sortie, pas de mémoire entre les appels, pas de boucle, pas de capacité à exécuter quoi que ce soit. Il peut exprimer l'intention d'appeler un outil — émettre une requête structurée — mais un élément extérieur doit exécuter cet outil et renvoyer le résultat. Appeler le modèle « l'agent » est l'erreur de catégorie originelle : le modèle est le moteur de raisonnement, et à lui seul, il répond à un prompt et s'arrête.
En termes de production, le modèle est également la partie la plus interchangeable — c'est précisément pourquoi il doit se trouver derrière une abstraction. Sur TrueFoundry, les modèles sont accessibles par leur nom via l'API unique compatible OpenAI de l'AI Gateway : modèles frontières commerciaux, modèles open-weight hébergés en propre et checkpoints affinés derrière une interface de passerelle commune, avec le RBAC, les budgets, l'observabilité et les guardrails appliqués de manière centralisée là où le trafic passe par la passerelle. La conséquence architecturale du fait que « le modèle n'est qu'un composant parmi d'autres » est que son changement doit être une modification de configuration — le sujet de notre article sur l'API unifiée — et tout le reste dans ce glossaire représente ce qui reste en place lorsque vous le remplacez.
Voici la distinction que le glossaire vise à établir, et celle qui crée le plus de confusion dans la pratique. Le scaffold est la couche définissant le comportement à partir de laquelle le modèle travaille : le system prompt, les descriptions d'outils, les formats de sortie qu'il doit suivre, les règles pour ce qui est transmis entre les étapes. Il façonne la façon dont le modèle perçoit son environnement. Le harness est la couche d'exécution qui fait fonctionner l'agent : la boucle qui appelle le modèle, analyse ses requêtes d'outils, les exécute réellement, renvoie les résultats, gère les erreurs et décide quand s'arrêter. Le scaffold correspond aux instructions ; le harness correspond à la machinerie. Des produits comme Claude Code utilisent souvent le terme « harness » au sens large pour tout ce qui n'est pas le modèle, ce qui convient comme raccourci — la distinction prend tout son sens lorsque vous devez raisonner sur les couches séparément, ce qui est constamment le cas en production : une modification de prompt est un changement de scaffold que vous pouvez déployer en quelques minutes ; un changement des conditions d'arrêt ou de la gestion des erreurs est un changement de harness avec un rayon d'impact important.
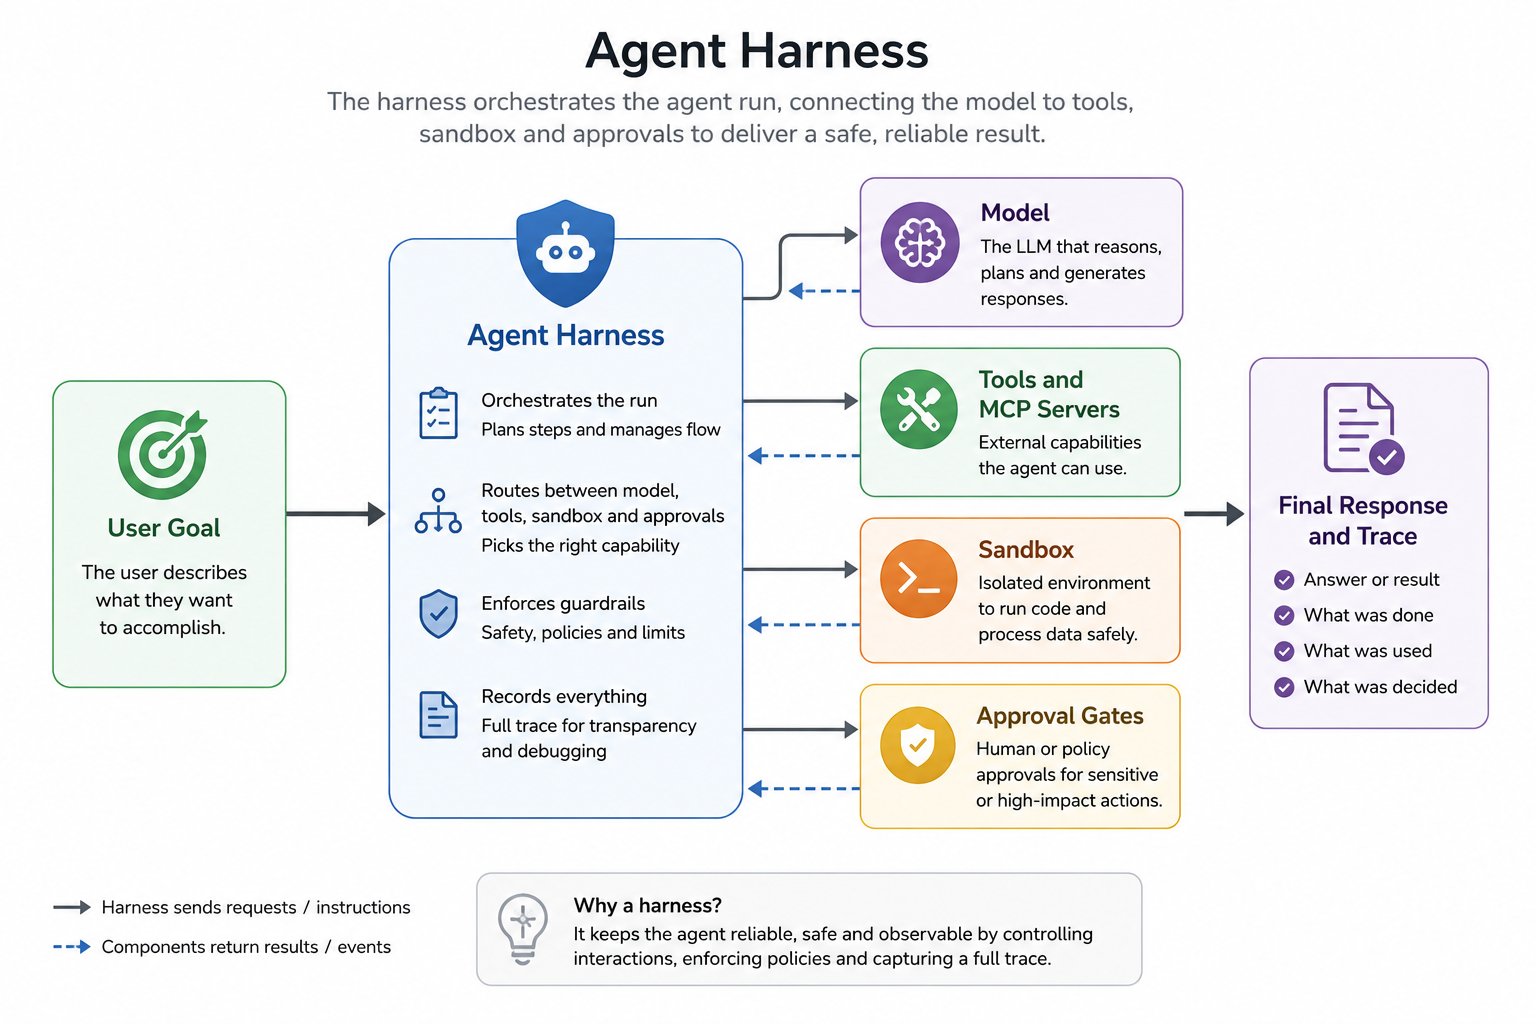
Sur TrueFoundry, les deux couches ont deux emplacements différents, ce qui clarifie les choses. Les artefacts de scaffold — instructions, versions de prompt, descriptions d'outils, skills — sont du contenu géré : versionné, révisable, contrôlé par RBAC. Le harness est le runtime géré : l'Agent Harness de TrueFoundry exécute la boucle plan→act→observe, exécute les outils via des passerelles gouvernées, gère le sandbox, applique les portes d'approbation et enregistre les étapes des exécutions gouvernées de l'Agent Harness. Vous rédigez le scaffold ; la plateforme opère le harness. L'analyse approfondie qui suit cet article est entièrement consacrée à cette séparation et à la discipline que la communauté appelle désormais l'ingénierie de harness.
Une fois ces deux couches nommées, l'agent cesse d'être mystique : un agent est un modèle plus tout ce qui l'entoure pour lui permettre d'agir plutôt que de simplement répondre — la formulation que la communauté résume par agent = modèle + harness. L'héritage provient de l'apprentissage par renforcement, où un agent est simplement l'entité qui prend des observations et renvoie des actions dans une boucle ; la version LLM conserve cette boucle et remplit l'étape de décision avec un modèle. Deux conséquences pratiques découlent de cette équation, et toutes deux méritent d'être assimilées.
Premièrement, ce que les utilisateurs perçoivent comme un « produit agent » réside souvent dans le harness et le scaffold qui entourent le modèle. Lorsque deux produits basés sur le même modèle sous-jacent semblent complètement différents, la différence réside dans le harness et le scaffold — la conception de leur boucle, leur gestion du contexte, leurs ensembles d'outils. Le modèle, le harness et le produit sont trois choses différentes, et évaluer « un agent » sans préciser dans quel harness il a fonctionné n'a pratiquement aucun sens. Deuxièmement, l'inventaire devient possible. La question d'Elif « combien d'agents avons-nous ? » a une réponse une fois qu'un agent est une entité concrète et enregistrée : une définition (modèle + scaffold + attributions d'outils) plus un runtime. Pour les agents exécutés via l'Agent Harness de TrueFoundry, l'agent devient une définition enregistrée faisant référence à un modèle, des serveurs MCP et des skills par leur nom, avec des identifiants conservés au niveau de la passerelle plutôt qu'intégrés dans la définition — ce qui rend la partie gouvernée du parc d'agents quantifiable et auditable au lieu d'être un débat de vocabulaire.
Une définition d'agent, annotée avec le glossaire (illustratif)
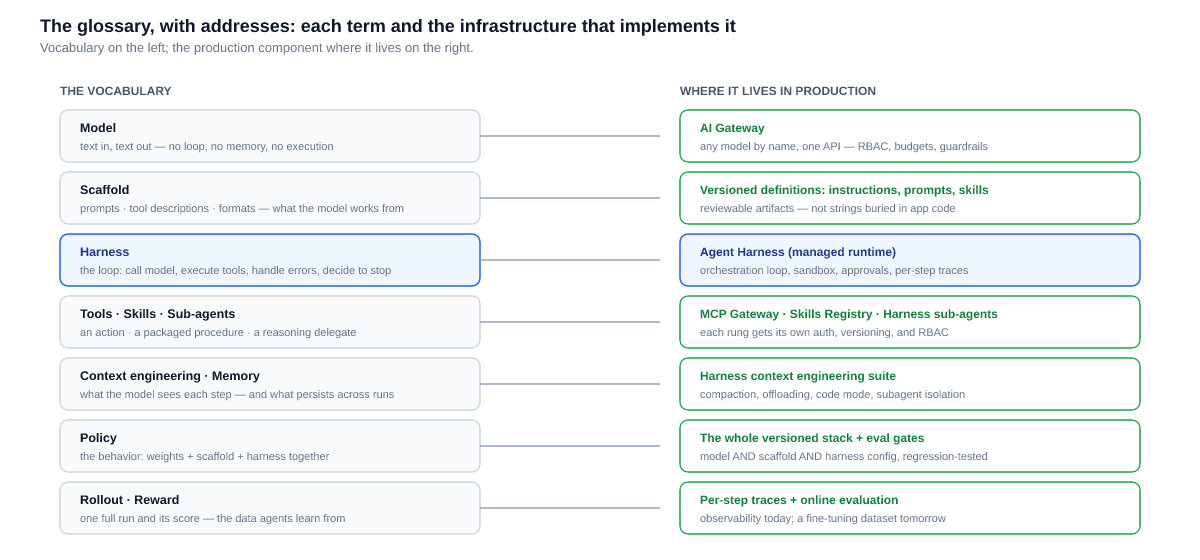
En prenant du recul par rapport au runtime, l'ensemble du vocabulaire s'aligne de la même manière : chaque terme à gauche est un concept, et chacun possède un emplacement de production concret à droite.
L'ingénierie de contexte est la discipline qui consiste à décider ce que le modèle voit à chaque étape : quelles instructions, quelles descriptions d'outils, quelle portion d'historique, quels faits récupérés. Il ne s'agit pas d'une décision de prompt ponctuelle, car dans un agent, le contexte est vivant — le résultat de chaque tour façonne l'entrée du tour suivant, et un harness qui ne gère pas activement cette accumulation voit son agent se dégrader à mesure que la fenêtre se remplit. Le glossaire sépare clairement la mémoire : la mémoire à court terme est ce qui reste dans la fenêtre pendant une exécution ; la mémoire à long terme persiste d'une session à l'autre de manière externe et est récupérée lorsque cela est pertinent.
En production, il s'agit d'une responsabilité du harness, et non de l'auteur du prompt — aucun humain ne peut sélectionner à la main le contexte d'une exécution en 40 étapes. L'Agent Harness de TrueFoundry intègre une suite d'ingénierie de contexte qui effectue cette sélection automatiquement : la compaction résume un long historique et poursuit l'exécution ; le déchargement de grands résultats évite d'inclure une réponse d'outil volumineuse dans la fenêtre et la charge à la demande ; le mode code permet à l'agent de traiter des données volumineuses avec du code au lieu de les lire dans le contexte ; les sous-agents (section suivante) isolent les sous-tâches dans de nouvelles fenêtres. Nous traitons du mode de défaillance que cela évite — la communauté l'appelle le « context rot » — dans son propre article ; ici, l'association est l'élément clé : « ingénierie de contexte » désigne le travail que, dans un runtime géré, le harness effectue pour vous.
La clarification la plus utile du glossaire sur le plan pratique est la frontière entre trois éléments qui ressemblent tous à « l'agent qui fait quelque chose ». Un outil est une action : un appel de fonction unique — exécuter cette commande, interroger cette API — exécuté par le harness et renvoyé. Un skill est une connaissance packaged : une procédure structurée et réutilisable pour un objectif multi-étapes (« analyser le bug, former une hypothèse, écrire le correctif »), chargée dans le contexte à la demande plutôt qu'exécutée en un seul appel. Un sous-agent est un délégué de raisonnement : un agent invoqué par un autre agent, avec son propre modèle, son propre scaffold et son propre contexte, qui traite la sous-tâche de manière indépendante et renvoie un résultat. La frontière varie selon les frameworks — le glossaire l'indique honnêtement — mais le spectre lui-même reste stable : action, procédure, délégué.
La raison pour laquelle cette distinction importe en production est que chaque échelon nécessite une gouvernance différente. Un outil a besoin d'authentification et d'autorisation par appel — ce que fournit l'MCP Gateway : registre, authentification centralisée, RBAC par outil, guardrails avant et après l'appel. Un skill a besoin de versionnage et de traçabilité — qui a écrit cette procédure, quelle version l'agent exécute-t-il — ce que fournit le Skills Registry de TrueFoundry : des artefacts SKILL.md versionnés avec RBAC, montés à la demande. Un sous-agent a besoin d'une identité et d'un contexte délimité — sa propre trace, ses propres permissions, une isolation par rapport à la fenêtre du parent — ce que l'Agent Harness fournit en natif. Si vous réduisez ce spectre à de simples « outils », vous gouvernerez un délégué de raisonnement comme un appel de fonction ; l'analyse approfondie de ce spectre détaille chaque échelon.
Le terme « politique » (policy) est le plus discret du glossaire et, pour les équipes opérationnelles, peut-être le plus important. Empruntée à l'apprentissage par renforcement, une politique est le comportement lui-même — pour n'importe quelle situation, ce que le système va faire. La phrase essentielle est que dans les agents LLM, seule une partie de la politique réside dans les poids du modèle : le reste est déterminé par le scaffold et le harness. Le même checkpoint derrière un system prompt différent, des descriptions d'outils différentes ou une boucle différente constitue, sur le plan comportemental, une politique différente. Une politique n'est pas un agent — la politique est le comportement ; l'agent est le système déployé dont elle régit le comportement.
Si l'on prend cela au sérieux, une habitude opérationnelle courante s'effondre : suivre « quelle version de modèle est en prod » comme si cela répondait à la question « que va faire le système ». Cela ne répond qu'à un tiers de la question. La traduction en production de « politique » est que l'ensemble de la stack déterminant le comportement — nom du modèle, prompts, jeu d'outils et descriptions, skills, configuration du harness — forme un tout versionné, modifié délibérément et testé ensemble contre les régressions, car une modification de prompt d'une ligne est un changement de politique au même titre qu'un changement de modèle. C'est le sujet du quatrième article de cette série ; l'infrastructure qui rend cela gérable repose sur les définitions en tant qu'artefacts (la définition d'agent déclarative de l'Agent Harness), le versionnage des prompts et la boucle d'évaluation en ligne qui détecte une dérive de comportement, quelle que soit la couche qui l'a provoquée.
La dernière section du glossaire aborde le vocabulaire de l'entraînement par renforcement — environnement, entraîneur, rollout, reward — et une équipe de production pourrait être tentée de l'ignorer. Ne le faites pas, car deux de ces termes décrivent des éléments que vous possédez déjà. Un rollout est une exécution complète d'un agent, de bout en bout : ce que l'agent a vu, ce qu'il a fait, ce qui a été renvoyé, étape par étape. Les équipes de production appellent cela une trace. Un reward est le score qui indique si une exécution était bonne — vérifiable (les tests passent, la réponse correspond) ou appris (préférences, LLM-as-a-judge). Les équipes de production appellent cela un signal d'éval. Le pipeline d'entraînement et la boucle de production ont la même structure ; l'un met à jour les poids et l'autre met à jour les tableaux de bord.
La conséquence mérite qu'on s'y arrête : si votre harness enregistre des traces complètes étape par étape et que votre couche d'évaluation les évalue, vous collectez déjà la matière première pour des jeux de données de rollout/reward — des traces accompagnées de signaux de qualité qui peuvent être sélectionnés pour du fine-tuning ou de l'amélioration de type apprentissage par renforcement. Les équipes qui hébergent leurs propres modèles open-weight (notre article sur l'auto-hébergement) peuvent boucler la boucle délibérément : des traces issues de l'Agent Harness, des scores issus de la couche d'éval, un fine-tuning sur TrueFoundry, et le checkpoint amélioré déployé derrière le même nom de passerelle. Le dernier article de cette série détaille cette boucle dans son intégralité. La leçon de vocabulaire est plus simple : « rollout » et « reward » ne sont pas du jargon d'entraînement réservé à d'autres — c'est votre observabilité, vue depuis le futur.
La réunion de quarante minutes d'Elif n'a pas été gaspillée par ignorance ; elle a été gaspillée par ambiguïté, et l'ambiguïté dans le vocabulaire devient de l'ambiguïté dans les systèmes. Lorsque le terme « agent » n'a pas de référent fixe, l'inventaire des agents ne peut pas exister. Lorsque « harness » peut désigner un produit, une boucle ou tout-sauf-le-modèle, une conversation achat-contre-développement sur les harness devient trois conversations sous le même nom. Lorsque « skill » et « outil » se confondent, le modèle de gouvernance se confond avec eux — et des capacités non gardées sont précisément la cause de la prolifération et des agents clandestins (shadow agents). Fixer les mots est la première étape économique vers la fixation de l'architecture.
L'association apportée par cet article constitue la deuxième étape : chaque terme doit avoir un emplacement. Sur TrueFoundry, c'est le cas — les modèles derrière l'AI Gateway, les outils derrière l'MCP Gateway, les skills dans le Skills Registry, la boucle et les sous-agents dans l'Agent Harness, l'ingénierie de contexte en tant que machinerie du harness, la politique en tant que tout versionné, les rollouts en tant que traces alimentant l'évaluation. Rien de tout cela ne nécessite spécifiquement TrueFoundry ; cela nécessite une réponse concrète à la question « où vit ce mot, et qui le régit à cet endroit ? » Les quatre articles qui suivent abordent les termes les plus riches un par un : harness contre scaffold, le spectre outil/skill/sous-agent, la politique en tant qu'élément que vous versionnez réellement, et la boucle rollout-vers-reward en production.
La formule « agent = modèle + harness » est-elle la définition officielle ? Il n'existe pas d'organisme officiel, et le glossaire lui-même prend soin de préciser que de nombreux termes ne disposent pas de définitions universellement acceptées — différents frameworks utilisent réellement les mêmes mots de manière différente. Il vaut mieux la considérer comme un modèle de travail utile et exploitable : elle sépare clairement le moteur de raisonnement de la machinerie qui le fait agir, ce qui correspond à la séparation dont l'architecture de production a besoin. Traitez-la comme un modèle de travail, créditez la source et attendez-vous à des affinements.
Où s'arrête le scaffold et où commence le harness ? La limite la plus nette : le scaffold est ce à partir de quoi le modèle travaille (prompts, descriptions d'outils, formats — le contenu), le harness est ce qui fait fonctionner l'agent (la boucle, l'exécution, la gestion des erreurs, l'arrêt — la machinerie). Les produits utilisent souvent le terme « harness » pour désigner les deux, ce qui ne pose pas de problème jusqu'à ce que vous deviez modifier l'un sans l'autre. Dans la pratique, cette limite est aussi une limite de responsabilité : les auteurs possèdent le scaffold ; la plateforme possède le harness.
Un sous-agent n'est-il qu'un outil du point de vue de l'appelant ? Sur le plan mécanique, il est souvent invoqué comme tel, ce qui explique pourquoi les termes se confondent. La différence réside dans ce qui se trouve de l'autre côté : un outil exécute une fonction ; un sous-agent raisonne — il possède son propre modèle, son propre scaffold, son propre contexte et éventuellement ses propres outils. Cette différence est invisible pour le code appelant, mais majeure pour la gouvernance : un sous-agent nécessite une identité, des permissions et un traçage propres, et non une simple entrée dans la liste d'outils du parent.
Les équipes de production ont-elles réellement besoin des termes de l'apprentissage par renforcement ? Pour deux d'entre eux, oui. En termes de production, un rollout ressemble à une trace et un reward ressemble à un score d'éval — un vocabulaire pour des éléments que vous produisez déjà. Connaître le cadre de l'entraînement devient important le jour où vous souhaitez que vos agents s'améliorent à partir de leur propre historique : des traces complètes associées à des scores de qualité constituent la matière première, et les équipes qui les ont bien capturées disposent d'un jeu de données là où d'autres n'ont que des journaux d'événements (logs).
La standardisation du vocabulaire change-t-elle réellement quelque chose sur le plan technique ? Indirectement, mais de manière significative. Des termes partagés rendent l'inventaire quantifiable (« agent » = définition enregistrée + runtime), permettent de comparer les achats (chaque affirmation « harness inclus » se décompose en boucle, sandbox, approbations, traces) et permettent d'attribuer la gouvernance (l'emplacement de chaque terme a un responsable). Le problème de réunion d'Elif était un problème de système qui ressemblait à un problème de sémantique — c'est généralement le cas.
Un glossaire est une légende de carte ; cet article a cherché à dessiner la carte. Le vocabulaire de la communauté — modèle, scaffold, harness, agent, skill, sous-agent, politique, rollout, reward — s'avère décrire remarquablement bien une architecture de production, terme par terme, à condition que chaque terme reçoive un emplacement. Donnez-lui en un, et les mots cesseront d'être le sujet de débat pour devenir la conception elle-même.
Elif est un personnage illustratif composite, et non une personne, une organisation ou un incident spécifique. Les définitions de cet article sont reformulées à partir du glossaire des agents de Hugging Face (mai 2026) et des discussions communautaires plus larges qu'il cite, auxquelles crédit est rendu ; le glossaire lui-même note que de nombreux termes ne disposent pas de définitions universellement acceptées et que l'usage varie selon les frameworks. Les fonctionnalités de TrueFoundry mentionnées reflètent la documentation publique du produit au moment de la rédaction ; vérifiez les détails par rapport à la documentation actuelle.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















