



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Resumen: TrueFoundry y Seldon se unen en una sola plataforma. El servicio de ML en tiempo real de Seldon se integra con AI Deploy y AI Gateway de TrueFoundry, ofreciendo a las empresas un plano de control único tanto para ML clásico como para agentes. Sus modelos en producción continúan ejecutándose en el mismo Kubernetes que utiliza hoy en día, al tiempo que obtiene un camino claro hacia los LLM y los agentes de IA sobre ellos.
La mayoría de los equipos de IA empresarial operan actualmente a ambos lados de una misma línea. Ejecutan modelos de ML clásico en producción para tareas como puntuación de fraude, predicción de abandono (churn) y recomendaciones. Al mismo tiempo, están desarrollando aplicaciones basadas en agentes que razonan, invocan herramientas y actúan de forma autónoma. Antes, esos dos mundos avanzaban a distintas velocidades; ya no. Ambos se están volviendo críticos para el negocio simultáneamente, y mantenerlos como dos stacks separados, con dos proveedores y dos modelos de gobernanza, resulta costoso e inestable rápidamente.
Esa es la brecha que TrueFoundry y Seldon están cerrando juntos. Seldon ha dedicado más de una década a perfeccionar el servicio de ML en tiempo real para algunas de las empresas más exigentes del mundo. TrueFoundry diseñó el plano de control en torno a la IA moderna, con despliegue, un AI Gateway y gobernanza para LLM y agentes. Estamos fusionando ambos en una sola plataforma para que los equipos dispongan de un único lugar donde ejecutar modelos predictivos y agentes sobre la base de Kubernetes en la que ya confían.
Esta fusión funciona porque ninguna de las dos partes tiene que renunciar a su diseño. Seldon y TrueFoundry tomaron la misma decisión arquitectónica hace años. Ambos se ejecutan como un plano de control en el propio Kubernetes del cliente, dentro de su VPC, on-premise o air-gapped. Ambos son independientes de la nube (cloud-agnostic). Ambos se apoyan en los mismos componentes estándar para tráfico, autoescalado y telemetría, y ambos asignan a cada equipo su propio namespace en lugar de requerir permisos de administración a nivel de todo el clúster.
Seldon tomó esa base compartida y profundizó en una capa: el servicio de ML clásico en tiempo real a escala. Nosotros tomamos esa misma base y nos expandimos a lo ancho, desde el despliegue hasta un gateway que gobierna modelos, agentes y herramientas. Por tanto, las dos plataformas nunca estuvieron en rumbo de colisión; estaban resolviendo partes adyacentes del mismo problema, de la misma manera. Unirlas simplemente conecta dos capas que ya hablan el mismo idioma.
Seldon ha sido la columna vertebral de la inferencia de ML en tiempo real en bancos, empresas de telecomunicaciones, aseguradoras, minoristas y compañías del sector salud durante más de una década. Esa reputación proviene de haber profundizado en los aspectos más complejos del servicio de ML en producción:
En conjunto, se trata de una capa madura de servicio y monitorización con profundas raíces en entornos regulados y de baja latencia, donde una mala predicción se convierte en un problema para el cliente en cuestión de minutos.
TrueFoundry construyó el plano de control en torno al modelo, las capas que transforman un modelo desplegado en una aplicación gobernada, optimizada en costes y lista para agentes:
Nuestros clientes ya ejecutan IA crítica para el negocio a través del Gateway a una escala superior a un billón de tokens al día.
Aquí está la parte clave. Cuando la capa de servicio de Seldon y las capas de despliegue y gateway de TrueFoundry se unen, la empresa obtiene un único plano de control que cubre ambas mitades de su IA.
Deploy ejecuta las cargas de trabajo. El Gateway las gobierna y enruta. Sus modelos de ML clásico y sus agentes conviven en el mismo Kubernetes, bajo un único conjunto de controles de acceso, un stack de observabilidad único y una visión unificada de los costes. Una sola solicitud puede consultar un modelo de fraude, un LLM y un agente que invoca una herramienta, y cada salto se registra y gobierna de la misma manera.
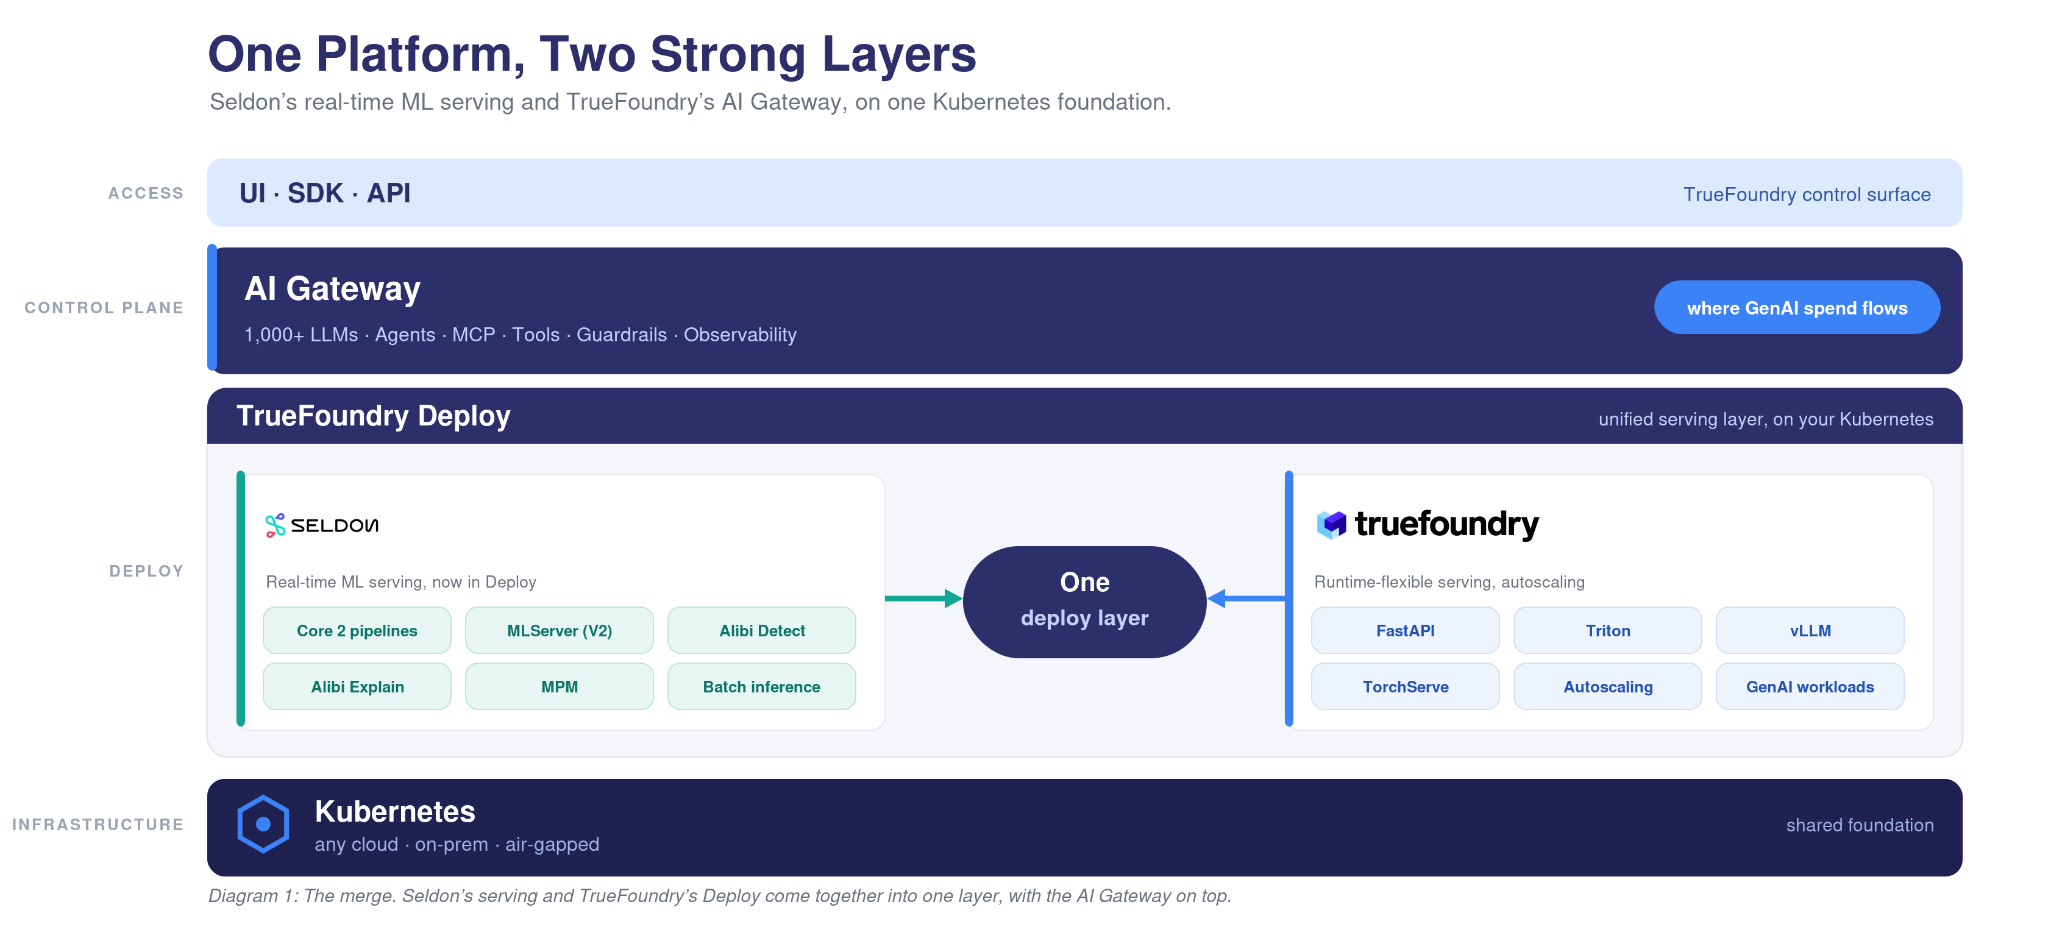
Resulta útil analizar hacia dónde se mueve el presupuesto. El ML predictivo está en su mayoría construido y se ejecuta de manera estable. La nueva inversión en IA empresarial se está dirigiendo a los LLM y a los agentes, y ese gasto fluye a través del Gateway. Cada llamada a un modelo, cada paso de un agente y cada invocación de una herramienta pasa por él, razón por la cual nuestros clientes ya procesan más de un billón de tokens al día a través de nuestra plataforma.
Por lo tanto, la plataforma combinada cumple dos funciones útiles a la vez. Mantiene el ML que ya ha desarrollado funcionando sin interrupciones. Y le posiciona en el entorno donde se concentra la próxima ola de inversión en IA, sin necesidad de desplegar una plataforma independiente para conseguirlo.
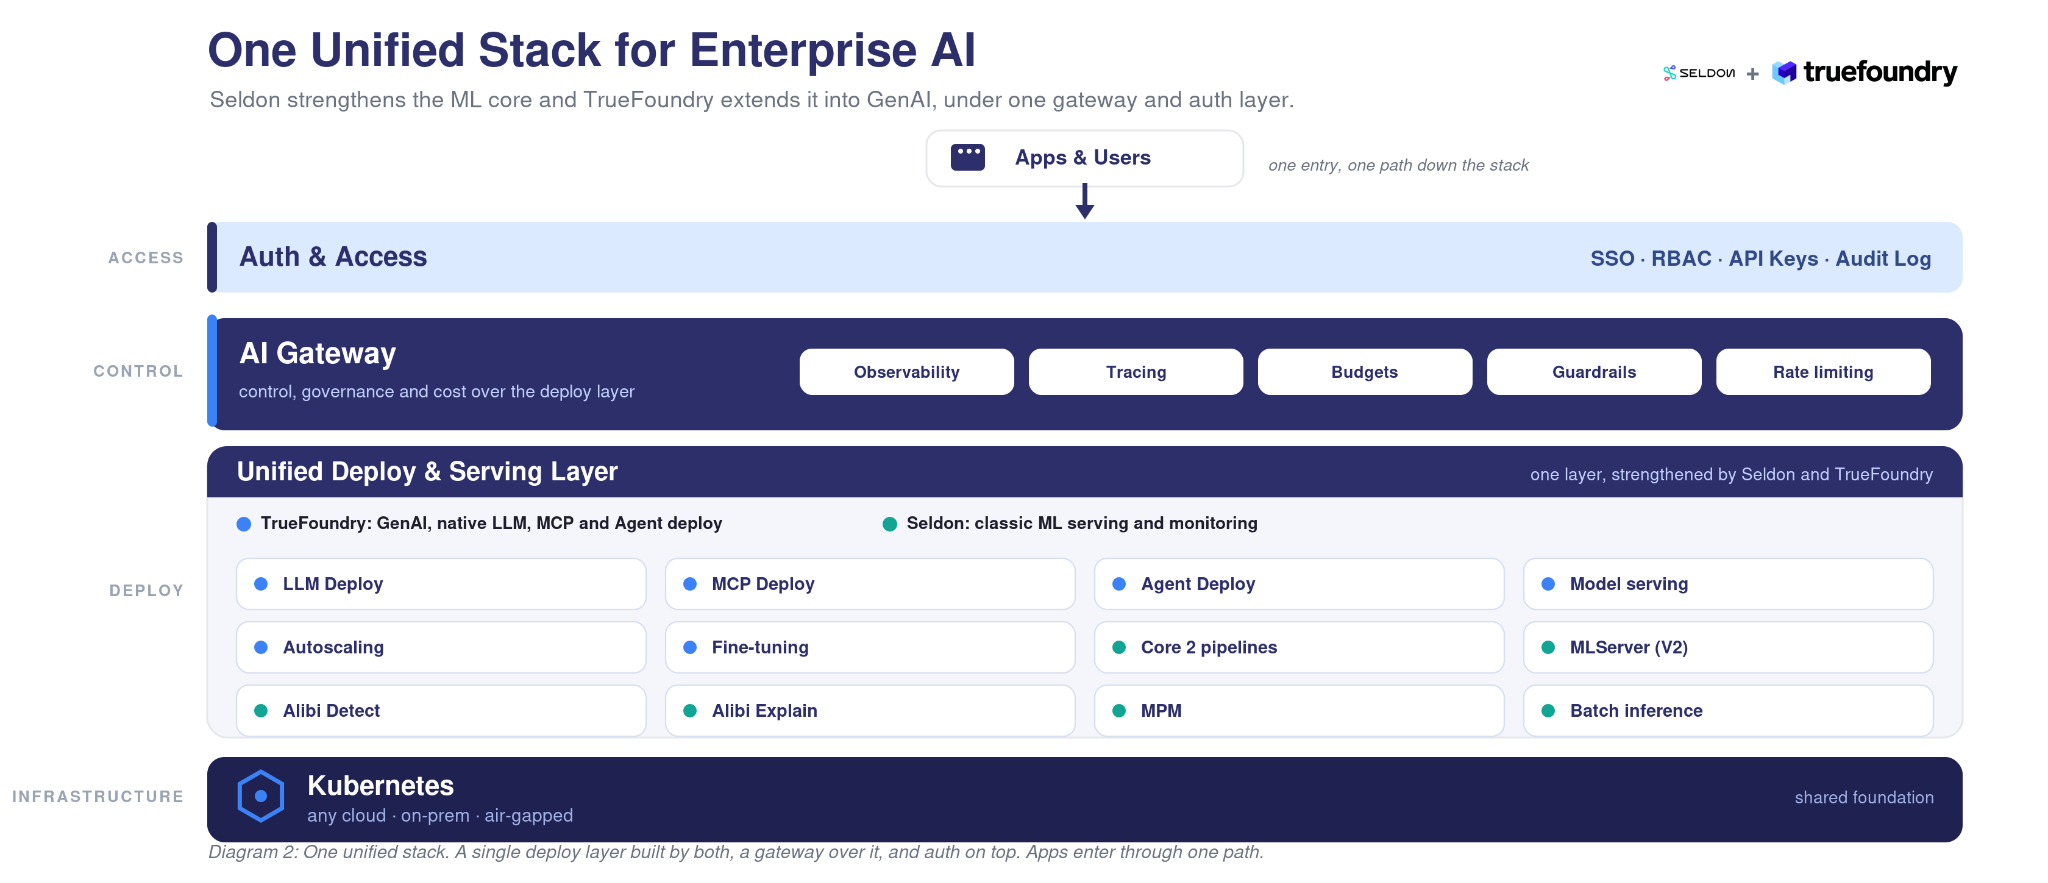
Si utiliza Seldon actualmente, su ML en tiempo real seguirá ejecutándose en el Kubernetes que ya opera. Los modelos servidos mediante el protocolo V2 se mantienen portables, y los pipelines de Core 2 se asignan a las primitivas propias de Deploy sin necesidad de reescribirlos. Además, obtiene el AI Gateway y la capa de agentes sin tener que desplegar nada nuevo.
Si utiliza TrueFoundry actualmente, nada cambia en su stack y Deploy se vuelve más potente. Incorpora la herencia de servicio y monitorización de Seldon, incluida la detección de drift y outliers, las explicaciones de modelos y la monitorización del rendimiento, que se integran directamente en la plataforma que ya utiliza.
Para ambos, significa disponer de un solo stack en lugar de dos. Un único lugar para desplegar un modelo, enrutar una llamada, supervisar el drift, gobernar un agente y auditar los costes, tanto en ML clásico como en GenAI, sobre la infraestructura que ya opera.
Las empresas no deberían tener que gestionar una plataforma para sus modelos y otra diferente para sus agentes. Con TrueFoundry y Seldon juntos, ya no es necesario. El servicio de ML en tiempo real de Seldon y el AI Gateway de TrueFoundry residen ahora en un único plano de control para la IA empresarial, sobre el Kubernetes que ya ejecuta. Su ML en producción sigue funcionando y el camino hacia los agentes y los LLM está integrado justo encima.
Descubra cómo el AI Gateway de TrueFoundry unifica ML y agentes → Explore el AI Gateway
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















