


November 13, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Cualquier otra carga de trabajo de AI se ejecuta en infraestructura que usted posee: su clúster, su política de red, una credencial que puede rotar. Codex es un proceso CLI en el portátil de un desarrollador que lee un archivo TOML en su directorio de usuario y habla directamente con un proveedor de modelos. Cinco propiedades lo convierten en una clase diferente de problema:
El reflejo habitual es un documento de políticas. Falla por una razón: todo lo que pide reside en un archivo que el desarrollador puede editar.
Cuatro propiedades se deben cumplir en cada solicitud:
Un gateway le ofrece las cuatro, pero solo si el cliente apunta a él y sigue apuntando a él. Hay tres posturas para eso, y solo una es la aplicación obligatoria:
Bloquear el archivo sin rotar el token maneja la manipulación pero ignora el robo de credenciales; rotar sin bloquear hace lo contrario. Necesita ambos.
Tratar la cuenta del proveedor del modelo como el punto de control. La identidad, el SSO, la pertenencia al espacio de trabajo y la política de la consola de administración para Codex viven en la consola de OpenAI, no en su gateway, al igual que la retención de prompts y outputs, que "se rige por su acuerdo con OpenAI". Un gateway controla el enrutamiento, el gasto, los guardrails y su propio registro, no su contrato de proveedor.
Asumir que un push de MDM equivale a una aplicación permanente. Los clientes cambian la precedencia de configuración entre versiones. Codex v0.149.0 eliminó managed_config.toml en Windows por completo: ahora ignora el archivo con una advertencia al inicio (Ignoring deprecated managed config file), sin un equivalente en el registro. Una flota configurada antes de esa versión no está sujeta a control y no informa ningún error.
Enviar una clave de API compartida. La forma más rápida de hacer trabajar a treinta desarrolladores, y destruye todos los controles posteriores a la vez. No se puede limitar la tasa a una persona ni responder a "quién envió ese prompt" a partir de una credencial para todo el tenant.
Codex trata el AI Gateway de TrueFoundry como un proveedor de modelos; todo lo demás se deriva de que el tráfico llegue a un lugar que usted controla. Los detalles del gateway provienen del fragmento de código en la interfaz de usuario.
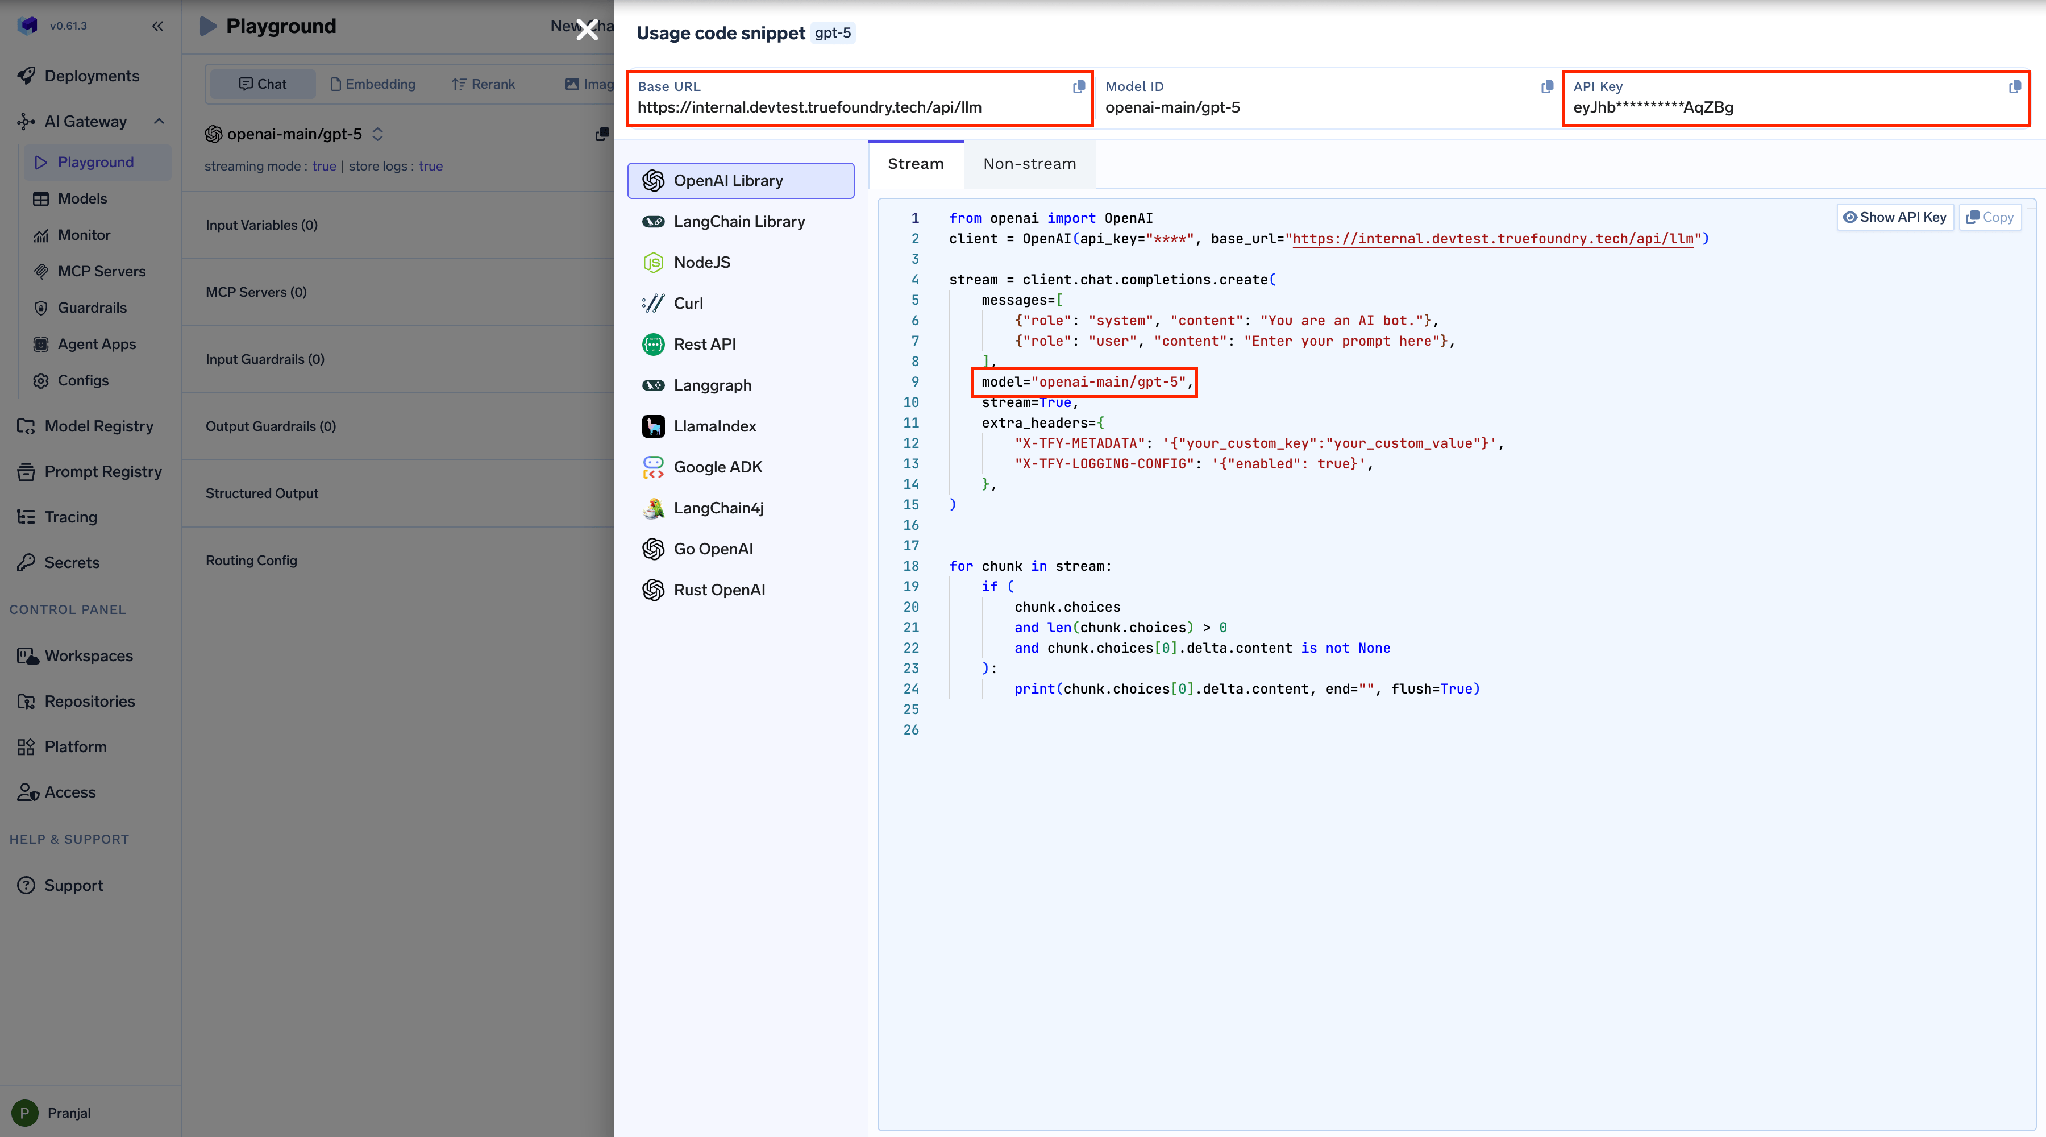
La forma para un solo desarrollador: el token va en Authorization y el gateway lo resuelve asignándolo a una persona.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer TFY_API_KEY"
La suscripción a ChatGPT del desarrollador paga por la inferencia y el gateway sigue gobernando el tráfico. Cambian dos cosas: requiere requires_openai_auth = true, y la credencial de TrueFoundry se mueve de Authorization a x-tfy-api-key, porque Codex necesita Authorization para su propio token OAuth de ChatGPT.
model = "gpt-5.2-codex"
model_provider = "truefoundry"
[model_providers.truefoundry]
name = "TrueFoundry AI Gateway"
base_url = "{GATEWAY_BASE_URL}"
wire_api = "responses"
requires_openai_auth = true
[model_providers.truefoundry.http_headers]
x-tfy-api-key = "TFY_API_KEY"
En el lado del gateway, cree un proveedor en Integrations → Providers de tipo OpenAI, URL base https://chatgpt.com/backend-api/codex, y deje el campo de la clave de API vacío.
El campo vacío es la señal, no una omisión. Si hay una clave almacenada presente, el gateway la utiliza en lugar de las credenciales de ChatGPT del desarrollador, lo que rompe el flujo de suscripción y posiblemente enruta el tráfico bajo la cuenta equivocada. Un administrador que "útilmente" llena ese campo convierte a treinta desarrolladores atribuidos individualmente en un único tenant de clave de API anónimo, y nada da error.
Si se deja vacío, se obtiene una atribución dual: TrueFoundry registra al desarrollador desde x-tfy-api-key, OpenAI atribuye el uso a su asiento de ChatGPT. Los ID de los modelos se ven como chatgpt-codex/gpt-5.2-codex.
De la credencial vinculada a una cuenta de ChatGPT se derivan dos restricciones. Solo uno de los destinos de un modelo virtual puede ser una cuenta de modelo con suscripción a ChatGPT; los destinos respaldados por claves de API coexisten junto a ella. Y un 401, 403 o 429 por desarrollador no pone el destino compartido en enfriamiento del balanceador de carga, por lo que la cuota agotada de un desarrollador no puede afectar a nadie más.
(La documentación difiere sobre la elegibilidad del plan: la página de enterprise-security dice Business o Enterprise, la página de CLI también enumera Personal. [VERIFY] antes de prometer un nivel.)
Esta es la línea que los equipos copian mal y luego depuran durante una tarde. El gateway añade el endpoint /responses únicamente para el protocolo Responses. Establezca wire_api = "chat" y la solicitud irá a /chat/completions contra la misma URL base, el cual no es un endpoint válido para el tráfico de Codex. También es lo que hace que los tokens de pensamiento gpt-5.x-codex se comporten correctamente.
La página de la CLI de Codex lo plantea de forma más suave: responses para gpt-5.x-codex, chat para otros modelos. Se reconcilian: para los modelos de la familia Codex, el protocolo Responses es obligatorio.
Codex envía tokens de pensamiento a ciertos modelos y los identifica al hacer coincidir la cadena del modelo. Los nombres completamente cualificados (fully qualified names) — openai-main/gpt-5, azure-openai/gpt-5 — no coinciden, por lo que la detección de funciones falla.
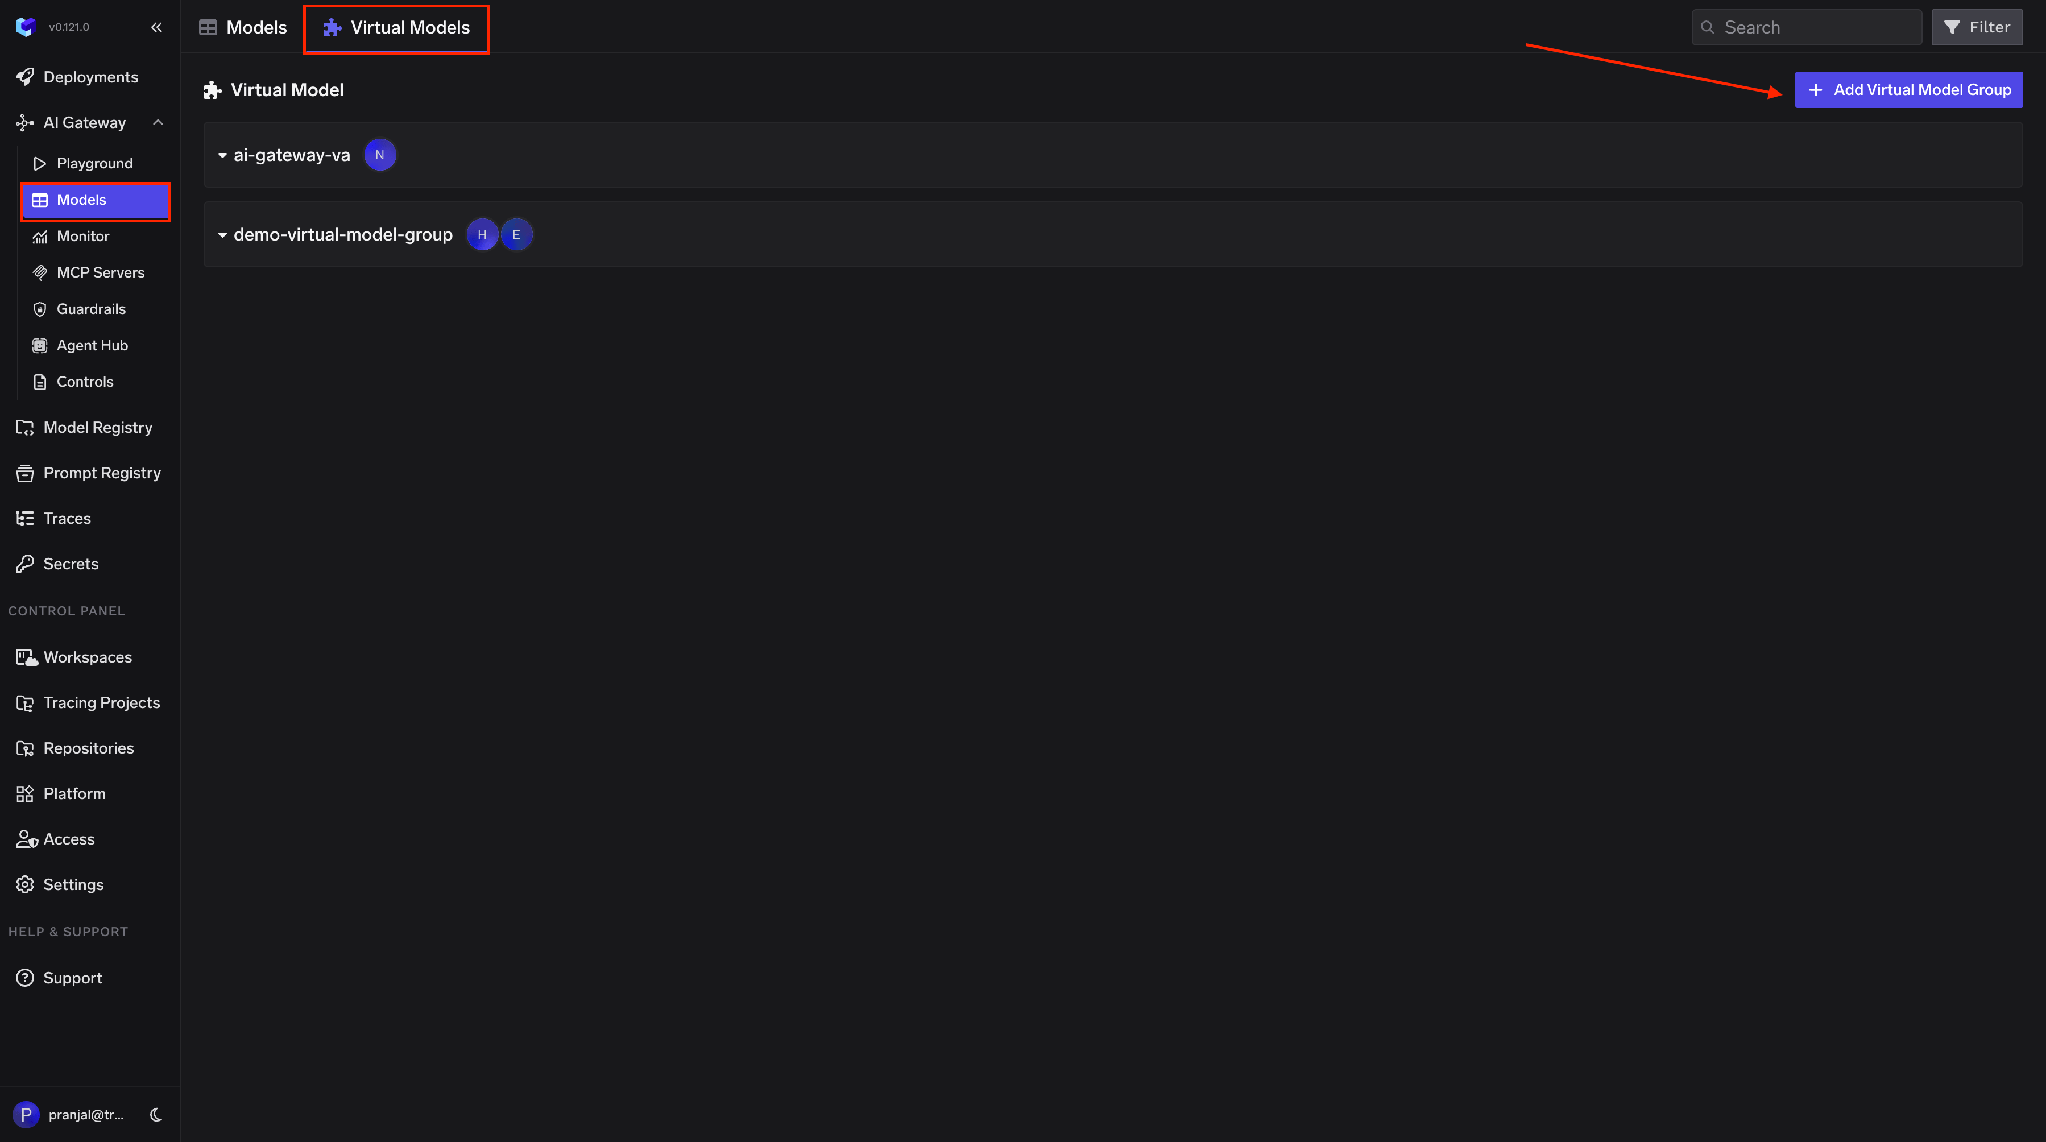
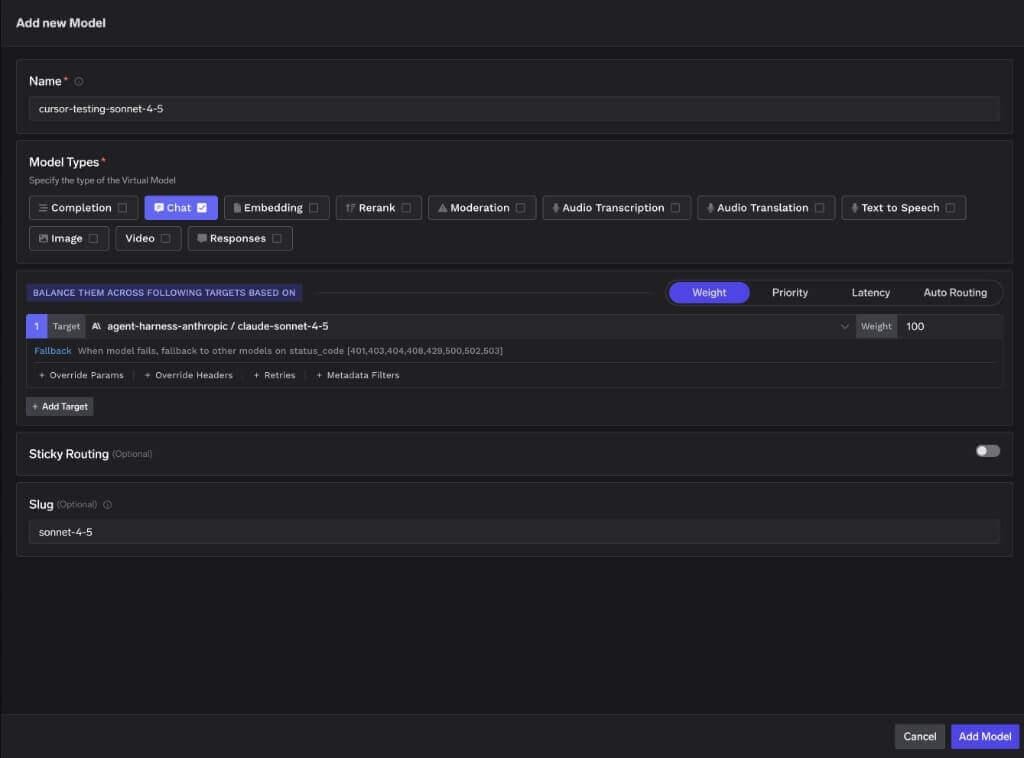
La regla: utilice un slug que coincida con el ID del modelo real, p. ej. gpt-5.2-codex. Codex reconoce esos ID y habilita las funciones correctas. No ponga el nombre completamente cualificado en la configuración de Codex.
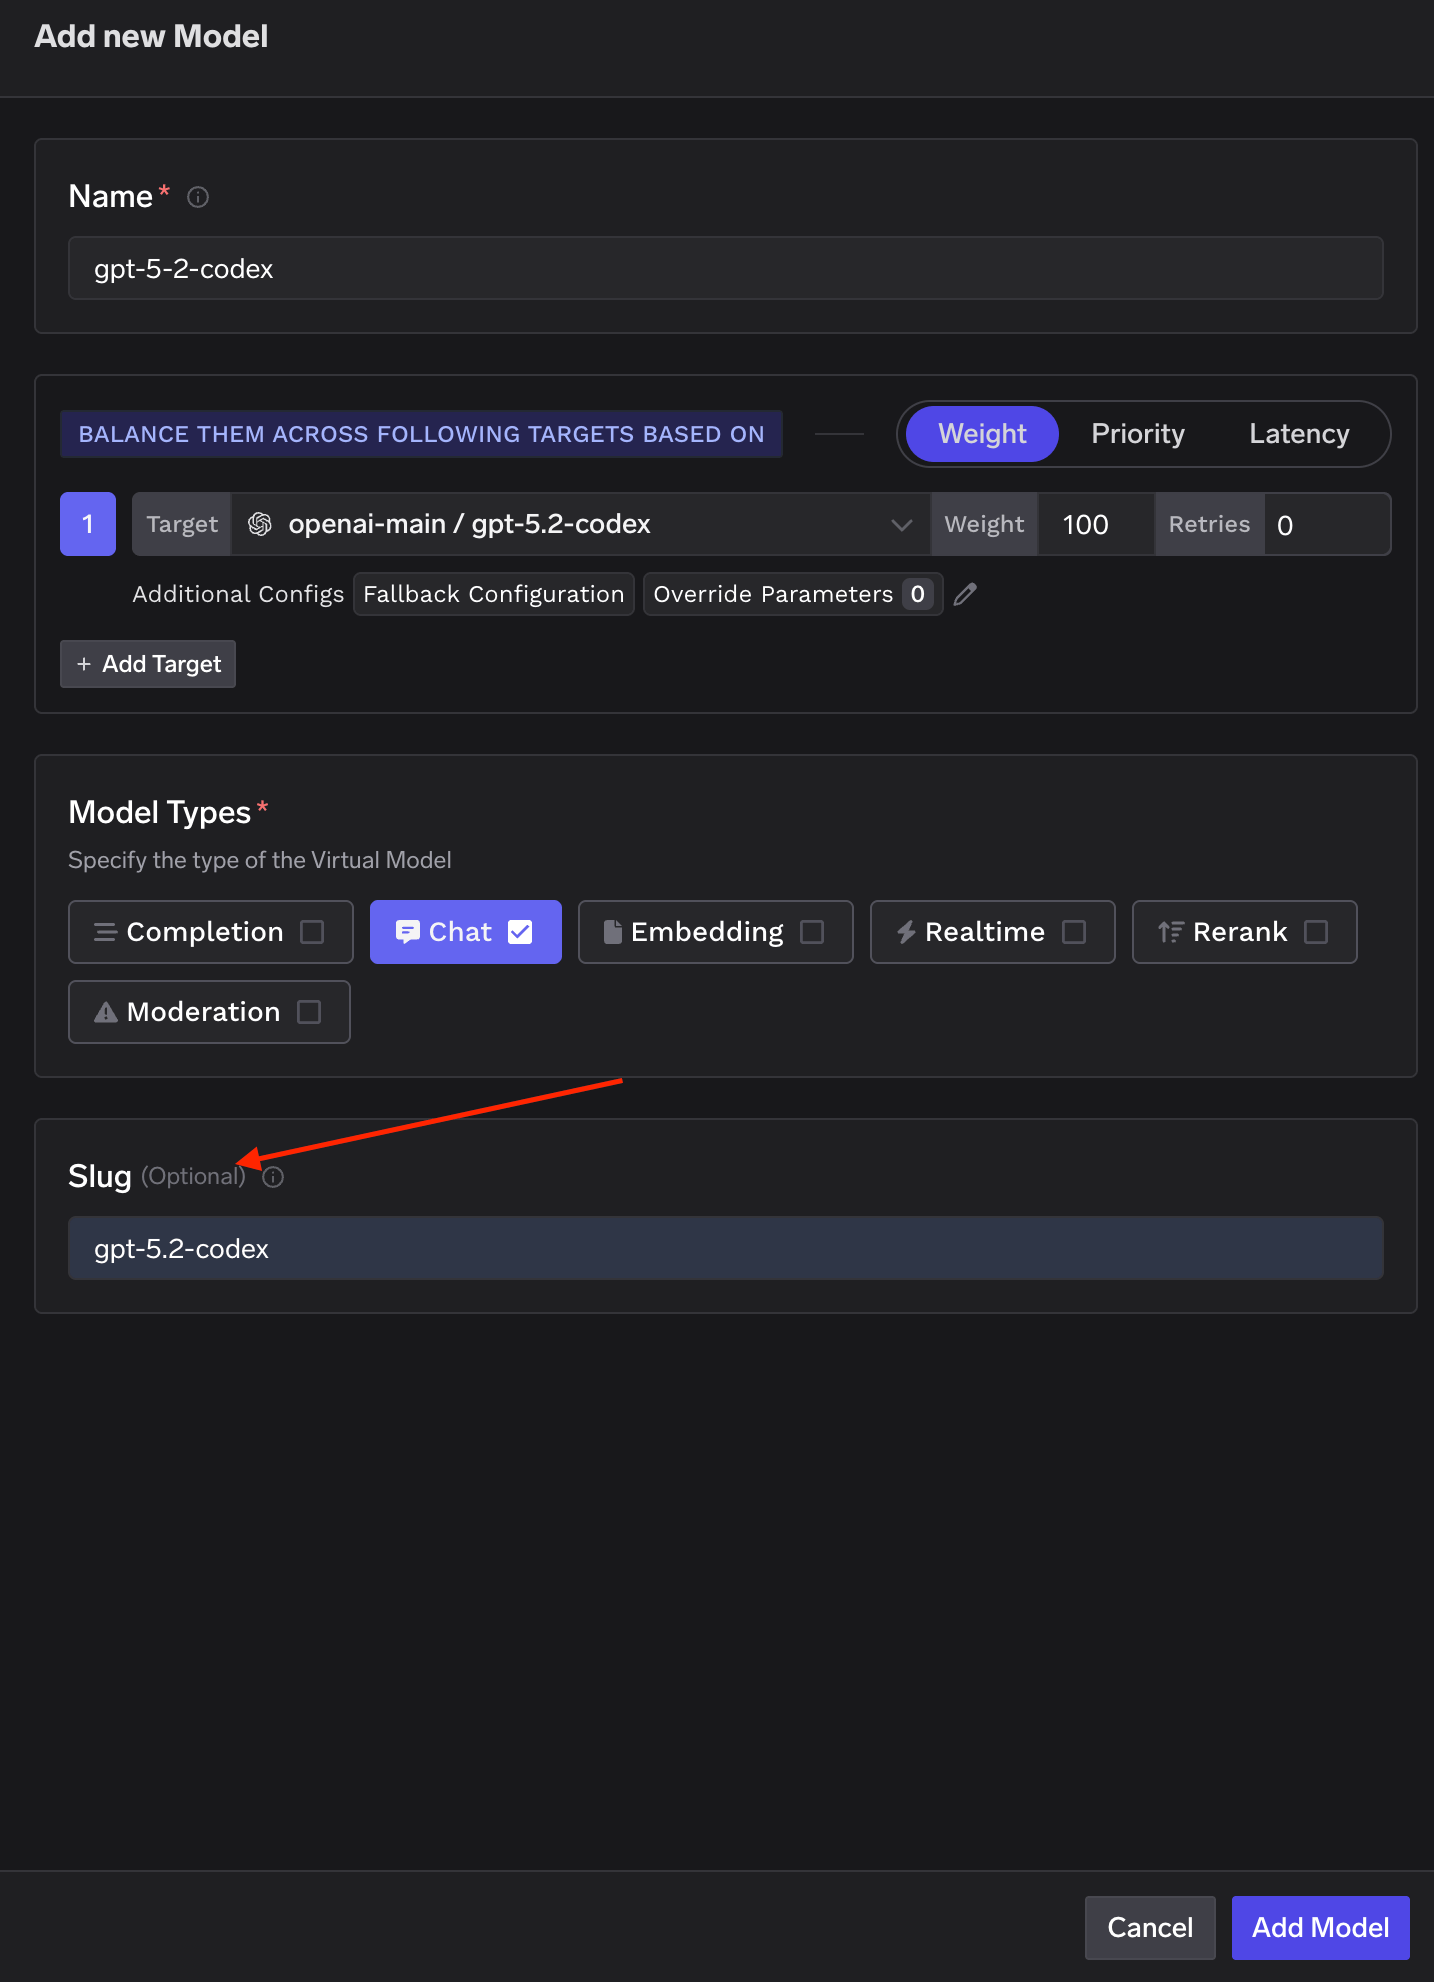
Los slugs son únicos en todo el tenant y se configuran en los ajustes de Virtual Model Provider Group. Tanto el slug como la ruta completa de grupo/modelo funcionan en el cuerpo de una solicitud; Codex necesita la forma de slug.
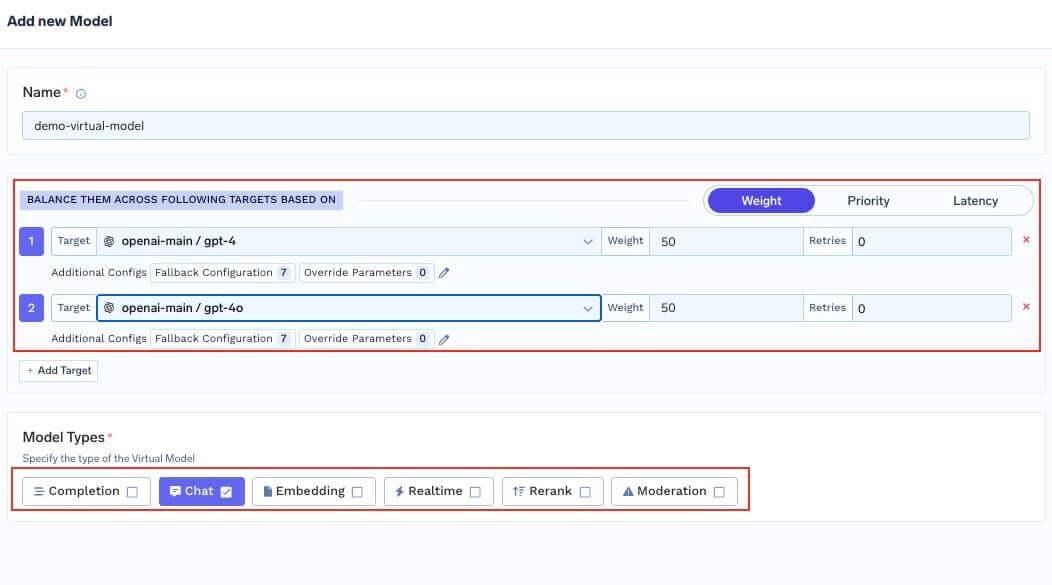
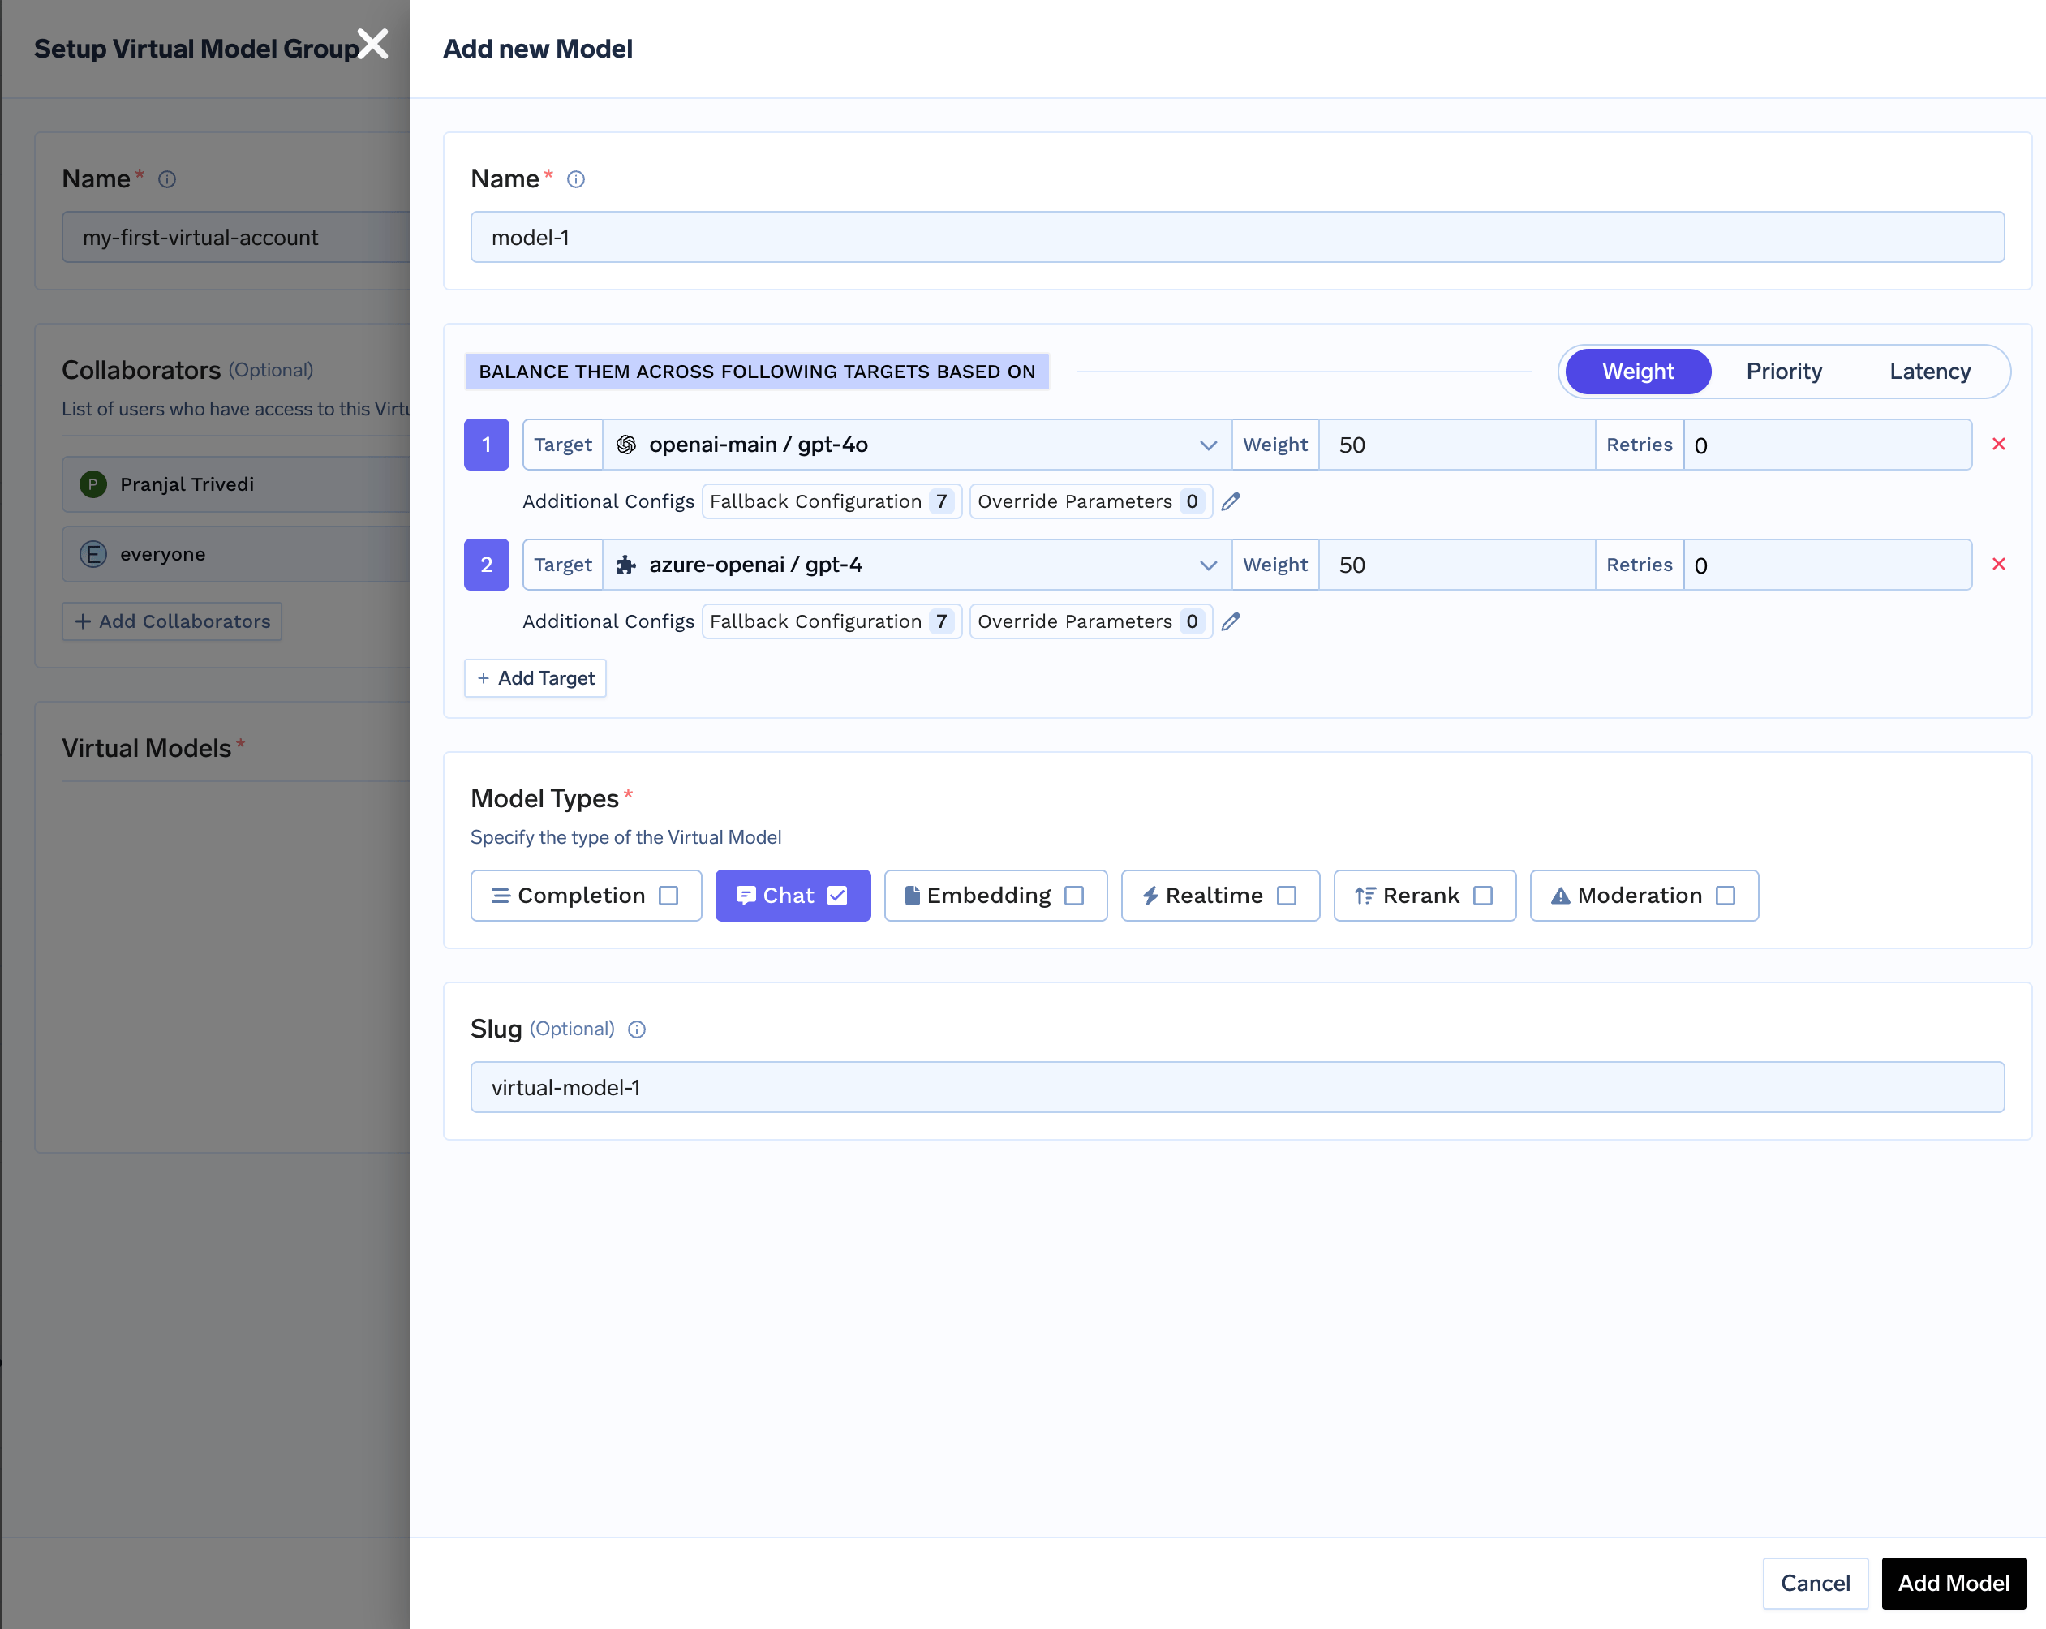
Detrás de un slug puede ponderar destinos — openai-main/gpt-5 a 70, azure-openai/gpt-5 a 30 — y cambiar la mezcla sin tocar un portátil, como en deprecación de modelos y transiciones escalonadas.
La nomenclatura del slug es también donde los clientes difieren drásticamente. Cursor elige su formato de solicitud a partir de las palabras clave del slug y cambia de formato silenciosamente si el slug contiene anthropic, claude, openai, gpt, gemini o vertex. Codex quiere el ID del modelo dentro del slug; Cursor quiere esas palabras clave fuera.
Una configuración por desarrollador es una configuración documentada, no un control. La aplicación en la flota utiliza tfy-local-ai-setup, un binario distribuido por su MDM y ejecutado como root (Administrador en Windows) con una cadencia horaria recomendada, desde github.com/truefoundry/tfy-local-ai-setup/releases; los scripts de Codex fijan RELEASE_TAG="v1.3.5". Cada ejecución realiza cuatro cosas:
El paso tres es el que más importa. El portátil nunca contiene un token de gateway de larga duración: el token de actualización es válido durante 30 días desde la última emisión, cada ejecución exitosa lo rota, y la credencial en la configuración administrada es recién obtenida y delimitada a la identidad de ese usuario.
Configuración requerida: GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME. Opcional: CODEX_GATEWAY_URL, CODEX_AUTH_MODE, CODEX_DEFAULT_MODEL, CODEX_SETTINGS_FILE. CODEX_AUTH_MODE="api-key" es el valor predeterminado; "chatgpt-subscription" hace que el binario escriba requires_openai_auth = true y mueva el token a x-tfy-api-key. Las máquinas sin Codex son una operación nula limpia: el binario las omite y finaliza.
En macOS y Linux el archivo de administrador prevalece, reaplicado en cada inicio:
/etc/codex/managed_config.toml → ~/.codex/config.toml → CLI flags
model_provider = "truefoundry"
model = "gpt-5.2-codex"
[model_providers.truefoundry]
name = "TrueFoundry Gateway"
base_url = "https://<your-truefoundry-gateway-url>"
wire_api = "responses"
[model_providers.truefoundry.http_headers]
Authorization = "Bearer <freshly-fetched-tfy-token>"
La clave model de nivel superior se escribe únicamente cuando CODEX_DEFAULT_MODEL está configurado; si no se establece, la elección del modelo queda en manos del desarrollador mientras que el proveedor se mantiene bajo aplicación obligatoria.
En Windows el archivo, el orden y el esquema cambian.
C:\ProgramData\OpenAI\Codex\requirements.toml → ~/.codex/config.toml → CLI flags → C:\ProgramData\OpenAI\Codex\config.toml
Tenga en cuenta la última posición: config.toml en Windows es el valor predeterminado de la máquina con la precedencia más baja de las cuatro, por lo que el archivo del propio desarrollador prevalece sobre él. requirements.toml prevalece sobre todo. El bloque de proveedor coincide con macOS; la fijación del modelo no:
# C:\ProgramData\OpenAI\Codex\requirements.toml
model_provider = "truefoundry"
# ... mismos bloques [model_providers.truefoundry] y http_headers ...
[models.new_thread]
model = "gpt-5.2-codex"
El esquema de requirements no tiene una clave model de nivel superior. CODEX_DEFAULT_MODEL se ubica bajo [models.new_thread] en su lugar. Copie el bloque de macOS en Windows sin cambios y la fijación del modelo no hará nada silenciosamente.
Dos números de versión deciden si algo de esto es real en Windows. v0.149.0 eliminó managed_config.toml allí. v0.156.0 es el mínimo para la aplicación obligatoria — Codex respeta model_provider en requirements.toml solo a partir de esa compilación; las compilaciones anteriores recurren al config.toml de menor precedencia, que un desarrollador puede anular desde su directorio de usuario. Compruebe codex --version antes de tratar a Windows como controlado. La gestión de Codex en Windows dentro del binario de instalación llega en tfy-local-ai-setup v1.3.5.
Bloquear convierte el archivo en un control:
En macOS, /etc/codex/ es root:wheel 755 y el archivo es root:wheel 644 más schg — el propio root debe ejecutar chflags noschg para editarlo.
La advertencia sobre la ACL de Windows merece su propia línea. C:\ProgramData\OpenAI\Codex\ es propiedad de Administrators con la herencia eliminada: SYSTEM y Admins total, Users lectura; ambos archivos TOML SYSTEM total, Admins lectura, Users lectura. La razón es contundente: ProgramData permite a cualquier usuario autenticado crear directorios, y Codex carga cualquier configuración que encuentre allí en lugar de rechazar una que sea editable por el usuario. No relaje esa ACL; un directorio permisivo convierte una configuración obligatoria en una sugerencia, silenciosamente.
Codex llega a la web abierta de dos maneras. La búsqueda alojada por el proveedor envía la herramienta web_search de la Responses API, incluso en modelos compatibles en AWS Bedrock Mantle: rápida, pero el comportamiento varía según el proveedor y no es una llamada a herramienta que usted controle. La búsqueda web por MCP — Tavily o Exa detrás del MCP Gateway de TrueFoundry — se recomienda por consistencia, porque las herramientas MCP se ejecutan en el lado del cliente en el proceso de Codex, independientemente de a qué modelo enrute el gateway.
[mcp_servers.web-search]
url = "https://<gateway>/<tenant>/mcp/<mcp-server-name>/server"
http_headers = { Authorization = "Bearer TFY_API_KEY" }
Utilice bearer_token_env_var = "TFY_API_KEY" en lugar de incluir el token directamente. Para desactivar la búsqueda alojada por el proveedor, establezca web_search = "disabled" en ~/.codex/config.toml — esto desactiva únicamente la ruta alojada por el proveedor; el servidor MCP sigue funcionando hasta que elimine su bloque [mcp_servers.<name>]. Registrar la búsqueda como un servidor MCP es también lo que hace que el tráfico de esa herramienta sea gobernable bajo el control de acceso de MCP gateway.
Dado que cada completado cruza el gateway, el registro existe independientemente de si el desarrollador lo desea o no: cada solicitud en Request Traces muestra el usuario resuelto, el modelo servido, los tokens y la latencia.
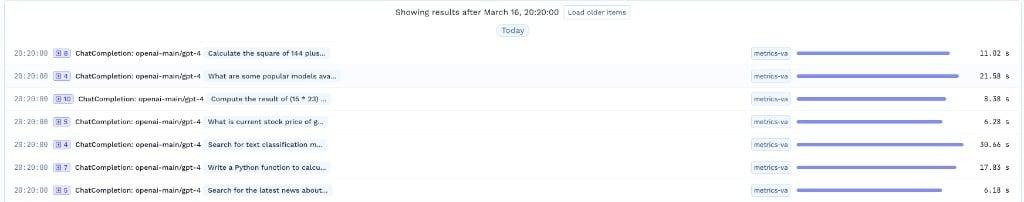
Por encima de eso, el panel de métricas agrega la flota: gasto y volumen por usuario, equipo y modelo.
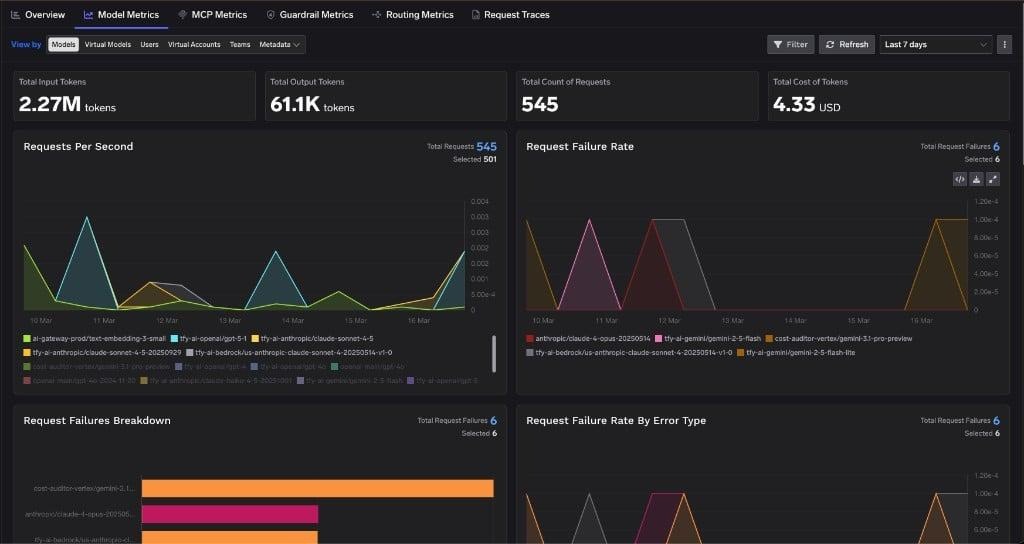
Cada cliente de código en el gateway aterriza en la misma vista: una sola imagen de costos en lugar de cuatro, como en la centralización del control de costos en IDEs de código con AI.
Doscientos ingenieros, macOS y Windows, ChatGPT Enterprise ya adquirido. Los desarrolladores mantienen Codex; seguridad obtiene la atribución; finanzas obtiene una cifra por equipo.
1. Cree el proveedor. Integrations → Providers → OpenAI, URL base https://chatgpt.com/backend-api/codex, campo de clave de API vacío — anote eso en el libro de operaciones (runbook) para que el próximo administrador no lo "corrija".
2. Cree el Modelo Virtual. Slug gpt-5.2-codex — el ID del modelo real, no el nombre completamente cualificado. Un destino de suscripción a ChatGPT, más destinos respaldados por claves de API para la conmutación por error (failover).
3. Configure la configuración de MDM. GATEWAY_URL, CONTROL_PLANE_URL, TENANT_NAME, más CODEX_AUTH_MODE="chatgpt-subscription" y CODEX_DEFAULT_MODEL="gpt-5.2-codex".
4. Envíe el script cada hora, como root. Instala tfy-local-ai-setup v1.3.5, renueva el token de cada usuario, escribe managed_config.toml en macOS y requirements.toml en Windows, y bloquea ambos.
5. Condicione el despliegue en Windows a codex --version. Cualquier versión inferior a v0.156.0 no estará sujeta a aplicación obligatoria; informe de la distribución de versiones de la flota antes de afirmar que hay cobertura.
6. Verifique. ls -lO para schg, lsattr para i, icacls para el propietario Administrators y Users:(RX). Luego abra Request Traces y confirme que el nombre de un desarrollador, y no el de una cuenta de servicio, esté en la solicitud.
7. Cierre la ruta de búsqueda web. Registre Tavily o Exa detrás del MCP Gateway, luego establezca web_search = "disabled".
El límite honesto: estos pasos gobiernan el proveedor del modelo, la autenticación y el gasto. No controlan qué servidores MCP puede habilitar un desarrollador.
El script de MDM no controla los servidores MCP. Gestiona managed_config.toml, cubriendo el proveedor del modelo y la autenticación. La aplicación de Codex sobre qué servidores MCP puede habilitar un desarrollador reside en un archivo /etc/codex/requirements.toml independiente en macOS y Linux, el cual tfy-local-ai-setup no escribe. Despliegue ese archivo junto con el script — y no diga a un auditor que la configuración de MDM cubre la lista de permitidos de MCP.
Dos scripts de MDM, un archivo de configuración, diferentes versiones fijadas. Los scripts de Codex fijan tfy-local-ai-setup v1.3.5; los scripts de Claude Code fijan la v1.3.4. Ambos describen un binario que comparte un archivo de configuración guardado en la misma máquina, por lo que una flota que ejecute ambos reinstalaría una versión diferente cada hora — y el soporte para Codex en Windows solo existe a partir de la v1.3.5. [VERIFY] la versión fijada antes de habilitar ambos.
Desviación de versiones de modelos en la documentación. La página de Codex anuncia GPT-5.3-Codex mientras que cada ejemplo de configuración, la guía de slugs y el valor predeterminado de MDM utilizan gpt-5.2-codex. Fije explícitamente en CODEX_DEFAULT_MODEL; [VERIFY] el ID del modelo actual antes del despliegue.
Cursor no es aplicable de la misma manera. Sus políticas de MDM cubren hooks, no modelos: la URL base, la clave de API y la lista de modelos no son aplicables por MDM, por lo que un desarrollador puede revertirlos en cualquier momento. Copilot CLI tampoco tiene una ruta settings.json para BYOK. Codex y Claude Code son los dos que se mantienen firme — la seguridad de Cursor cubre esa brecha.
La mayoría de los consejos sobre la gobernanza de OpenAI Codex se quedan en "enrútelo a través de un proxy". Esa es la mitad fácil. La mitad difícil decide si el enrutamiento sobrevive a una flota real: un campo de clave de API vacío que parece un error y no lo es, un protocolo de conexión obligatorio, un slug que debe coincidir exactamente con el ID de un modelo, un archivo de Windows con su propio esquema, un límite mínimo de versión por debajo del cual el control no hace nada silenciosamente y una ACL que no debe relajar.
Ninguna de estas son preguntas de políticas. Son hechos de configuración, cada uno con un comando que puede ejecutar para comprobarlo. Esa es la diferencia entre un documento de gobernanza y una flota gobernada: alguien se acerca a cualquier portátil, ejecuta ls -lO o icacls, y obtiene un sí o un no.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Cuatro controles que se mantienen sin la cooperación del desarrollador: una identidad por desarrollador en cada solicitud, control del administrador sobre los modelos accesibles, gasto atribuido a una persona y a un equipo, y auditoría generada en la ruta de red. En la práctica: un archivo de configuración propiedad del administrador que se lee con mayor precedencia que el del desarrollador, un bloqueo del archivo y credenciales de corta duración.
Sí. Establezca requires_openai_auth = true, traslade la credencial del gateway a x-tfy-api-key para que Codex pueda usar Authorization con su propio token OAuth de ChatGPT, y cree el proveedor del gateway con el campo de clave de API vacío: una clave almacenada anula las credenciales de ChatGPT del desarrollador y rompe el flujo. Obtiene la identidad del desarrollador en el lado del gateway y su licencia de ChatGPT en el de OpenAI.
Solo a partir de Codex v0.156.0. La v0.149.0 eliminó la compatibilidad con managed_config.toml sin un equivalente en el registro; la aplicación pasó a requirements.toml, un esquema distinto sin clave model de nivel superior. Por debajo de la v0.156.0 solo se aplica config.toml, de menor precedencia, que la configuración del propio desarrollador anula.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Sí. Incluye un MCP Gateway, un Agent Gateway y un MCP & Agents Registry con control de acceso a nivel de herramienta. Los agentes creados con LangGraph, CrewAI, AutoGen o un framework propio pueden gobernarse de forma centralizada.
Sí. El gateway es compatible con OpenTelemetry y se conecta a Grafana, Datadog o Prometheus. Cada llamada al clasificador LLM genera su propio span, por lo que la latencia del clasificador se ve por separado de la del modelo servido.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















