



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
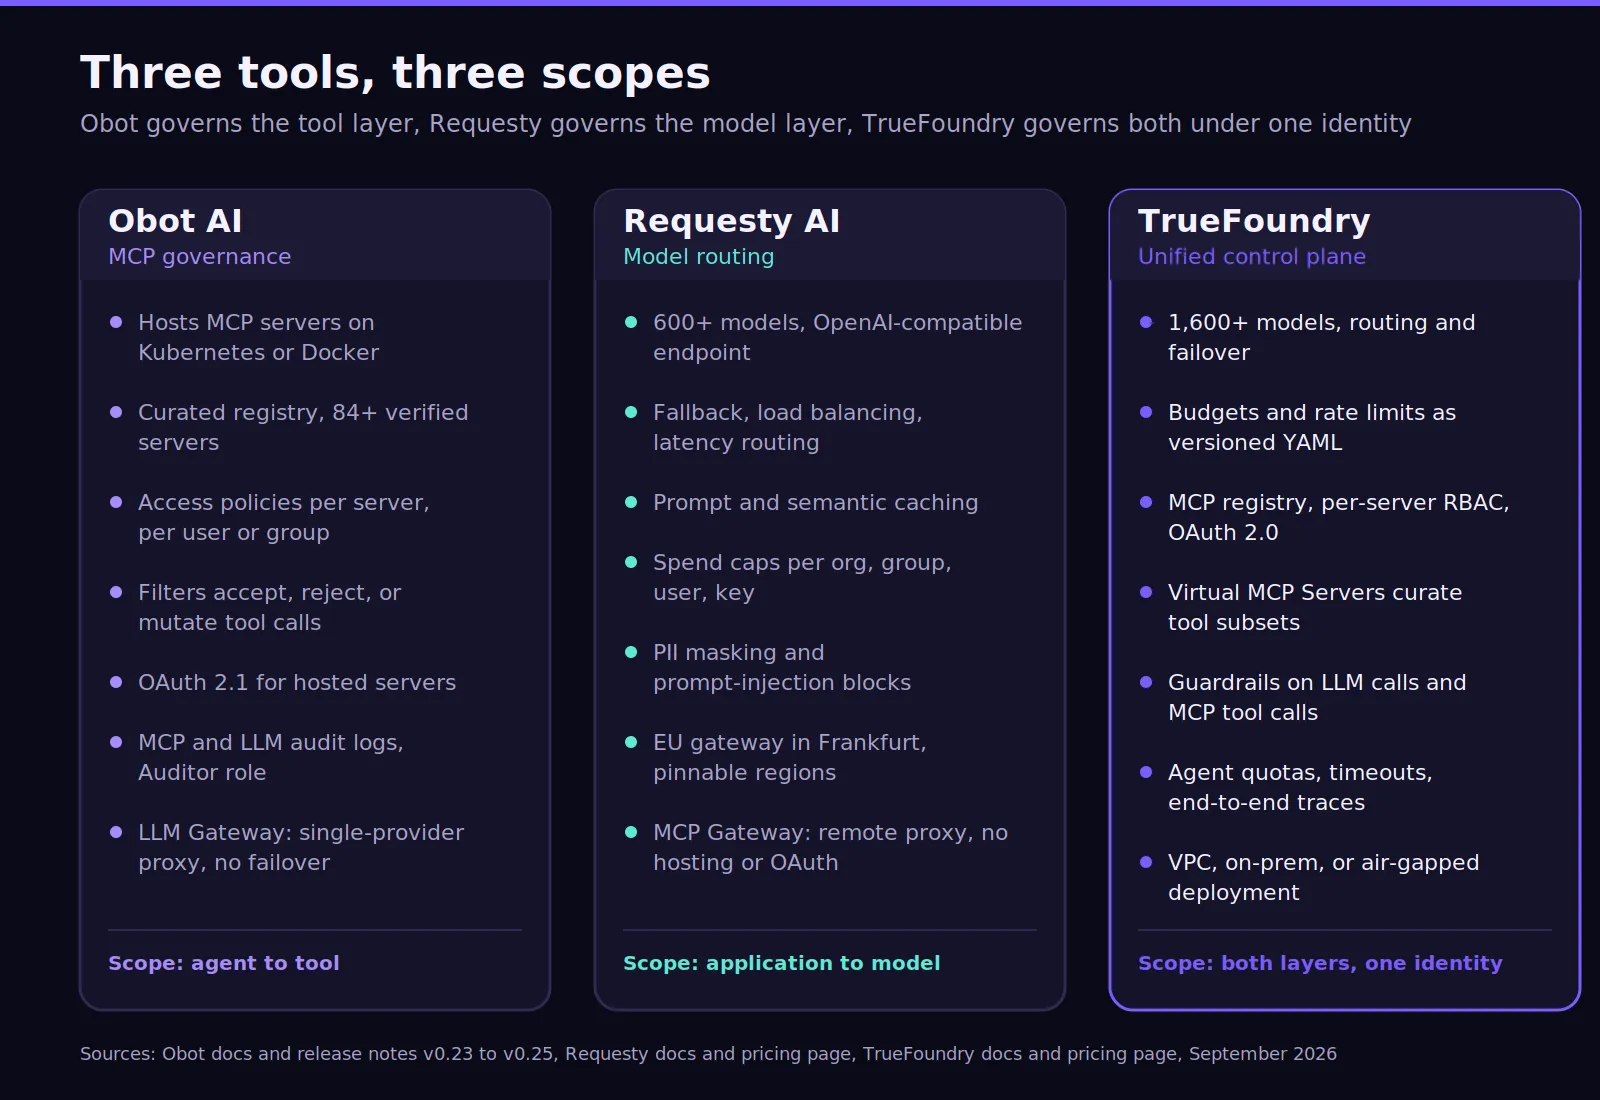
La comparación entre Requesty AI y Obot AI comienza reconociendo que sus funciones principales difieren. Obot se sitúa en la intersección de agentes, modelos y herramientas. Requesty se ubica principalmente entre las aplicaciones y los proveedores de LLM.
Obot AI centra su plataforma en Obot MCP Gateway. Puede alojar o actuar como proxy de servidores MCP, gestionar credenciales, aplicar políticas de acceso y registrar peticiones. Su plano de control también incluye un LLM Gateway, políticas de modelos, registros y servicios de agentes.
Requesty se centra más profundamente en el acceso a los modelos. Las aplicaciones cambian la URL base a Requesty y acceden a más de 600 modelos a través de un endpoint compatible con OpenAI. Las políticas de enrutamiento admiten conmutación por error (fallback), balanceo de carga, selección adaptada al coste y enrutamiento basado en latencia entre diferentes proveedores.
La distinción práctica resulta muy útil. Obot ayuda a los equipos de TI a gobernar qué identidades acceden a qué herramientas y modelos. Requesty ayuda a las aplicaciones a seleccionar un proveedor de modelos de forma fiable mientras controla los costes y la disponibilidad.
Los equipos que examinen la arquitectura de gateways de modelos también pueden revisar el análisis sobre LLM Gateway de TrueFoundry para comprender el papel del acceso centralizado a proveedores.
Las tablas de características pueden ocultar diferencias arquitectónicas, por lo que las notas situadas debajo de esta tabla son importantes. Obot posee una mayor parte de la infraestructura MCP y puede ejecutarse dentro de entornos controlados por el cliente. Requesty opera como un servicio gestionado en la nube, eliminando la mayor parte de las operaciones de gateway para el cliente.
Las capacidades principales de Obot se extienden ahora más allá de MCP. Su LLM Gateway es compatible con OpenAI, Anthropic, Amazon Bedrock, Azure y endpoints compatibles. Los administradores definen las políticas de acceso a los modelos, mientras que Obot almacena las credenciales ascendentes (upstream) en lugar de exponerlas a los usuarios.
El Obot Gateway también gestiona el alojamiento de MCP en Docker o Kubernetes. Admite servidores remotos cuando las organizaciones ya operan sus propios servidores MCP. Los filtros pueden aceptar, rechazar o modificar el tráfico antes de reenviar una llamada a una herramienta autorizada.
Requesty resuelve un problema de enrutamiento diferente. Su enrutamiento inteligente puede distribuir el tráfico en función del coste, la latencia, la calidad o un orden de conmutación por error definido. Esto lo hace más sólido para la fiabilidad multiproveedor y la optimización de costes cuando las aplicaciones utilizan varios modelos comerciales.
La gestión de agentes marca otra diferencia clara. Obot trata a un agente de IA como una identidad de plataforma gobernada con acceso a modelos y herramientas. Requesty gobierna principalmente las políticas de enrutamiento de modelos que utiliza un agente.
Obot Agent admite conversaciones y flujos de trabajo programados, mientras que los alcances de autorización de agentes (Agent Authorization Scopes) proporcionan credenciales de máquina. Un administrador puede restringir una clave API a servidores MCP seleccionados, al acceso proxy de LLM u a otras capacidades. Esto permite un acceso seguro sin necesidad de utilizar el inicio de sesión interactivo de una persona.
En lugar de que los desarrolladores integren credenciales en las herramientas de IA locales, Obot ofrece una gestión centralizada de credenciales y acceso a servidores. Los filtros aplican las políticas antes de que las peticiones aprobadas lleguen a los sistemas descendentes (downstream). El gateway también gestiona los flujos de OAuth ascendentes y renueva el token OAuth necesario en nombre del usuario.
Device Management extiende la visibilidad a clientes de desarrollador compatibles como Claude Code, Codex y Cursor. La aplicación de políticas en llamadas a herramientas sigue siendo experimental, aunque la actividad local se puede auditar. Esto proporciona a los equipos de ingeniería visibilidad sobre la actividad de IA fuera de las cargas de trabajo de agentes alojadas de forma centralizada.
Requesty no ofrece el mismo modelo de ejecución de agentes alojados. En su lugar, permite a las organizaciones aplicar una política de enrutamiento y un límite de gasto a agentes específicos. Esto resulta útil cuando el requisito principal sigue siendo la fiabilidad del modelo más que la ejecución completa del flujo de trabajo.
Los equipos que evalúen alternativas en materia de gobernanza de agentes y MCP también pueden consultar las alternativas a Obot AI.
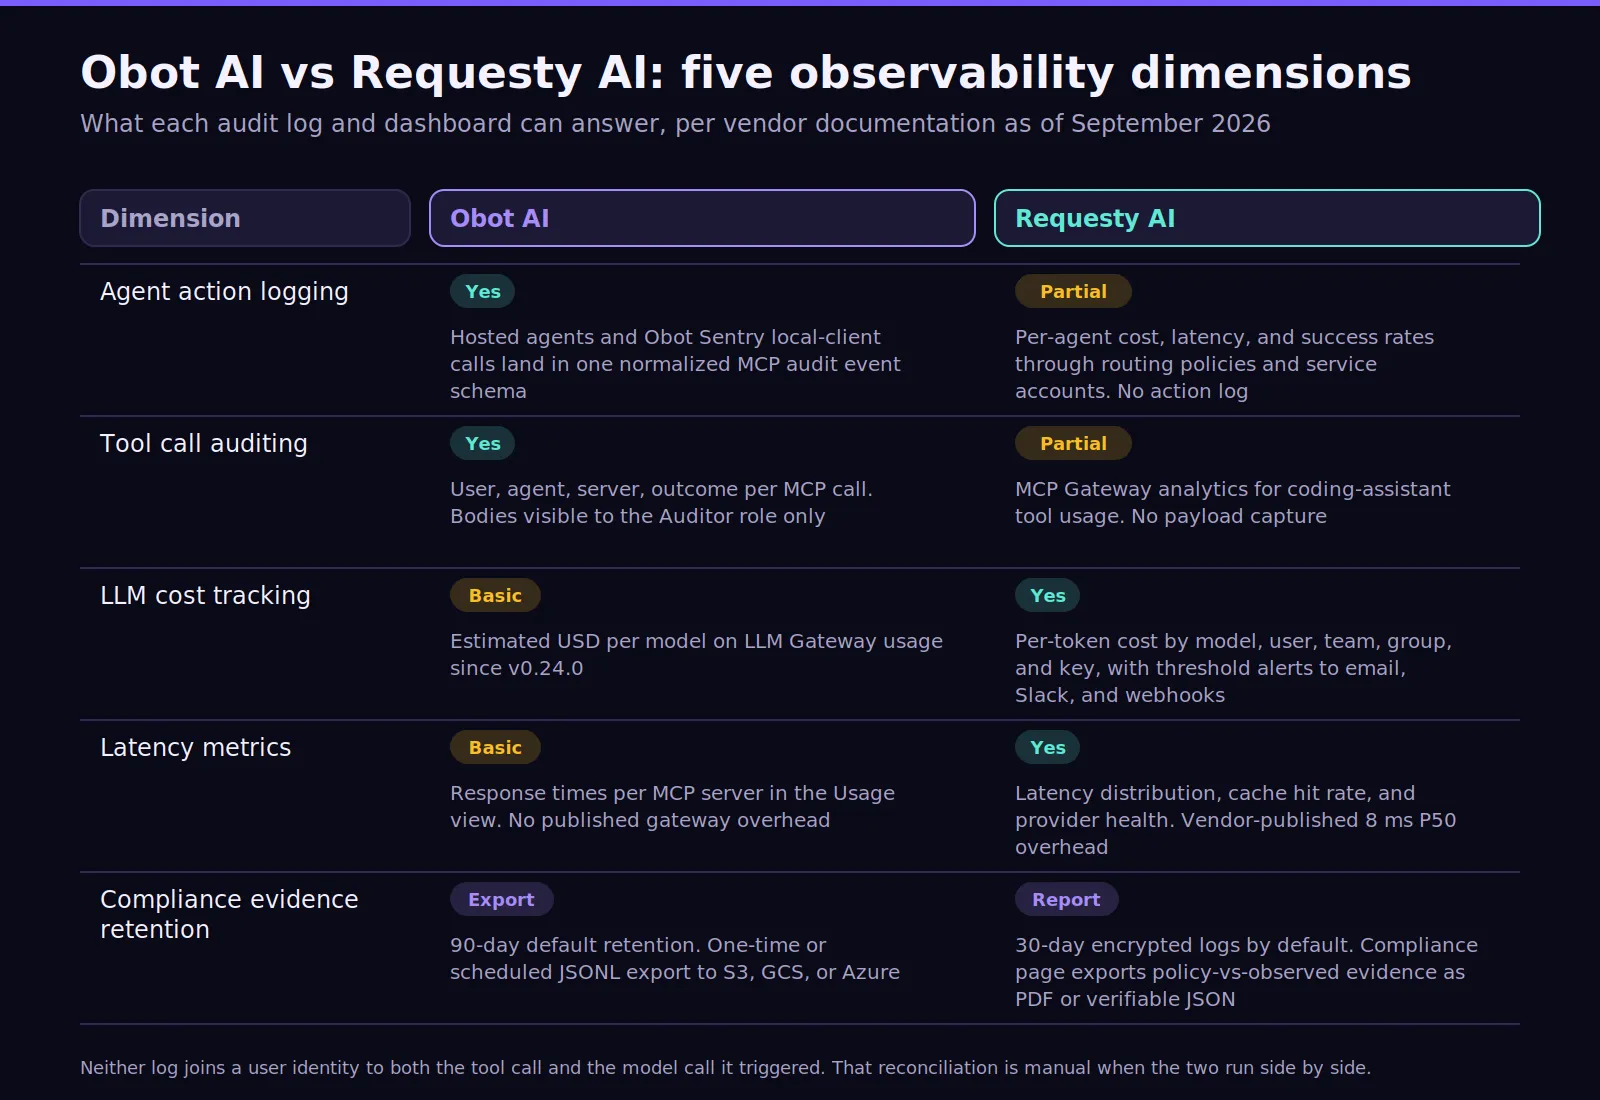
Ambas plataformas ofrecen observabilidad, aunque responden a preguntas operativas distintas. Obot se centra en la actividad de agentes, modelos y herramientas. Requesty se orienta más hacia el comportamiento del proveedor, el coste, el enrutamiento y el rendimiento del gateway.
Obot registra peticiones MCP, usuarios, marcas de tiempo, resultados, información del modelo y uso de tokens. Sus registros de auditoría de LLM también incluyen el proveedor, el modelo solicitado, los detalles del cliente y la duración. Los datos sensibles de la petición o respuesta requieren el rol de Auditor (Auditor role).
Las exportaciones de auditoría se pueden enviar a Amazon S3, Google Cloud Storage, Azure Blob Storage o almacenamiento de objetos compatible. De este modo, las organizaciones conservan el control total sobre las evidencias a largo plazo y pueden alinear el almacenamiento con sus requisitos de privacidad de datos.
Requesty enfatiza la latencia de las peticiones, el rendimiento de la caché, el coste del modelo, los fallos y el enrutamiento de proveedores. Su panel de control proporciona visibilidad en tiempo real del coste y el uso en claves, equipos y modelos. El gateway también admite enrutamiento regional basado en políticas y endpoints con retención cero de datos.
Esta distinción es relevante para los requisitos de cumplimiento normativo. Obot proporciona una pista de auditoría detallada sobre las acciones de los agentes y de MCP. Requesty ofrece a los equipos una mayor visibilidad sobre los resultados del enrutamiento de modelos, la aplicación de políticas y los costes en todo el tráfico de modelos en producción.
Los modelos de precios y despliegue reflejan filosofías de propiedad diferentes. Obot otorga a los clientes un mayor control sobre la infraestructura. Requesty cobra por un gateway totalmente gestionado y elimina la mayor parte del trabajo operativo.
Actualmente, Obot ofrece tres ediciones a partir de la misma imagen de contenedor. La edición predeterminada admite hasta 100 usuarios y 100 dispositivos. Community sigue siendo gratuita y añade Entra, Okta, JumpCloud y Auth0. Enterprise elimina esos límites e incluye soporte empresarial.
Un despliegue en Kubernetes o Docker mantiene a Obot dentro de la infraestructura del cliente. Las cargas de trabajo MCP alojadas se ejecutan en contenedores separados o en cargas de trabajo de Kubernetes. Esta estructura puede adaptarse a organizaciones con requisitos estrictos de nube privada, credenciales internas o almacenamiento de auditoría local.
Requesty ofrece un punto de entrada gratuito y precios de pago por uso. Su tarificación actual añade un 5 % a los costes de los modelos ascendentes, mientras que las claves de proveedor propiedad del cliente no tienen recargo (0 %). El plan gratuito admite 200 peticiones diarias sobre los modelos gratuitos disponibles.
El precio Enterprise de Requesty es personalizado. El plan Enterprise añade SSO, RBAC, soporte de cumplimiento normativo, SLA personalizados y controles organizativos más profundos. Su periodo de observación SOC 2 Tipo II sigue en progreso, mientras que la residencia de datos en la UE está disponible en Fráncfort.
Para cargas de trabajo a gran escala, los equipos deben comparar el licenciamiento con la responsabilidad operativa. El autohospedaje implica que el parcheo, el escalado, el almacenamiento y el soporte siguen siendo responsabilidades internas. El modelo SaaS elimina gran parte de ese trabajo, mientras el cliente acepta las opciones de despliegue y el límite de seguridad del proveedor.
Lea también: Guía de costes de AI gateways
Obot AI es adecuado para equipos que necesitan una capa de gobernanza de MCP dedicada. Resulta útil cuando los agentes internos, los asistentes de código y los clientes de IA necesitan un acceso aprobado a servidores MCP locales, remotos o alojados. También respalda a las organizaciones que prefieren la infraestructura de código abierto y el control autohospedado.
Cabe añadir una advertencia. El límite de 100 usuarios y 100 dispositivos por debajo de Obot Enterprise se introdujo en la versión v0.25.0 y ahora se aplica a los despliegues con autenticación de GitHub y Google que antes eran ilimitados. Los usuarios existentes pueden seguir trabajando tras superar el límite, pero no se pueden añadir otros nuevos. Dimensione el piloto teniendo en cuenta esa cifra.
Requesty AI se adapta a equipos que necesitan un acceso rápido a múltiples modelos a través de un gateway gestionado. Su mayor valor reside en ofrecer proveedores de LLM fiables, políticas de enrutamiento, almacenamiento en caché, analítica y controles de gasto sin necesidad de gestionar infraestructura autohospedada.
La plataforma también funciona bien para cargas de trabajo de prototipado donde los equipos desean experimentar rápidamente con diferentes modelos. Una vez que el uso alcanza un nivel moderado de RPS o picos más altos, los equipos deben probar la fiabilidad del proveedor y los escenarios de alta latencia utilizando tráfico de producción real en lugar de peticiones aisladas.
El gateway de Requesty puede redirigir el tráfico evitando proveedores degradados y aplicar restricciones de modelos de forma centralizada. Esto puede mejorar la experiencia del desarrollador cuando, de otro modo, los equipos tendrían que mantener credenciales e integraciones independientes. Su interfaz compatible con OpenAI también minimiza los cambios en las aplicaciones.
Elegir entre Obot AI o Requesty AI basándose únicamente en una demo puede llevar a conclusiones erróneas. Una plataforma puede mostrar cómo se bloquea el acceso a una herramienta, mientras que la otra demuestra una conmutación por error exitosa. Ambos escenarios son importantes, aunque cada uno mide una capa diferente de la producción.
La comparación entre Obot AI y Requesty AI revela una limitación compartida cuando un flujo de trabajo atraviesa ambas capas. Obot gobierna modelos, agentes y acceso a MCP dentro de su plataforma. Requesty ofrece un enrutamiento entre proveedores más profundo. Ninguno combina todos los controles empresariales con el mismo nivel de profundidad.
Un flujo de trabajo de soporte técnico puede llamar a un modelo, consultar un CRM a través de MCP, actualizar un caso y activar otro agente. Esto crea una exposición potencial de datos cuando la identidad, los permisos, los presupuestos y los registros se distribuyen en sistemas independientes.
Requesty también ha ampliado sus propias integraciones con MCP. Su MCP Gateway admite autenticación centralizada, listas blancas de herramientas, analítica de uso y credenciales compartidas o por usuario para servidores MCP remotos. Sin embargo, no reemplaza el alojamiento completo de MCP ni la gobernanza integral de la ejecución de agentes.
Las piezas faltantes se hacen más evidentes cuando los equipos buscan una única política para modelos y herramientas:
Una capa de agentes dedicada cobra relevancia cuando estas acciones se convierten en flujos de trabajo de varios pasos. El Agent Gateway de TrueFoundry ofrece reintentos, tiempos de espera (timeouts), controles de políticas, trazabilidad y ejecución gobernada de herramientas en todos esos flujos de trabajo.
TrueFoundry es ideal para empresas que buscan una única plataforma que conecte la gobernanza de modelos, herramientas y agentes. Su plano de control de IA integra enrutamiento de modelos, identidad, políticas, presupuestos, barreras de protección (guardrails) y observabilidad en una misma arquitectura de producción.
La capa de modelos admite enrutamiento multiproveedor y servicio de modelos (model serving) en endpoints alojados y autohospedados. Las políticas presupuestarias se pueden aplicar a usuarios, equipos, modelos o metadatos antes de que se ejecuten peticiones adicionales.
Una regla presupuestaria es un objeto YAML con control de versiones, por lo que reside en Git junto con el resto de la configuración de la plataforma:
Cuando el pipeline RAG del equipo de soporte supera los 5000 $ en un mes, el gateway devuelve un 429 con `error_origin_level: rate_limit_budget` en el cuerpo y el ID de la regla infringida en la cabecera `x-tfy-applied-rules`, evitando sorpresas en la factura. Esto cubre el caso de uso de acceso multiproveedor y gobernanza de costes que ofrece Requesty AI, con la ventaja arquitectónica añadida del despliegue nativo en VPC.
El MCP gateway de TrueFoundry ofrece RBAC por servidor, abstracciones de servidores MCP virtuales (Virtual MCP Server), gestión de tokens OAuth 2.0 con renovación automática y pistas de auditoría vinculadas a la identidad del usuario para cada invocación de herramienta.
Un servidor MCP virtual (Virtual MCP Server) toma un subconjunto de herramientas de varios servidores registrados (por ejemplo, GitHub sin `delete_pr` y Slack sin `delete_message`) y las expone como un único endpoint que no requiere despliegue. Las barreras de protección se vinculan en la misma capa de políticas, y un solo archivo YAML gobierna tanto las llamadas a LLM como las llamadas a herramientas MCP:
Esta arquitectura es muy útil cuando el uso de productos de gateway independientes generaría políticas superpuestas. También puede simplificar la gobernanza cuando varios equipos comparten modelos, agentes y herramientas MCP en diferentes entornos.
Elija TrueFoundry cuando:
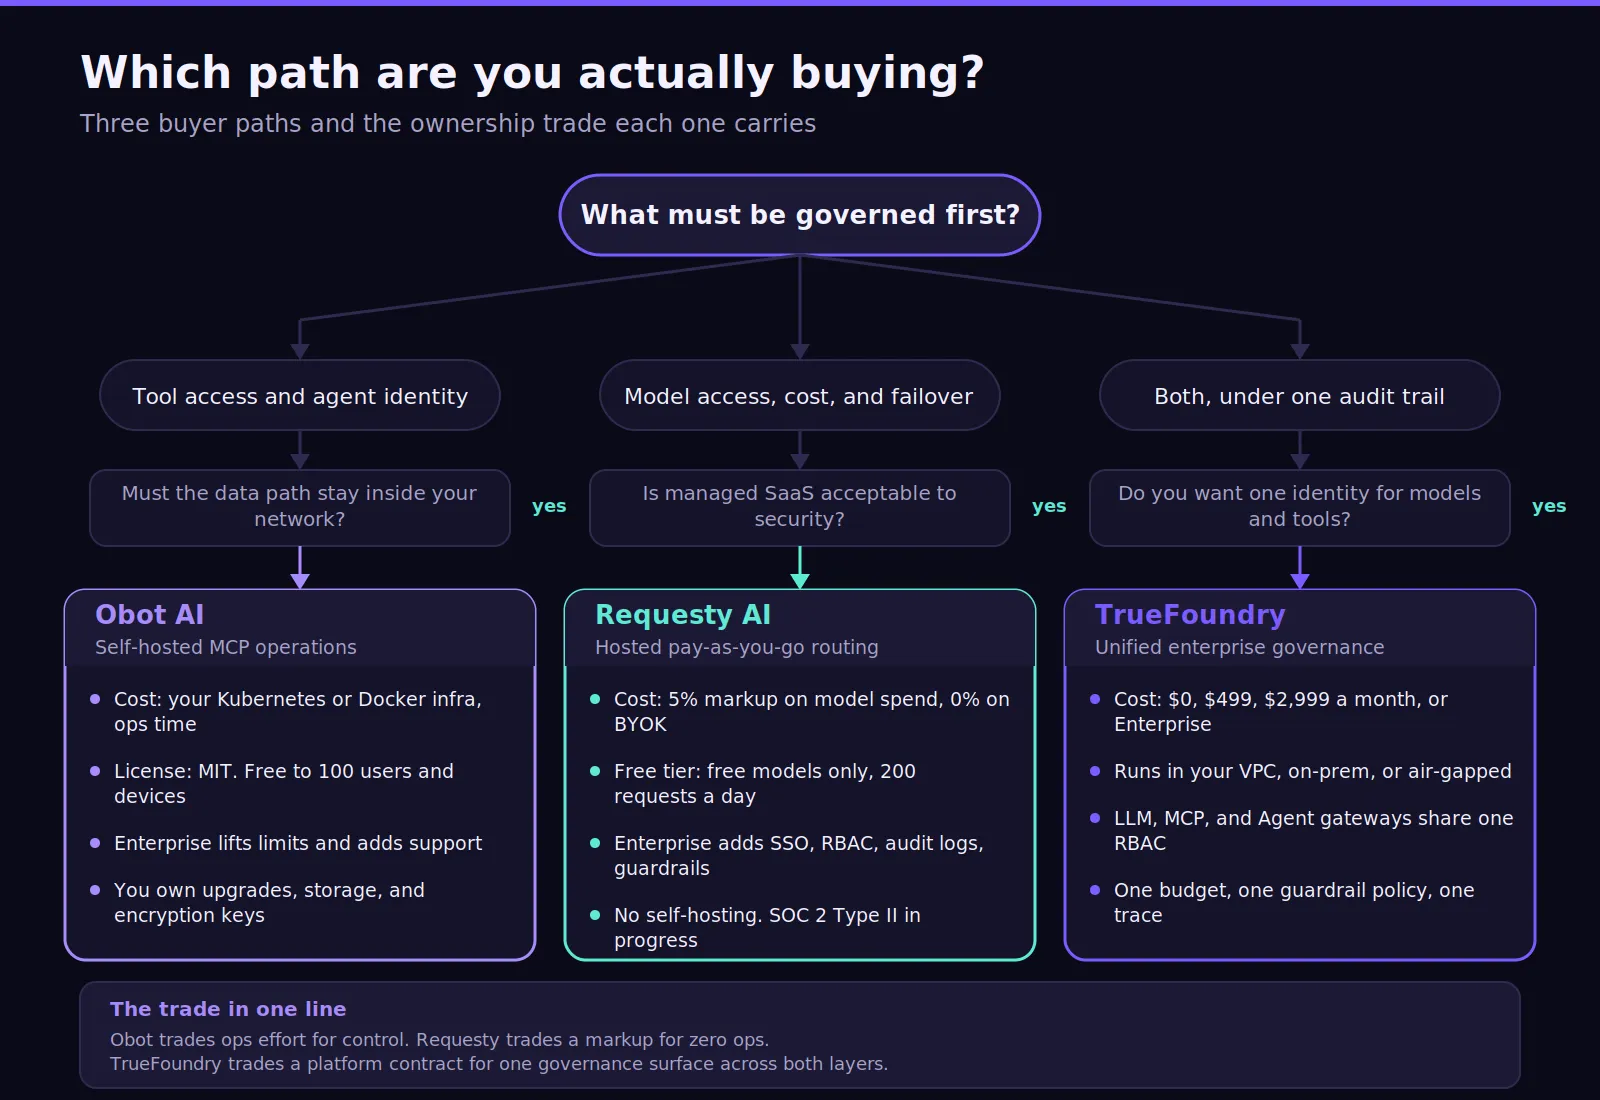
TrueFoundry ofrece actualmente el plan Developer a 0 $, Pro a 499 $ mensuales, Pro Plus a 2999 $ y precios personalizados para Enterprise. El plan Enterprise admite planos de control y de gateway en VPC y aislados (air-gapped).
Para los equipos que comparan arquitecturas de producción más amplias, TrueFoundry proporciona una capa de control unificada para modelos, herramientas, agentes y ejecución empresarial gobernada.
Reserve una demo con TrueFoundry para descubrir cómo un único plano de control empresarial puede gobernar de forma segura modelos, herramientas MCP, agentes, presupuestos, políticas y evidencias de auditoría hoy mismo en su entorno de IA en producción.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















