



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
GPT-6 Astra llegó el 3 de septiembre de 2026. La cadena de la API es gpt-6-astra; sin instantánea fechada ni alias independiente; la página del modelo enumera gpt-6-astra tanto como la instantánea como el alias.
Las especificaciones, según la documentación del modelo de OpenAI:
Hay tres detalles en la letra pequeña que importan más que el titular.
En primer lugar, reasoning.effort ya no acepta none. GPT-5.6 Sol sí lo hacía. Si tiene una ruta rápida y barata fijada en none, no se podrá migrar tal cual.
En segundo lugar, temperature, top_p y logprobs han desaparecido. El registro de cambios establece que Astra «no admite valores personalizados de temperature o top_p ni log probabilities». Cualquier elemento de su stack que configure parámetros de muestreo debe ser auditado antes de realizar el cambio.
En tercer lugar, la llamada a herramientas (tool calling) requiere la API de Responses. Si hoy realiza llamadas a herramientas a través de Chat Completions, se trata de una migración, no de un simple cambio de modelo.
[CAPTURA DE PANTALLA: OpenAI Platform — la página del modelo gpt-6-astra mostrando la ventana de contexto, la salida máxima y el precio por token]
La ventana de contexto y el límite de salida no han variado. El precio sí.
Fuentes: documentación del modelo GPT-6 Astra, documentación del modelo GPT-5.6 Sol, septiembre de 2026. Tenga en cuenta que OpenAI describe las tarifas de GPT-5.6 Sol como precios promocionales disponibles al menos hasta el 21 de noviembre de 2026, por lo que es posible que la proporción no se mantenga después de esa fecha.
Cada tarifa ha cambiado exactamente en el mismo factor. Esto resulta ser relevante para la cuestión del almacenamiento en caché que se analiza a continuación.
Batch y Flex se mantienen al 50% de Standard. El modo Fast, que según OpenAI ofrece hasta el doble de velocidad que el procesamiento Standard, tiene un precio equivalente a 2x las tarifas aplicables; por lo tanto, Astra en modo Fast cuesta $20 de entrada y $100 de salida.
OpenAI publica una gran tabla comparativa en el post de lanzamiento. A continuación se muestra la parte que merece la pena reproducir y, después, la parte que la mayoría de la cobertura omite.
Fuente: post de lanzamiento de GPT-6 Astra, septiembre de 2026. Las puntuaciones son el máximo en cualquier nivel de esfuerzo de razonamiento.
Donde Astra lidera claramente. Trabajo agéntico de largo alcance. Terminal-Bench 4.0 sube más de veinte puntos respecto a Sol. Terminal-Bench Science casi se triplica. AutomationBench se duplica con creces. La recuperación en contextos largos de 512K-1M pasa del 73.8% al 96.3%. Estas son las cargas de trabajo para las que se creó el modelo y la diferencia es notable.
Donde la brecha se reduce a margen de error. Conocimiento y razonamiento en un solo intento (single-shot). GPQA Diamond pasa de 94.6% a 96.0%. DeepSWE pasa de 72.7% a 74.1%. Si su tráfico consiste en preguntas con respuestas en lugar de tareas con pasos, está pagando 2.5x por aproximadamente un punto de mejora.
Donde Astra no gana. En los dos índices compuestos de terceros que OpenAI decidió incluir, Astra no ocupa el primer lugar. El Artificial Analysis Intelligence Index sitúa a Claude Fable 5.1 en 65.7 frente a los 61.2 de Astra. El Coding Agent Index ubica a Claude Opus 5 en 68.1 frente a los 67.0 de Astra. OpenAI publicó ambas cifras, lo cual es encomiable, y representan el contrapeso honesto al dominio agéntico mostrado arriba.
Un factor que complica el análisis de precios. Las estimaciones de costes por tarea de OpenAI a veces resultan inferiores a las de Sol a pesar de las tarifas 2.5x más altas, porque Astra termina consumiendo menos tokens. La publicación de lanzamiento afirma un coste estimado en la API por tarea aproximadamente un 9% menor en Terminal-Bench 4.0 en comparación con Sol, cerca de un 27% menor en Terminal-Bench Science en una configuración de menor coste, y alrededor de un 43% menor en BenchCAD. Estas son las propias estimaciones de OpenAI en configuraciones específicas, no reproducciones independientes, y no se generalizarán a su tráfico. Pero sí significan que «2.5x más caro» es una síntesis errónea para el trabajo agéntico. Mida los tokens por tarea completada, no el precio por token.
TrueFoundry calculó el cálculo del umbral de rentabilidad del caché en GPT-5.6 cuando las escrituras en caché pasaron a ser facturables por primera vez. La misma pregunta se aplica aquí, y la respuesta es más interesante de lo que parece.
Los multiplicadores de caché de Astra son idénticos a los de GPT-5.6. La documentación del modelo indica que las escrituras en caché se facturan a 1.25x la tarifa de entrada no almacenada en caché, y la tarifa publicada de entrada en caché de $1.00 frente a una tarifa de entrada de $10.00 es exactamente 0.10x. Por lo tanto:
Sea w la proporción de solicitudes contra un prefijo compartido que son escrituras en caché en lugar de lecturas. El almacenamiento en caché alcanza el umbral de rentabilidad cuando:
1.25w + 0.10(1 - w) = 1
1.15w = 0.90
w = 78.3%
El punto de equilibrio es del 78.3%, sin cambios respecto a GPT-5.6. P se cancela, razón por la cual el aumento de precio de 2.5x no altera nada. El almacenamiento en caché deja de compensar solo cuando más de aproximadamente el 78% de sus solicitudes contra un prefijo dado son escrituras; es decir, cuando su contexto compartido sobrevive a menos de 1.3 solicitudes de media antes de cambiar o expirar. Casi ninguna carga de trabajo de agente real se encuentra en ese rango.
Lo que sí modifica el aumento de precio es la magnitud del ahorro. Considere un prefijo compartido de 32K tokens reutilizado a lo largo de una sesión de 25 solicitudes: una escritura y veinticuatro lecturas:
El porcentaje es idéntico. Los costes absolutos en dólares son 2.5x mayores. Siempre valió la pena utilizar el almacenamiento en caché; en Astra, no hacerlo cuesta dos veces y media más.
El escenario de fallo tampoco ha cambiado: contexto que cambia rápidamente (high churn). Si su agente reconstruye el system prompt o el esquema de herramientas cada pocos turnos, pagará $12.50 por millón para escribir una caché que apenas leerá. Eso es ahora un error de $12.50 en lugar de uno de $5.00.
La ventana de contexto anunciada para GPT-6 es de 1 050 000 tokens. Sin embargo, la facturación no se escala de forma gradual a lo largo de ella.
Según la documentación del modelo: «Los prompts con más de 272K tokens de entrada se tarifican a 2x los precios de entrada y caché y a 1.5x la salida para la solicitud completa».
Lea esto con atención. Es para la solicitud completa, no para el exceso por encima de 272K. Cruzar la línea no cuesta el doble solo en los tokens adicionales; cuesta el doble en todos ellos.
Un incremento del 0.7% en el tamaño del prompt produce un aumento del 101% en la factura de entrada. Las lecturas en caché también se duplican, de $1.00 a $2.00 por millón, y la salida pasa de $50.00 a $75.00. GPT-5.6 Sol aplica la misma regla, por lo que esto no es nuevo; sin embargo, con las tarifas de Astra, el salto es 2.5 veces mayor.
La consecuencia práctica: si sus prompts se sitúan cerca de los 272K, la optimización de costes con mayor impacto a su alcance es reducirlos por debajo de ese límite. Recortar 5K tokens de un prompt de 275K aporta más valor que cualquier cambio de enrutamiento que pueda realizar.
[CAPTURA DE PANTALLA: OpenAI Platform — panel de control de uso que muestra el gasto en tokens de entrada, entrada en caché y salida por modelo]
Surgen cuatro patrones de fallo de forma recurrente en las primeras semanas tras el lanzamiento de un modelo puntero, y Astra presenta los cuatro.
Todo se enruta hacia el nuevo modelo. Lo más costoso que hace un equipo tras un lanzamiento es definir el nuevo modelo por defecto. Con $10 de entrada y $50 de salida, una llamada de clasificación que un modelo económico responde correctamente cuesta ahora 2.5x más que el mes pasado sin ganancia alguna en calidad. La dispersión de los benchmarks mostrada arriba es un argumento a favor de una flota mixta, no de una migración a ciegas.
La migración no es un mero cambio de cadena de texto. Sin esfuerzo de razonamiento none, sin temperature, sin top_p, sin logprobs, y con llamadas a herramientas que requieren la API de Responses. El código que funcionaba con gpt-5.6-sol puede fallar con gpt-6-astra de formas que no son evidentes hasta llegar a producción.
La supervisión de desalineación puede detener su solicitud. OpenAI ejecuta verificaciones asíncronas en el trabajo agéntico en las solicitudes admitidas de la API de Responses. La publicación de lanzamiento es explícita sobre la consecuencia: en ChatGPT o Codex se le puede pedir que revise una acción, pero «en la API, la tarea se detendrá». OpenAI reconoce que estas verificaciones «a veces pueden interrumpir el trabajo legítimo». Se trata de una nueva característica de fiabilidad que requiere diseño previo, no de una simple nota al pie.
Nadie sabe cuánto cuesta realmente hasta que llega la factura. El precio por token dice muy poco cuando el modelo utiliza un número diferente de tokens por tarea. Sin una atribución de costes por solicitud y por equipo, la pregunta «¿es Astra más barato o más caro para nosotros?» no se puede responder.
Un modelo de vanguardia más caro no debilita la necesidad de un gateway; la refuerza, porque cada decisión de enrutamiento vale ahora 2.5 veces más.
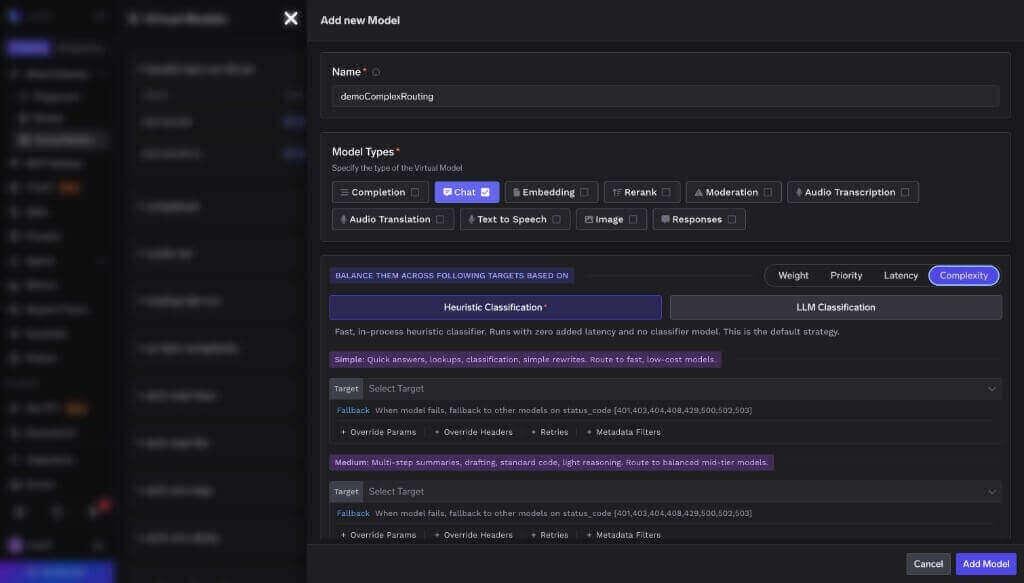
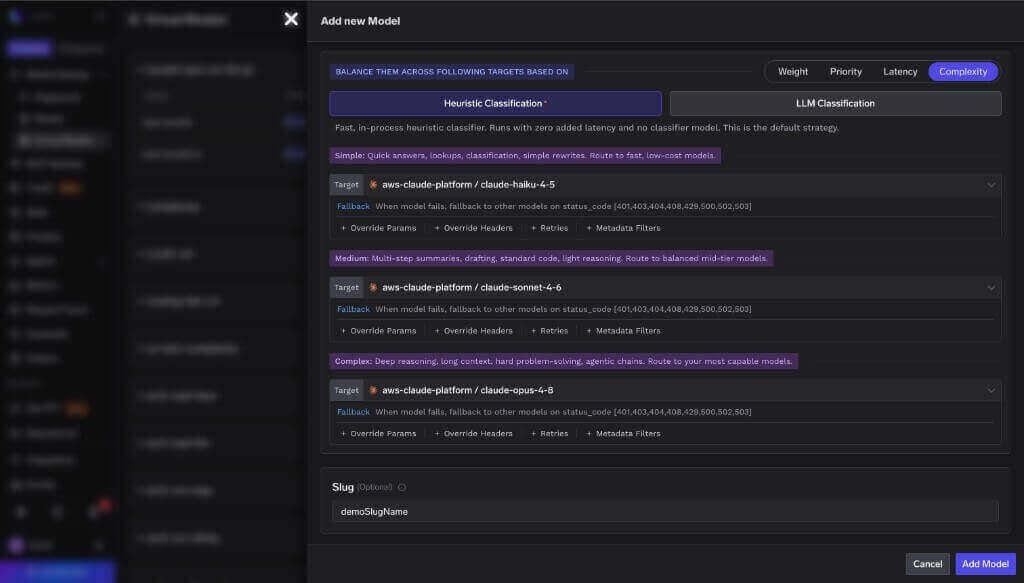
Enrute por complejidad, no por costumbre. El AI Gateway clasifica las solicitudes entrantes y envía cada una al nivel adecuado, de modo que el trabajo agéntico complejo llegue a Astra y la extracción, clasificación y resumen no lo hagan. En el benchmark propio de Auto Routing de TrueFoundry sobre 550 prompts, la segmentación por niveles redujo el coste un 69% manteniendo el 98% de la calidad de referencia, con una caída de la latencia media de 7.6s a 4.0s. En tráfico con estructura de producción, la reducción alcanzó el 80%. Esos porcentajes aplicados a tarifas de $10/$50 valen considerablemente más de lo que valían a $4/$20.
Normalice el almacenamiento en caché entre proveedores. La semántica de caché de Astra es la propia de OpenAI. La de Anthropic es diferente, y la de Bedrock vuelve a ser distinta. El almacenamiento en caché de prompts independiente del proveedor a nivel de gateway permite escribir el prefijo una sola vez y mantener la regla del 78.3% explicada anteriormente, independientemente del modelo que seleccione el enrutador.
Mida el coste por tarea, no el coste por token. Todo el debate sobre el precio de Astra gira en torno a la eficiencia de tokens, y esto no se puede resolver mediante una lista de tarifas. El coste por solicitud, el recuento de tokens y la latencia desglosados por equipo y modelo es como descubrirá si la afirmación de Astra de usar menos tokens por tarea se cumple en su carga de trabajo.

Mantenga una única ruta de guardrails entre modelos. Los guardrails a nivel de gateway se ejecutan en la ruta de solicitud y respuesta independientemente del modelo que responda, garantizando que un cambio de enrutamiento no altere silenciosamente su postura de seguridad.

La versión resumida, a fecha de septiembre de 2026:

GPT-6 Astra representa un avance real en las tareas para las que fue concebido. Terminal-Bench 4.0 sube veinte puntos, la recuperación en contexto largo aumenta veintidós, AutomationBench se duplica con creces; estos avances no son marginales. En los índices compuestos de terceros publicados por la propia OpenAI, no figura en la primera posición, y en preguntas de conocimiento de un solo intento la diferencia con GPT-5.6 Sol está muy cerca del margen de error.
La estructura de precios refleja la misma dualidad. Cada tarifa ha aumentado 2.5x, lo que parece un incremento directo hasta que se observa que las propias estimaciones por tarea de OpenAI resultan inferiores a las de Sol en varios benchmarks agénticos, debido a que Astra completa las tareas con menos tokens. Ambas realidades son compatibles. Cuál de ellas se aplica a su caso es una cuestión empírica sobre su tráfico, y la única forma de responderla es ejecutar ambos modelos y medir el coste por tarea completada.
Hay dos aspectos que no requieren medición. El almacenamiento en caché sigue compensando exactamente en el mismo umbral de rentabilidad del 78.3% que en GPT-5.6; por lo tanto, si utiliza caché hoy, manténgalo. Y el salto de facturación a partir de 272K es una función escalonada que duplicará silenciosamente una factura de entrada por un prompt que haya crecido unos pocos miles de tokens.
Por tanto, todo se reduce a qué modelo operacional desea adoptar. Si prefiere tener un solo modelo y una factura simple, dirija todo a Astra y asuma que estará pagando de más por la mitad sencilla de su tráfico. Si prefiere enviar el trabajo complejo al modelo puntero y todo lo demás a opciones más económicas, necesitará una capa de enrutamiento —y con tarifas de $10 de entrada y $50 de salida, la justificación financiera para implementar una acaba de hacerse dos veces y media más convincente.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




GPT-6 Astra es el modelo de frontera de OpenAI, lanzado el 3 de septiembre de 2026 y disponible en la API como gpt-6-astra. Está disponible a través de la API de OpenAI, Microsoft Azure y AWS Bedrock, y para los usuarios de ChatGPT Plus, Pro, Business y Enterprise.
A septiembre de 2026, por cada millón de tokens: 10,00 $ de entrada, 1,00 $ de entrada en caché, 12,50 $ de escrituras en caché y 50,00 $ de salida. Batch y Flex cuestan el 50 % de esas tarifas; el modo Fast, el doble. Las solicitudes de más de 272K tokens de entrada se facturan al doble de las tarifas de entrada y de caché y a 1,5 veces la de salida para toda la solicitud.
1.050.000 tokens, con una salida máxima de 128.000 tokens. Ambas cifras son idénticas a las de GPT-5.6 Sol. El límite práctico es comercial más que técnico: a partir de 272K tokens de entrada, toda la solicitud se factura al doble de la tarifa de entrada.
Depende por completo del tipo de tarea. En trabajo agéntico de largo recorrido las mejoras son grandes: Terminal-Bench 4.0 pasa del 37,3 % al 57,9 %. En preguntas de conocimiento de una sola respuesta son marginales, y usted paga 2,5 veces más por token por ellas. Enrute en consecuencia en lugar de cambiarlo todo de golpe.
Sí, y con el mismo margen. Las escrituras en caché cuestan 1,25 veces el precio de entrada y las lecturas 0,10 veces, exactamente igual que en GPT-5.6, así que el punto de equilibrio se sitúa en una proporción de escrituras del 78,3 % en ambos casos. Los precios de lista más altos aumentan el ahorro absoluto, no el umbral.
El AI Gateway de TrueFoundry añade aproximadamente 3-4 ms y sostiene más de 350 RPS con 1 vCPU, algo irrelevante frente a tiempos de generación de varios segundos.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















