


August 26, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Large Language Models wie ChatGPT und Diffusionsmodelle wie Stable Diffusion haben die Welt in knapp einem Jahr im Sturm erobert. Immer mehr Unternehmen beginnen nun, Generative AI für ihre bestehenden und neue, spannende Anwendungsfälle zu nutzen. Während die meisten Unternehmen direkt mit der Nutzung von APIs von Anbietern wie OpenAI, Anthropic, Cohere usw. beginnen können, bringen diese APIs auch erhebliche Kosten mit sich. Auf lange Sicht möchten viele Unternehmen kleinere bis mittelgroße Versionen gleichwertiger Open-Source-LLMs wie Llama, Flan-T5, Flan-UL2, GTP-Neo, OPT, Bloom usw. feinabstimmen, so wie es die Projekte Alpaca und GPT4All getan haben.
Das Finetuning kleinerer Modelle mit Ausgaben größerer Modelle kann auf vielfältige Weise nützlich sein:
Um all dies zu ermöglichen, sind GPUs zum essenziellen Arbeitstier in jedem Unternehmen geworden, das mit diesen Fundamentaldaten-Modellen arbeitet. Mit wachsenden Modellgrößen, die mittlerweile Trillionen von Parametern erreichen, wird verteiltes Training über mehrere GPUs langsam zum neuen Standard. Nvidia ist mit seinen neueren Karten der Ampere- und Hopper-Serie führend im Hardware-Bereich. Hochgeschwindigkeits-Interconnects wie NVLink und Infiniband ermöglichen die Verbindung von bis zu 256 Nvidia A100 oder Nvidia H100 (und ~4k in Super-Pod-Clustern), um immer größere Modelle in Rekordzeit zu trainieren und auszuführen.
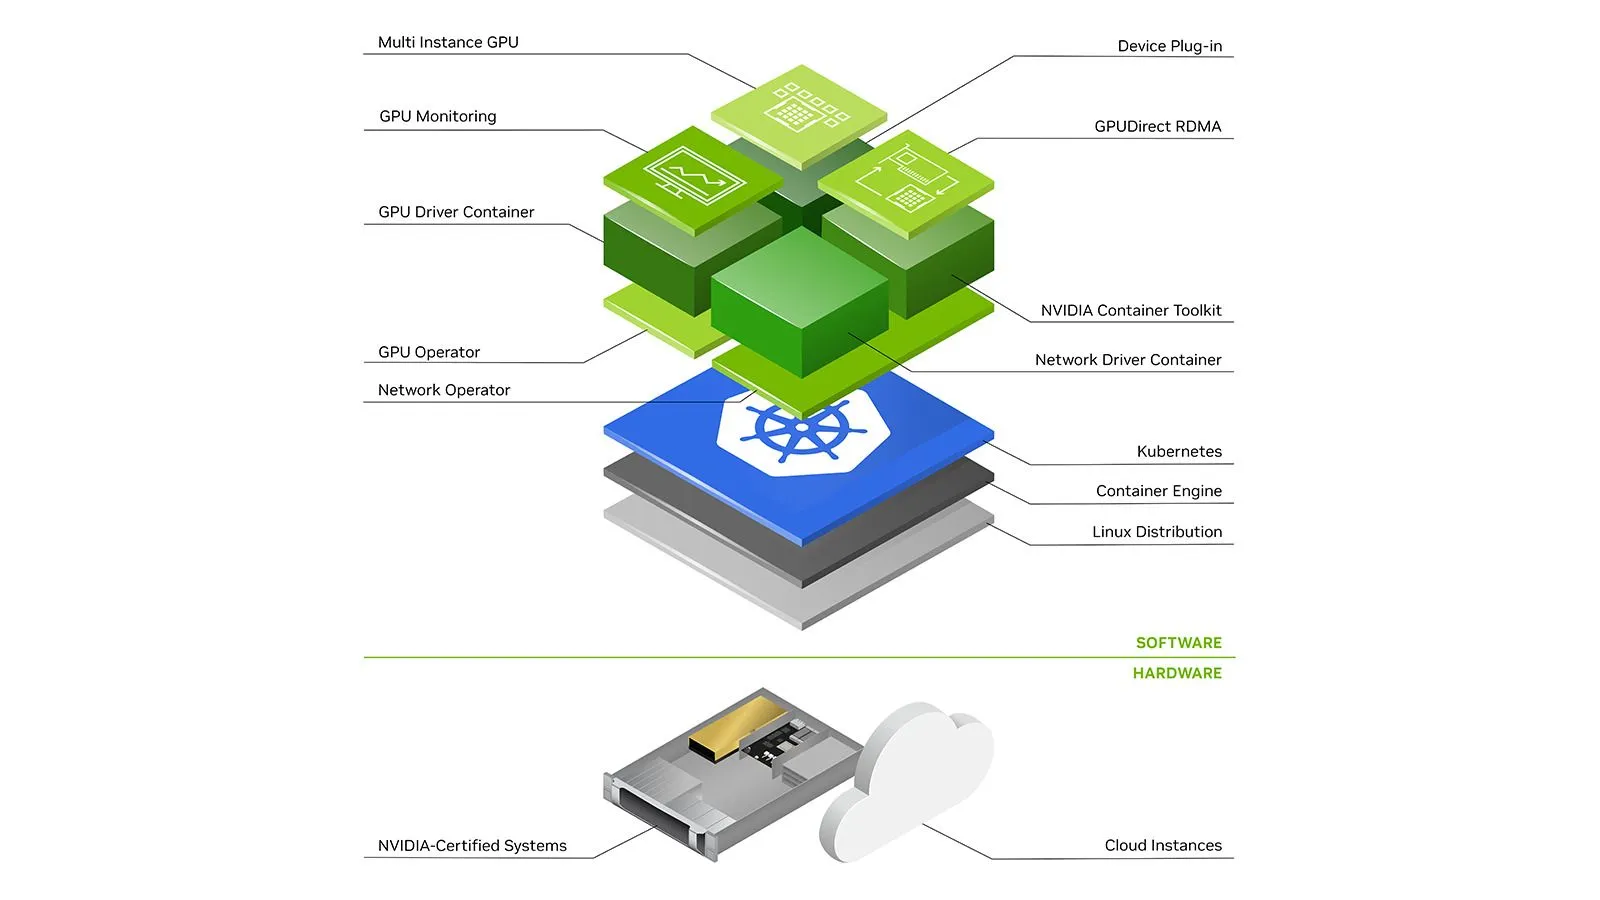
Wir gehen nun die Komponenten durch, die für die Nutzung von GPUs mit Kubernetes erforderlich sind – hauptsächlich auf AWS EKS und GCP GKE (Standard oder Autopilot), aber die genannten Komponenten sind auf jedem K8s-Cluster essenziell.

Ihr Cloud-Anbieter verfügt über GPU-VMs – wie bringen wir sie in den K8s-Cluster? Eine Möglichkeit besteht darin, GPU-Nodepools fester Größe oder mit dem cluster autoscaler manuell zu konfigurieren, der GPU-Knoten bei Bedarf hinzufügt und wieder freigibt, wenn sie nicht mehr benötigt werden. Dies erfordert jedoch weiterhin die manuelle Konfiguration mehrerer verschiedener Nodepools. Eine noch bessere Lösung ist die Konfiguration automatischer Bereitstellungssysteme wie AWS Karpenter oder GCP Node Auto Provisioners. Wir haben darüber in unserem vorherigen Artikel gesprochen: Cluster Autoscaling for Big 3 Clouds ☁️
apiVersion: karpenter.sh/v1alpha5
kind: Provisioner
metadata:
  name: gpu-provisioner
  namespace: karpenter
spec:
  weight: 10
  kubeletConfiguration:
    maxPods: 110
  limits:
    resources:
      cpu: "500"
  requirements:
    - key: karpenter.sh/capacity-type
      operator: In
      values:
        - spot
        - on-demand
    - key: topology.kubernetes.io/zone
      operator: In
      values:
        - ap-south-1
    - key: karpenter.k8s.aws/instance-family
      operator: In
      values:
        - p3
        - p4
        - p5
        - g4dn
        - g5
  taints:
    - key: "nvidia.com/gpu"
      effect: "NoSchedule"
  providerRef:
    name: default
  ttlSecondsAfterEmpty: 30
Beispiel für eine GCP Node Auto Provisioner-Konfiguration
resourceLimits:
  - resourceType: 'cpu'
    minimum: 0
    maximum: 1000
  - resourceType: 'memory'
    minimum: 0
    maximum: 10000
  - resourceType: 'nvidia-tesla-v100'
    minimum: 0
    maximum: 4
  - resourceType: 'nvidia-tesla-t4'
    minimum: 0
    maximum: 4
  - resourceType: 'nvidia-tesla-a100'
    minimum: 0
    maximum: 4
autoprovisioningLocations:
  - us-central1-c
management:
  autoRepair: true
  autoUpgrade: true
shieldedInstanceConfig:
  enableSecureBoot: true
  enableIntegrityMonitoring: true
diskSizeGb: 100
Beachten Sie, dass wir unsere Provisioner hier auch so konfigurieren können, dass sie Instanzen vom Typ spot nutzen, um 30–90 % Kosten bei zustandslosen Anwendungen zu sparen.
Damit eine virtuelle Maschine GPUs nutzen kann, müssen deren Treiber auf dem Host installiert sein. Glücklicherweise sind die Knoten sowohl bei AWS EKS als auch bei GCP GKE bereits mit bestimmten Versionen von Nvidia-Treibern vorkonfiguriert.
Da jede neuere CUDA-Version eine höhere Mindesttreiberversion erfordert, möchten Sie möglicherweise sogar die Treiberversion für alle Knoten steuern. Dies kann erreicht werden, indem Knoten mit benutzerdefinierten Images bereitgestellt werden, die den Treiber nicht enthalten, und Nvidia gpu-operator eine bestimmte Version installieren lässt. Dies ist jedoch möglicherweise nicht bei allen Cloud-Anbietern zulässig. Achten Sie daher auf die Treiberversionen auf Ihren Knoten, um Kompatibilitätsprobleme zu vermeiden.
Wir gehen weiter unten näher auf das gpu-operator ein.
Da in Kubernetes alles innerhalb von Pods (einer Gruppe von Containern) läuft, reicht die bloße Installation von Treibern auf dem Host nicht aus. Nvidia bietet eine eigenständige Komponente namens nvidia-container-toolkit an, die Hooks in containerd runC installiert, um die GPU-Treiber und -Geräte des Hosts den auf dem Knoten laufenden Containern zur Verfügung zu stellen. Eine detailliertere Erklärung finden Sie in diesem Artikel.

nvidia-container-toolkit kann so installiert werden, dass es als Daemonset auf den GPU-Knoten läuft.
GPUs auf dem Knoten zu haben reicht nicht aus; der Kubernetes-Scheduler muss wissen, welcher Knoten wie viele GPUs zur Verfügung hat. Dies kann mithilfe eines Device Plugin erfolgen. Ein Device Plugin ermöglicht es, benutzerdefinierte Hardware-Ressourcen gegenüber der Control Plane zu signalisieren, z. B. nvidia.com/gpu . Nvidia hat ein device plugin veröffentlicht, das allokierbare GPUs auf einem Knoten signalisiert. Dieses Plugin kann ebenfalls als Daemonset ausgeführt werden.
Sobald die oben genannten Komponenten konfiguriert sind, müssen wir der Pod-Spezifikation einige Dinge hinzufügen, um sie auf dem GPU-Knoten zu schedulen – hauptsächlich resources , affinity und tolerations
Z. B. können wir auf GCP GKE Folgendes tun:
spec:
  # We define how many gpus we want for the pod
  resources:
    limits:
      nvidia.com/gpu: 2
  # affinities help us place the pod on the GPU nodes
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
          - matchExpressions:
              # Specify which instance family we want
              - operator: In
                key: cloud.google.com/machine-family
                values:
                  - a2
              # Specify which gpu type we want
              - operator: In
                key: cloud.google.com/gke-accelerator
                values:
                  - nvidia-tesla-a100
              # Specify we want a spot VM
              - operator: In
                key: cloud.google.com/gke-spot
                values:
                  - "true"
tolerations:
  # Spot VMs have a taint, so we mention a toleration for it
  - key: cloud.google.com/gke-spot
    operator: Equal
    value: "true"
    effect: NoSchedule
  # We taint the GPU nodes, so we mention a toleration for it
  - key: nvidia.com/gpu
    operator: Exists
    effect: NoSchedule
resources.limits an, wie viele GPUs wir benötigenBeachten Sie, dass diese Konfigurationen je nachdem variieren, welche Bereitstellungsmethoden und Cloud-Anbieter Sie verwenden (z. B. Karpenter auf AWS vs. NAP auf GKE).
Überwachung von GPU-Metriken wie Auslastung, Speicherverbrauch, Leistungsaufnahme, Temperatur usw. ist wichtig, um einen reibungslosen Betrieb zu gewährleisten und weitere Optimierungen vorzunehmen.
Glücklicherweise bietet Nvidia eine Komponente namens dcgm-exporter, die als Daemonset auf GPU-Knoten ausgeführt werden und Metriken an einem Endpunkt bereitstellen kann. Diese Metriken können dann mit Prometheus gescrapt und verwendet werden. Hier ist eine Beispiel-Scrape-Konfiguration:
- job_name: gpu-metrics
  scrape_interval: 15s
  scrape_timeout: 10s
  metrics_path: /metrics
  scheme: http
  kubernetes_sd_configs:
  - role: endpoints
    namespaces:
      names:
      - <dcgm-exporter-namespace-here>
  relabel_configs:
  - source_labels: [__meta_kubernetes_pod_node_name]
    action: replace
    target_label: kubernetes_node
Beachten Sie jedoch, dass dcgm-exporter mit hostIPC: true und privilegiertem securityContext ausgeführt werden muss. Dies ist für EKS und GKE Standard in Ordnung. GKE Autopilot erlaubt einen solchen Zugriff jedoch nicht; stattdessen veröffentlicht GKE Metriken über die vorkonfigurierten nvidia-device-plugin-Daemonsets, die in GCP Cloud Monitoring gescrapt oder angezeigt werden können.
AWS EKSGCP GKE StandardGCP GKE AutopilotProvisionierungKarpenter / ManuellGCP Node Auto Provisioner / ManuellAuto ProvisioningTreiberVorkonfiguriert/Installieren über gpu-operatorVorkonfiguriertVorkonfiguriertContainer Toolkitnvidia-container-toolkitüber gpu-operatorVorkonfiguriertVorkonfiguriertDevice Pluginnvidia-device-pluginüber gpu-operatorVorkonfiguriertes DaemonsetVorkonfiguriertes DaemonsetMetrikennvidia-dcgm-exporterüber gpu-operatorEigenständiges nvidia-dcgm-exporter / Benutzerdefiniertes ScrapingBenutzerdefiniertes Scraping
Das oben erwähnte gpu-operator für AWS EKS besteht zum Großteil aus einer Reihe von eigenständigen Nvidia-Komponenten wie Treibern, container-toolkit, device-plugin und metrics exporter, die alle kombiniert und so konfiguriert sind, dass sie zusammen über ein einziges Helm-Chart verwendet werden können. Der gpu-operator führt einen Master-Pod auf der Control Plane aus, der GPU-Knoten im Cluster erkennen kann. Bei Erkennung eines GPU-Knotens wettet er ein Worker-Daemonset aus, das wiederum Pods scheduled, um optional Treiber, container toolkit, device-plugin, CUDA toolkit, metrics exporter und Validatoren zu installieren. Sie können hier mehr darüber lesen.
Im Allgemeinen ist es möglich, das CUDA-Toolkit auf dem Host-Rechner zu installieren und es dem Pod über Volume Mounting zur Verfügung zu stellen. Wir finden jedoch, dass dies recht anfällig sein kann, da es das Hantieren mit PATH- und LD_LIBRARY_PATH-Variablen erfordert. Darüber hinaus müssen alle Pods auf demselben Knoten dieselbe Version des CUDA-Toolkits verwenden, was sehr einschränkend sein kann. Daher ist es besser, das CUDA-Toolkit (oder Teile davon) in das Container-Image zu integrieren.

Sie können von bereits erstellten Images ausgehen, die von Nvidia oder Ihrem bevorzugten Deep-Learning-Framework bereitgestellt werden, oder es mit einer Zeile auf der TrueFoundry-Plattform hinzufügen

CUDA auf TrueFoundry
Um Unternehmen in die Lage zu versetzen, ihre Generative AI-Modelle schneller auf ihrer bestehenden Infrastruktur feinzutunen und auszuliefern, ermöglicht die TrueFoundry-Plattform Entwicklern, ihren Anwendungen mit minimalem Aufwand eine oder mehrere Nvidia-GPUs hinzuzufügen. Dabei werden Workflows unterstützt, die zusammen mit den besten Prompt-Engineering-Tools verwendet werden. Entwickler müssen lediglich angeben, wie viele Instanzen von einigen der besten GPUs für Machine Learning wie V100, P100, A100 40GB, A100 80GB (optimal für Training) oder T4, A10 (optimal für Inference) sie benötigen, und wir kümmern uns um den Rest. Lesen Sie mehr in unserer Dokumentation. Da GPU-gestützte AI-Workloads in die Produktion gehen, wird diese Art der Infrastruktursteuerung auch für umfassendere AI-Sicherheitsplattformen wichtig, bei denen Compute-Isolierung, Zugriffssteuerung und Workload-Observability zusammenarbeiten müssen.
GPUs sind eine fantastische Technologie, und das ist erst der Anfang für uns. Wir arbeiten aktiv an den folgenden Herausforderungen:
Wenn klingt das spannend für Sie? Nehmen Sie Kontakt mit uns auf, um gemeinsam die beste MLOps-Plattform zu bauen.
TrueFoundry ist ein ML-Deployment-PaaS auf Kubernetes, um Entwickler-Workflows zu beschleunigen und ihnen gleichzeitig volle Flexibilität beim Testen und Bereitstellen von Modellen zu bieten – unter Gewährleistung voller Sicherheit und Kontrolle für das Infra-Team. Über unsere Plattform ermöglichen wir es Machine-Learning-Teams, Modelle in 15 Minuten mit 100%iger Zuverlässigkeit, Skalierbarkeit und der Möglichkeit zum Rollback in Sekunden bereitzustellen und zu überwachen. Dies spart Kosten und bringt Modelle schneller in Produktion, was eine echte geschäftliche Wertschöpfung ermöglicht.
Diskutieren Sie hier mit uns über die Herausforderungen Ihrer ML-Pipeline
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















