November 2, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
TypeSafe AI ist ein KI-Labor, das von Diogo Almeida – ehemals bei OpenAI, wo er an der Forschung zum Befolgen von Anweisungen arbeitete, aus der ChatGPT hervorging – sowie Erik Gafni und Sasha Sheng gegründet wurde. Nach etwa zwei Jahren im Verborgenen veröffentlichte das Unternehmen am 15. September 2026 seinen Launch-Beitrag, flankiert von einer Seed-Finanzierungsrunde in Höhe von 40 Millionen US-Dollar unter der Leitung von DCVC. DataCamp und mehrere Fachmedien berichteten in den darauffolgenden Tagen darüber.
Die Argumentation im Launch-Beitrag ist eher eine Fragestellung als ein Benchmark: Modelle sind seit Jahren bei Chat-Anwendungen übermenschlich gut, wo bleibt also die Automatisierung? Die Antwort von TypeSafe lautet, dass der Engpass nie die reine Intelligenz war – sondern dass ein Modell, das in Prosa antwortet, eine unhandliche Komponente für die Softwareentwicklung ist. Das Firmenmanifest drückt es deutlicher aus: Die heutige KI wurde unter der Annahme trainiert, dass auf der anderen Seite ein Mensch sitzt.
Jev ist das erste Modell, das auf dieser Prämisse aufbaut. Der Name stammt von William Stanley Jevons, dessen Paradoxon besagt, dass sinkende Kosten den Verbrauch steigern; „System One“ ist eine Anspielung auf Daniel Kahnemans schnelles, intuitives System-1-Denken, im Gegensatz zum langsamen, bewussten System-2-Denken.
Unter den Arten von KI-Modellen , die man in der Produktion einsetzen würde, zeichnet sich dieses Modell dadurch aus, worauf es verzichtet. Ein Chat-Modell liefert eine Zeichenkette zurück, und eine Zeichenkette kann alles sein – eine Antwort, eine Verweigerung, ein Absatz voller Überlegungen oder etwas Fehlerhaftes, an dem Ihr Parser scheitert. Jev liefert überhaupt keine Zeichenketten zurück.
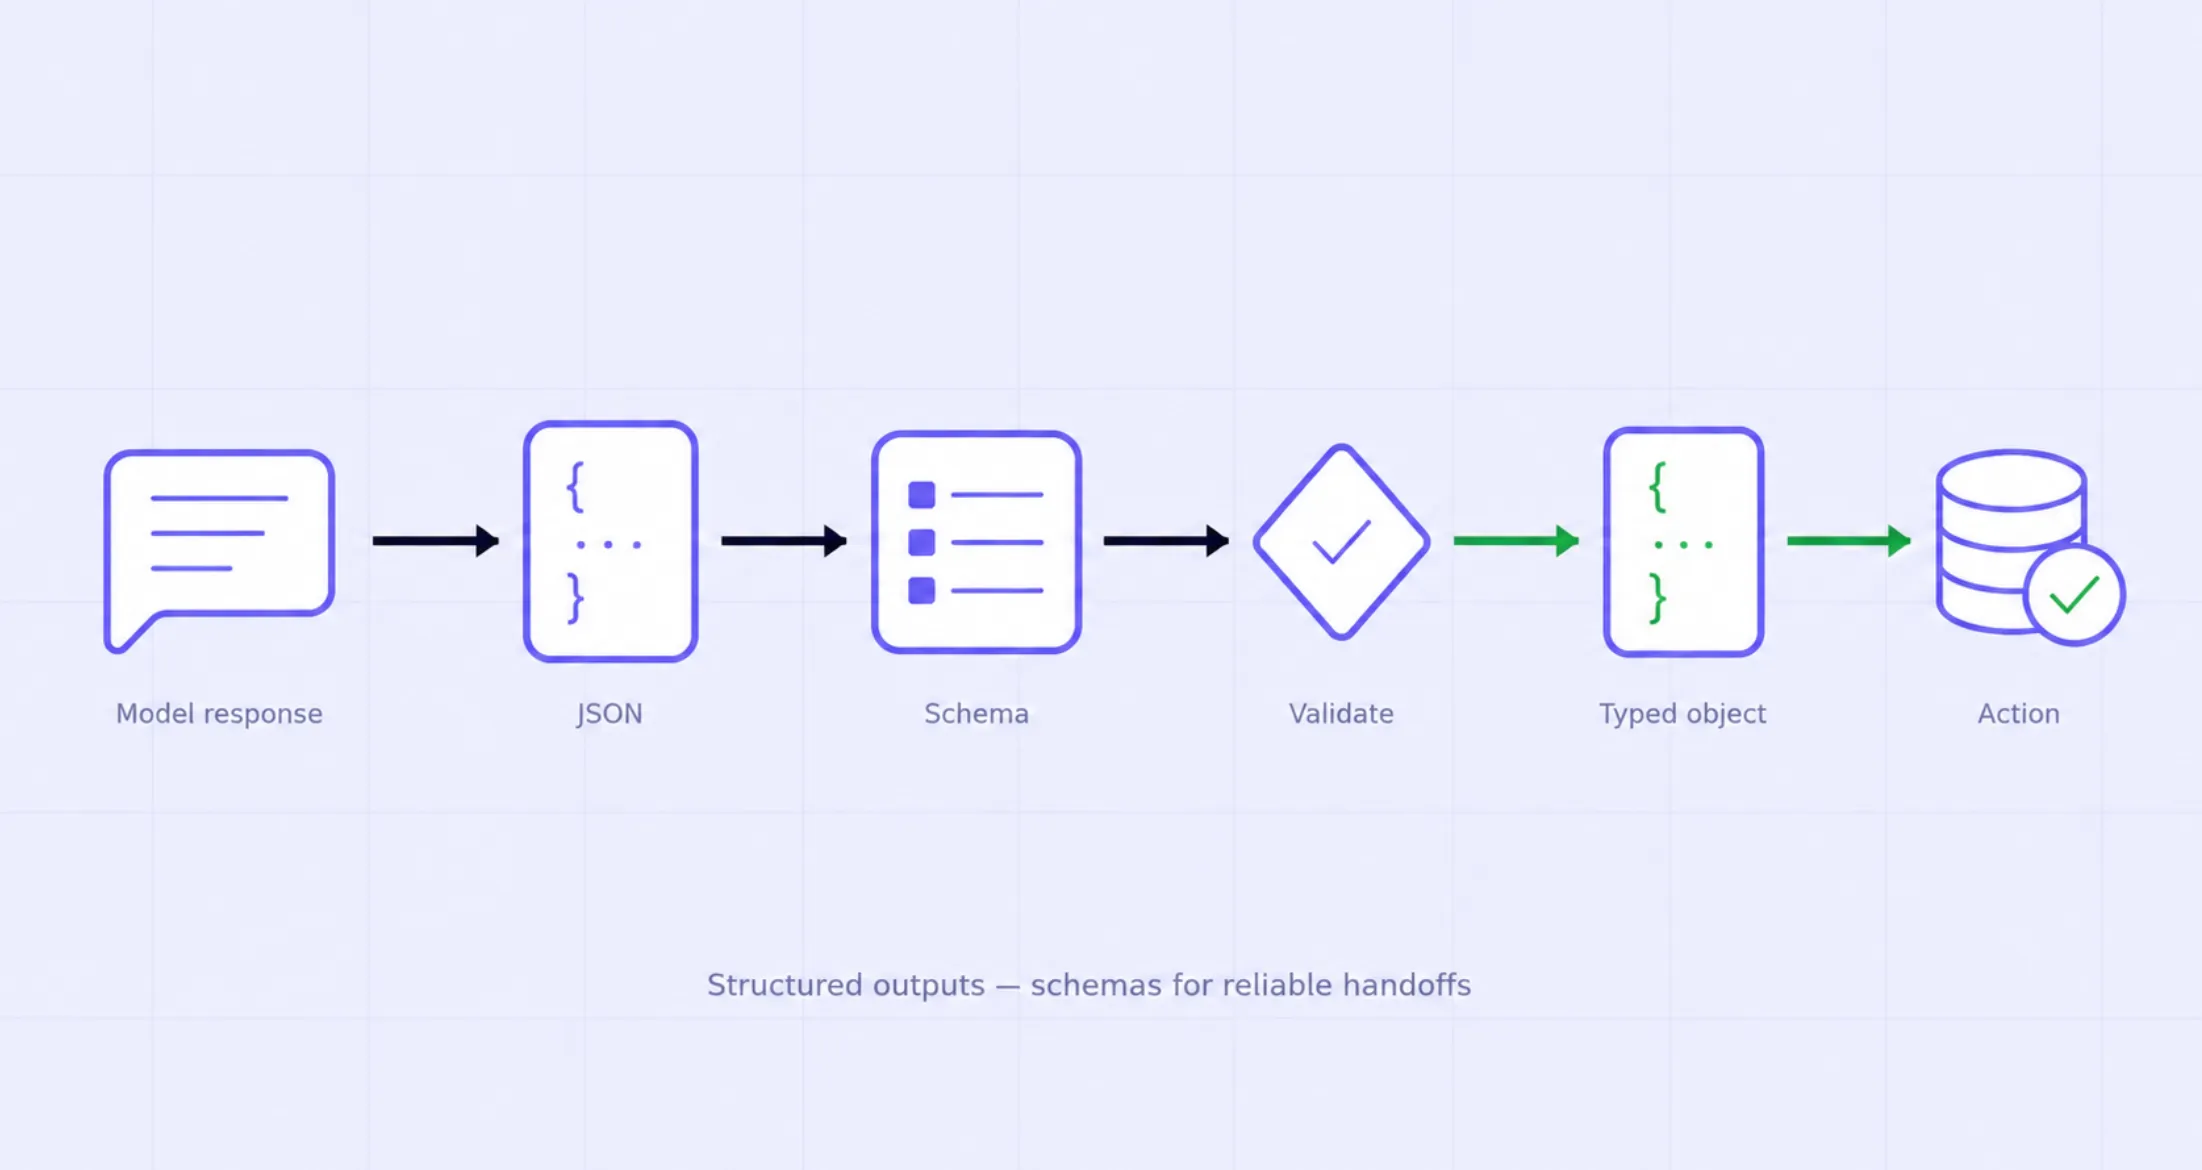
Stattdessen definieren Sie vorab die Struktur der Antwort: welche Felder Sie wünschen und welche Werte für jedes Feld zulässig sind. Das Modell gibt diese Felder ausgefüllt zurück, jeweils mit einer zugehörigen Wahrscheinlichkeit. TypeSafe beschreibt das Ergebnis als einen Funktionsaufruf mit Spitzenintelligenz – unstrukturierter Status rein, typisierte probabilistische Entscheidungen raus. In der Praxis verhält es sich weniger wie ein Chatbot und mehr wie eine KI-Entscheidungsmaschine , die Sie aus einer Codezeile heraus aufrufen können.
Aus diesem Design ergeben sich drei Eigenschaften:
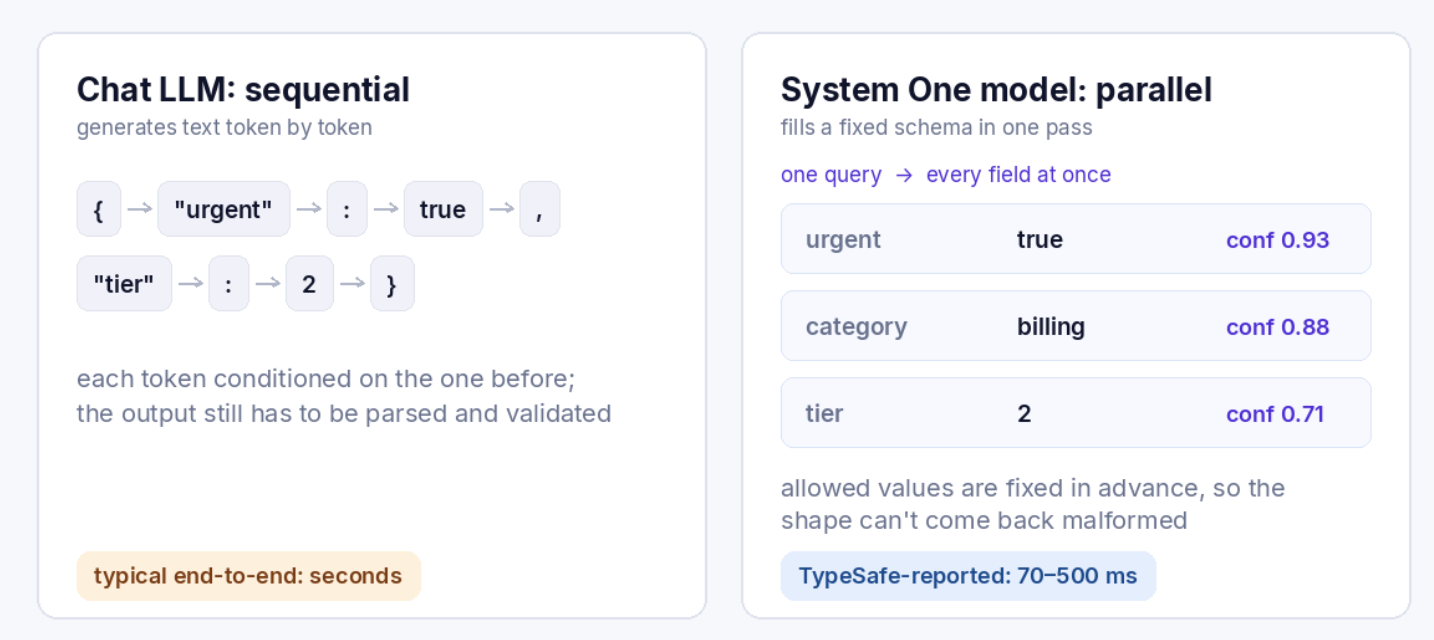
Ein Chat-LLM erstellt seine Antwort Token für Token; ein System-One-Modell füllt jedes Feld eines festen Schemas in einem Durchgang aus, jeweils mit einem Konfidenzwert.
Diese dritte Eigenschaft wird am ehesten unterschätzt. Ein Modell, das zu 95 % richtig liegt, aber nicht sagen kann, welche Aufrufe in die restlichen 5 % fallen, lässt sich nicht automatisieren. Eines, das ehrliche Unsicherheit meldet, hingegen schon – man kann basierend auf dem Konfidenzwert verzweigen und Fälle mit geringer Konfidenz an einen Menschen oder ein größeres Modell weiterleiten.
Eine praktische Grenze, die man kennen sollte: Jev unterstützt eine Kardinalität von bis zu 255 Optionen pro Auswahl. Darüber hinaus verwendet TypeSafe einen zweistufigen Ansatz – Kandidaten werden unabhängig bewertet und anschließend eine explizite Auswahl getroffen –, was, wie das Unternehmen einräumt, langsamer ist.
Hier lohnt es sich, genauer hinzusehen, da die Zahlen zum Start ungewöhnlich hoch sind und die Belege dafür ungewöhnlich in sich geschlossen wirken. Positiv hervorzuheben ist, dass TypeSafe in seinem Beitrag unter jedem Ergebnis eigene „Nuancen“-Anmerkungen aufführt, aus denen der Großteil der folgenden Informationen stammt.
Aktuell unabhängig überprüfbar:
Selbst berichtet und noch nicht unabhängig reproduziert:
Noch unbekannt: Leistung bei öffentlichen Benchmarks, Verhalten bei Aufgaben, die nicht klar entscheidungsbasiert sind, Genauigkeit bei domänenspezifischen Arbeiten in der Praxis sowie jegliche Informationen zur Produktionszuverlässigkeit im großen Maßstab. Der Vorabzugang wurde erst diese Woche eröffnet.
Es gibt zudem ein sprachliches Detail, bei dem man präzise sein sollte, da es in Zusammenfassungen oft vereinfacht wird. TypeSafe sagt, Jev könne nicht halluzinieren, und im engeren Sinne ist das korrekt: Ein Modell, das niemals freien Text ausgibt, kann keine Zitate oder Tool-Namen erfinden. Aber LLM-Halluzinationen und Korrektheit sind nicht dasselbe Problem. Ein Modell, das auf drei zulässige Kategorien beschränkt ist, kann immer noch überzeugt die falsche wählen – eliminiert wurde die fehlerhafte Form der Antwort, nicht das fehlerhafte Urteil. Kalibrierung ist TypeSafes Antwort darauf, und genau diese Kalibrierung ist der Punkt, der unabhängig geprüft werden muss. Teams, die bereits strukturierte Ausgaben mit JSON-Schema nutzen, werden den Unterschied erkennen: Die Einschränkung der Form einer Antwort hat noch nie die inhaltliche Richtigkeit garantiert.
Lassen wir den konkreten Launch einmal beiseite, denn die Struktur dahinter ist interessanter als die Zahlen. Was TypeSafe argumentiert – und worauf immer mehr Teams unabhängig voneinander kommen – ist, dass ein Allzweckmodell, das jede Anfrage beantwortet, ein Prototyping-Muster ist, kein Produktionsmuster.
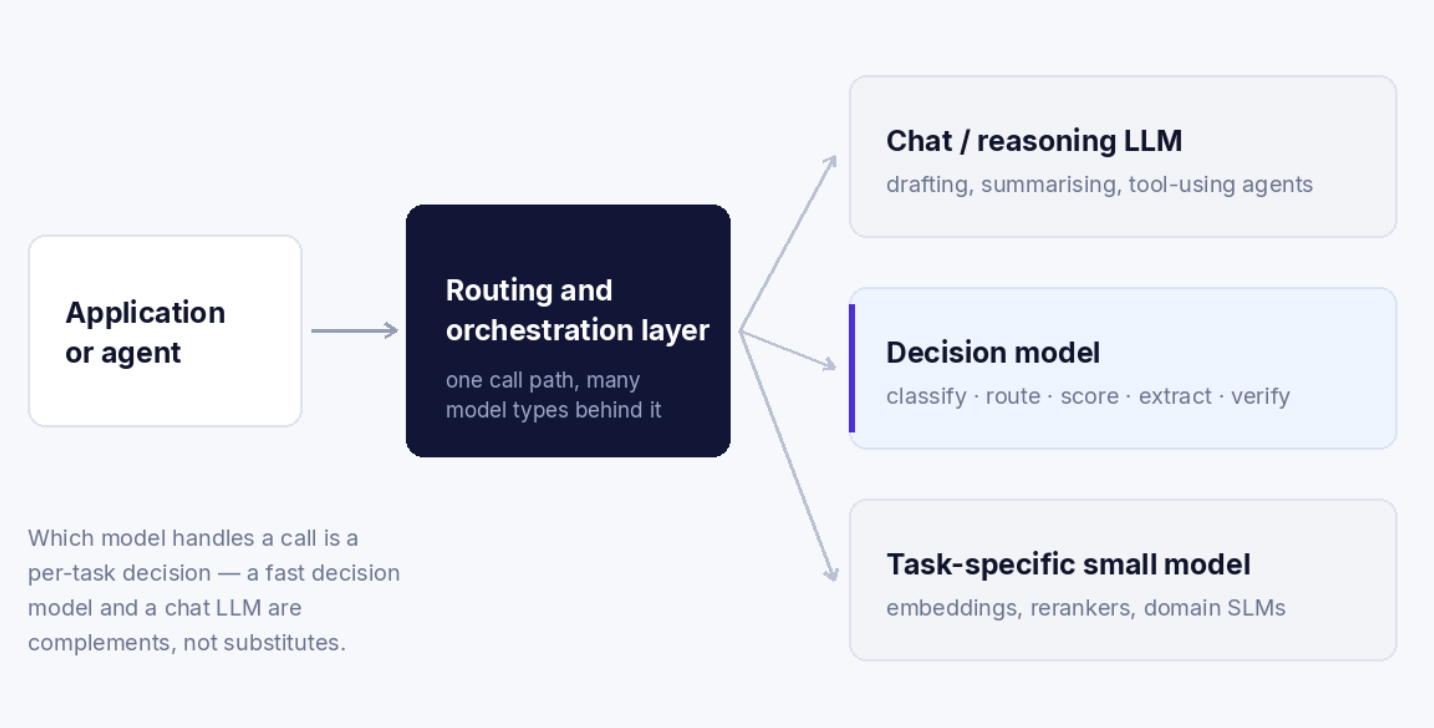
Ein Produktions-Stack enthält letztlich mehrere Modelltypen gleichzeitig, wobei die Routing-Ebene entscheidet, welches Modell eine bestimmte Anfrage bedient.
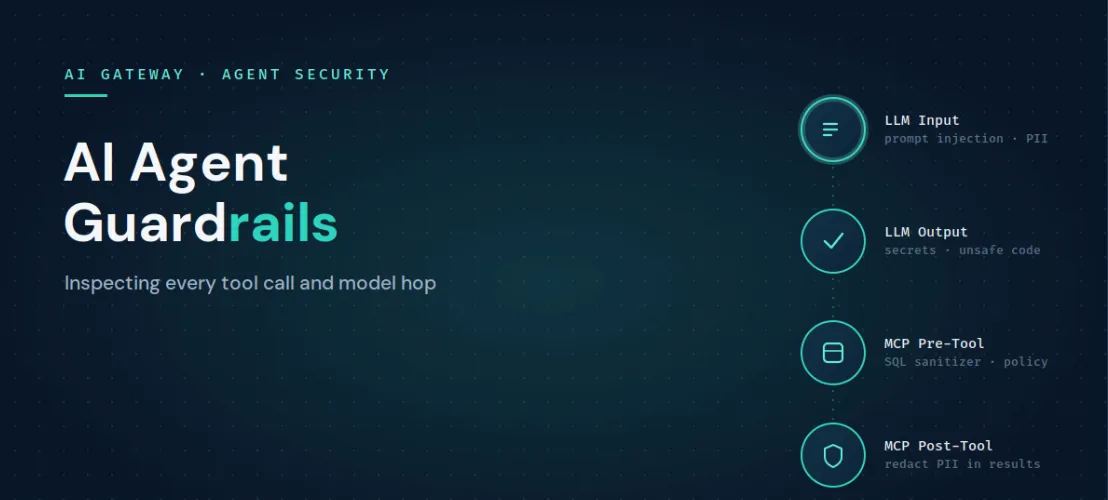
Die Entscheidungen innerhalb eines laufenden Systems sind meist klein und repetitiv: Ist dieses Ticket dringend, in welche Warteschlange gehört es, verstößt diese Antwort gegen Richtlinien, welches dieser Felder ist die Rechnungsnummer? Jede dieser Anfragen an ein Frontier-Chatmodell zu senden funktioniert zwar, und Teams tun das auch, aber es bedeutet, Generierungspreise und Generierungslatenz für etwas zu zahlen, das eher einem Nachschlagevorgang entspricht. Das ist dasselbe Kalkül, das hinter der Entscheidung steckt, wann man ein kleines Modell spezialisiert, anstatt ein großes Modell zu nutzen, und deshalb ist Arbeit im Bereich Verifizierung – Scoring, Beurteilung, Erkennung von Jailbreaks, Agenten-Guardrails – der Anwendungsfall, mit dem TypeSafe vorangeht. Guardrails müssen bei jeder Anfrage laufen, was Kosten und Latenz zur entscheidenden Einschränkung macht, nicht die reine Leistungsfähigkeit.
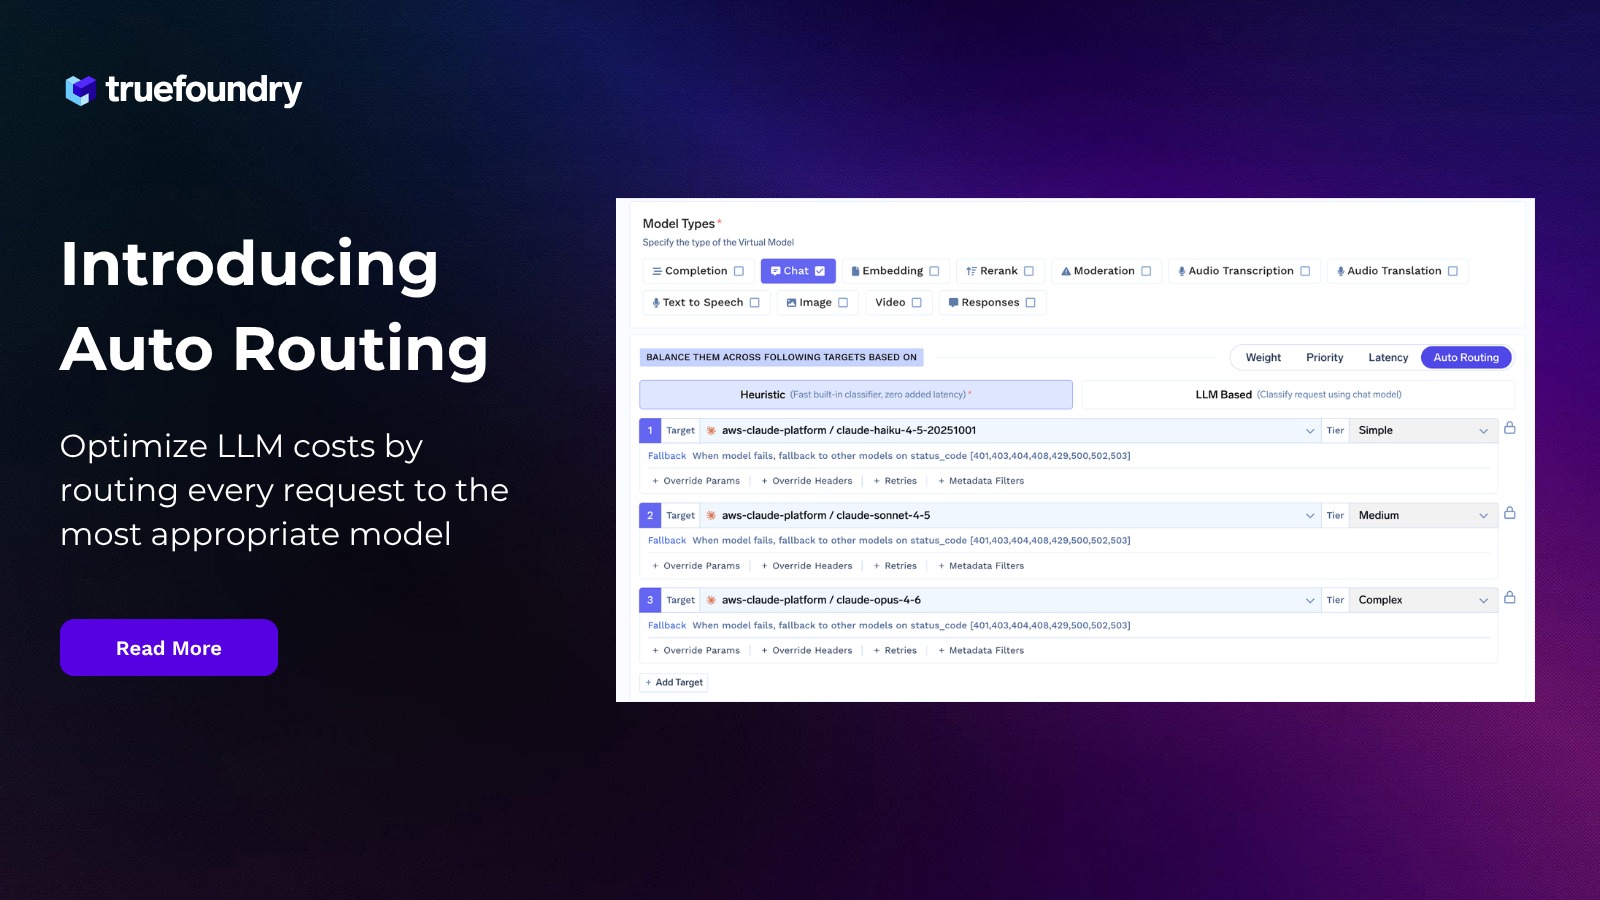
Die Konsequenz für jeden, der KI in der Produktion einsetzt, ist ein KI-Orchestrierungsproblem und kein Problem der Modellauswahl. Wenn die richtige Antwort für manche Anfragen ein Chat-LLM ist, für andere ein schnelles Entscheidungsmodell und für eine dritte Gruppe ein feinabgestimmtes kleines Modell, dann muss die Ebene davor stabil sein – ein einheitlicher Aufrufpfad, konsistente Authentifizierung und Protokollierung sowie die Freiheit, das Modell für eine bestimmte Aufgabe zu ändern, ohne die Anwendung neu schreiben zu müssen. Das ist die Prämisse hinter Auto-Routing auf dem TrueFoundry AI Gateway, und deshalb ist ein Launch wie dieser als architektonisches Signal interessanter als als Benchmark.
Jev ist derzeit eine geschlossene gehostete API im Early Access, es gibt also nichts zu implementieren und keine Integration zu bewerten. Das mag sich ändern. Das Muster, das es repräsentiert, wird sich mit ziemlicher Sicherheit nicht ändern.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet