October 30, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




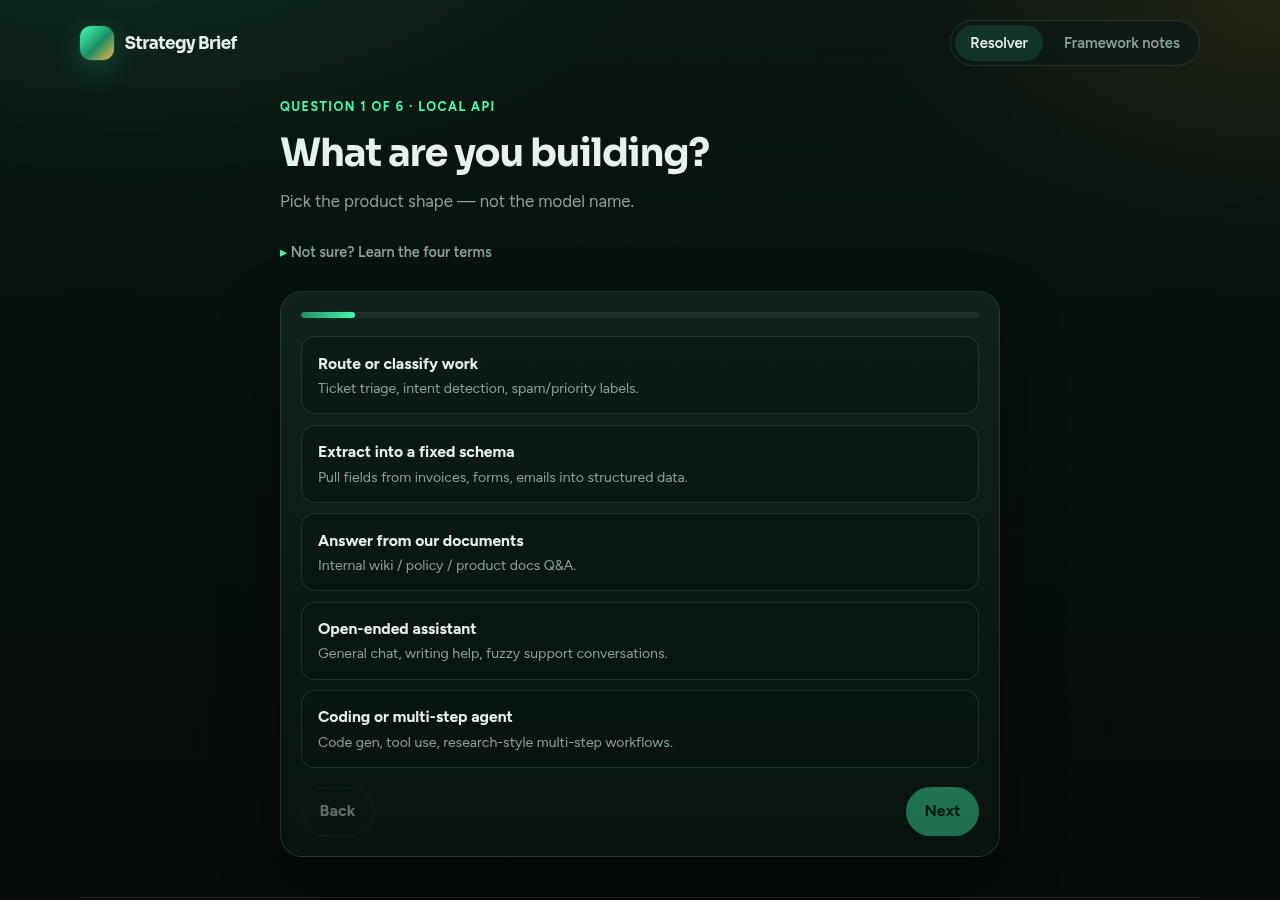
Wenn die Aufgabe eng umrissen und repetitiv ist, Sie über rund 1.000 oder mehr saubere, gelabelte Beispiele verfügen, es einen benannten Verantwortlichen für Evaluierungen und erneute Deployments gibt, das Volumen so hoch ist, dass Stückkosten oder Latenz schmerzen, und eine Prompt-Baseline existiert, die Sie auf einem zurückgehaltenen Datensatz übertreffen können. Fehlt einer dieser Punkte, bleiben Sie bei Prompts (und ergänzen Sie RAG, wenn es um Wissen geht).
Fine-Tuning verändert die Modellgewichte für ein spezialisiertes Verhalten. RAG ruft zum Zeitpunkt der Frage vertrauenswürdige Dokumente ab, damit Antworten fundiert und aktuell bleiben. Privates Hosting beschreibt, wo die Inferenz läuft. Sie können sie in beliebiger Reihenfolge kombinieren; die Entscheidung für VPC-Hosting bedeutet nicht, dass Sie Fine-Tuning betreiben müssen.
Meist aus einem dieser Gründe: keine Evaluierung auf zurückgehaltenen Daten, Labels, die aus rohen Tickets bestanden, eine offene Aufgabe, die nicht hätte spezialisiert werden sollen, oder kein Verantwortlicher, der das spezialisierte Modell vor Drift bewahrt. Specialize ohne Anzeigetafel ist Raten.
Leiten Sie den Traffic über ein AI Gateway. Legen Sie Standardmodelle fest. Beschränken Sie den Zugriff auf Premium-Modelle. Machen Sie die Ausgaben pro Team sichtbar. Das AI Gateway von TrueFoundry gibt Engineering-Leads Transparenz über Nutzung und Kosten für mehr als 1.000 LLMs hinter einer einzigen OpenAI-kompatiblen API, damit sich Modellentscheidungen nicht zu Überraschungen bei der Abrechnung aufsummieren, während Sie das Produkt noch validieren.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet