



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Kurz gefasst TrueFoundry und Seldon verschmelzen zu einer gemeinsamen Plattform. Seldons Echtzeit-ML-Serving ergänzt TrueFoundrys AI Deploy und AI Gateway und bietet Unternehmen eine zentrale Control Plane für klassisches ML sowie für Agenten. Ihre Produktionsmodelle laufen weiterhin auf dem Kubernetes-Cluster, das Sie bereits nutzen, und Sie erhalten einen klaren Pfad für den Einsatz von LLMs und KI-Agenten.
Die meisten Enterprise-AI-Teams arbeiten heute zweigleisig. Sie betreiben klassische ML-Modelle in der Produktion für Aufgaben wie Betrugserkennung, Abwanderungsprognosen und Empfehlungssysteme. Gleichzeitig entwickeln sie agentenbasierte Anwendungen, die eigenständig Schlussfolgerungen ziehen, Tools aufrufen und agieren. Bisher entwickelten sich diese beiden Welten in unterschiedlichem Tempo. Das hat sich geändert. Beide Bereiche werden gleichzeitig geschäftskritisch, und der Betrieb über zwei separate Stacks mit zwei Anbietern und zwei Governance-Modellen wird schnell teuer und fehleranfällig.
Genau diese Lücke schließen TrueFoundry und Seldon gemeinsam. Seldon hat über ein Jahrzehnt damit verbracht, Echtzeit-ML-Serving für einige der anspruchsvollsten Unternehmen weltweit zu perfektionieren. TrueFoundry hat die Control Plane für moderne KI entwickelt, inklusive Deployment, AI Gateway sowie Governance für LLMs und Agenten. Wir führen beides zu einer Plattform zusammen, damit Teams ihre prädiktiven Modelle und Agenten zentral auf der Kubernetes-Basis betreiben können, der sie bereits vertrauen.
Diese Fusion funktioniert, weil keine Seite ihr Design aufgeben muss. Seldon und TrueFoundry haben vor Jahren dieselbe architektonische Entscheidung getroffen. Beide laufen als Control Plane auf dem Kubernetes-Cluster des Kunden – innerhalb der eigenen VPC, On-Premise oder in Air-Gapped-Umgebungen. Beide sind Cloud-agnostisch. Beide setzen auf dieselben Standardkomponenten für Traffic, Autoscaling und Telemetrie und beide weisen einem Team eigene Namespaces zu, anstatt Cluster-weite Admin-Rechte zu erfordern.
Seldon hat dieses gemeinsame Fundament genutzt, um sich auf eine Ebene zu spezialisieren: das skalierbare Echtzeit-Serving von klassischem ML. Wir haben dasselbe Fundament genutzt, um das Spektrum zu erweitern – vom Deployment bis hin zu einem Gateway, das Modelle, Agenten und Tools steuert. Die beiden Plattformen waren also nie auf Kollisionskurs. Sie haben benachbarte Teile desselben Problems auf die gleiche Weise gelöst. Die Zusammenführung verbindet nun zwei Ebenen, die ohnehin dieselbe Sprache sprechen.
Seldon ist seit über einem Jahrzehnt das Rückgrat für Echtzeit-ML-Inferenz bei Banken, Telekommunikationsanbietern, Versicherungen, Einzelhändlern und im Gesundheitswesen. Dieser Ruf basiert auf der tiefen Expertise in den komplexesten Bereichen des produktiven ML-Servings:
Zusammen ergibt das eine ausgereifte Serving- und Monitoring-Ebene mit tiefen Wurzeln in regulierten Umgebungen mit geringer Latenz – genau dort, wo eine fehlerhafte Vorhersage innerhalb von Minuten zu einem Kundenproblem wird.
TrueFoundry hat die Steuerungsebene rund um das Modell aufgebaut – die Schichten, die aus einem bereitgestellten Modell eine kontrollierte, kostenbewusste und agentenfähige Anwendung machen:
Unsere Kunden betreiben bereits geschäftskritische KI über das Gateway mit einem Volumen von mehr als einer Billion Token pro Tag.
Hier kommt der entscheidende Punkt: Wenn die Serving-Ebene von Seldon und die Deploy- sowie Gateway-Ebenen von TrueFoundry zusammenkommen, erhält ein Unternehmen eine einzige Steuerungsebene, die beide Hälften seiner KI abdeckt.
Deploy führt die Workloads aus. Das Gateway steuert und leitet sie. Ihre klassischen ML-Modelle und Ihre Agenten laufen auf demselben Kubernetes, unter einheitlichen Zugriffskontrollen, einem gemeinsamen Observability-Stack und einer zentralen Kostenübersicht. Eine einzelne Anfrage kann ein Betrugserkennungsmodell, ein LLM und einen Agenten, der ein Tool aufruft, durchlaufen – jeder Schritt wird dabei einheitlich protokolliert und gesteuert.
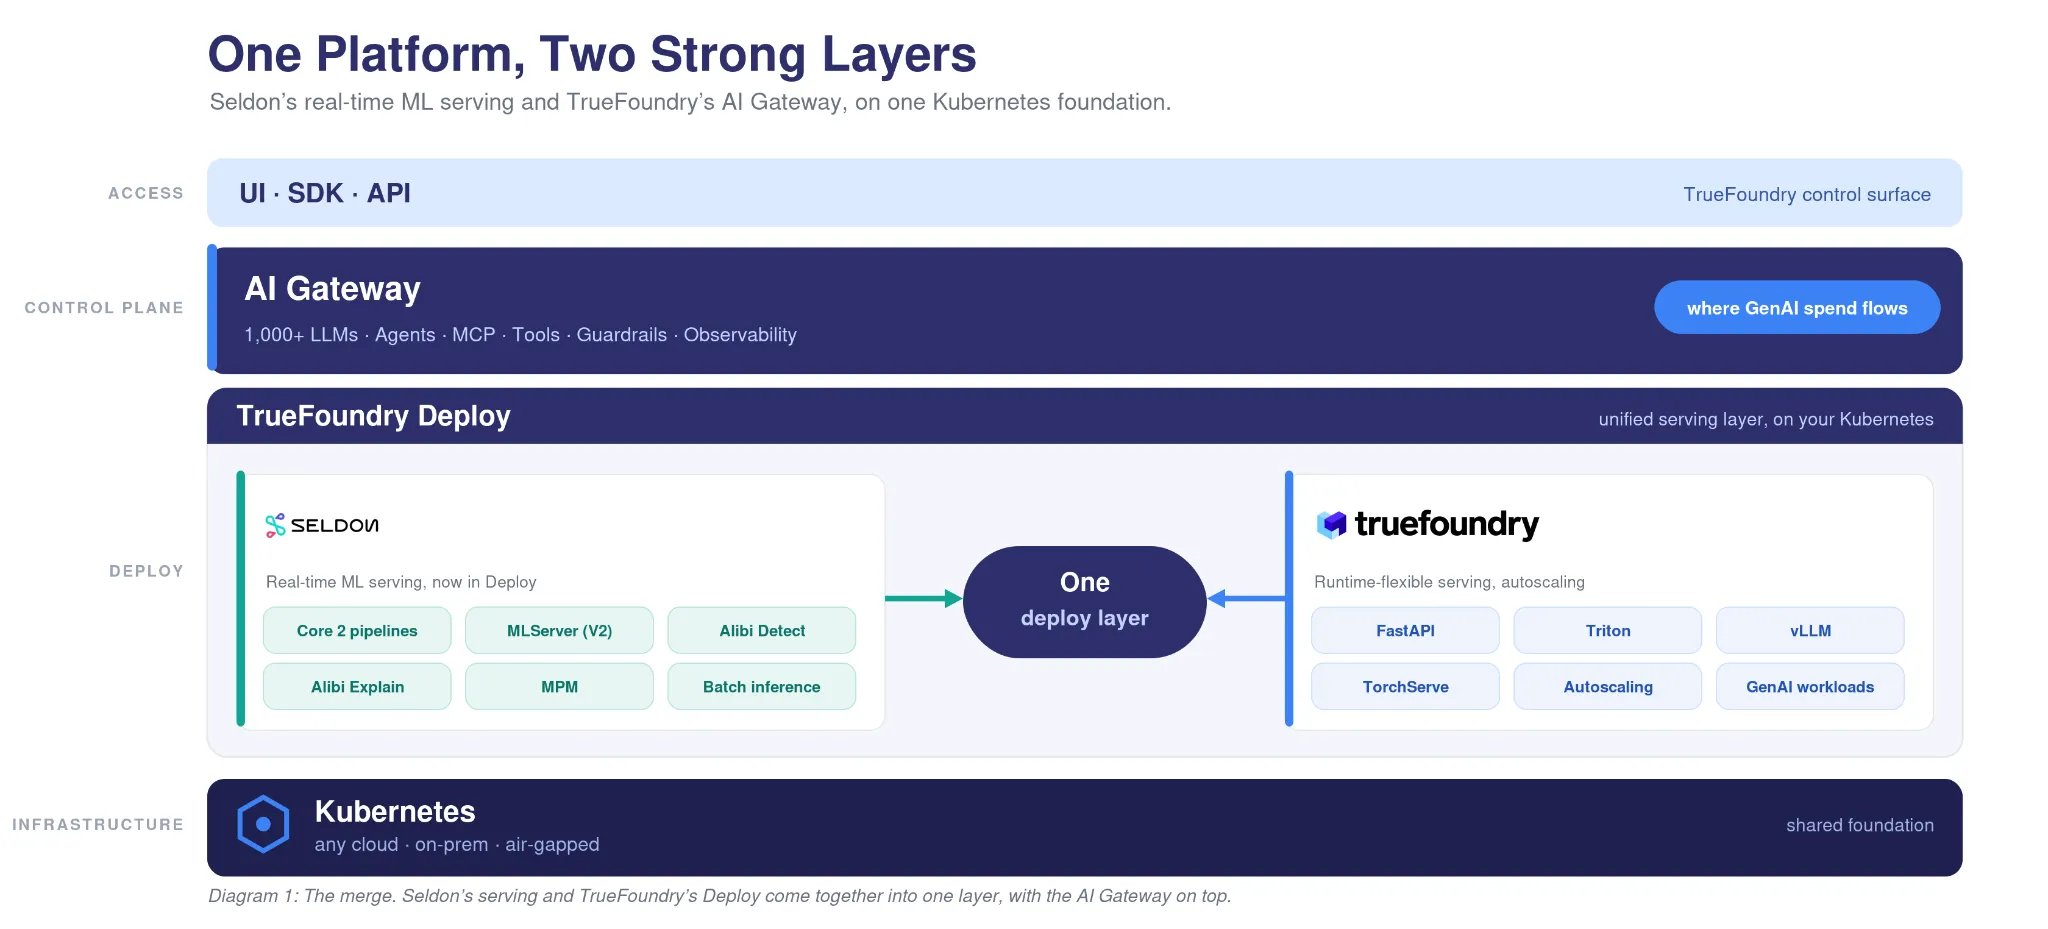
Es lohnt sich, einen Blick darauf zu werfen, wohin das Geld fließt. Prädiktives ML ist weitgehend etabliert und läuft stabil. Die neuen Investitionen in Unternehmens-KI fließen in LLMs und Agenten, und genau diese Ausgaben laufen über das Gateway. Jeder Modellaufruf, jeder Agentenschritt und jeder Tool-Aufruf passiert es – deshalb verarbeiten unsere Kunden bereits mehr als eine Billion Token pro Tag darüber.
Die kombinierte Plattform leistet also zwei Dinge gleichzeitig: Sie hält das bereits entwickelte ML ohne Unterbrechung am Laufen und bringt Sie direkt dorthin, wo die nächste Welle der KI-Investitionen stattfindet, ohne dass Sie dafür eine separate Plattform aufbauen müssen.
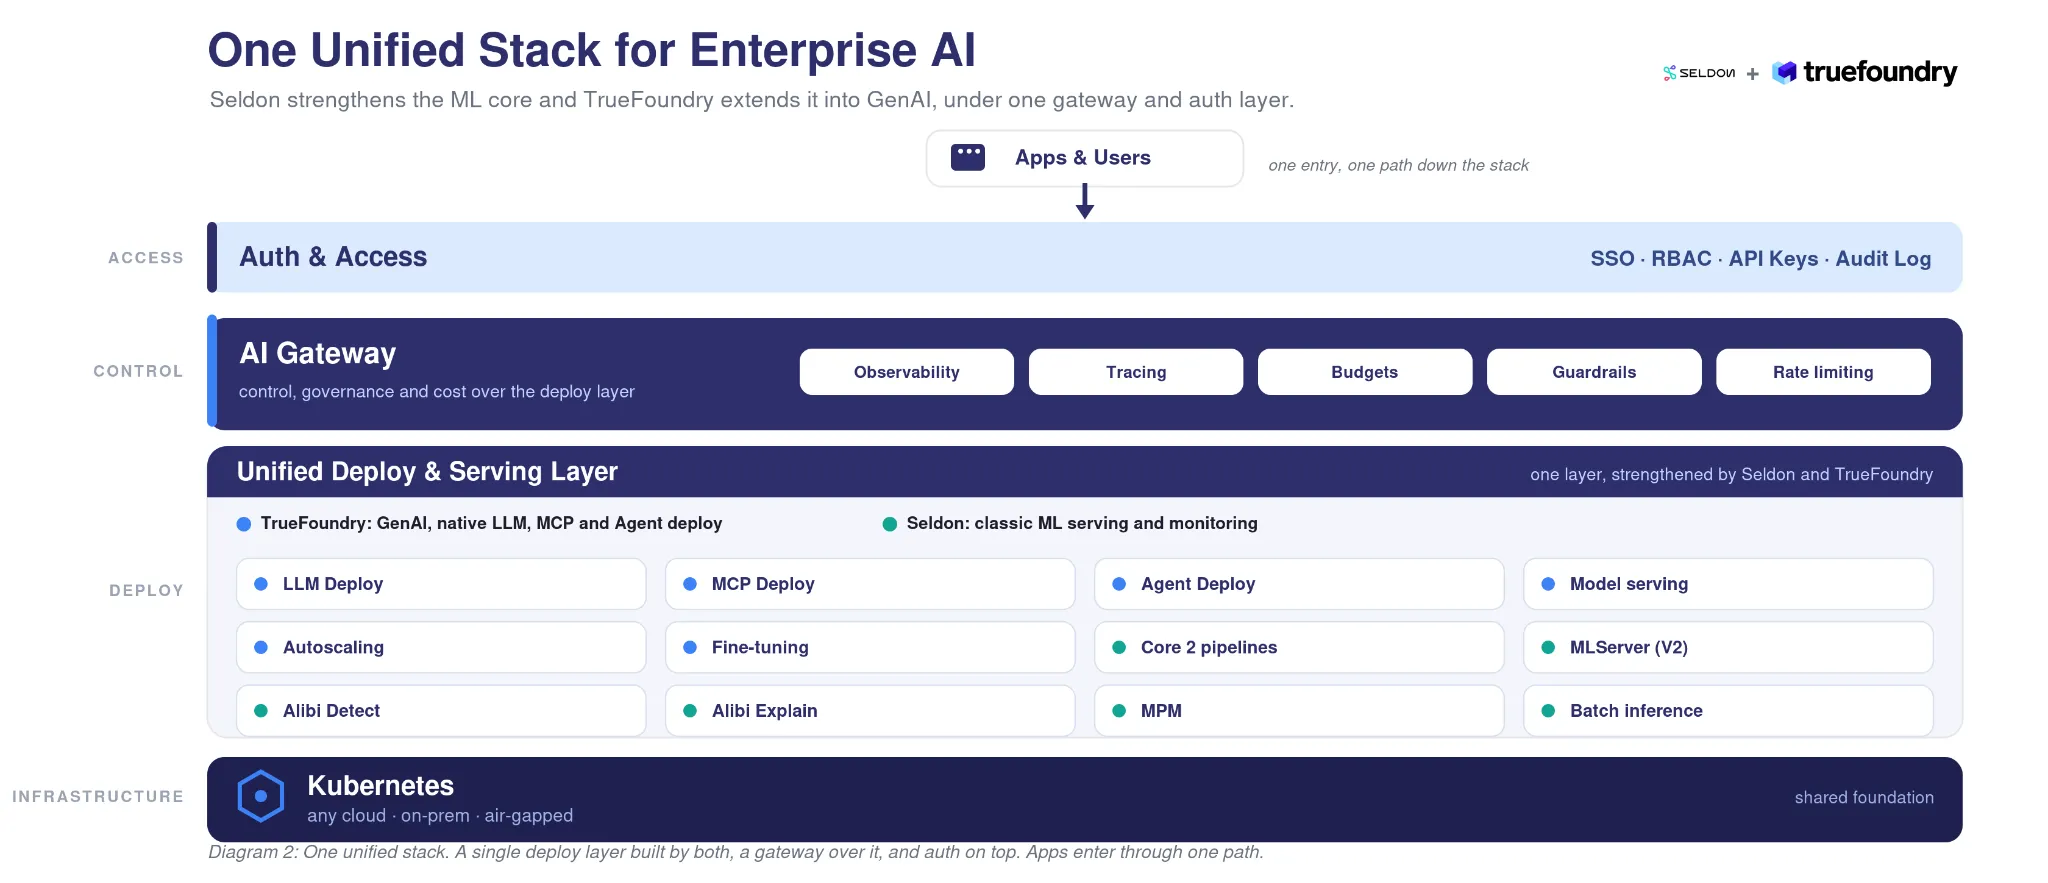
Wenn Sie Seldon bereits nutzen, läuft Ihr Echtzeit-ML weiterhin auf dem Kubernetes, das Sie bereits betreiben. Modelle, die über das V2-Protokoll bereitgestellt werden, bleiben portabel, und Core 2-Pipelines werden auf die Primitiven von Deploy abgebildet, anstatt sie neu schreiben zu müssen. Darüber hinaus erhalten Sie das AI Gateway und die Agenten-Ebene, ohne etwas Neues aufbauen zu müssen.
Wenn Sie TrueFoundry bereits nutzen, ändert sich nichts an Ihrem Stack, und Deploy wird noch leistungsfähiger. Es übernimmt die Bereitstellungs- und Monitoring-Historie von Seldon, einschließlich Drift- und Ausreißererkennung, Modellerklärungen und Leistungsüberwachung, die direkt in die Plattform einfließen, die Sie bereits verwenden.
Für beide bedeutet dies: ein Stack statt zwei. Ein zentraler Ort für die Bereitstellung von Modellen, das Routing von Aufrufen, die Überwachung von Drift, die Steuerung von Agenten und die Kostenabrechnung – für klassisches ML und GenAI, auf der Infrastruktur, die Sie bereits betreiben.
Unternehmen sollten nicht gezwungen sein, eine Plattform für ihre Modelle und eine weitere für ihre Agenten zu betreiben. Mit der Zusammenführung von TrueFoundry und Seldon ist das nicht mehr nötig. Seldons Echtzeit-ML-Serving und das AI Gateway von TrueFoundry bilden nun eine gemeinsame Steuerungsebene für Enterprise-KI auf dem Kubernetes, das Sie bereits nutzen. Ihr produktives ML läuft nahtlos weiter, und der Weg zu Agenten und LLMs ist direkt darauf aufgebaut.
Erfahren Sie, wie das AI Gateway von TrueFoundry ML und Agenten vereint → Das AI Gateway entdecken
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















