



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Amazon Bedrock ist ein praktikabler Ausgangspunkt für Teams, die fest an das AWS-Ökosystem gebunden sind, da es eine verwaltete API-Schicht für Foundation Models (FMs) bietet, ohne dass eine sofortige Infrastrukturverwaltung erforderlich ist. Wenn KI-Workloads jedoch im Jahr 2026 in die Produktion übergehen, stoßen Engineering-Teams unweigerlich an die „Plattform-Grenze“. Diese Barriere äußert sich in drei primären Reibungspunkten:
Für Architekten, die langfristig planen, verlagert sich der Fokus von einem einfachen API-Zugriff hin zur Entwicklung einer „Migrations- und Multi-Cloud-Strategie“. Dieser Leitfaden bewertet die technischen Kompromisse, die Stückkosten und die betrieblichen Realitäten der wichtigsten Alternativen zu Bedrock. Während Managed Services zwar bequem sind, entwickeln sich Plattformen wie TrueFoundry zur bevorzugten Steuerungsebene für Unternehmen, die die Benutzerfreundlichkeit von Bedrock mit der wirtschaftlichen und operativen Kontrolle einer Bereitstellung in der eigenen Cloud-Infrastruktur kombinieren möchten.
In diesem Abschnitt analysieren wir den technischen Nutzen und die architektonische Eignung der folgenden Wettbewerber:
TrueFoundry fungiert als plattformunabhängige Steuerungsebene und nicht als proprietäres Ökosystem. Im Gegensatz zu Bedrock, das eine verwaltete API ist, bei der die Inferenz auf gemeinsam genutzter Infrastruktur stattfindet, orchestriert TrueFoundry die Rechen- und Inferenzschichten direkt innerhalb Ihrer eigenen VPC oder Kubernetes-Cluster (EKS, GKE, AKS oder Bare Metal).
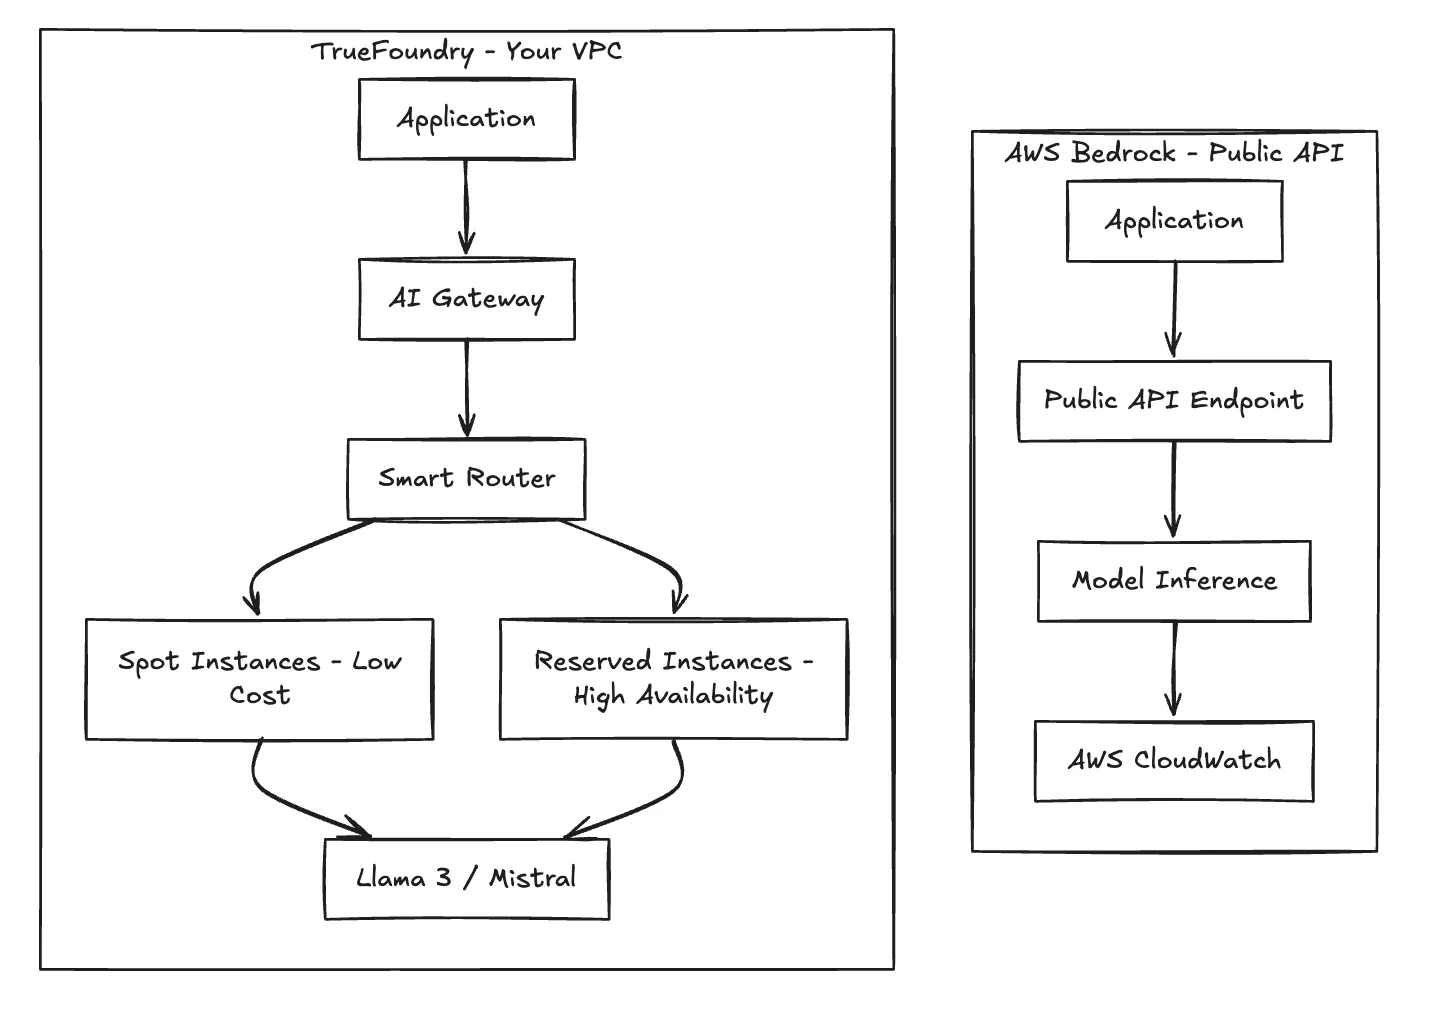
Diese Architektur entkoppelt die Entwicklererfahrung von der zugrunde liegenden Infrastruktur.
TrueFoundry erhebt keinen Aufschlag auf Inferenz-Token, wenn Sie Ihre eigenen Open-Source-Modelle hosten. Sie zahlen die Kosten für die zugrunde liegende Infrastruktur direkt an Ihren Cloud-Anbieter. Bei Workloads mit hohem Volumen sind diese pauschalen Rechenkosten deutlich günstiger als die lineare Skalierung bei tokenbasierter Abrechnung.
Nutzer auf G2 bewerten TrueFoundry durchweg mit 4,8/5, was die Fähigkeit der Plattform unterstreicht, die Komplexität von Kubernetes für Backend-Entwickler zu abstrahieren. Eine Bewertung lautet: "Es hat unser Backend-Team über Nacht in MLOps-Ingenieure verwandelt, ohne die steile Lernkurve von Kubeflow."
Vertex AI ist tief in das Google Cloud-Ökosystem integriert. Es bietet nativen Zugriff auf die Gemini-Familie und unterstützt AutoML. Besonders hervorzuheben ist die Operationalisierung von Modellen durch integrierte Feature-Stores und eine Vektorsuche, die direkt mit BigQuery verknüpft ist.
Die Preisgestaltung erfolgt pro Vorgang. Gemini 1.5 Pro wird beispielsweise pro 1.000 Zeichen/Bilder abgerechnet. Wichtig ist, dass für Vorhersagen mit individuell trainierten Modellen Kosten pro Knoten-Stunde anfallen. Details zu den spezifischen Maschinentypen (z. B. n1-standard-4 vs. TPU v5e) finden Sie in der Preisübersicht von Vertex AI.
Vertex ist optimal für Unternehmen, die BigQuery für RAG-Pipelines (Retrieval-Augmented Generation) nutzen, da der Datenzugriff innerhalb des GCP-Backbones eine sehr geringe Latenz aufweist.
Der Azure OpenAI Service bietet unternehmensweiten Zugriff auf GPT-4o und DALL-E 3. Er ergänzt die Standard-OpenAI-APIs um Compliance-Ebenen (SOC2, HIPAA) und private Netzwerkanbindung via Azure Private Link.
Azure nutzt ein "Pay-as-you-go"-Modell sowie "Provisioned Throughput Units" (PTUs). PTUs garantieren eine feste Latenz, erfordern jedoch erhebliche Vorabinvestitionen. Laut der Azure OpenAI-Preisliste können Standard-GPT-4-Modelle pro Token deutlich teurer sein als Open-Source-Alternativen, die auf selbst verwalteten VMs gehostet werden.
Die Standardwahl für Unternehmen mit bestehenden Microsoft Enterprise Agreements, die eine strikte rollenbasierte Zugriffskontrolle (RBAC) über Microsoft Entra ID erfordern.
OCI Generative AI basiert auf einer "Supercluster"-Architektur mit RDMA-Netzwerk, die für Hochleistungstraining ausgelegt ist. Zudem besteht eine Partnerschaft mit Cohere für eingebettete Vektorsuche.
OCI verfolgt eine aggressive Preisstrategie bei der Rechenleistung. Laut der Oracle Cloud-Preisliste unterbieten ihre GPU-Instanzen oft die von AWS und Azure, was sie für reine Trainingsaufgaben attraktiv macht.
Am besten geeignet für High-Performance Computing (HPC)-Workloads und das Training massiver Basismodelle von Grund auf, wenn die reine Recheneffizienz pro Dollar der wichtigste Leistungsindikator ist.
Mosaic AI ermöglicht es Unternehmen, LLMs mit proprietären Daten innerhalb des "Data Lakehouse" vorzutrainieren und feinabzustimmen. Die Architektur stellt sicher, dass Trainingsdaten niemals die Governance-Grenzen des Kunden verlassen.
Die Abrechnung erfolgt in Databricks Units (DBUs) zuzüglich der zugrunde liegenden Cloud-Kosten. Dieses entkoppelte Modell bietet Transparenz, erfordert jedoch eine Überwachung der Instanztypen.
Ideal für Unternehmen, die ihre proprietären Daten als Wettbewerbsvorteil betrachten und kleinere, fachspezifische Modelle (SLMs) trainieren müssen.
Botpress ist ein Low-Code-Orchestrierungstool auf Anwendungsebene. Es bietet einen visuellen Flow-Builder sowie Konnektoren für WhatsApp und Slack und konzentriert sich dabei auf das Dialogmanagement anstatt auf das Modell-Hosting.
Nutzungsbasiertes Abrechnungsmodell pro eingehender Nachricht.
Ideal für Produktteams, die Kundensupport-Bots entwickeln und sich nicht um die Verwaltung der GPU-Infrastruktur kümmern möchten.
Runpod bietet „Serverless GPU“-Container (Pods) an. Entwickler können damit innerhalb von Sekunden Instanzen mit vorkonfigurierten Vorlagen für vLLM oder Stable Diffusion starten.
Runpod konkurriert über günstige Stundenpreise. So listet Runpod beispielsweise A100-GPUs oft zu Preisen, die deutlich unter denen der Hyperscaler liegen, teilweise sogar bei nur 1,69 $/Std. für Community-Cloud-Instanzen.
Ausgerichtet auf Startups, die kosteneffiziente On-Demand-GPU-Rechenleistung für Batch-Verarbeitung oder Fine-Tuning ohne langfristige Verträge benötigen.
Konzentriert sich auf industrielle Data Science und bietet eine No-Code-Umgebung für Datenaufbereitung und ML-Bereitstellung, integriert in Simulations-Workflows.
Verwendet ein Lizenzmodell (Altair Units), das über das gesamte Softwareportfolio hinweg gemeinsam genutzt werden kann.
Entwickelt für die Fertigungs- und Luftfahrtindustrie, bei denen physikbasierte Simulationen zum Einsatz kommen.
Die Auswahl der richtigen Alternative erfordert einen Entscheidungsrahmen, der auf der Infrastrukturreife und den architektonischen Zielen basiert.
Planen Sie eine Multi-Cloud-Architektur?
Wenn Ihre Strategie darauf abzielt, eine Abhängigkeit von einem einzelnen Anbieter zu vermeiden, ist eine einheitliche Steuerungsebene unerlässlich. TrueFoundry ermöglicht es Ihnen, von einem einzigen Dashboard aus auf jedem Cluster über AWS, GCP und Azure hinweg bereitzustellen.
Ist Kostenvorhersehbarkeit für Ihre Budgetierung entscheidend?
Token-basierte Preise sind schwer zu prognostizieren. Wenn Sie stabile monatliche Ausgaben benötigen, ermöglicht der Besitz der Rechenleistung über TrueFoundry (mit Reserved Instances oder Spot-Instanzen) eine deterministische Budgetierung. Wie in AWS Savings Plansangeführt, kann die Verpflichtung zur Nutzung von Rechenleistung Einsparungen von bis zu 72% im Vergleich zu On-Demand-Preisen erzielen – Einsparungen, die Sie mit der API-Preisgestaltung von Bedrock nicht realisieren können.
Benötigen Sie Datensouveränität und VPC-Isolierung?
Regulierte Branchen können Daten oft nicht an einen öffentlichen Multi-Tenant-API-Endpunkt senden. TrueFoundry stellt den Inferenz-Endpunkt bereit innerhalb Ihrer VPC, wodurch sichergestellt wird, dass Ihre Daten Ihren Sicherheitsbereich niemals verlassen.
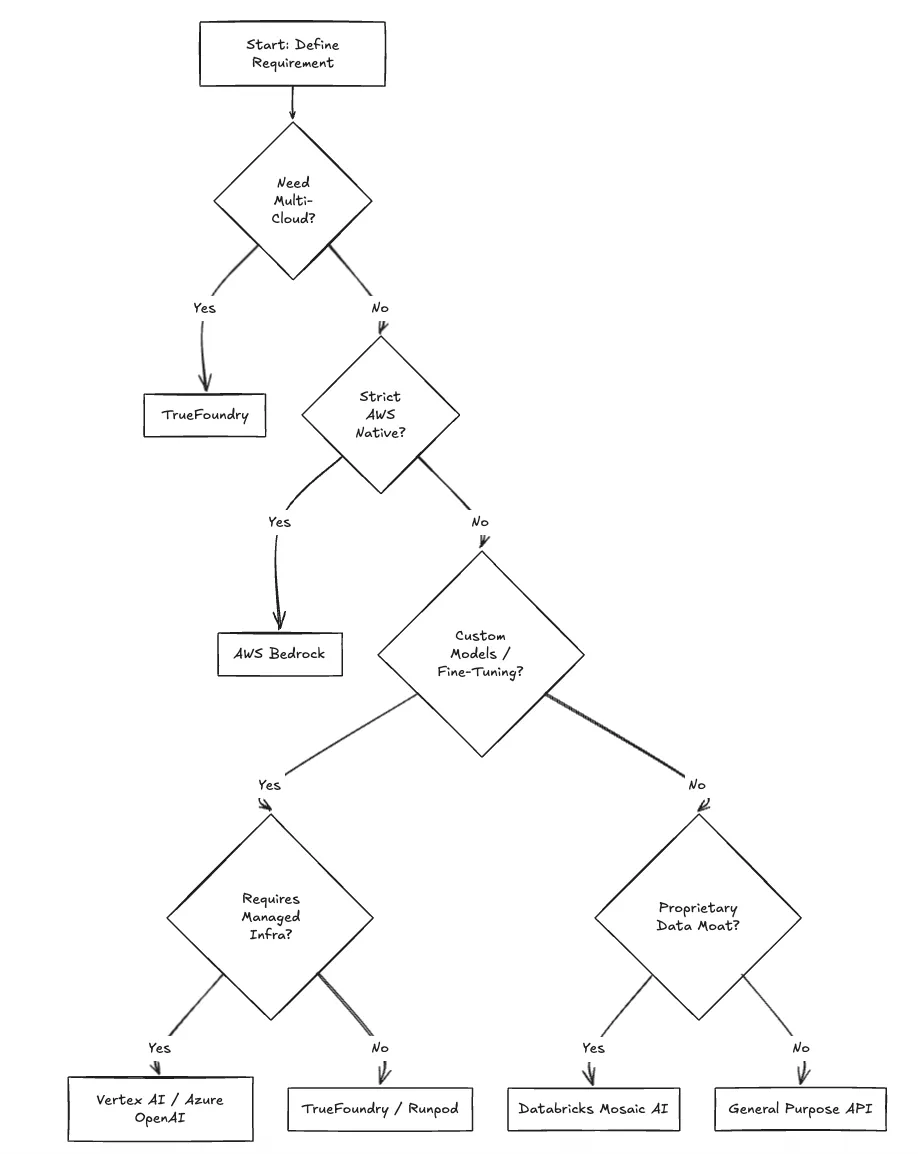
AWS Bedrock ist eine funktionale Lösung für Teams, die innerhalb des AWS-Ökosystems Prototypen entwickeln. Für Engineering-Teams, die jedoch Multi-Cloud- und kosteneffiziente KI-Produkte entwickeln, wird das „API-Wrapper“-Modell zur Einschränkung. TrueFoundry bietet die notwendige Brücke: die Infrastrukturhoheit und Flexibilität eines Eigenbaus ohne den operativen Aufwand der Verwaltung roher Kubernetes-Manifeste.
Für erste Prototypen ist Bedrock effizient. Bei produktiven Anwendungen macht der Aufschlag auf Token die Lösung jedoch oft weniger kosteneffizient als das Hosten von Modellen auf der eigenen Infrastruktur. Die Nutzung einer KI-Plattform wie TrueFoundry AI Gateway die für die schnelle Prototypenentwicklung von KI-Modellen konzipiert ist, stellt sicher, dass Sie hohe Ausgaben vermeiden und erhebliche Kosteneinsparungen erzielen.
Zu den Einschränkungen gehören die Abhängigkeit vom Ökosystem, unvorhersehbare Kosten bei Skalierung (tokenbasierte Preisgestaltung) und Beschränkungen bei der Bereitstellung benutzerdefinierter quantisierter Modelle (wie GGUF-Formate), die Rechenleistung einsparen könnten. Teams benötigen oft eine nahtlose Integration verschiedener Datenquellen für komplexe Aufgaben bei gleichzeitiger Verwaltung unterschiedlicher Versionen ihrer ML-Modelle.
Nein. ChatGPT ist eine SaaS-Anwendung. Bedrock ist eine PaaS (Platform as a Service), die zum Erstellen von Anwendungen wie ChatGPT verwendet wird. Es handelt sich um einen vollständig verwalteten Dienst, über den Sie per einfachem Texteingabe-Prompt auf Large Language Models zugreifen können.
Bedrock folgt dem AWS-Modell der geteilten Verantwortung. Obwohl es Verschlüsselung bietet, werden Ihre Daten auf einer von AWS verwalteten Infrastruktur verarbeitet. Das Self-Hosting über TrueFoundry innerhalb Ihrer eigenen VPC bietet eine höhere Isolation. Wir implementieren strenge Sicherheitsmaßnahmen und Zugriffskontrollen, um Ihre KI-Entwicklung über verschiedene Architekturen hinweg zu schützen.
Vertex AI ist mit seinen verwalteten APIs vergleichbar mit Amazon Bedrock, umfasst jedoch robustere MLOps-Tools für das benutzerdefinierte Training.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















